How Ramp Accelerated Machine Learning Development to Simplify Finance
Rampにおける機械学習による財務の簡素化
- RampのML適用領域
- 信用リスク
- 顧客が延滞する確率の予測など。
- 不正利用
- カード取引が不正かどうかの判断など。
- グロース
- 潜在的なリードが顧客に変わる確率の予測などの成長。
- プロダクト
- 特定の取引に対する会計コードの提案や、ランプの新しいAI製品群であるランプ・インテリジェンスなどの製品。
長いフィードバックループと過度の摩擦
- 最初の機械学習モデルのひとつは、「リスク度」モデル
- 毎日何万ものランプの顧客に関連するリスクのレベルを予測するタスクを解いていた
- scikit-learnとxgboostで構築されたかなりシンプルなモデル
- このモデルを利用して約20の機能があった
- ベンダーの既製のソリューションを利用
- MLパイプラインをローカルで定義・実行できないという課題
- パイプラインのコードをベンダーにプッシュしてから実行する必要があった
- ジョブの実行には、非常に小さなデータセットでも1時間以上かかった
- ジョブにはばらつきがあり、うまくいかないときは、その原因がよくわからないこともあった
- 理由もなくジョブが失敗することもあり、ログの記録も不十分
- プラットフォームはDockerコンテナで動作せず、Dockerを使用すると意味不明なエラーが発生し、コンテナ化されたワークロードでは利用できない機能がプラットフォームにあった
- 何が実行されているのかがよく見えず、開発には長い時間がかかり、リスク・モデルの構築には数ヶ月を要した
- 長いフィードバックループと過度の摩擦は、反復が鍵となる初期段階では特に苦痛を伴う
- Ramp製品は開発のベロシティでよく知られており、開発者の体験と素早いフィードバックループに対して非常に高いハードルを設定しています。データ・サイエンスとMLもその例外ではなく、2022年は機械学習モデルを思うように速く本番稼動させることができませんでした。
Metaflowの導入
- MLプラットフォームの選択肢はたくさんある
- 選定ポイントとしては以下
- コミュニティに支持されている
- シンプル
- ベロシティ
- シンプルさについては、インフラとエンドユーザー・コードの両方に焦点を当てた。インフラ側では、可能な限りAWSが管理するサービスを活用したかった。エンドユーザー側では、データサイエンティストと機械学習エンジニアが素早く立ち上がり、実行できるようにしたかった。
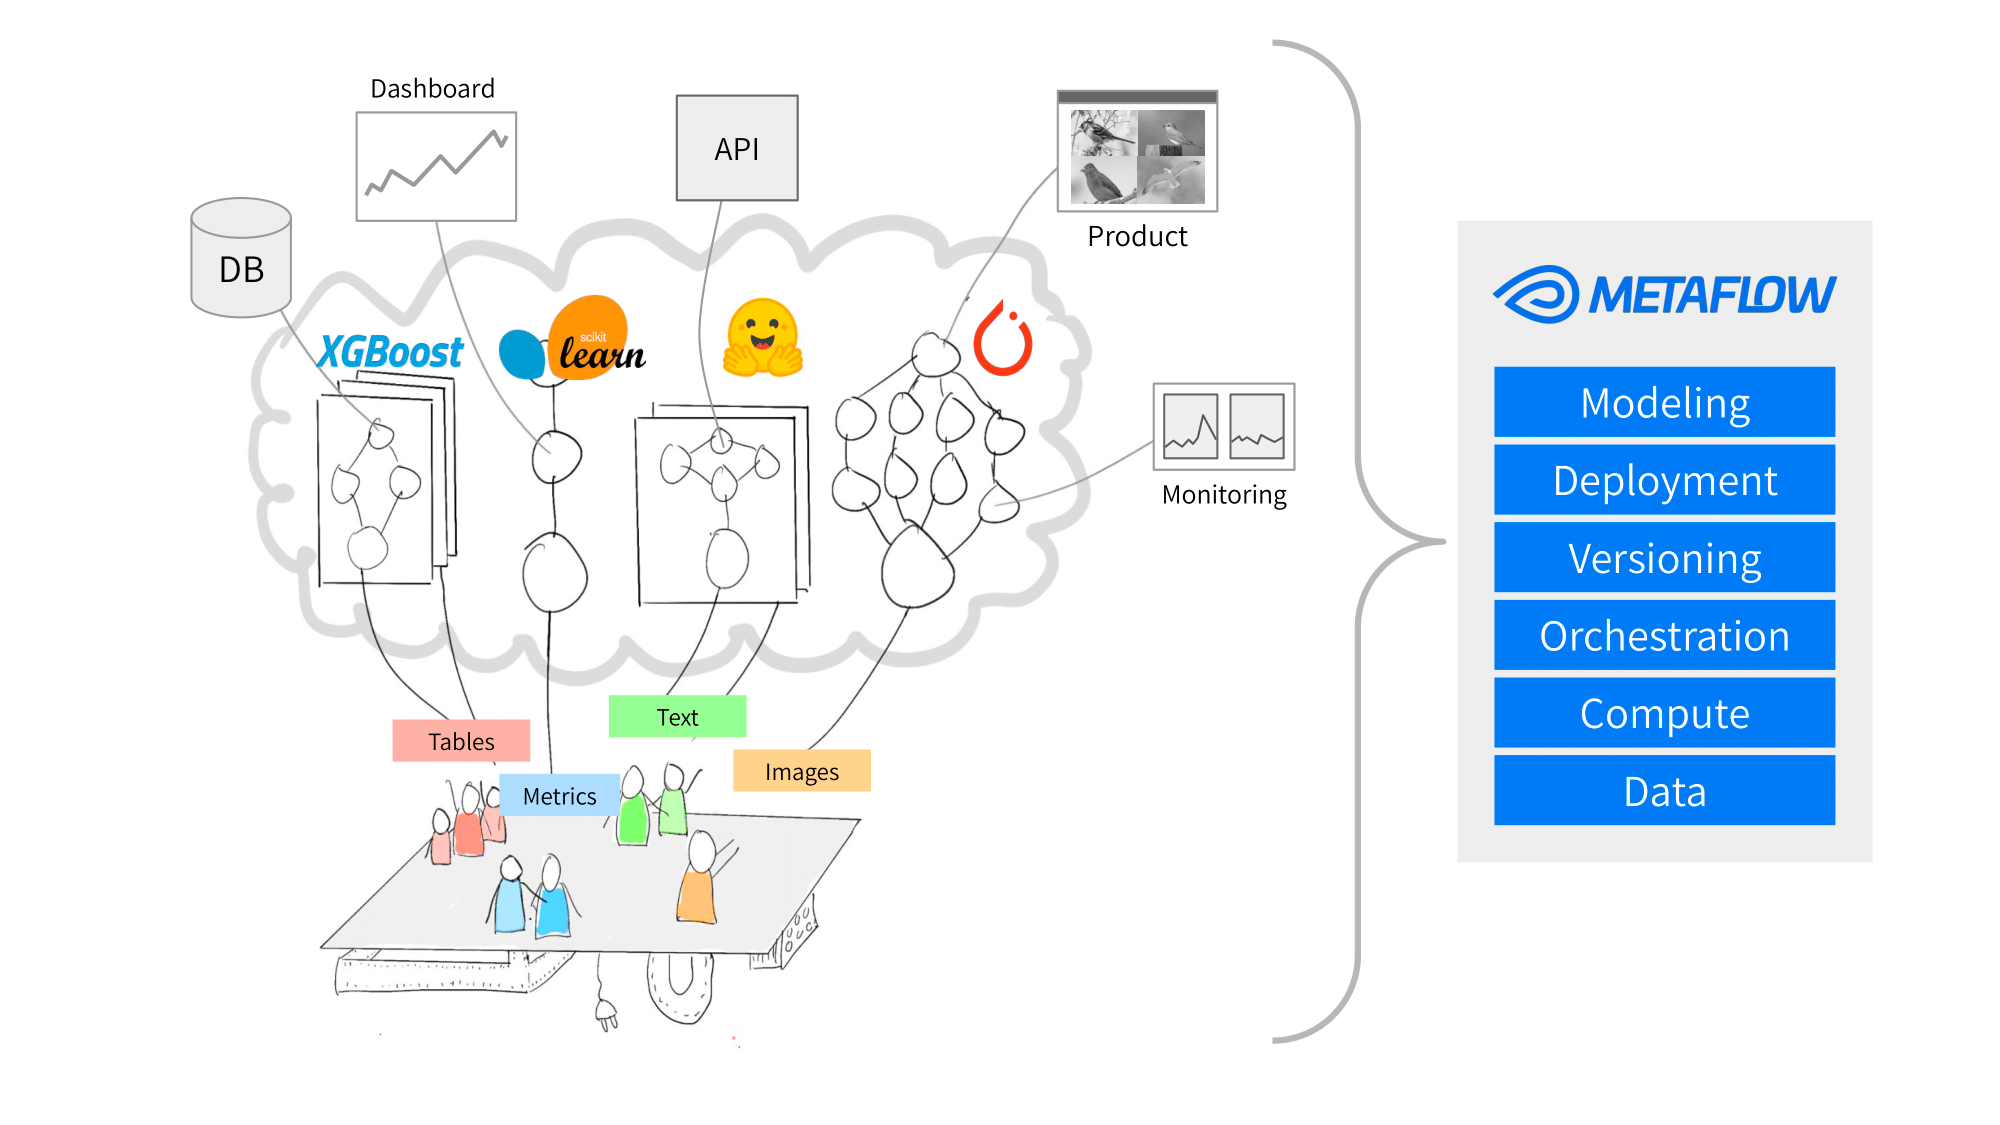
- Metaflowは、MLモデルのトレーニングと管理、MLシステム構築のためのオープンソースのMLフレームワーク
- データサイエンティストやMLEは、Pythonでモデルを構築することに集中しながら、データや計算からバージョン管理やデプロイまで、機械学習のフルスタックのすべてのレイヤーにアクセスできる
- Airflow、Argo Workflows、AWS Step Functionsのような既存のワークフローオーケストレーターや、KubernetesやAWS Batchのようなコンピュートインフラストラクチャとも統合できる
- 主にできること
- 純粋にPythonでMLパイプラインをMetaflow Flowとして定義。
- シンプルなPython run_flow.pyコマンドでパイプラインをローカルで実行。
- 同じコマンドに--with batchフラグを追加して、同じパイプラインをクラウドで実行。
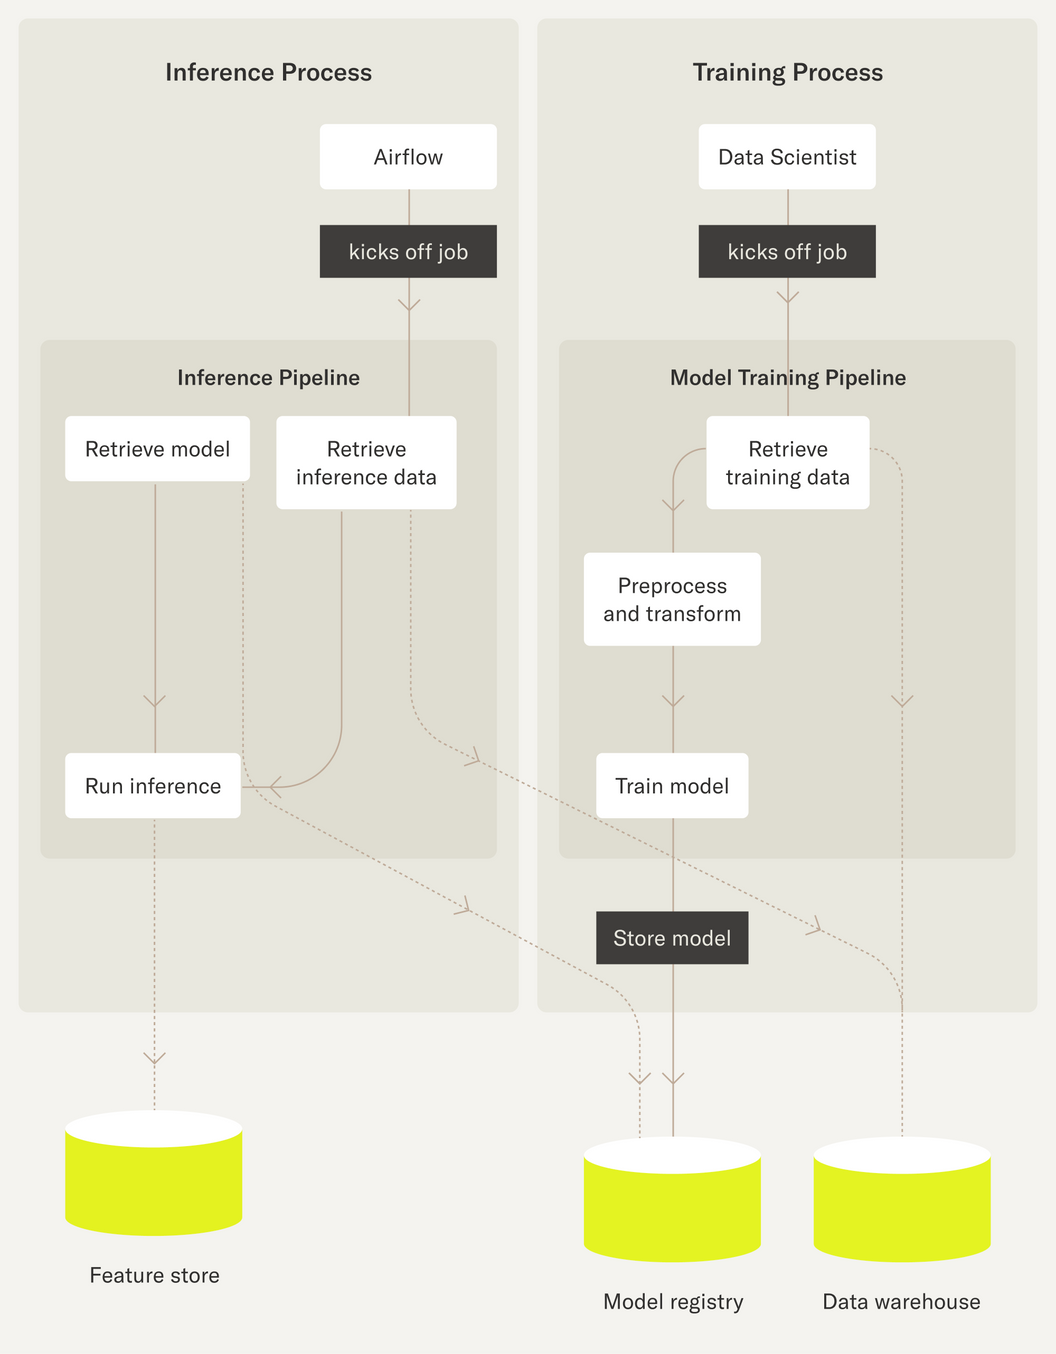
- Metaflowコードを本番環境にプッシュし、Airflow DAGから同じFlowをトリガーする。
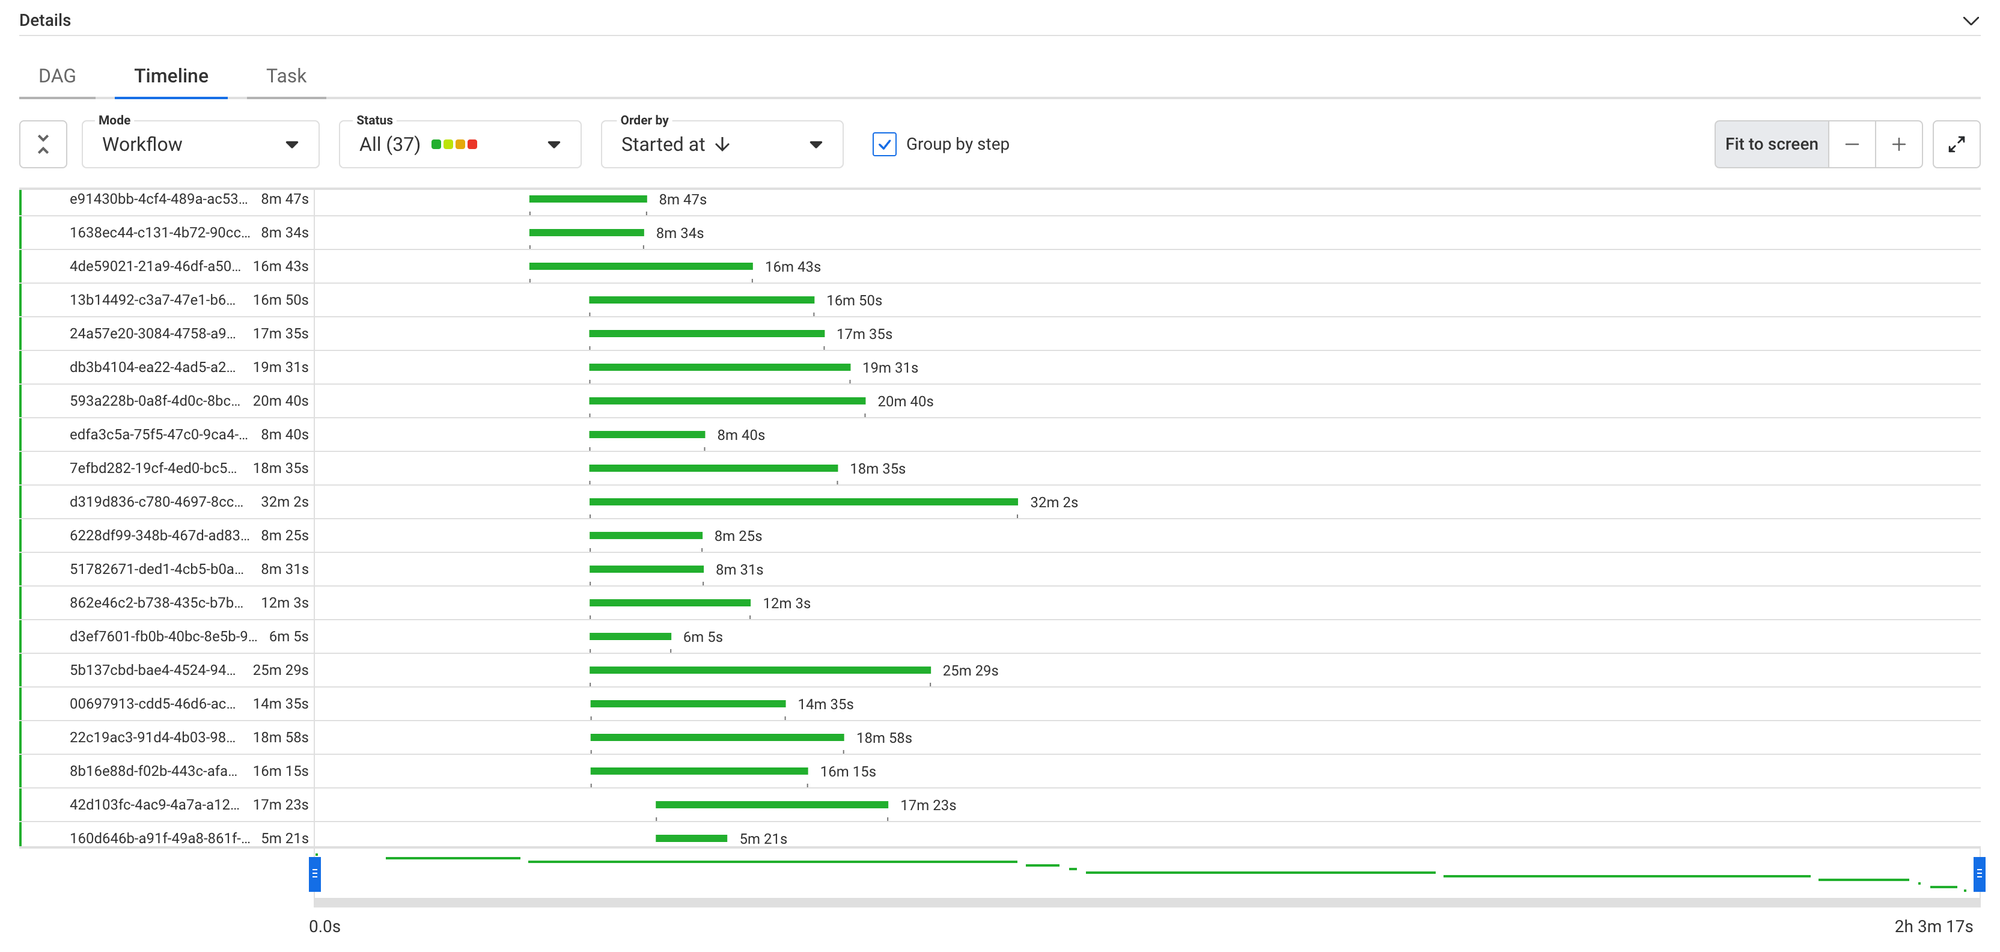
- UIから見えるMetaflowの「カード」を使って結果を可視化。
- リンク経由で結果と「カード」を簡単に共有。
- Airflowを使わないのか?
- Airflowは、Pythonベースのオーケストレーターであり、データエンジニアリングのデファクターツールだが、機械学習エンジニアリングに最適なツールとは限らない
- Airflowは、ワークロードそのものではなく、計算ワークロードのオーケストレーターとして使用されることを意図している
- 例えばデータを処理するSparkジョブをトリガーするなど
- Airflowでは、ローカルでパイプラインを実行し、スイッチひとつですぐにクラウドで実行することはできない。まず本番のクラウド環境にマージしてデプロイする必要がある
- Airflowには "MLバッテリー込み "ではないので、完全なシステムを構築するにはかなりの時間と追加ライブラリーが必要だが、Metaflowには、例えばノートブックで結果を検査・分析したり、モデルカードを作成したり、大量のデータに素早くアクセスしたりするための機能が最初から含まれており、経験の浅いデータサイエンティストでも単独でシステムを構築しやすい
- 導入の効果
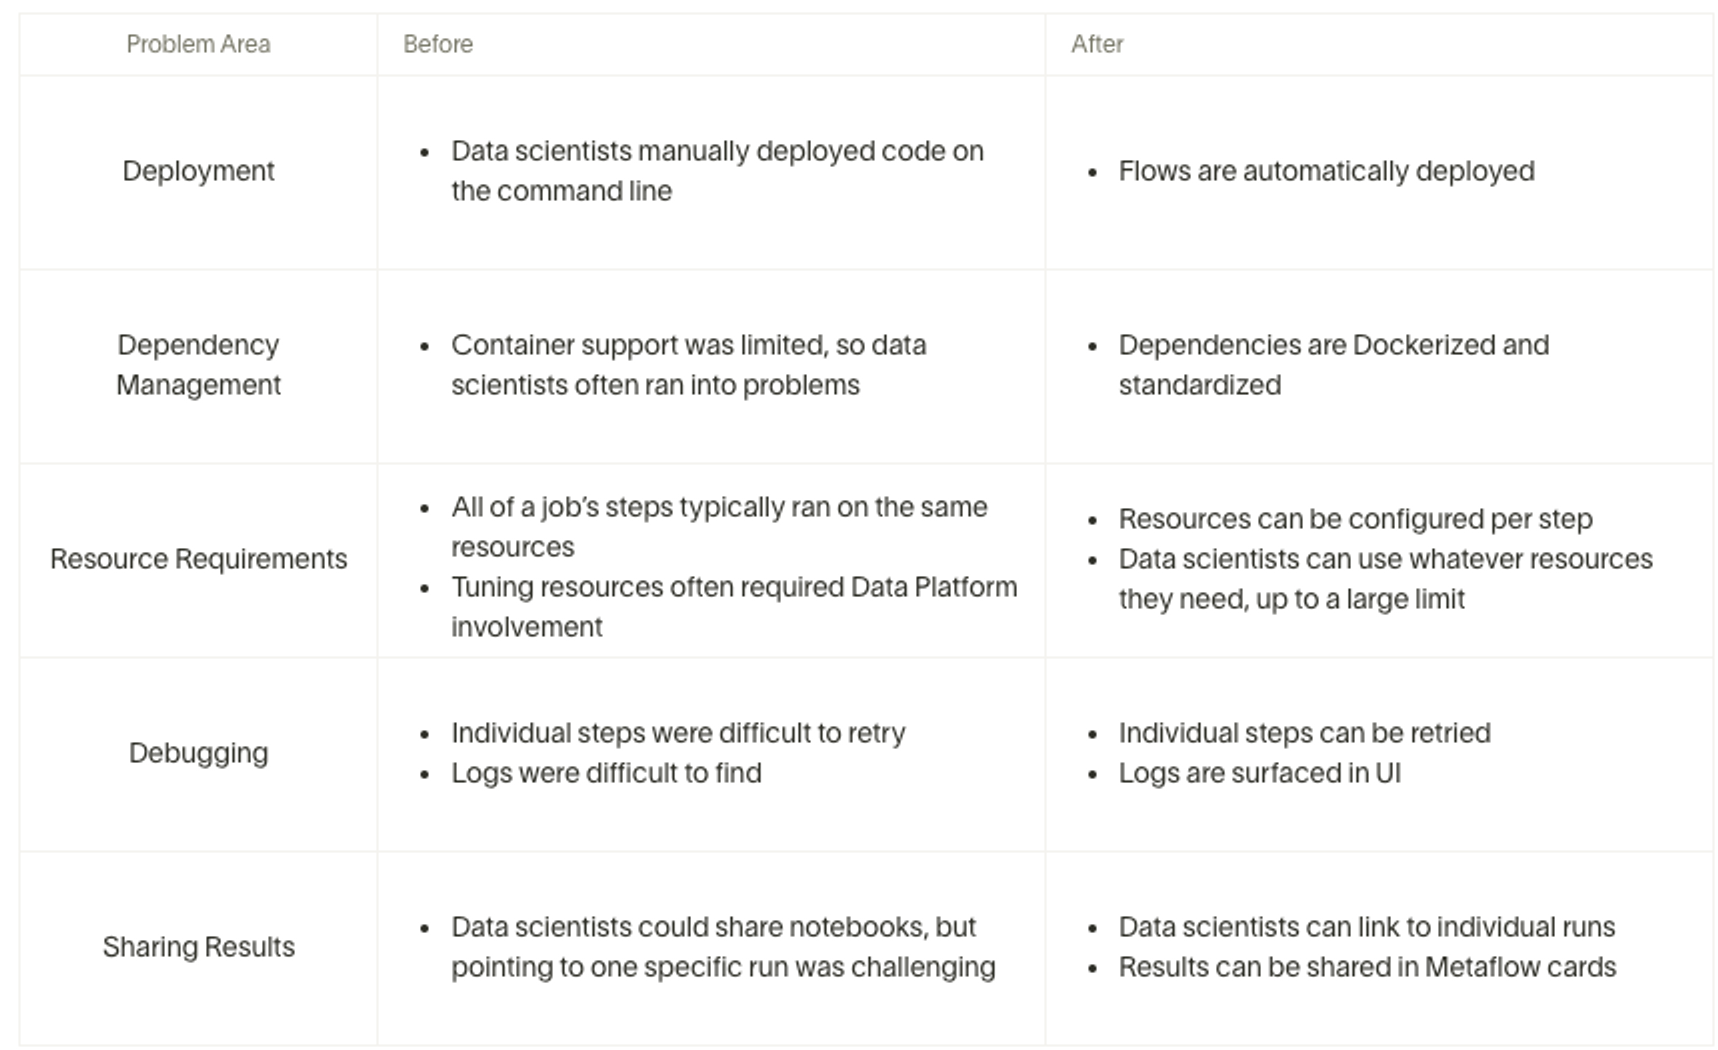
- Metaflowの採用後、以前は1つのモデルを立ち上げるのに何ヶ月もかかっていたのに、わずか10ヶ月で8つのモデルをデリバリできた
- 今後6ヶ月以内に、5~10個の追加モデルをトレーニングし、立ち上げる予定
Metaflowセットアップの詳細
- セットアップの概要
- MetaflowはAWS Batchを使ってジョブをスケジューリングし、AWSが管理するECSクラスタ上で実行することができる。
- Batchはジョブを追跡できるジョブキュー機能を提供する。
- 各ジョブキューには、複数のコンピュート環境をアタッチできる。これらのコンピュート環境はFargateやEC2で実行でき、利用可能なリソースやスケーリング戦略を調整できる。
- 小規模だったのでまずは1つのジョブキューを作成し、最初はFargateのコンピュート環境をアタッチした。
- FargateからEC2へ移行
- Fargateの起動時間が長く、ジョブの開始まで数分かかる
- FargateはCPUとメモリの特定の組み合わせしかサポートしていなく、コードを書くたびにドキュメントを見にいくのは面倒
- FargateはGPUをサポートしていなく、多くのモデルにとっては問題ではないが、より洗練されたモデルにとっては厄介な制限
- Terraformの活用
- Terraformを使ってインフラを定義しているので、Metaflowのインフラはすべてコードとして記述できる。
- MetaflowのStep Functionsの活用
- ローカルでフローを実行する場合、MetaflowはローカルのPCからステップをオーケストレーションする。これは短時間のインタラクティブなジョブには適しているが、長時間のジョブやプロダクションジョブには向いていない
- MetaflowのStep Functionsはステップ間の移行や失敗のリトライを処理し、スケジュールでトリガーできる。
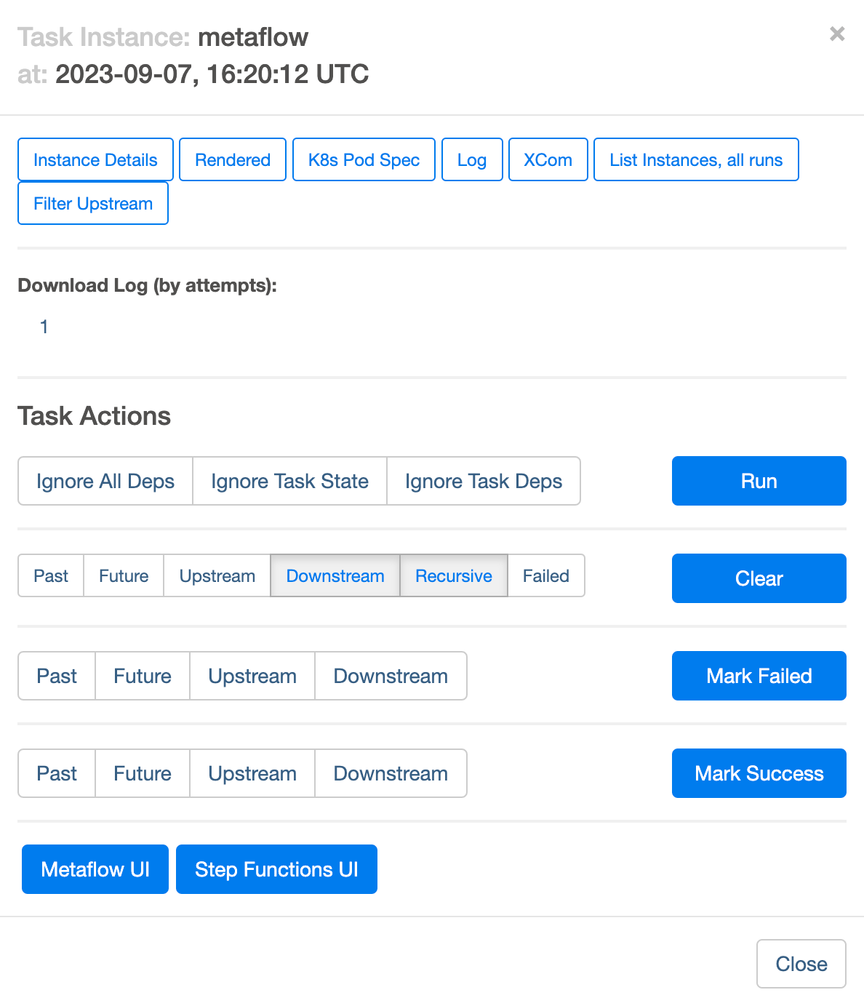
- 実際はフローの実行を管理するためにしか使っておらず、スケジュールやトリガーを処理するために、AirflowからStep Functionの実行をトリガーしている
- 最初は、Step FunctionsとAirflowを統合するために、Amazonのプロバイダー、つまりStepFunctionStartExecutionOperatorとStepFunctionExecutionSensorを使ったが非効率だった
- Metaflowとデータ・サイエンスの文脈ではほとんど意味をなさないステップ・ファンクションのステート・マシンARNを使って、実行のトリガーとなる2つの定型タスクを作らなければならなかった
- 何か問題が発生した場合、データサイエンティストはAWSコンソール、Metaflow UI、またはその両方でログを追跡しなければならなかった
- これを改善するために、MetaflowOperatorを作り、フローをトリガーし、成功または失敗を待つ処理を行う
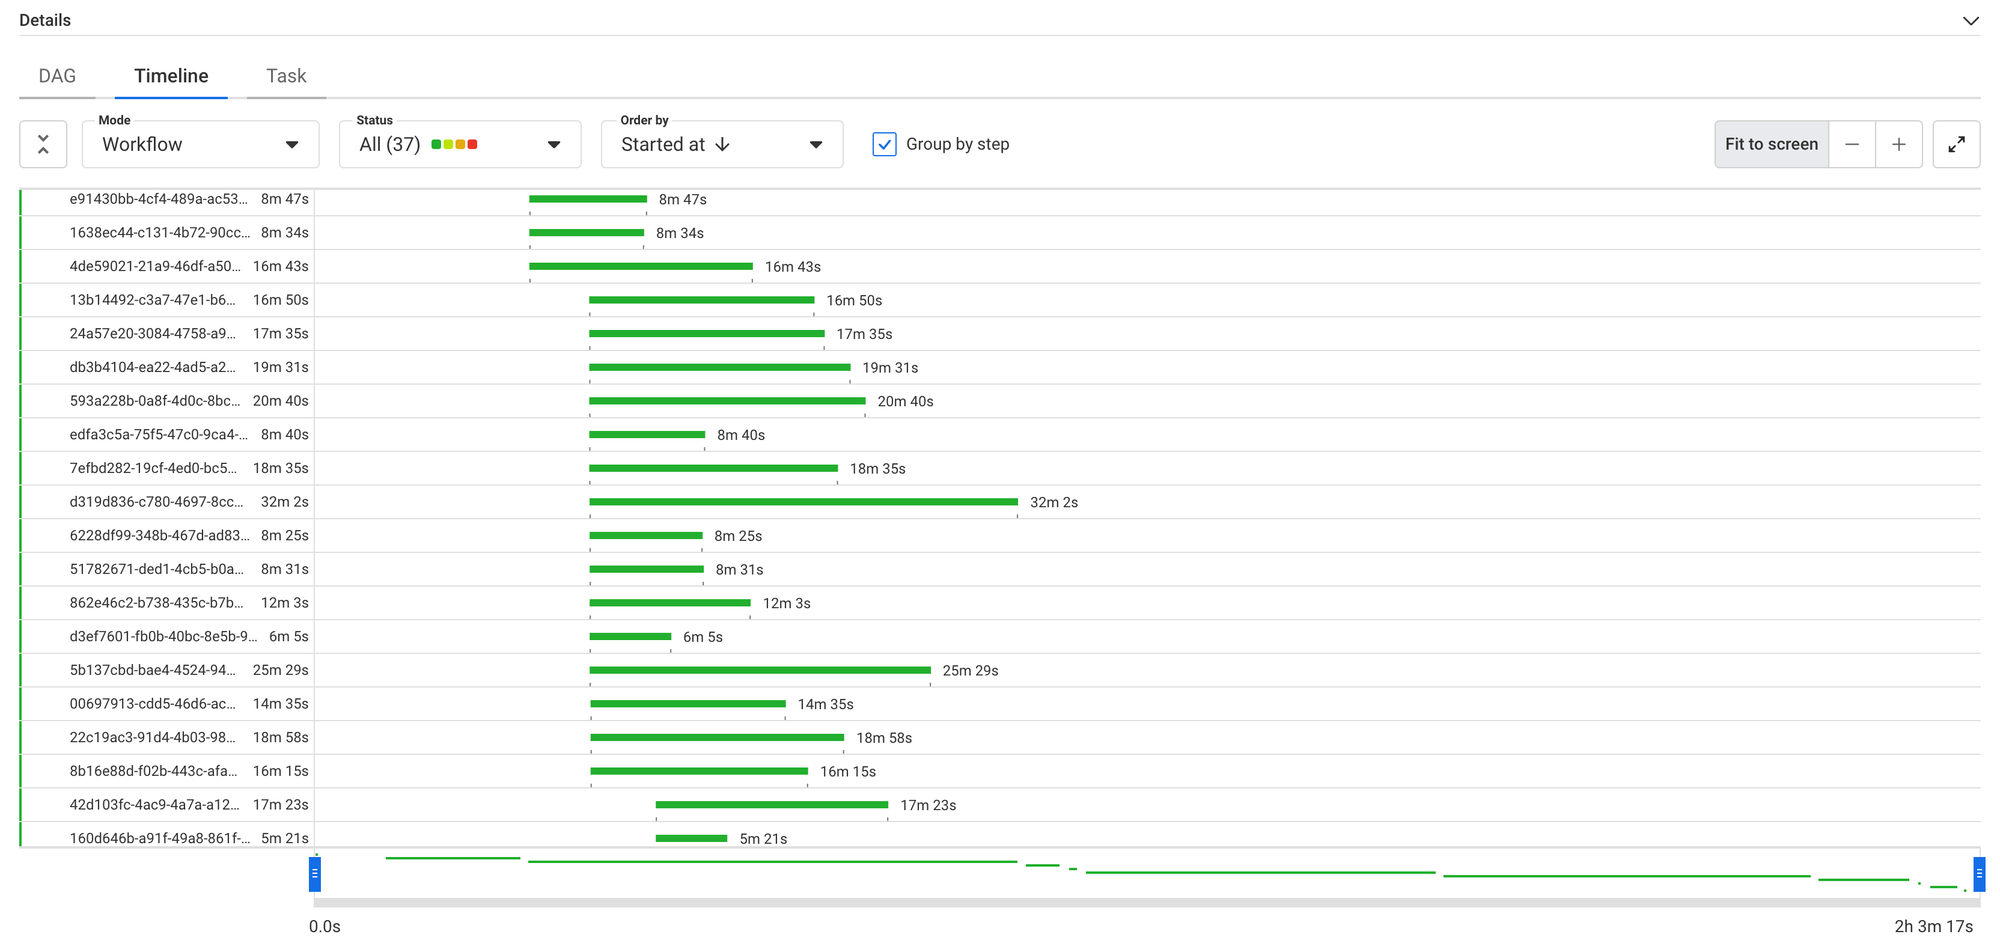
- 現在、6000以上のフローが実行されています。これらには、毎日行われるスケジュールされたタスクと、その場で行われる多くのタスクが含まれる。