VRDU: A Benchmark for Visually-rich Document Understanding
blog
概要
- KDD2023採択
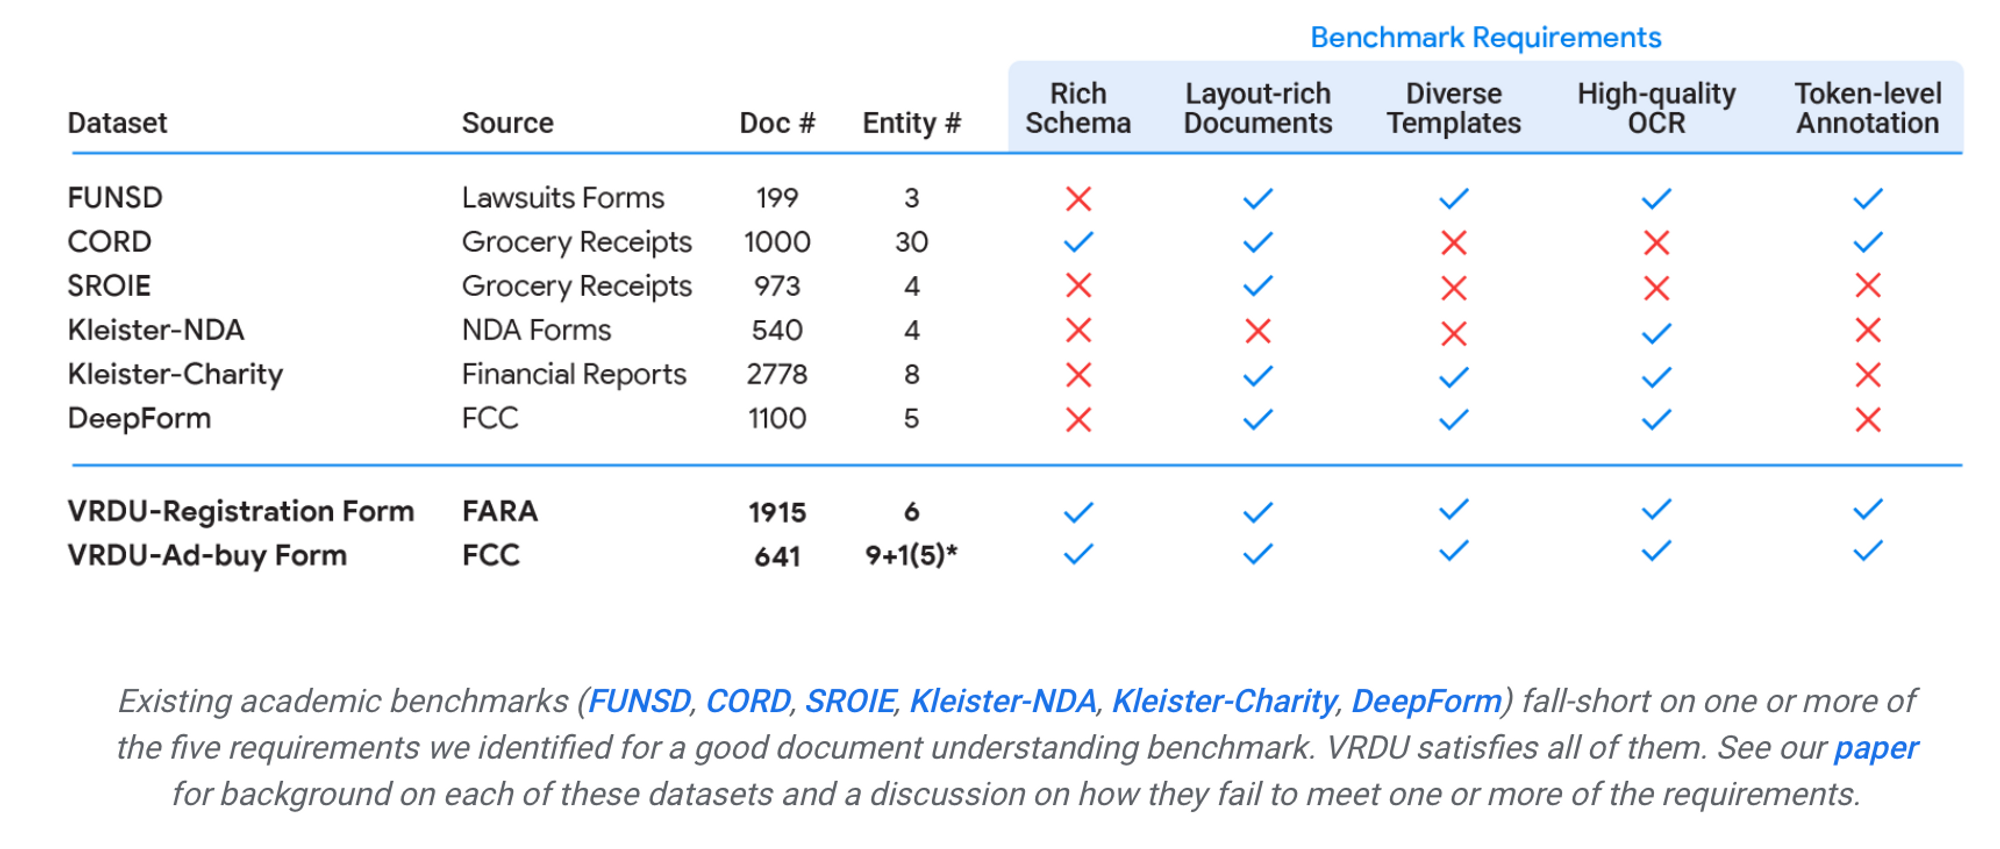
- 最近のマルチモーダル言語モデルは印象的な結果を出しているが、既存のベンチマークは産業界で見られる実際の文書の複雑さを反映していない
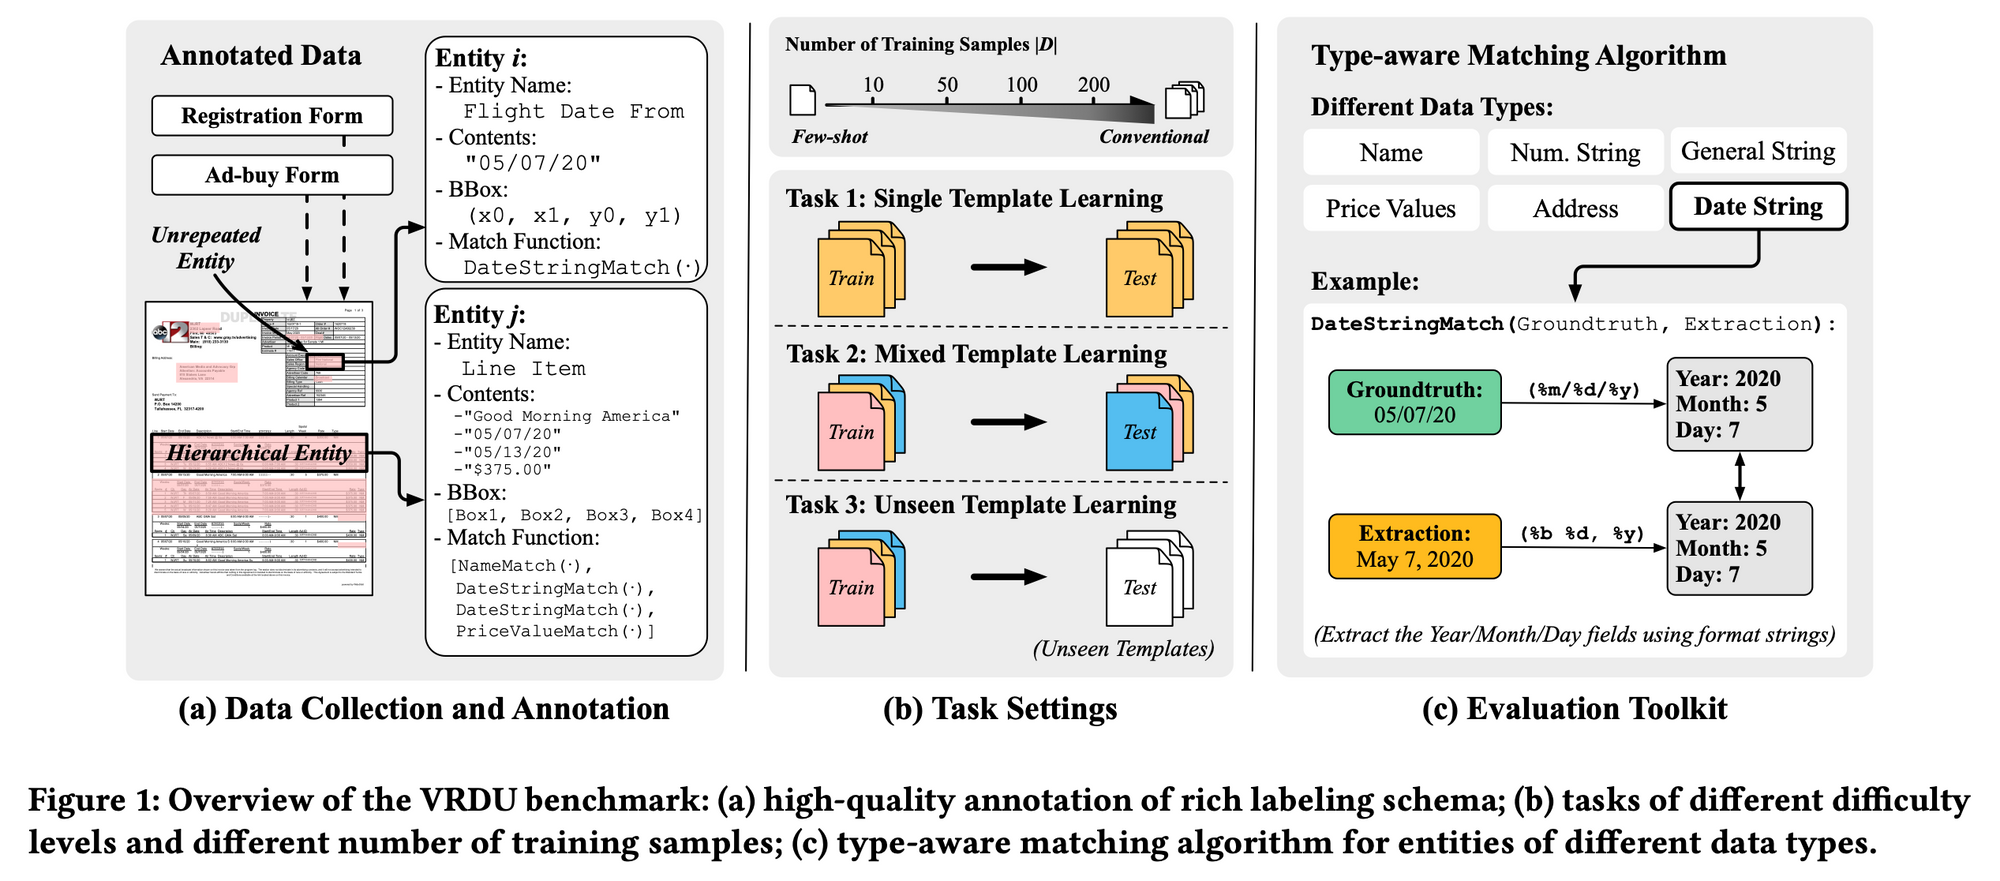
- 本研究では、より包括的なベンチマークの望みを明らかにし、Visually Rich Document Understanding (VRDU) と呼ぶものを提案
- VRDUには、多様なデータ型や階層的なエンティティを含む豊富なスキーマ、テーブルやマルチカラムレイアウトを含む複雑なテンプレート、1つの文書型内の異なるレイアウト(テンプレート)の多様性という、いくつかの課題を表す2つのデータセット(登録フォーム、広告購入フォーム)が含まれています
- データセットが現実世界のアプリケーションの複雑さをよりよく捉えることを可能にする5つのデータセット要件を特定しVRDUはすべてを満たす
- Rich Schema
- Layout-Rich Documents
- Diverse Templates
- High-Quality OCR
- Token-Level Annotation
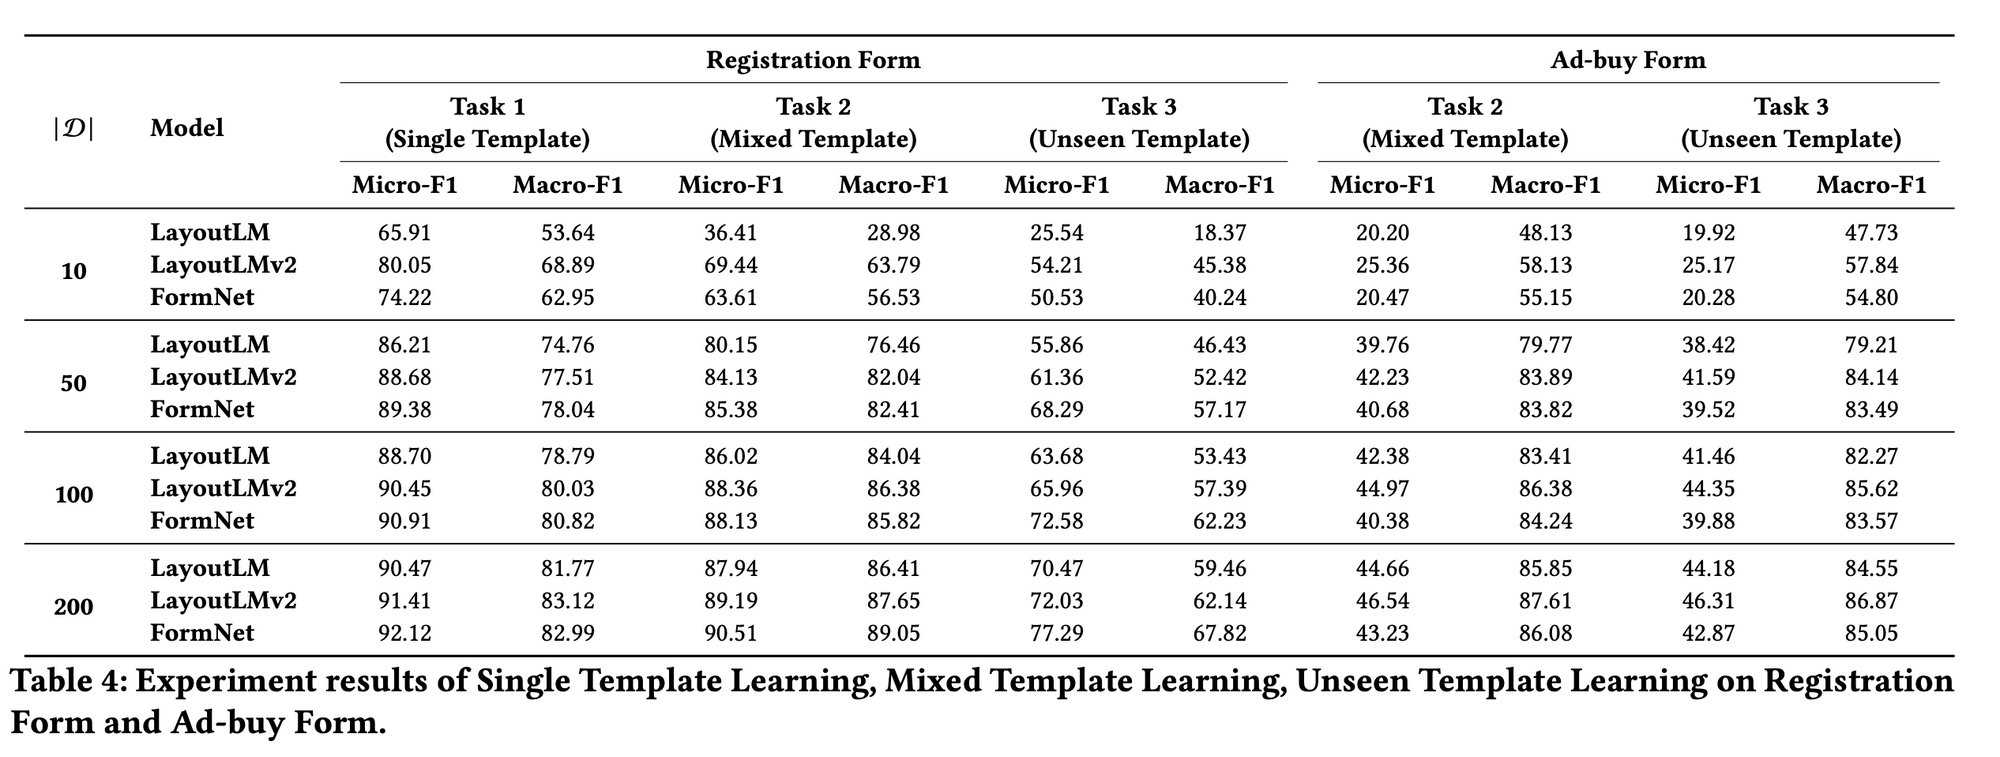
- VRDUを用いた実験結果
- 他のベンチマークとは異なり、VRDUは挑戦的であり、モデルには十分な改善の余地があることを示しています。第二に、最先端のモデルでもわずかなショットのパフォーマンスが驚くほど低く、最高のモデルでもF1スコアが0.60未満になることを示しています。第三に、モデルが構造化された繰り返しフィールドに対処するのに苦労し、特にパフォーマンスが低いことを示しています