Peek Across: Improving Multi-Document Modeling via Cross-Document Question-Answering
概要
- ACL2023
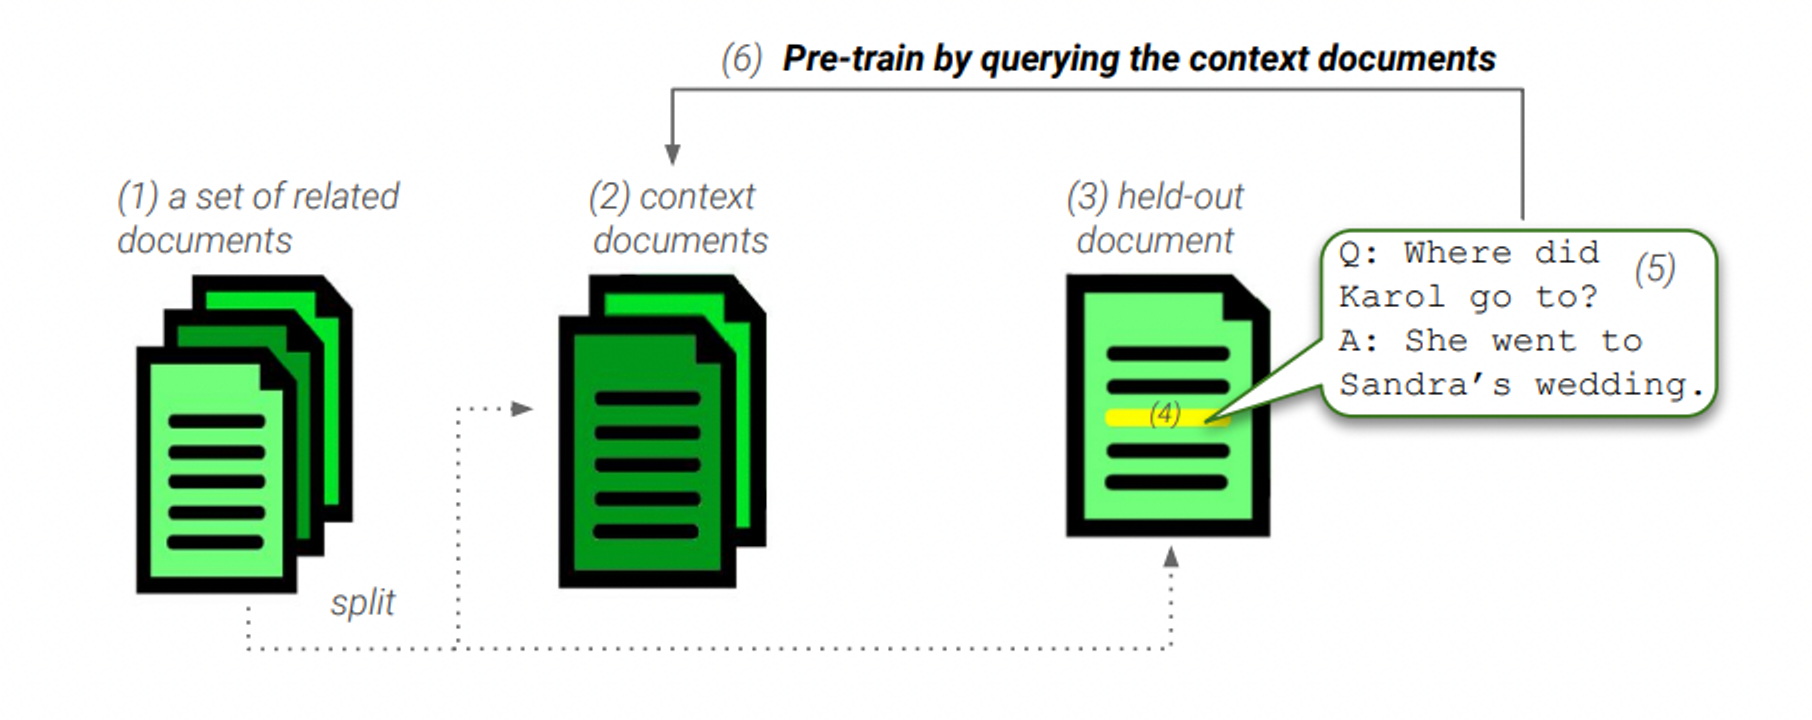
- マルチドキュメントの事前学習目標を言語モデルに組み込むことで、マルチドキュメントの下流タスクにおいて顕著な改善が見られる。本研究では、この考え方を拡張し、新しい文書横断的な質問応答事前学習目的から、一般的なマルチ文書モデルを事前学習することを提案する。そのために、トピック的に関連する文書の集合(またはクラスタ)が与えられたとき、ある文書中の顕著な文から意味指向の質問を系統的に生成し、事前学習中に、他のトピック的に関連する文書を「覗き見」しながら、これらの質問に答えるようモデルに課す。同様の方法で、モデルはまた、文書横断的な情報を活用しながら、質問が生成された文を復元することに挑戦する。この新しいマルチドキュメントQAの定式化は、テキスト間の情報関係をよりよく回復するようモデルを指示し、事前学習データを人為的に増加させる自然な補強を導入する。さらに、分類か要約のどちらかのタスクに焦点を当てた先行するマルチドキュメントモデルとは異なり、我々の事前学習目的定式化は、短いテキスト生成(例えばQA)と長いテキスト生成(例えば要約)の両方を含むタスクをモデルが実行することを可能にする。このスキームに従い、我々のモデル(QAmdenと呼ぶ)を事前学習させ、マルチドキュメントQA、要約、クエリに焦点を当てた要約を含む、いくつかのマルチドキュメントタスクにおける性能を評価した結果、最大7%の改善が得られ、ゼロショットGPT-3.5とGPT-4を大幅に上回る。