2025-08-06 機械学習勉強会
今週のTOPIC[blog] GPT-OSS[blog] AIによる開発の前提知識を学ぶため「LLMのプロンプトエンジニアリング」を読んだ[論文] PixNerd: Pixel Neural Field Diffusion[blog]AIエージェントのおかげでdbt開発の大部分を自動化した話[blog]Qwen-Image: Crafting with Native Text Rendering[論文] Transmission With Machine Language Tokens: A
Paradigm for Task-Oriented Agent CommunicationメインTOPICMagistral3行まとめ導入手法インフラストラクチャデータ実験分析うまくいかなかったこと
今週のTOPIC
@Naoto Shimakoshi
@Yosuke Yoshida (yossy)
@Takumi Iida (frkake)
@Hiromu Nakamura (pon)
@ShibuiYusuke
メインTOPIC
Magistral
| タイトル | Magistral |
|---|---|
| 著者 | Mistral AI |
| リンク | https://arxiv.org/abs/2506.10910 |
| 関連ページ | https://mistral.ai/news/magistral |
3行まとめ
- MagistralはMistral Medium 3をベースに、既存の推論モデルの知見やトレースを一切使わず、独自設計のオンラインRLVR(Reinforcement Learning from Verifiable Rewards)パイプラインで「純粋な」強化学習のみを行い、推論能力を大幅に向上させた。
- この手法により、AIME-24でパス@1が26.8→73.6(約50%増)、LiveCodeBenchでも29.1→59.4と著しい改善を達成しつつ、マルチモーダル理解や命令従属性、関数呼び出し機能も維持・向上させている。
- さらに、同じアプローチで得られた推論トレースを活用した24Bパラメータの小型モデル「Magistral Small」も開発・公開し、学術・実用両面で再現可能なオープンソースとしてApache 2.0ライセンスで提供している。
導入
- MistralベースのReasoningモデル Magistral を作成
- Mistral Small 3 → Magistral Small (Apache 2.0)
- Mistral Medium 3 → Magistral Medium
- 貢献ポイント
- 既存reasoningモデルからの蒸留はせず、強化学習のみで訓練
- 大規模かつ高速なRL trainingのための構成
- CoT, 最終的な回答の両方をユーザーの言語に合わせて出力する多言語モデル
- Reinforcement Learning from Verifiable Rewards (RLVR) に対する知見の提供
手法
強化学習アルゴリズム
- Group Relative Policy Optimization (GRPO) を利用
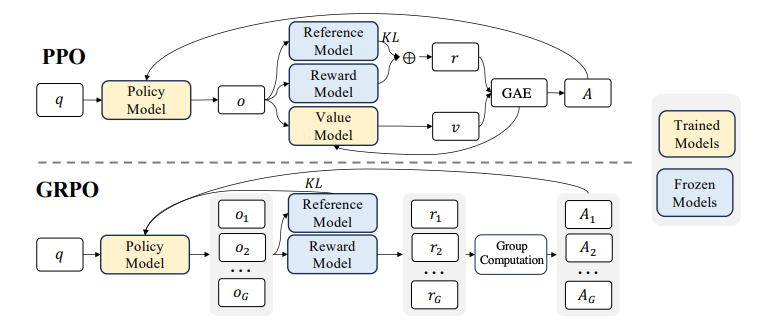
- 元々のGRPOの目的関数から変更
- before
- after
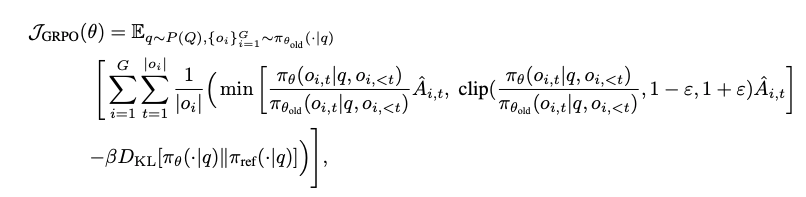
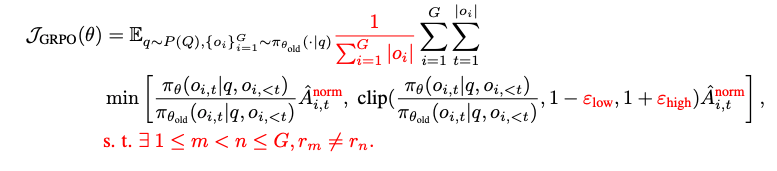
- 変更点
- KL-divergence項を削除: GRPOにおいて、policyのdivergeは大きく作用しないため、計算コスト削減のため削除
- lossの正規化: グループごとに生成されたトークン長の違いによるバイアスを緩和するため、グループ単位での正規化から、グループ全体での正規化に拡大
- Advantageの正規化: advantage(ある出力が平均よりどれだけ良いか) パラメータ A の正規化方法を変更(minibatch内でAを正規化)
- clip幅の調整
- before: 元の対数尤度の小さいtokenの上昇幅を抑えている
- after: low, highそれぞれの下限・上限を広げるように調整し、学習の余地を増やす
- non-diverge groupsの削除: すべて正解 or 間違いのtokenで構成されたグループは、Advantageが0になり、lossに影響を与えない。それらを除外してから正規化などの後続の計算をおこない、lossが過剰に小さくならないようにする。
報酬設計
- フォーマットに対する報酬
- 従うべきフォーマット
- 生成する回答は <think> タグから開始し、その後 </think> で終わっている。またそれらは1度だけ使われる。
- 数学の最終回答は、</think> の後に \boxed{} で囲む
- コードの回答は、マークダウン形式のコードブロックを含める
- フォーマットに1つでも違反すれば報酬は0、全て従っていれば0.1の報酬を加算する
- 正確さに対する報酬
- 数学: \boxed{} から回答を抜き出し、SymPyなどで整形した後、正解と比較し、同じであれば正解。
- コード: 最初のマークダウン形式のコードブロックから回答を抜き出し、C++で書かれていれば10sを上限にコンパイル(C++20)。利用可能なテストをランダムに20個選び、4sタイムアウト・300MBメモリでテストを実行する。テストが全て通れば正解。
- いずれも正解していれば0.9の報酬を与え、合計1.0の報酬となる。
- 長さに対するペナルティ
- 生成して良い最大の長さに近づいた場合、最大 -0.1 のペナルティを加算し、最大長に近づきすぎるのを防ぐ
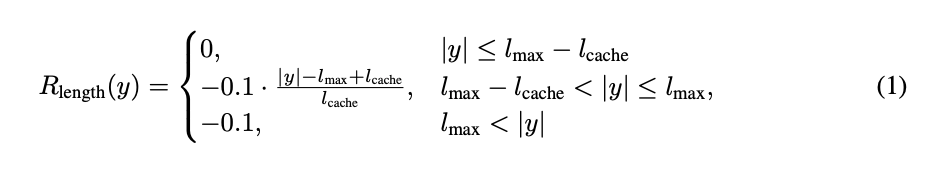
- 言語一貫性に対する報酬
- 特に言語制約なく強化学習すると、数学やコーディングの生成結果が複数言語の混ざったものになりがちな傾向にある。
- クエリデータの10%について、英語からフランス語・スペイン語・イタリア語・ドイツ語・中国語・ロシア語に翻訳。出力結果をfastText classifierにかけ、同じ言語だと判定されれば0.1の報酬を与える。
- これだけの制約で、任意の(事前に翻訳をかけた以外も含めた)言語について言語一貫性が改善
system prompt
- Be as casual and as long as you want の部分がexplorationを増やすのに有効(らしい)
インフラストラクチャ
オンライン強化学習を構成するワーカー
- Trainers: 勾配更新。モデルのメインコピーを保持
- Generators: 対数尤度付きで回答を生成。
- Verifiers: 出力を受け取り報酬を算出
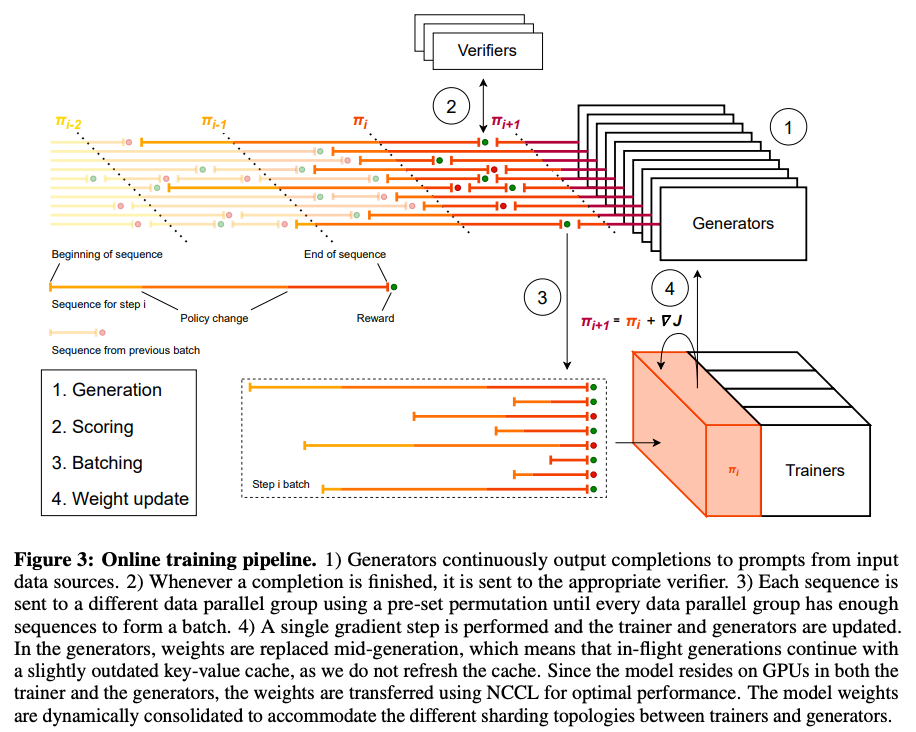
Challenges with distributed RL: クエリによってインプット・アウトプットする長さ(トークン列・時間)が大きく異なる
- 非同期生成
- 生成・検証が終わったsequenceをbatchに追加していく
- batchに必要な分が揃ったら、Trainerに流して新しいパラメータを得る
- 生成途中のものはKVキャッシュを使って元のパラメータのまま生成し続け、次の生成から新しいパラメータを反映
- Trainer Optimization
- Greedy Collation Algorithm: minibatchに含まれる系列長を揃えてpaddingを抑えるため、系列を長い順にsortした上でmicrobatchに分配していく。
データ
数学
- 元データ70万問から、問題が欠けておらず、「数値や式で正解を検証できる」ものを抽出
- Mistral Large 2で問題ごとに16回答を生成。極端な難易度(全く解けない or ほぼ必ず解ける)の問題を除外
- 得られたデータで24Bモデルを強化学習し、学習後に再度16回答を生成。極端な難易度の問題を再び除外し、「過半数の回答が同じ & 不正解」な問題を除外(正解が間違っている可能性が高い)。結果として3万8000問に。
コーディング
- 競技プログラミングデータ(問題・正解コード・テストケース)を収集
- テストのフィルタリング
- 出力結果が複数の正解コードで揃わないテストケースを除外
- 出力が揃っても間違っている場合は、テストの方を修正
- テストケースが少ない場合は、新しいテストを追加
- 結果として3万5000問に。
実験
Overview
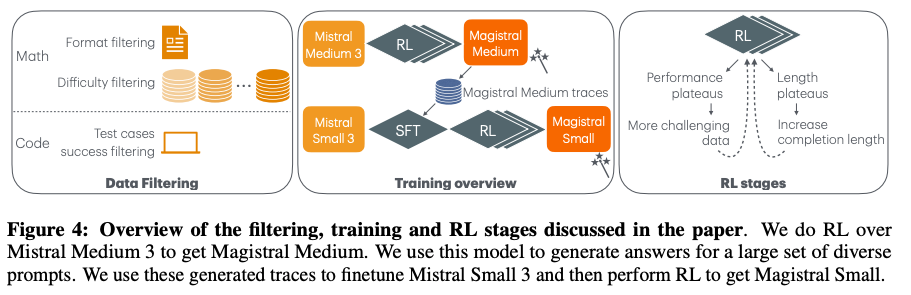
2種類のモデルを作成
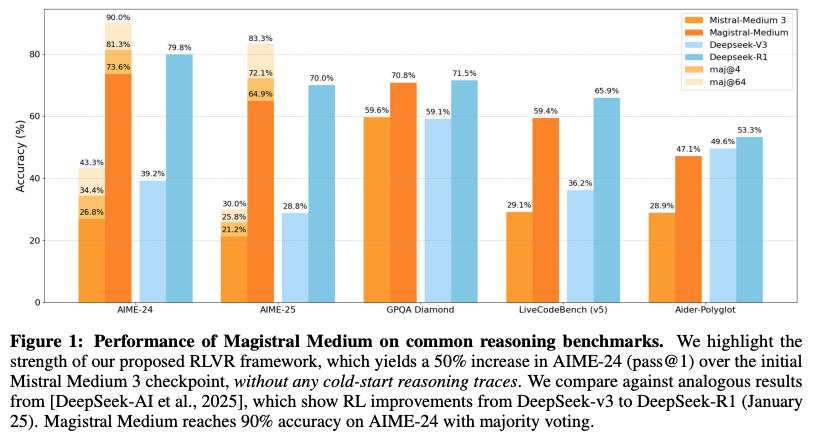
- Mistral Medium 3 → RL → Magistral Medium
- 学習中モデルパフォーマンスが高まるにつれてデータの難易度を上げていく
- 生成する列の長さが短いままにならないよう、length penaltyを受けない長さを少しずつ長くしていく(16k → 24k → 32k)
- 生成する列の長さを伸ばすにつれて、バッチサイズを落としてメモリを抑える
- DeepSeek-v3 → R1よりも大きな改善幅に
- Mistral Small 3 → SFT (w/ Magistral Medium) → RL → Magistral Small
- SFT: Magistral Mediumの訓練中に得られた、正しく短すぎないCoT+最終回答のトレースと、外部ソースの問題をMagistral Mediumに解かせて得られた回答を利用
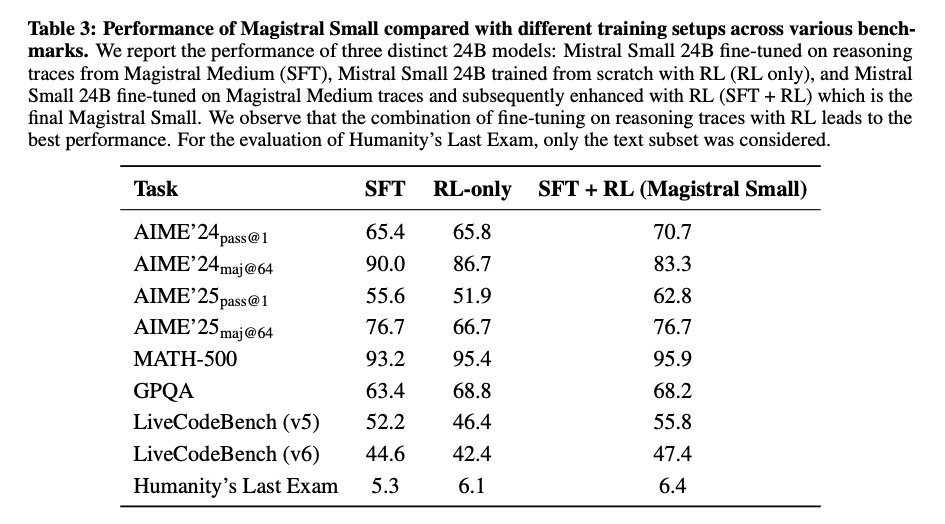
- SFT, RL単体よりも、SFT + RLが高性能
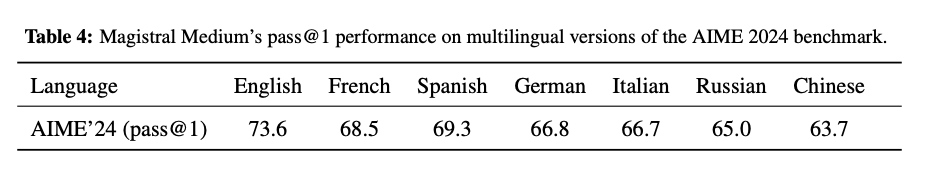
言語ごとの性能
分析
学習の進み方
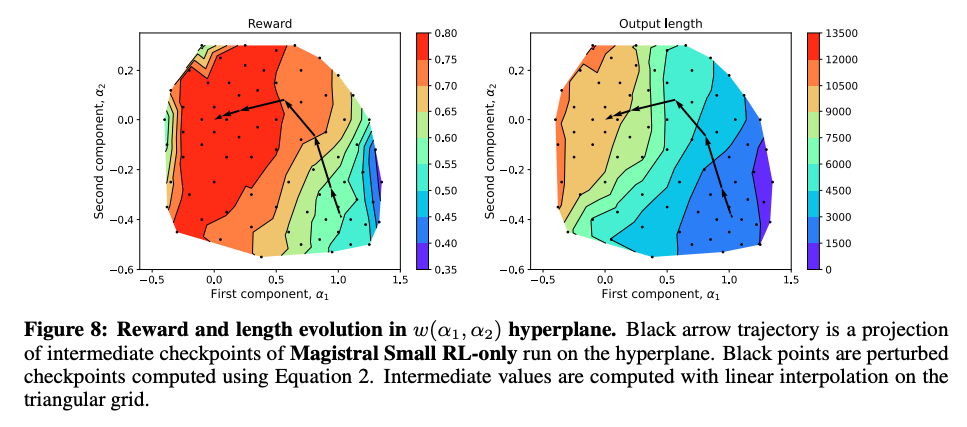
- チェックポイントごとに、重みをPCAで二次元化 & 回帰分析
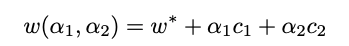
- 学習が進むにつれて、Reward, Output Lengthの大きくなる方向に進んでいる。Lengthは最大許容長まで増加。
マルチモーダル性能
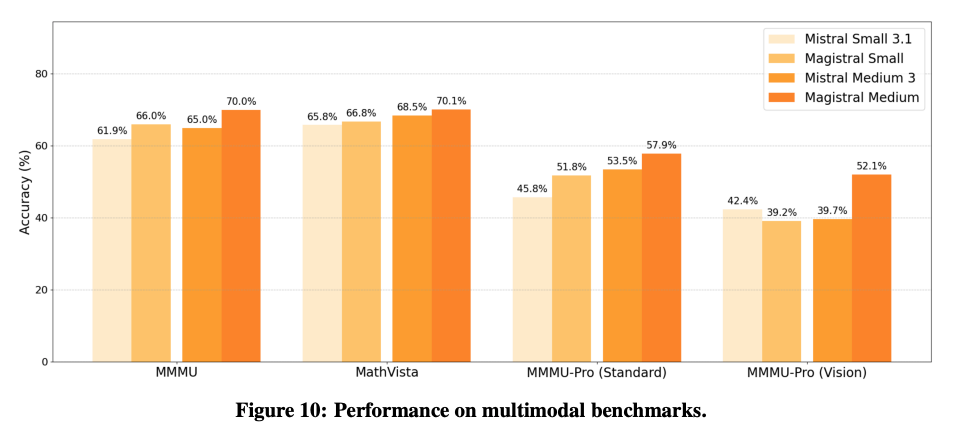
- 学習にはテキストデータしか利用していないが、マルチモーダルベンチマークで精度改善を確認
ツール利用・Agent性能
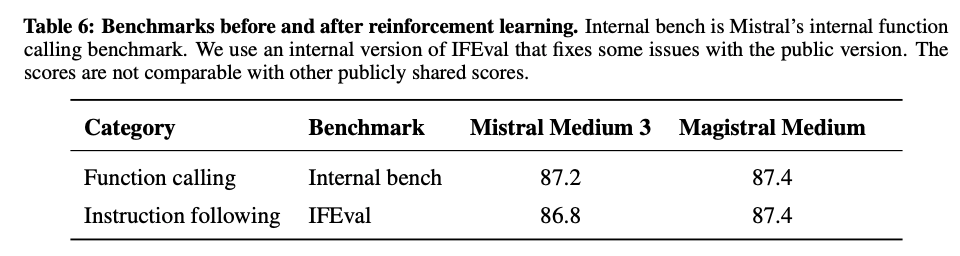
- Function calling, Instruction followingの改善も確認
うまくいかなかったこと
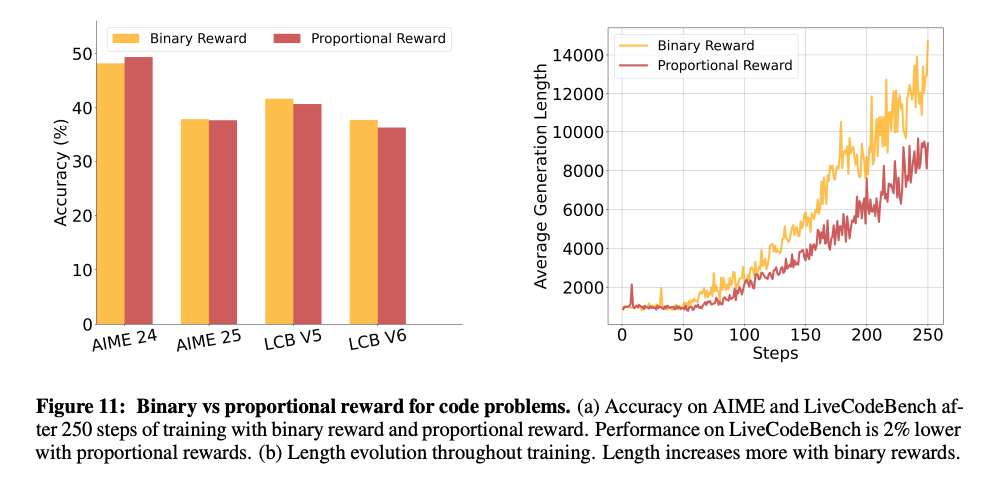
コーディングに対して、正解/不正解ではなく、テスト合格率に応じた報酬を与える
- 報酬の情報量は増えるが、間違った回答に関するsignalが入ることがノイズになり、性能がやや低下し、生成長も短くなる結果に。
エントロピーターゲティング
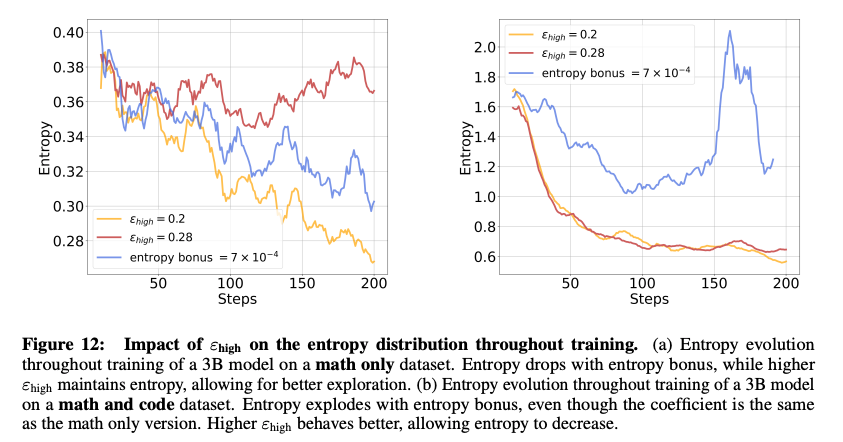
- PPOで利用されているentropy bonus(現在のポリシーと状態とのエントロピー)は、データセットによって作用の仕方が大きく異なる
- 左のmathデータセットでは、clip幅の上限を制御する を上げた方がよりエントロピーを増やせている
- 右のmath+codeデータセットでは、entropy bonusを使った時のエントロピーが大きくなりすぎている
- entropy bonus termよりも を使った方がコントロールしやすい