Accelerating Document AI
概要
- Document AIについてまとめられたhuggingfaceのブログ
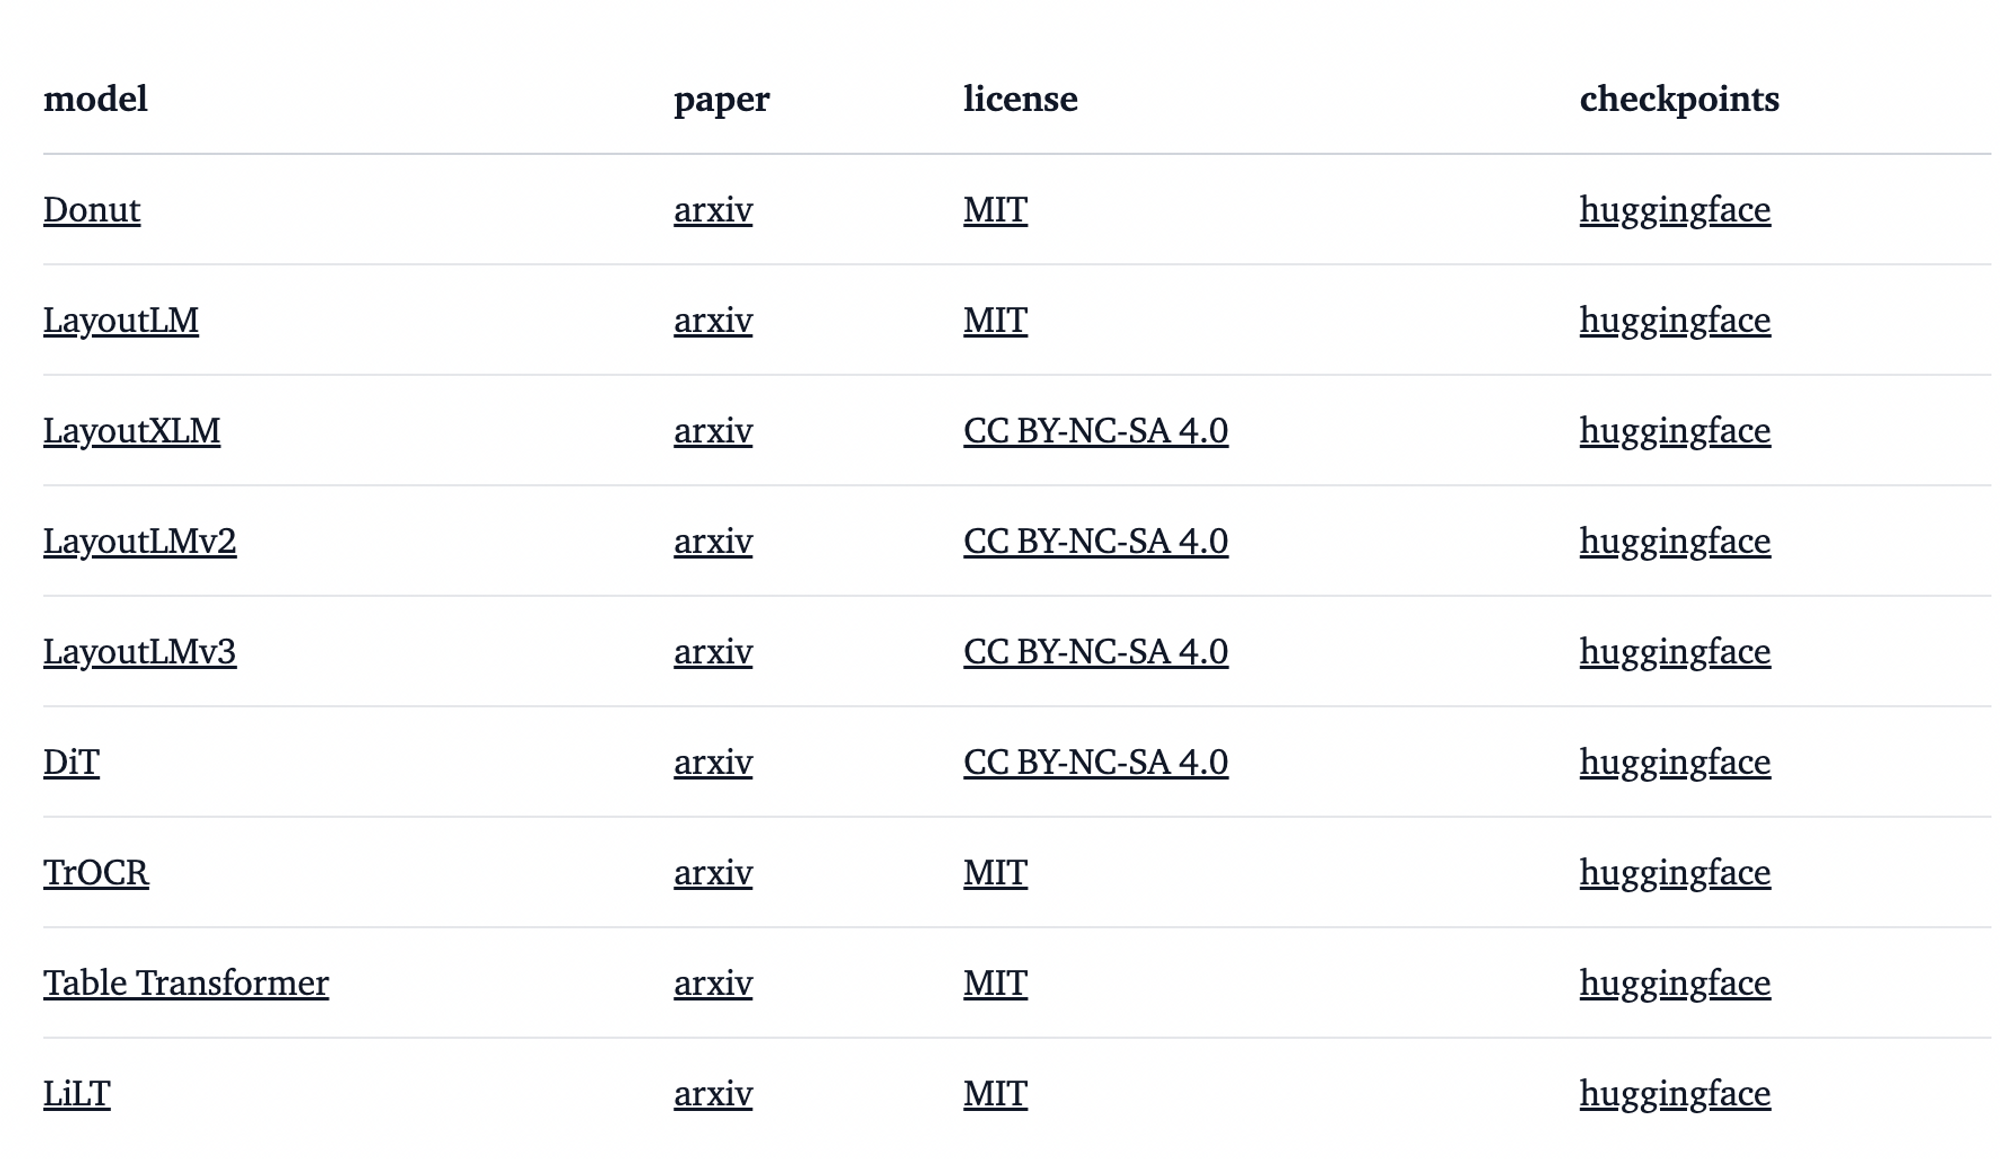
- 代表的な手法やオープンソースで使えるモデル、データセットなどについても紹介
- ライセンスの注意点にも言及されている
一部抜粋
What are Modeling Issues in Document AI?
モデルを柔軟に構築できるため、データサイエンティストには多くの選択肢があります。私たちがチームに強くお勧めするのは、事前にトレーニングされたオープンソースのモデルから始めることです。これらのモデルは、特定のドキュメントに合わせて微調整することができ、一般的にこれが優れたモデルへの最短の道です。
独自に訓練済みモデルを構築することを検討しているチームは、数百万件の文書が含まれ、モデルの訓練に数週間かかる可能性があることに注意してください。事前訓練されたモデルを構築するには多大な労力が必要であり、ほとんどのデータサイエンスチームにはお勧めできません。その代わりに、まずは微調整から始めましょう。
モデルにOCRを処理させたいか?
例えば、DonutはドキュメントをOCRする必要がなく、直接フル解像度の画像で動作するので、モデリングの前にOCRする必要はない。しかし、問題の設定によっては、OCRを別に用意した方が簡単な場合もあります。
より高解像度の画像を使うべきですか?
LayoutLMv2で画像を使用する場合、224×224にダウンスケールされますが、Donutでは完全な高解像度画像を使用します。しかし、フル解像度の画像を使用すると、学習と推論に必要なメモリが劇的に増加します。
モデルの評価方法は?
ずれたバウンディング・ボックスに注意してください。選択したOCRエンジンが提供するバウンディング・ボックスが、モデル・プロセッサと一致していることを確認する必要があります。これを確認することで、予期せぬ悪い結果を避けることができます。第二に、プロジェクトの要件が評価指標を導くようにします。例えば、トークンの分類や質問に対する回答のようなタスクでは、100%の一致が最適な評価基準とは限りません。部分一致のような評価基準では、"Acme "と "inside Acme "が一致するなど、より多くの潜在的なトークンを考慮することができます。最後に、これらのモデルは偏ったデータを使用していたり、特定のグループに偏った不安定な結果を提供したりする可能性があるため、評価中に倫理的な問題を考慮してください。
チュートリアル
- Niels' Transformers-Tutorials