2026-09-15 機械学習勉強会
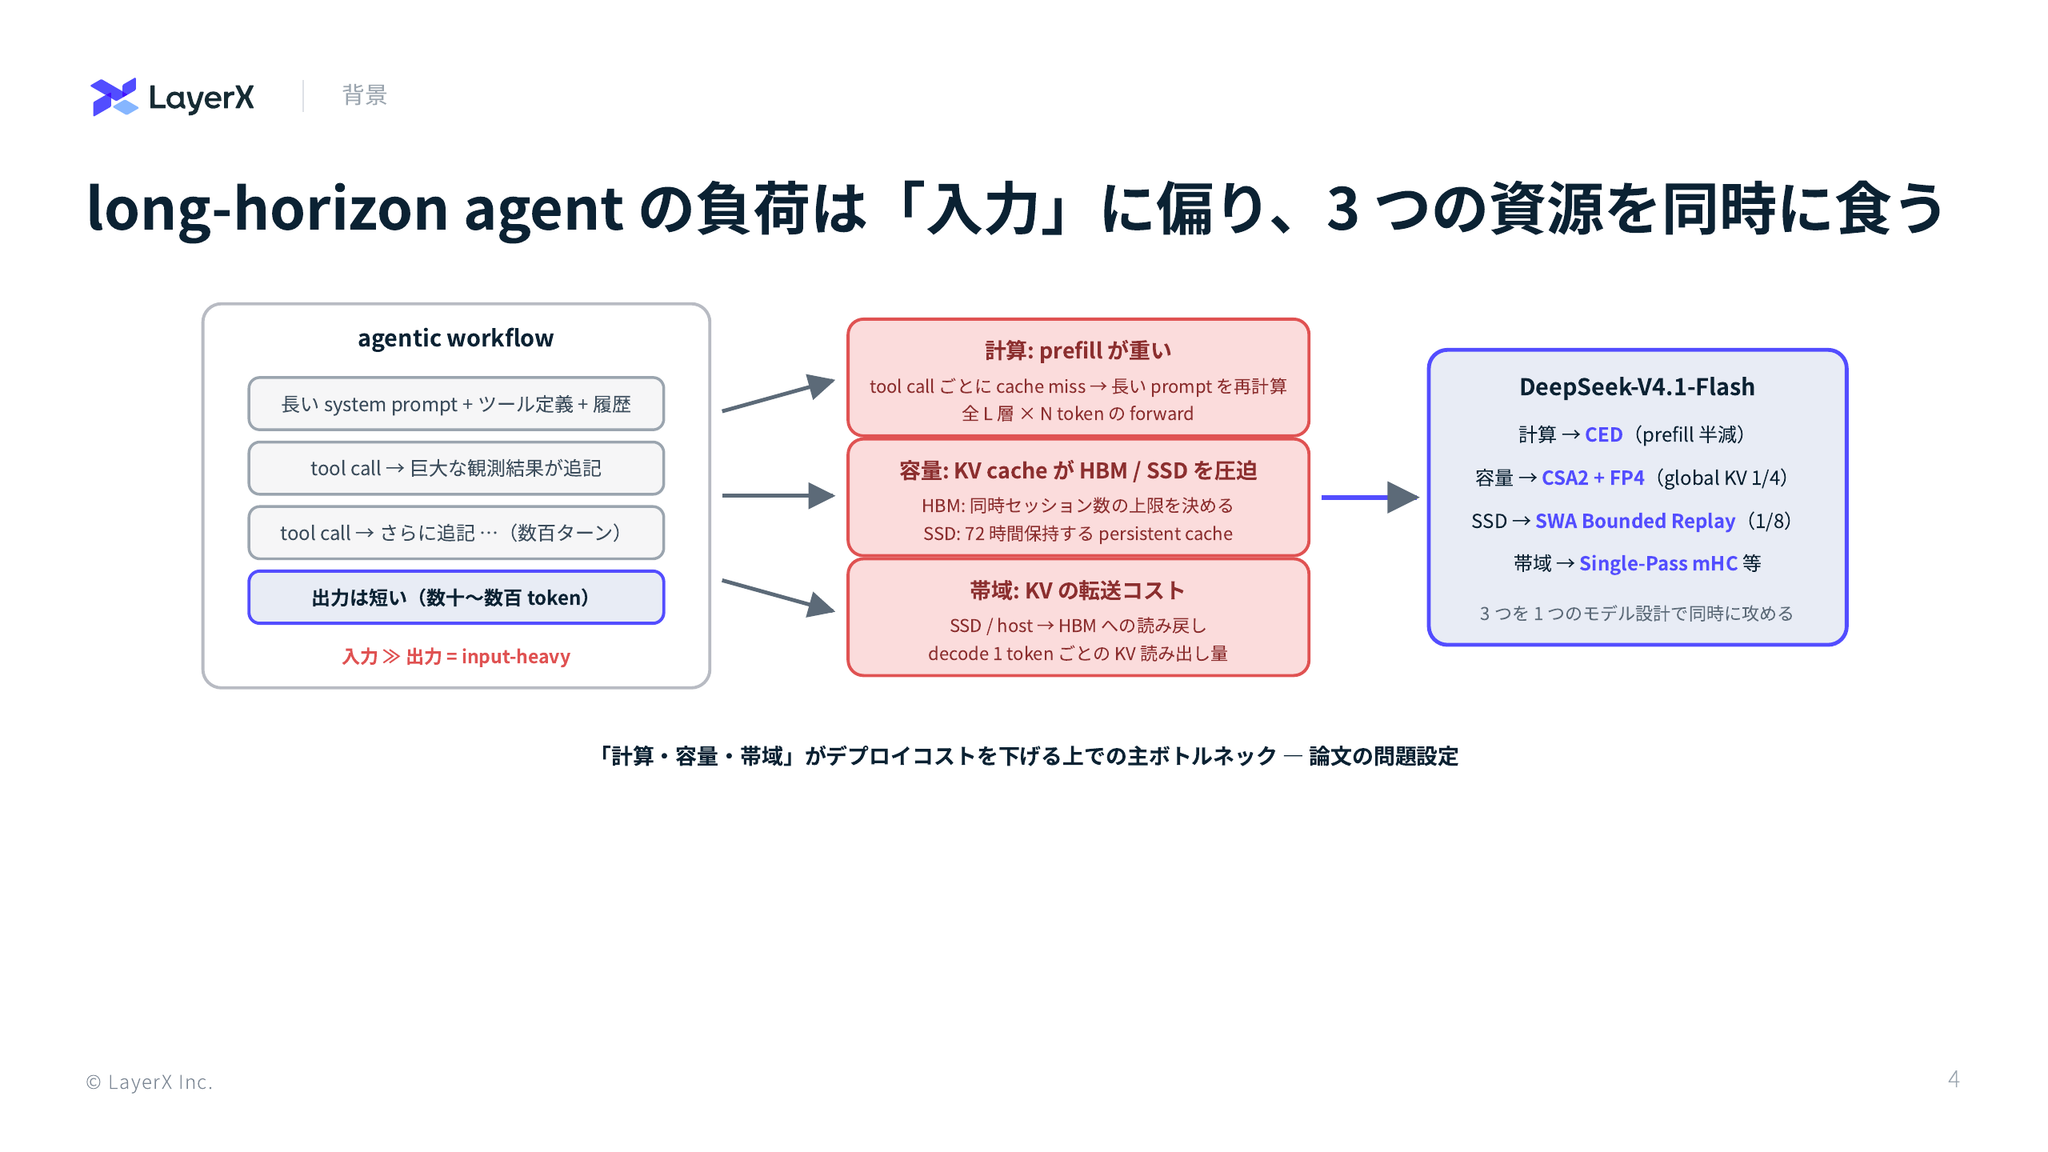
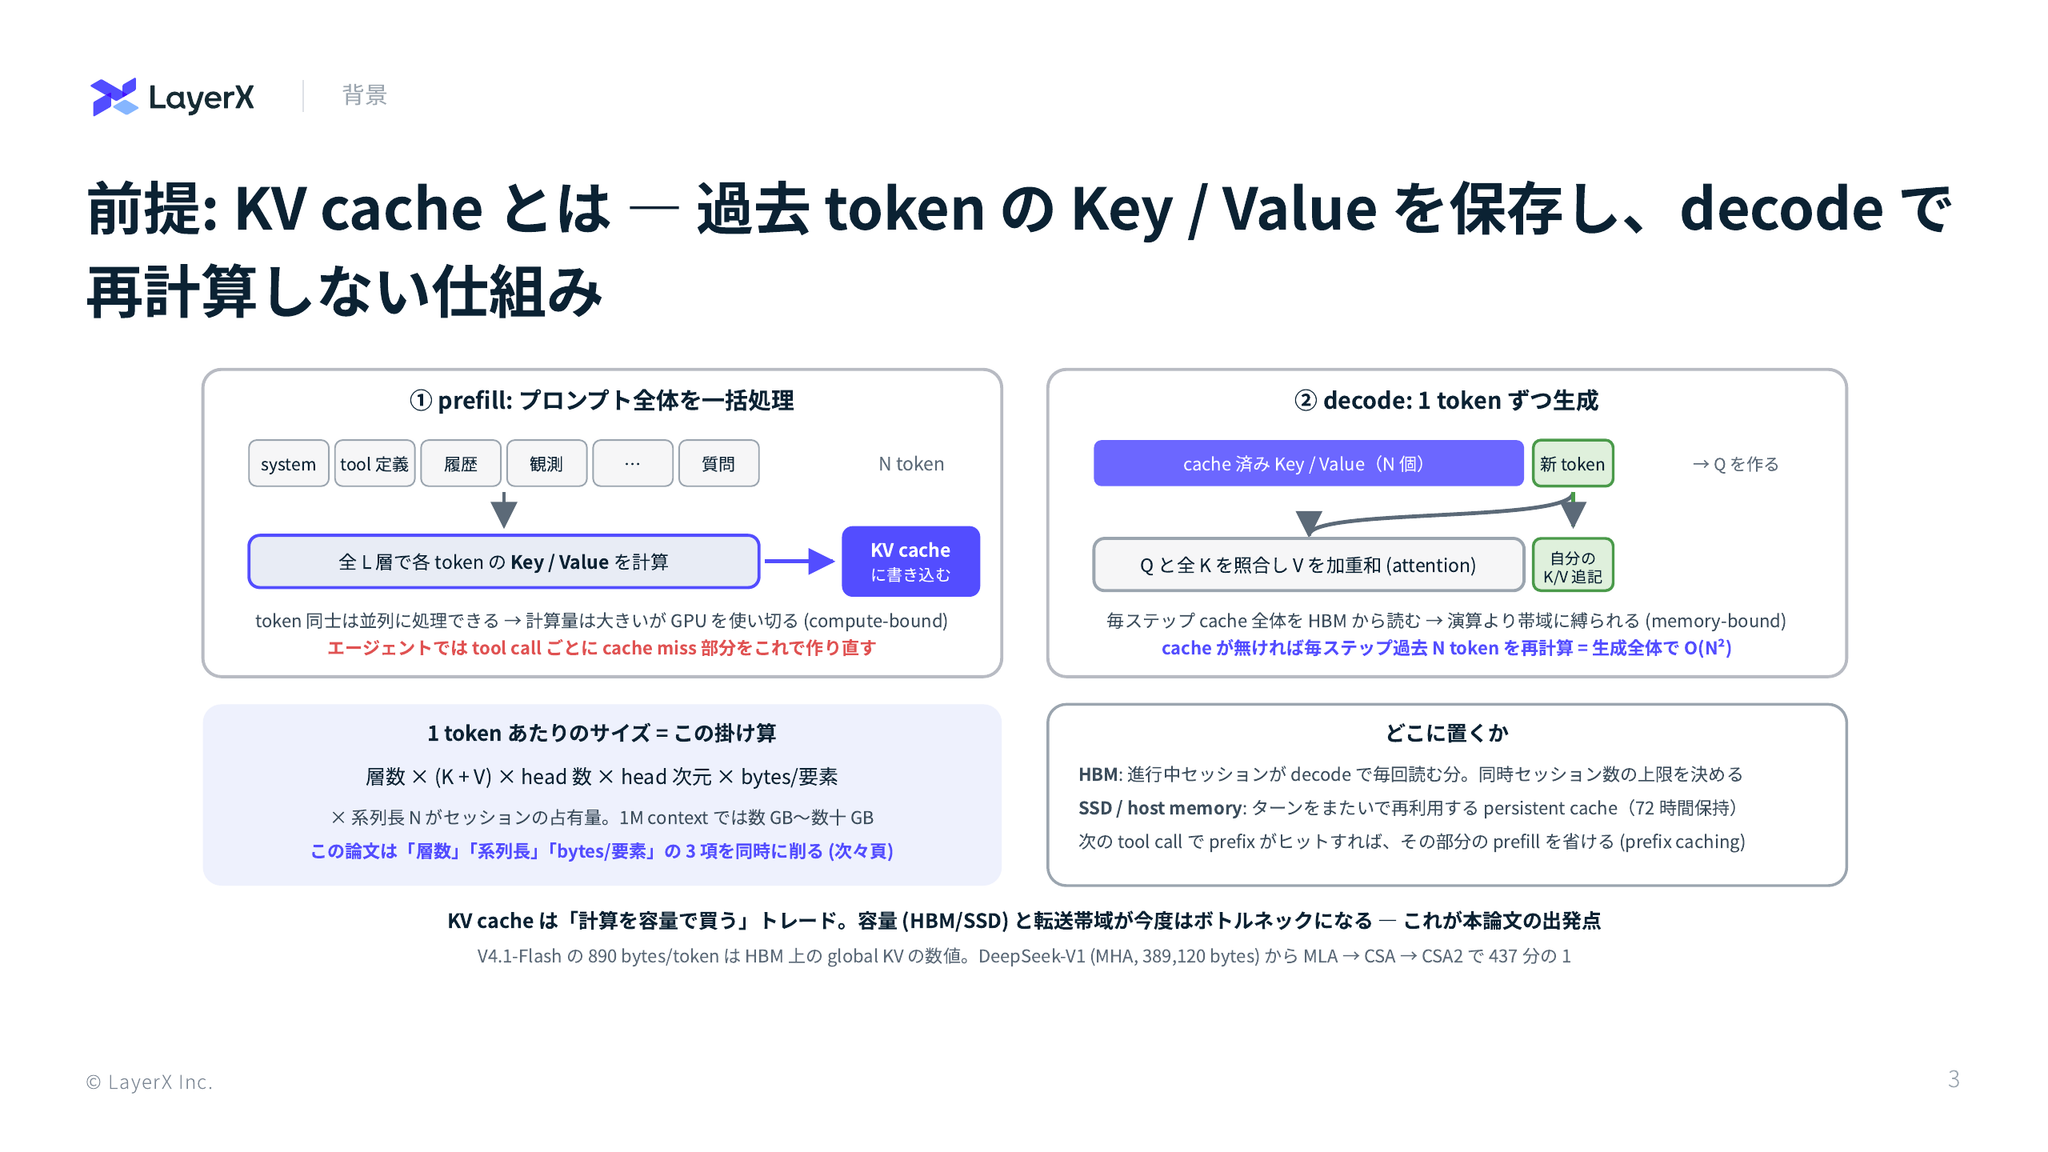
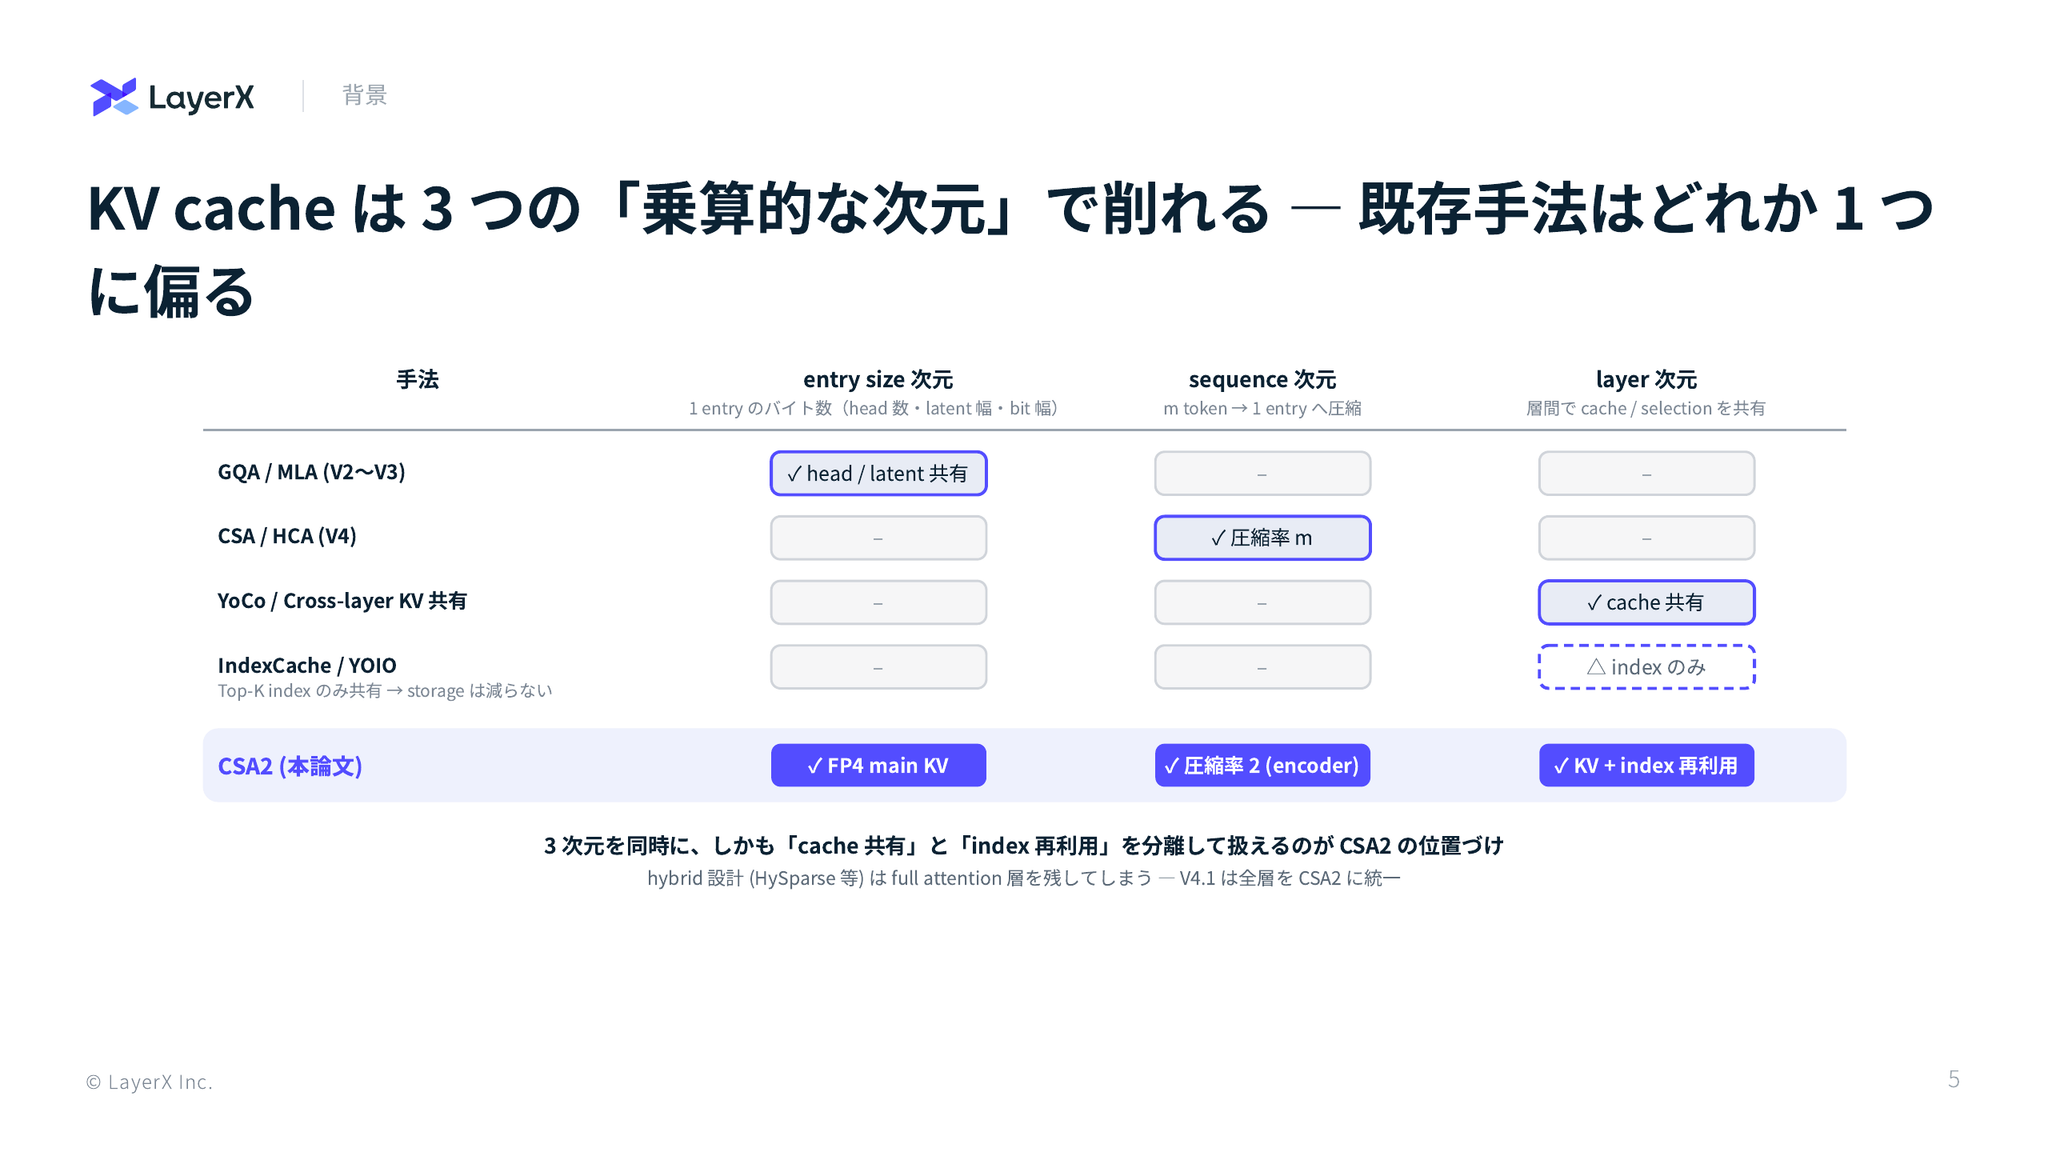
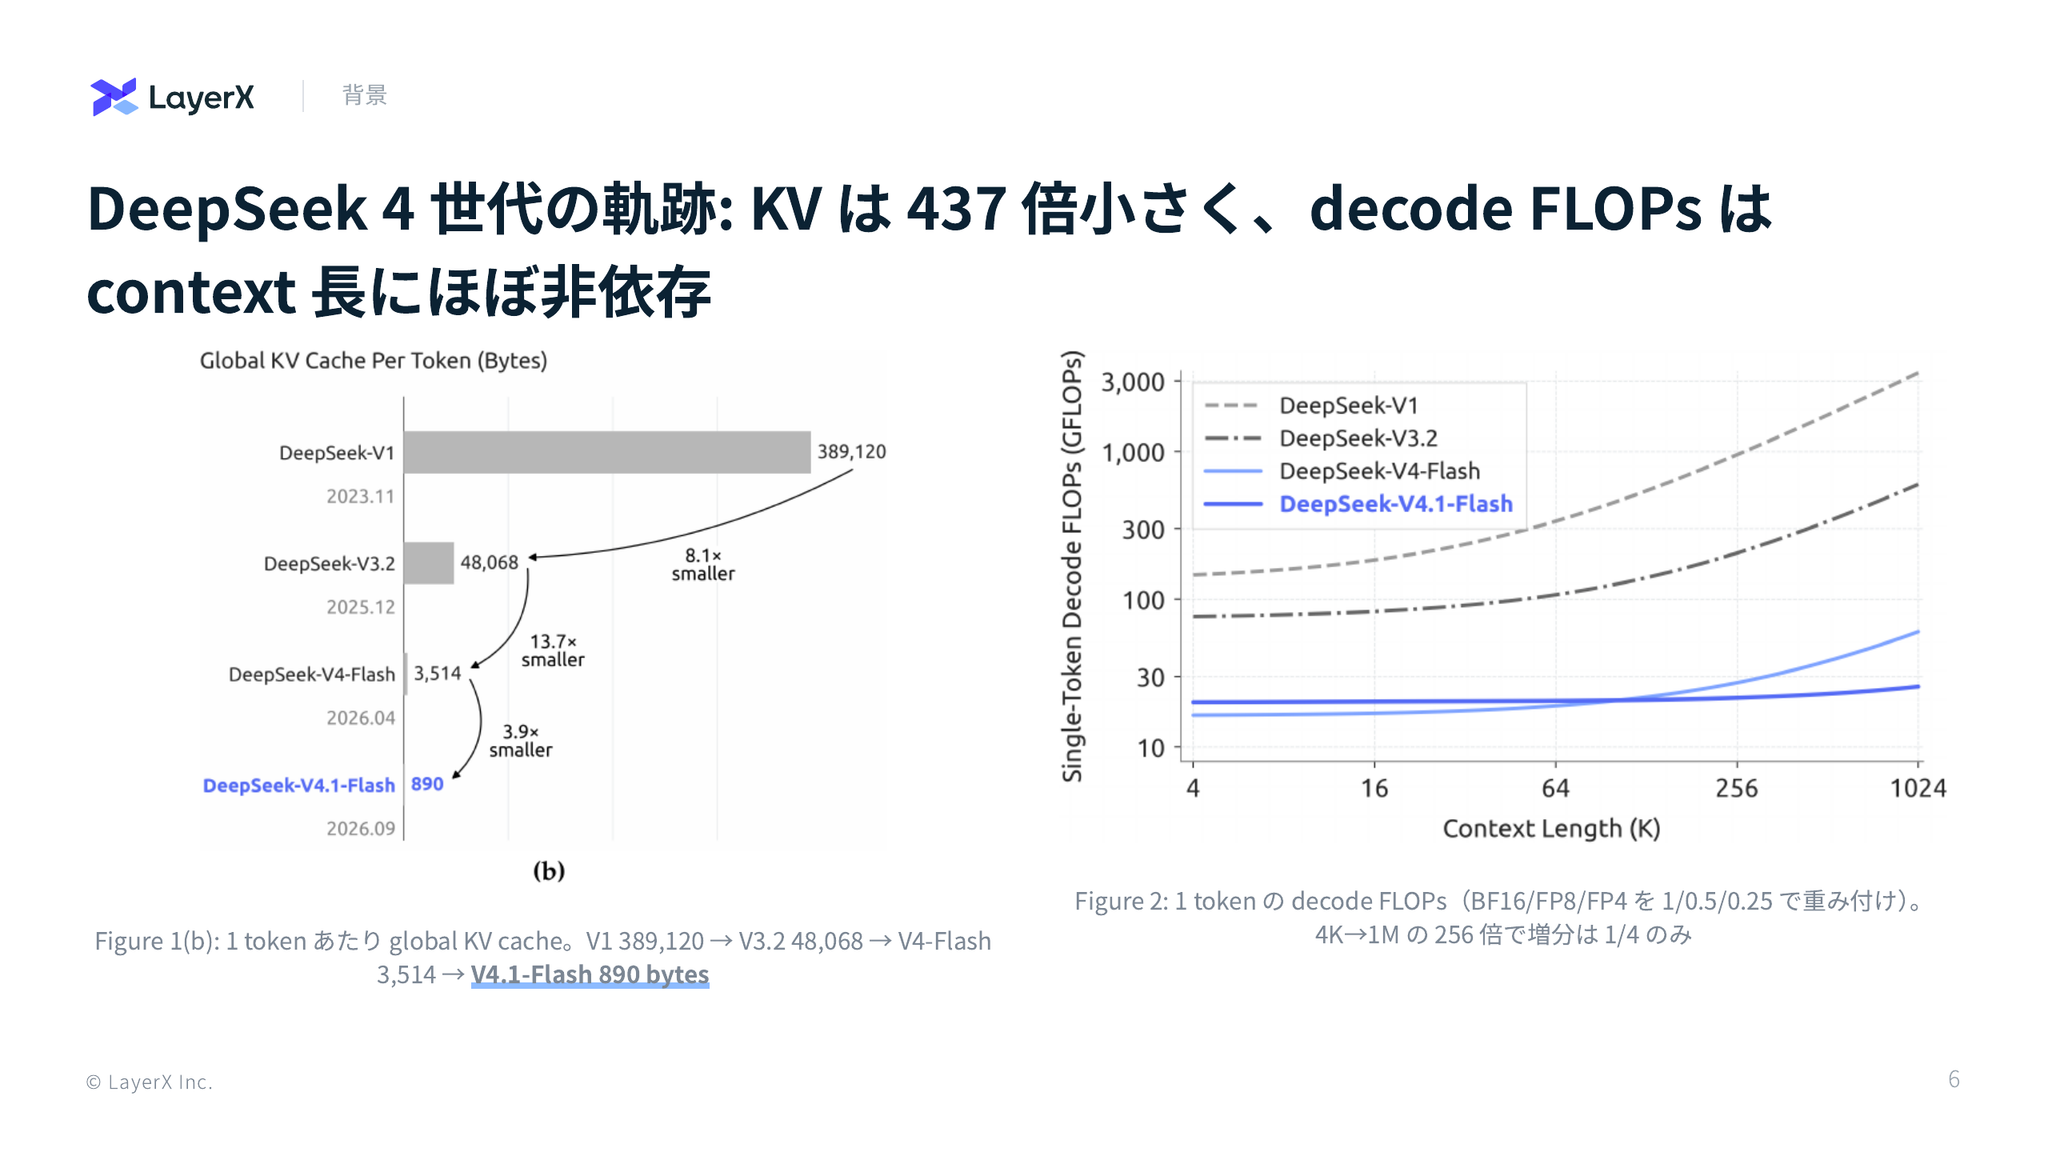
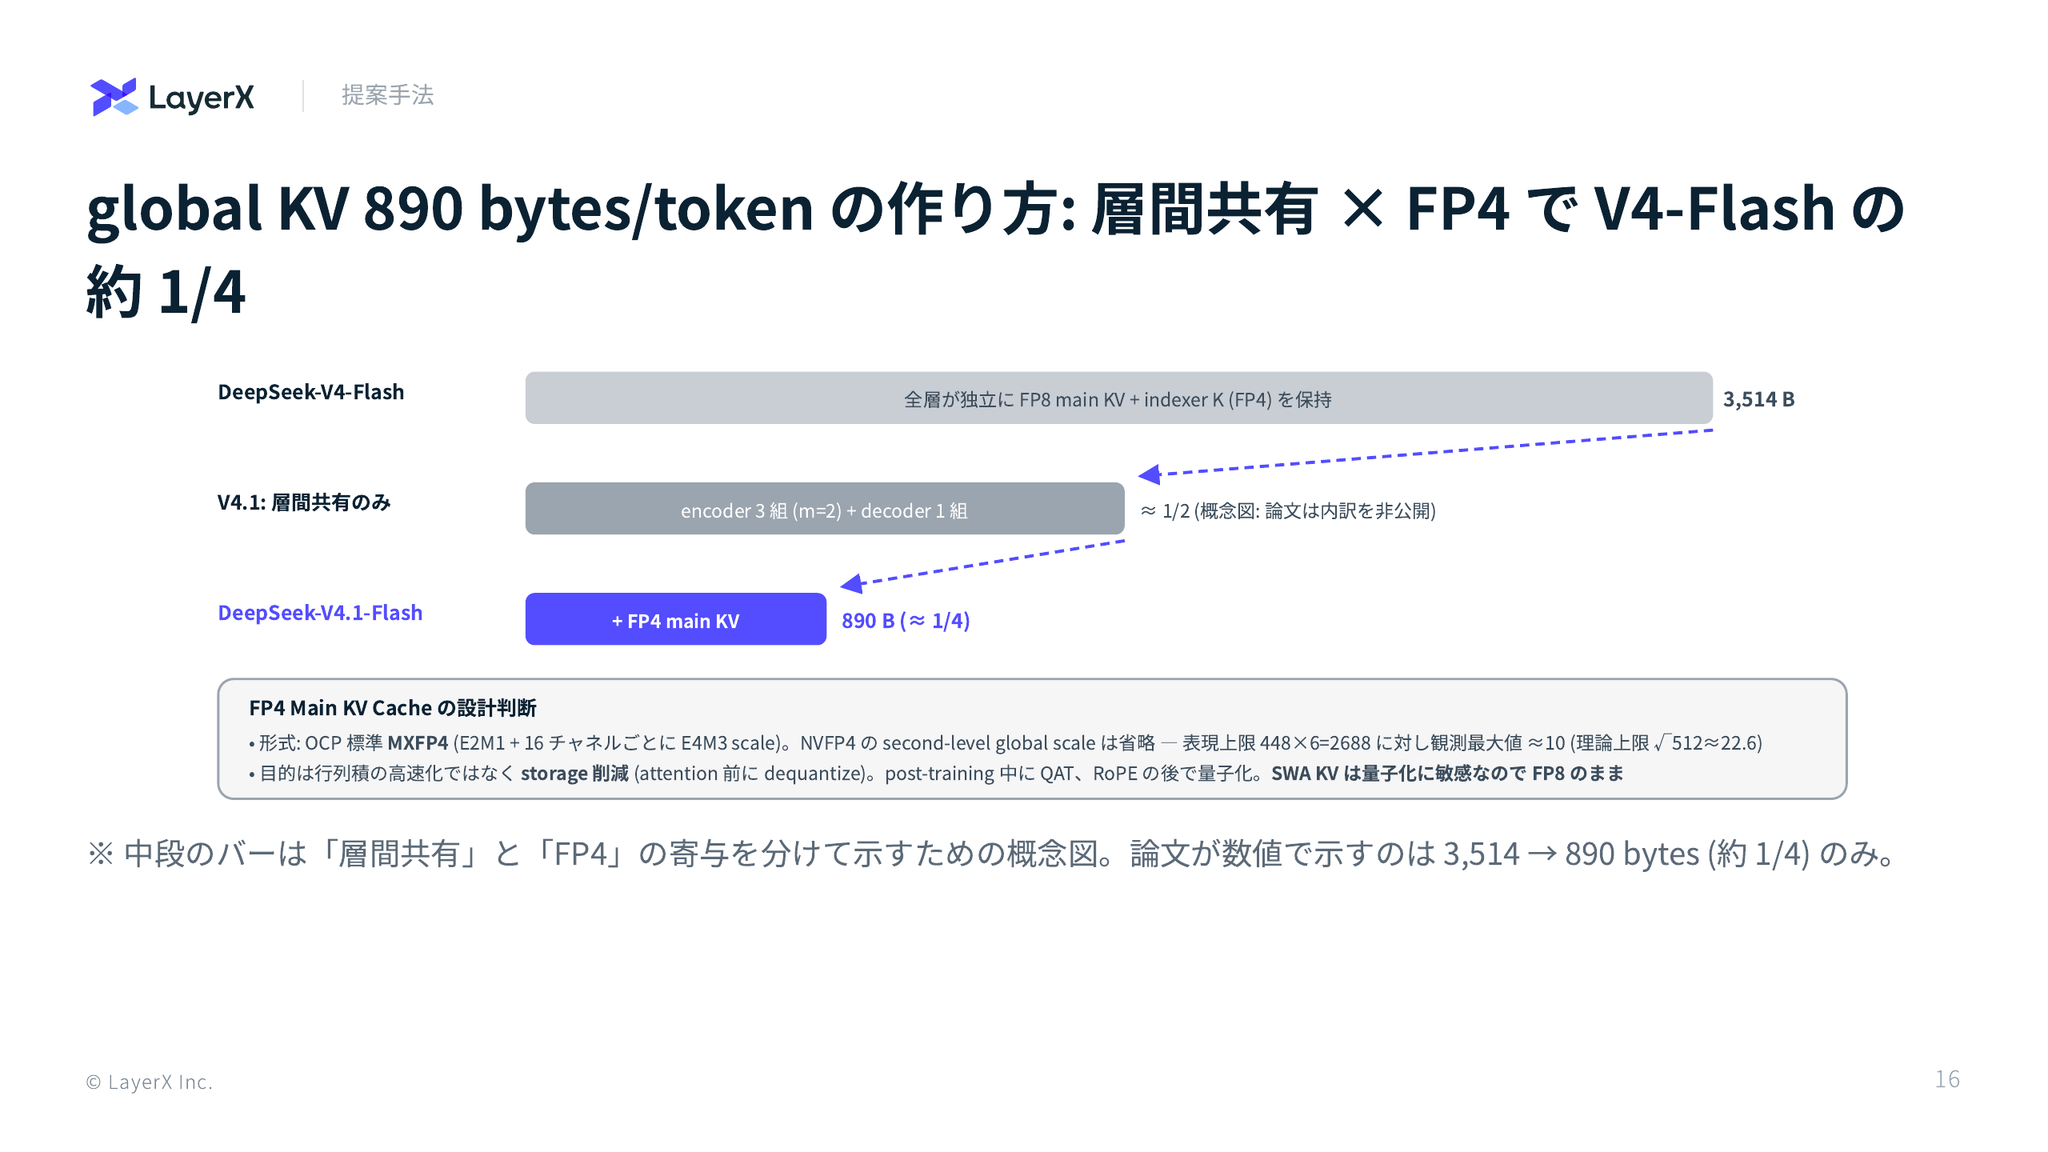
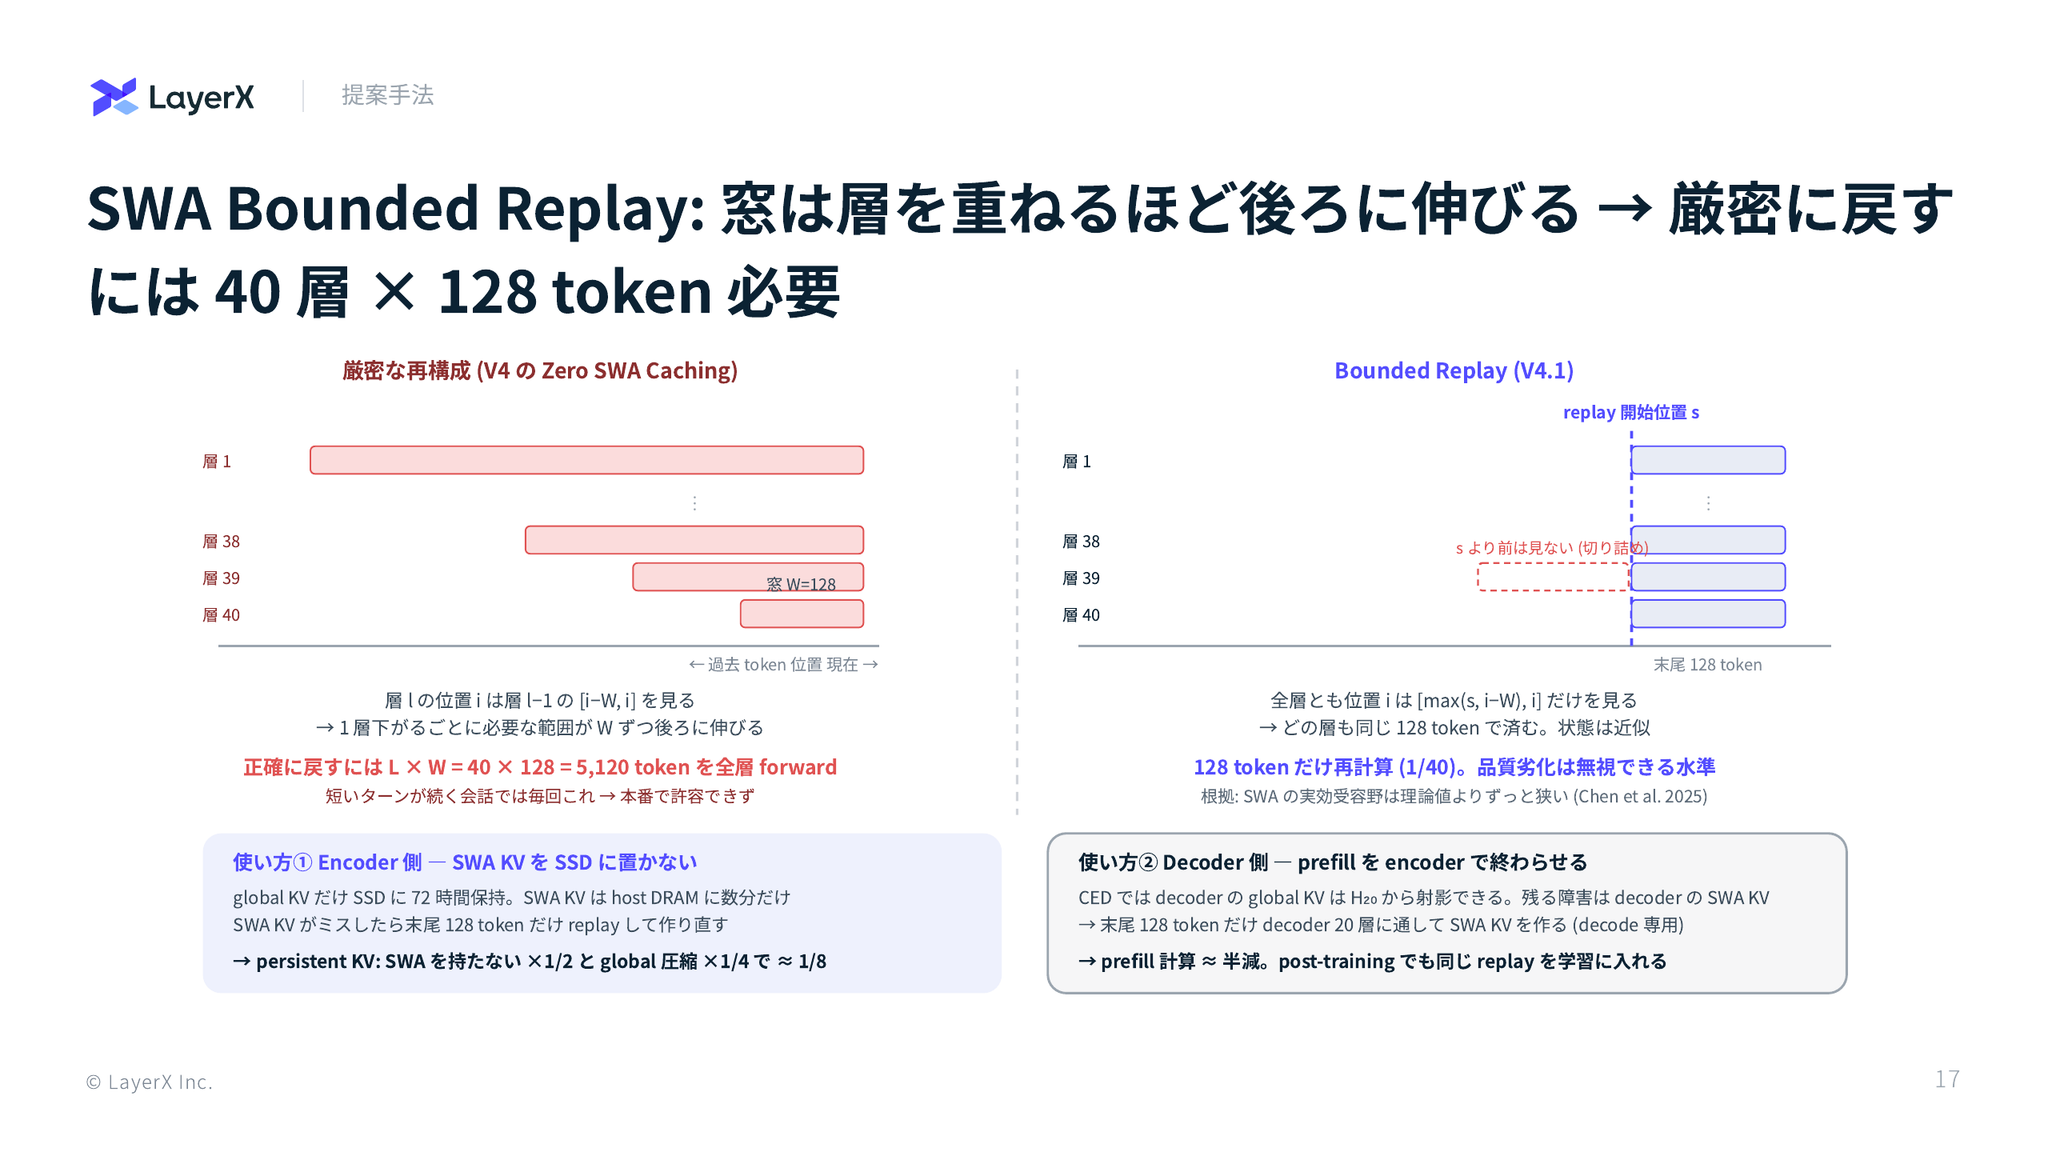
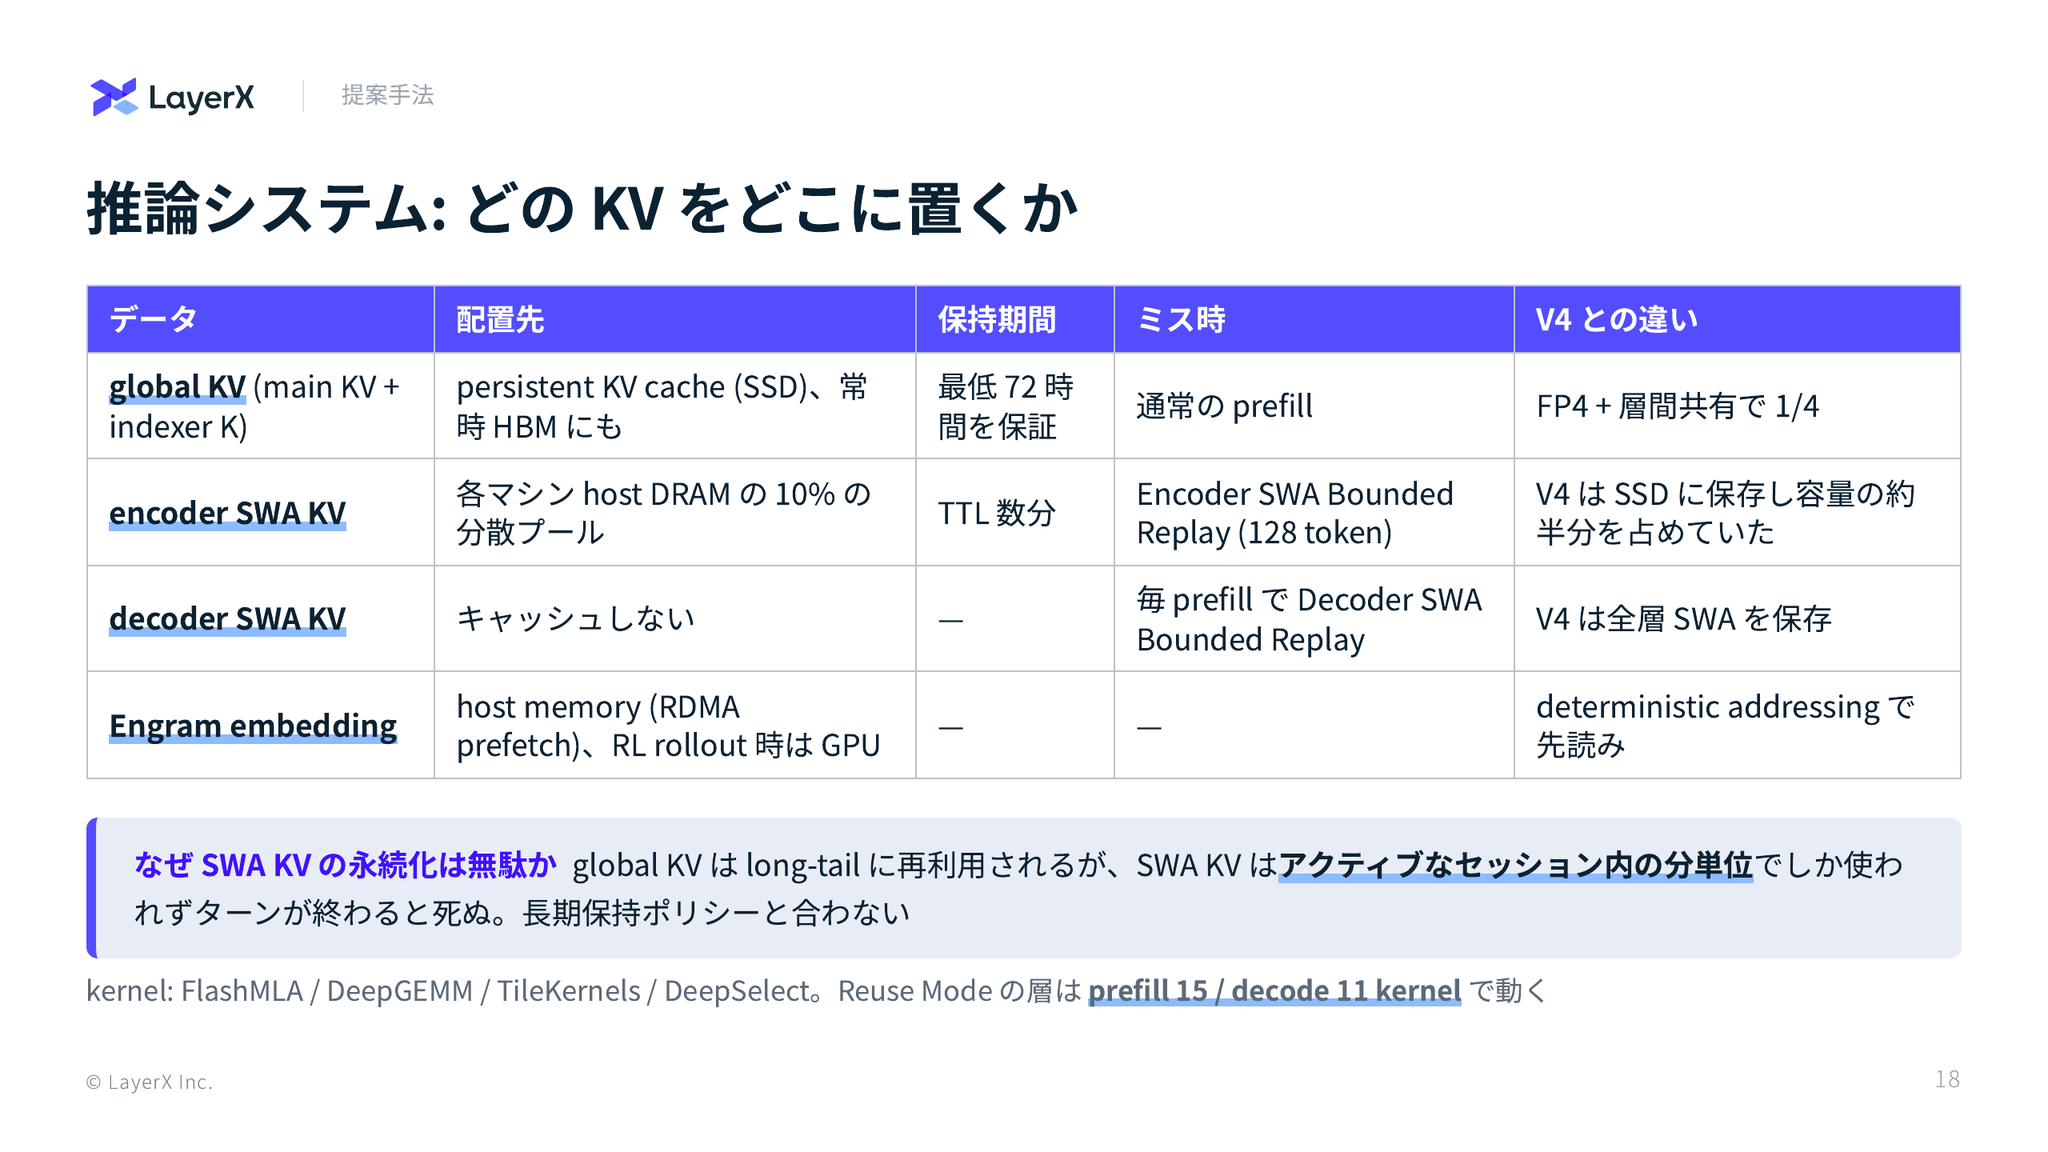
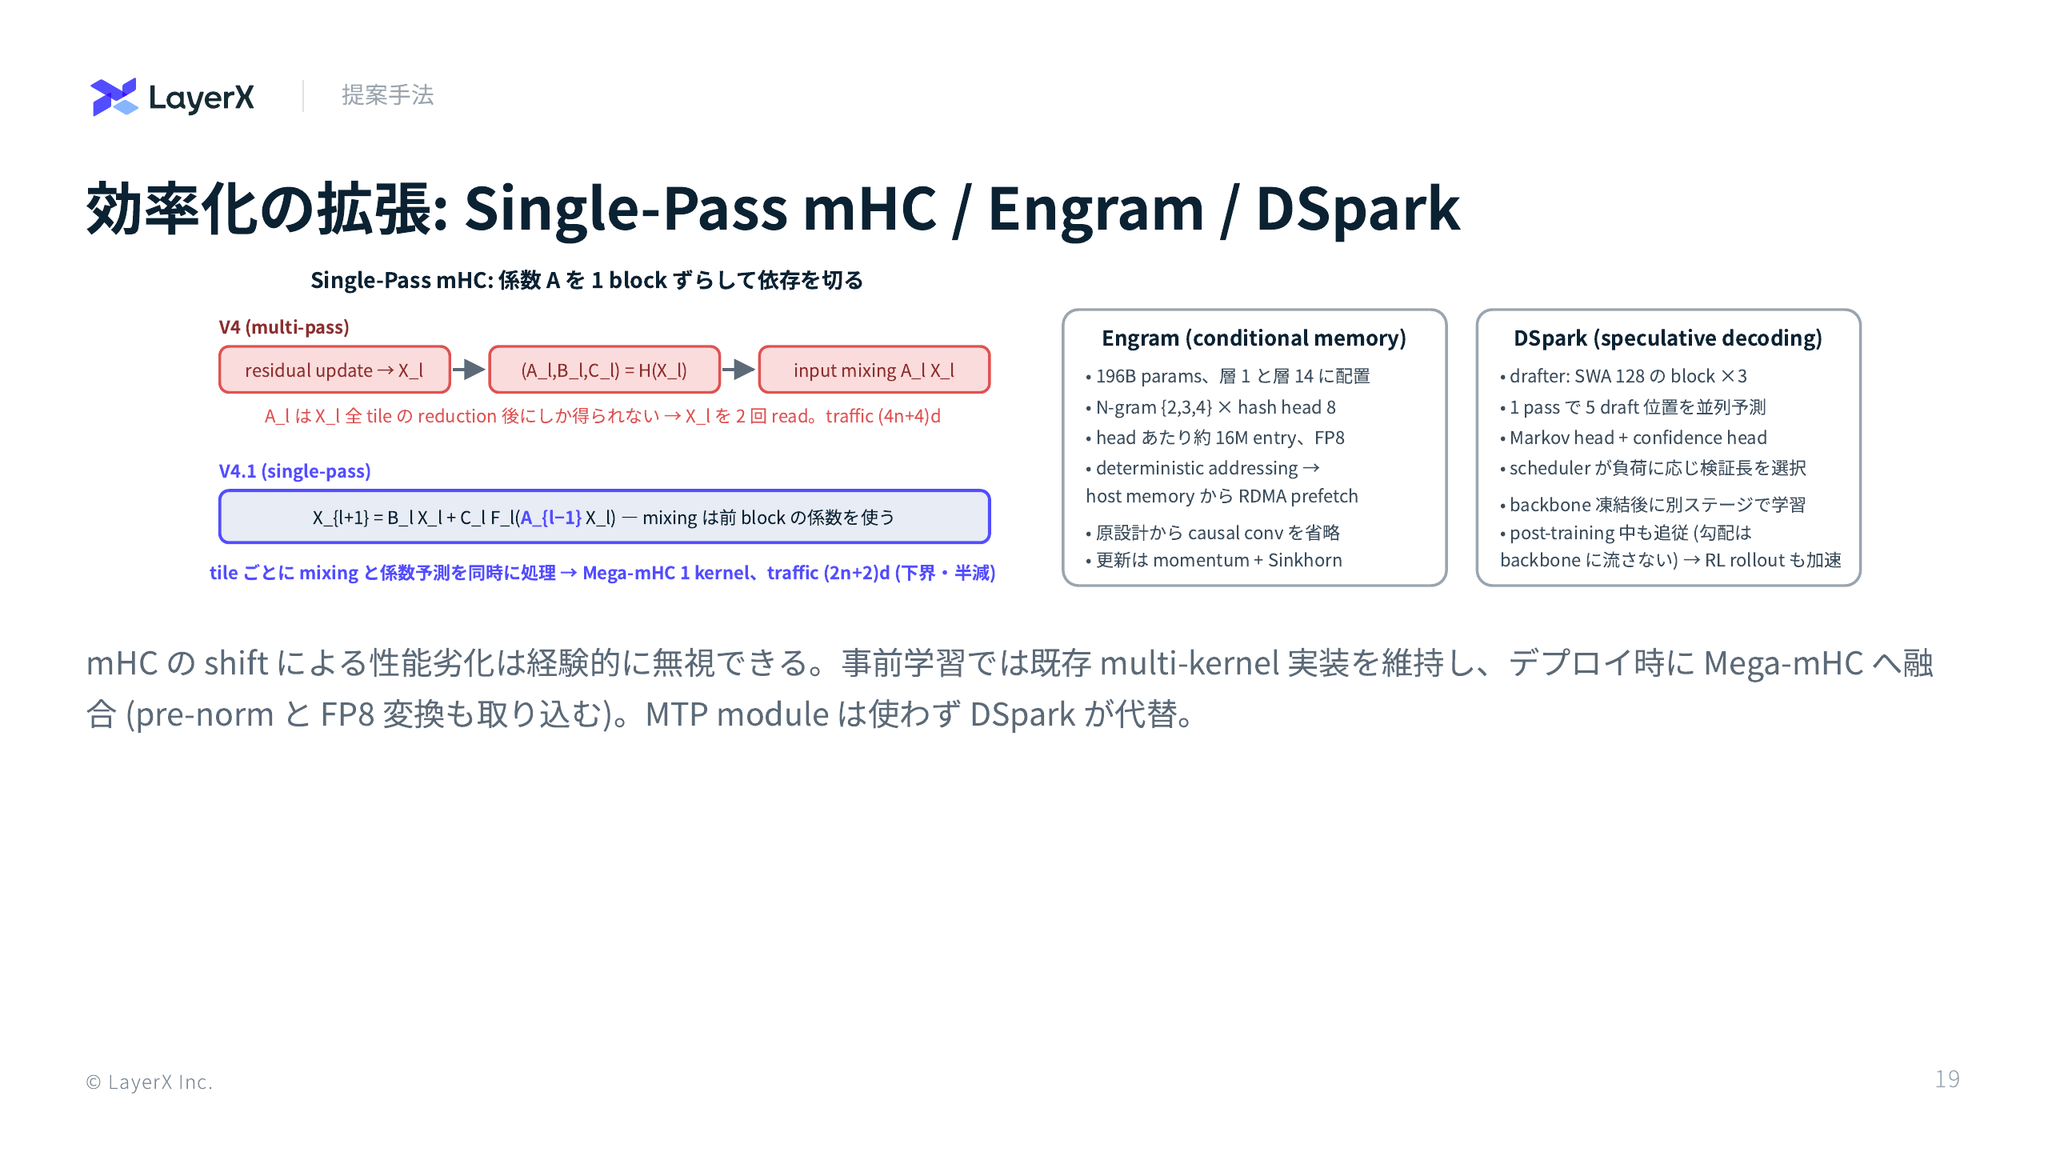
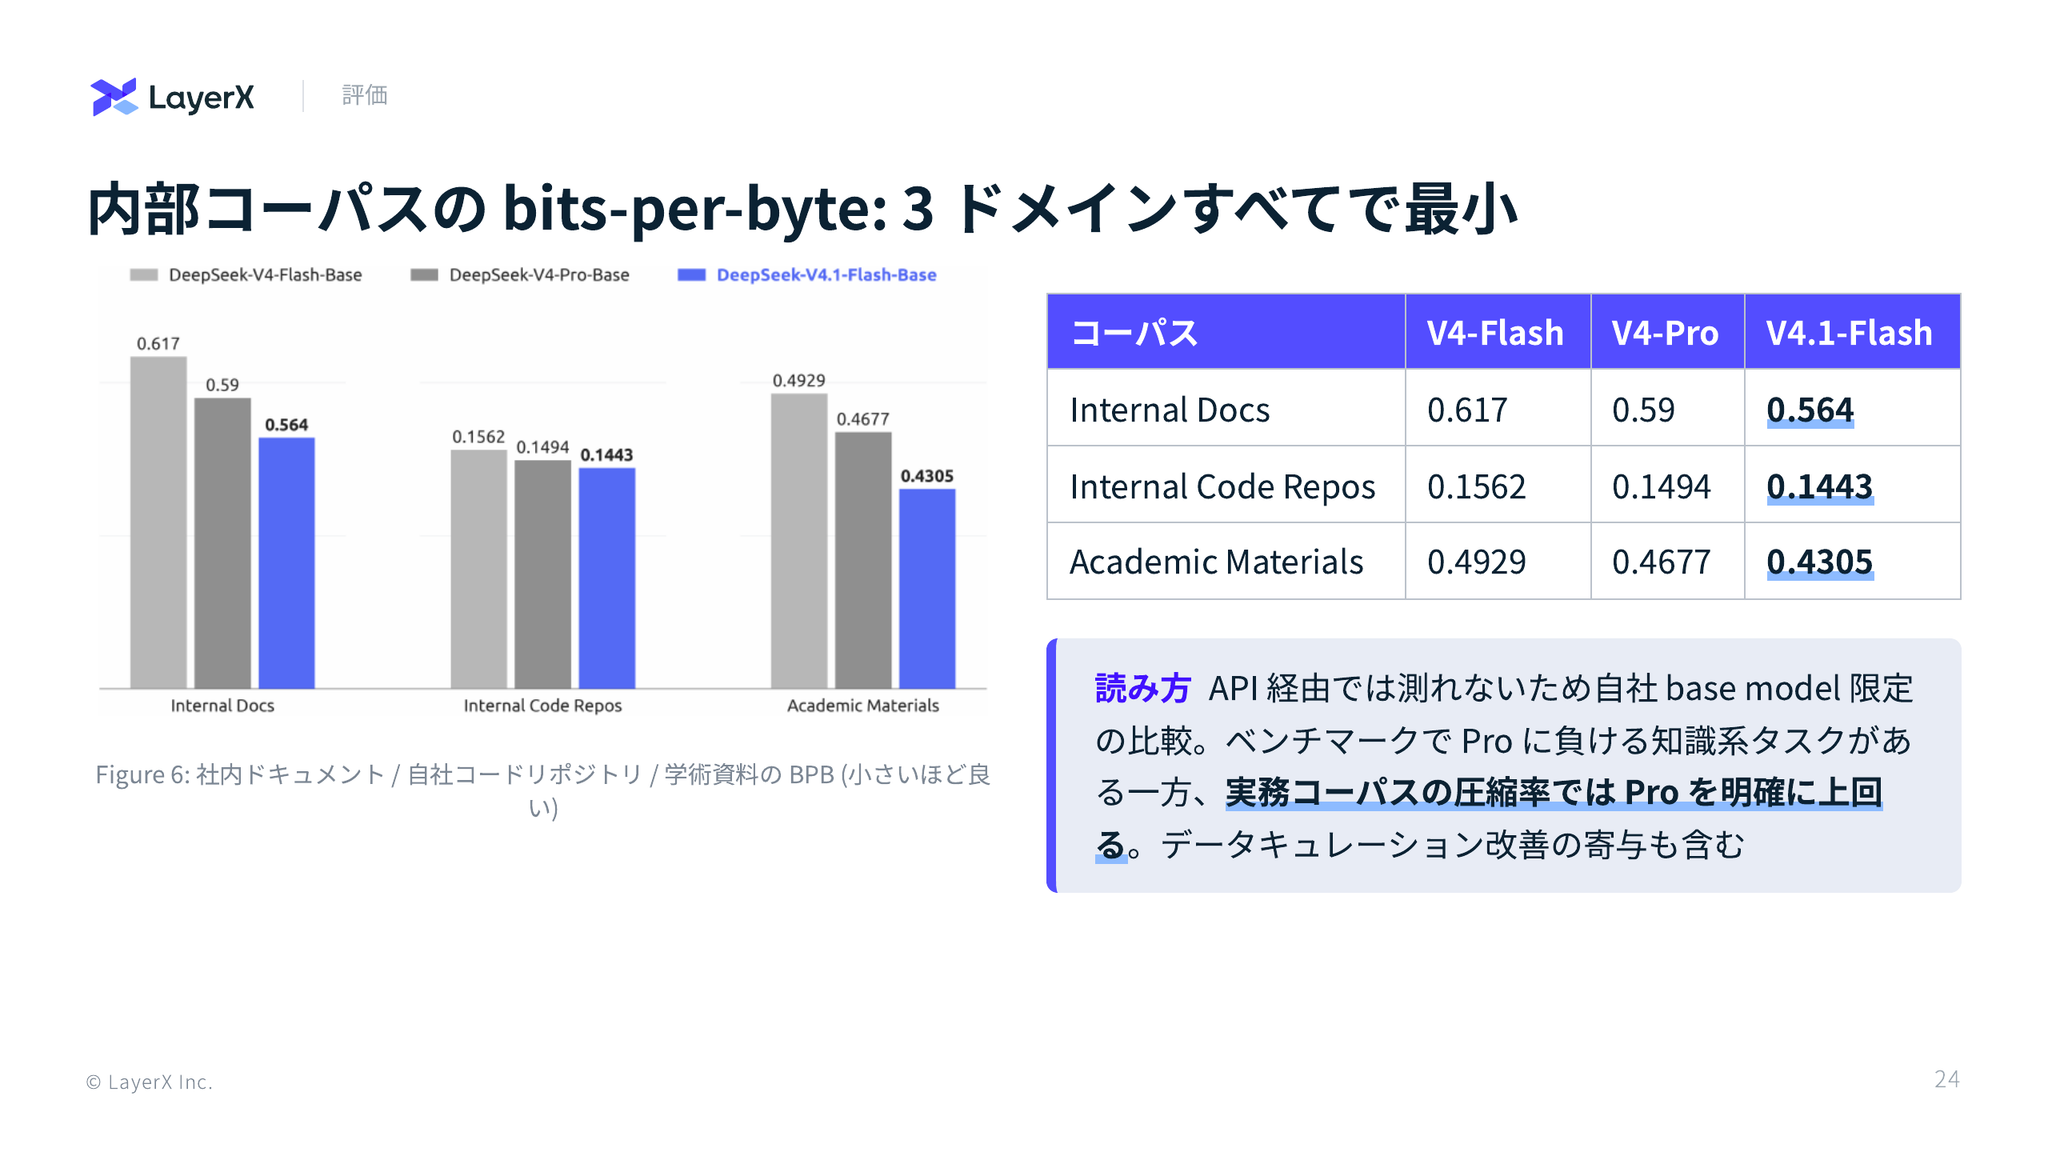
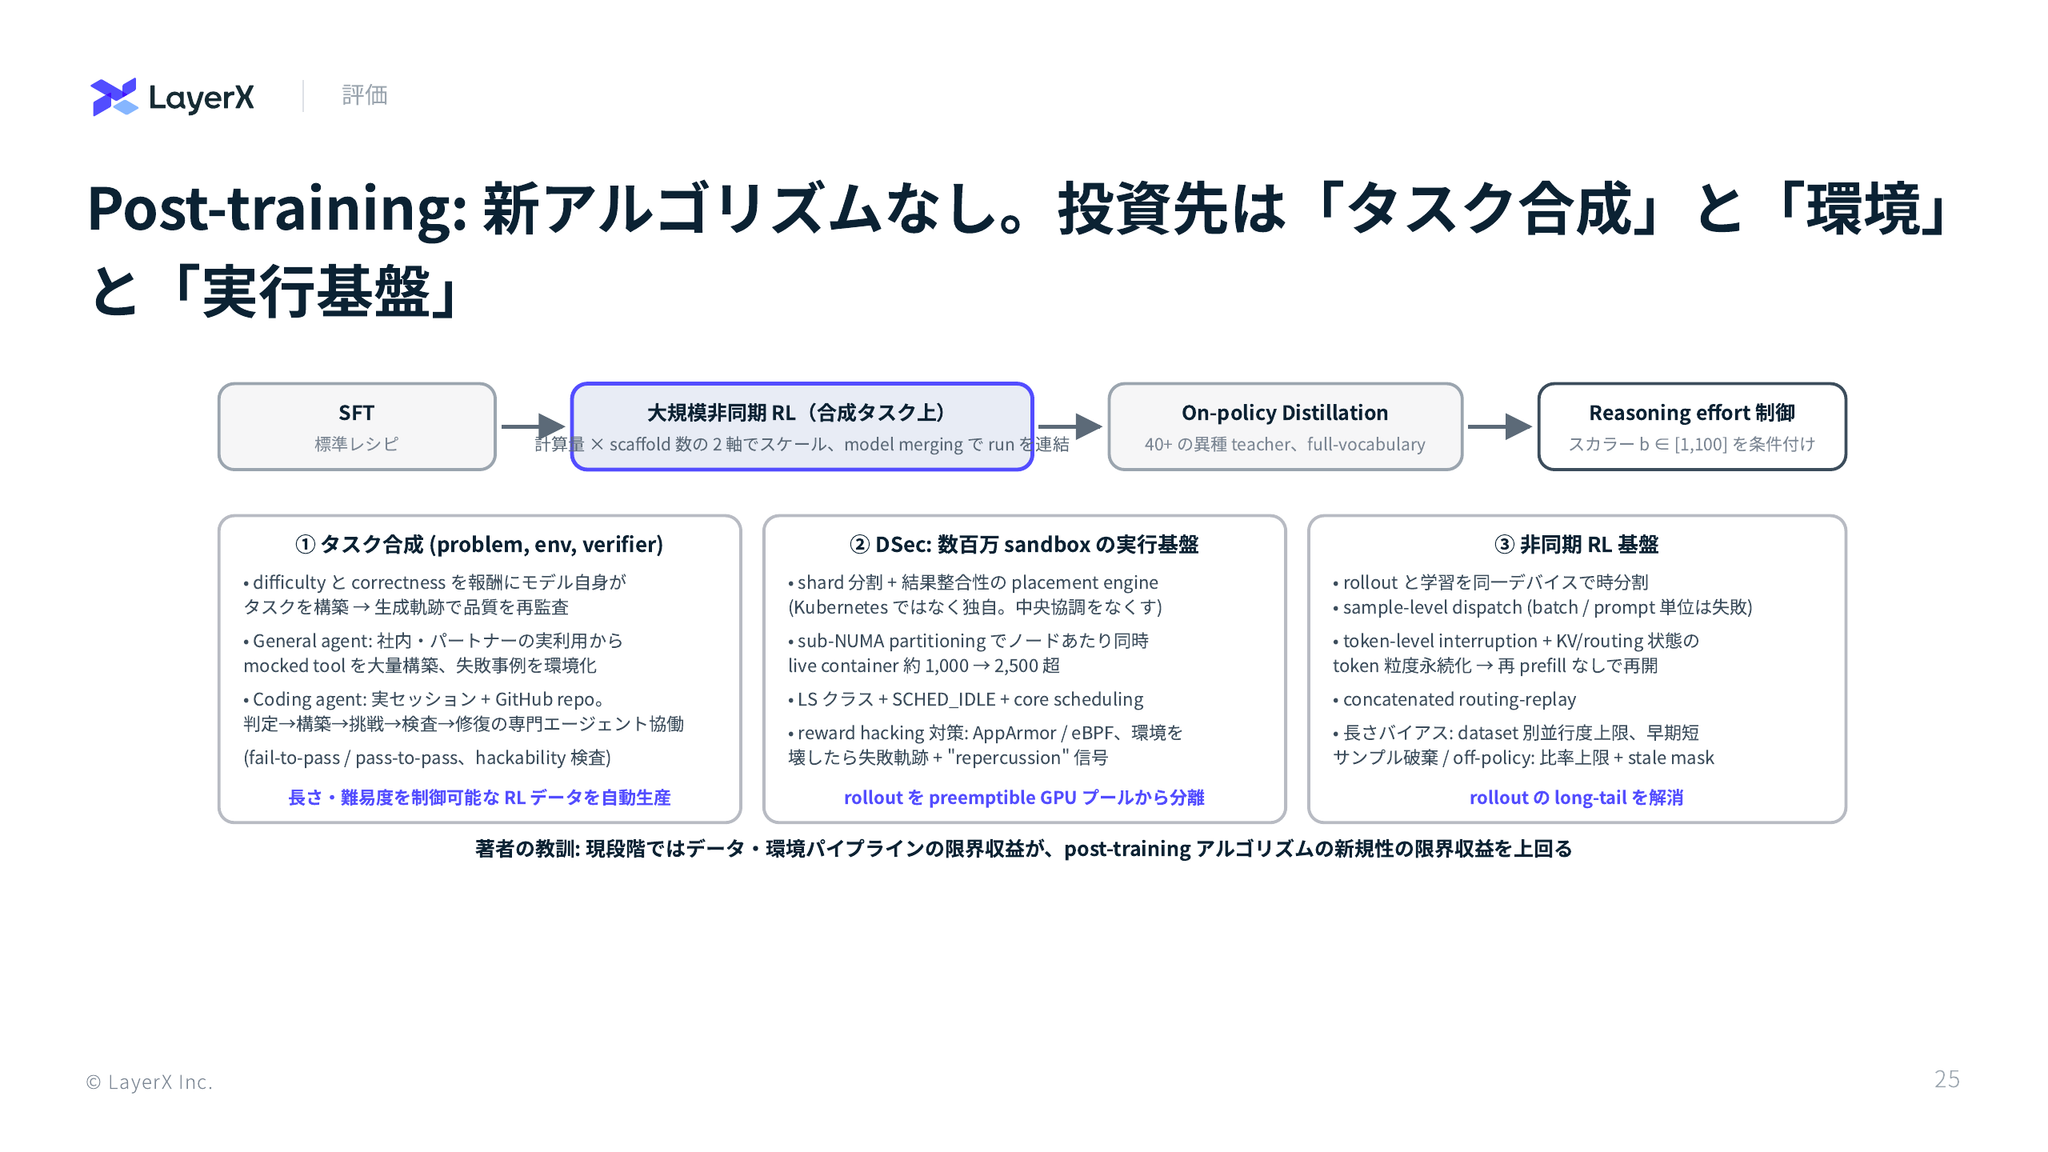
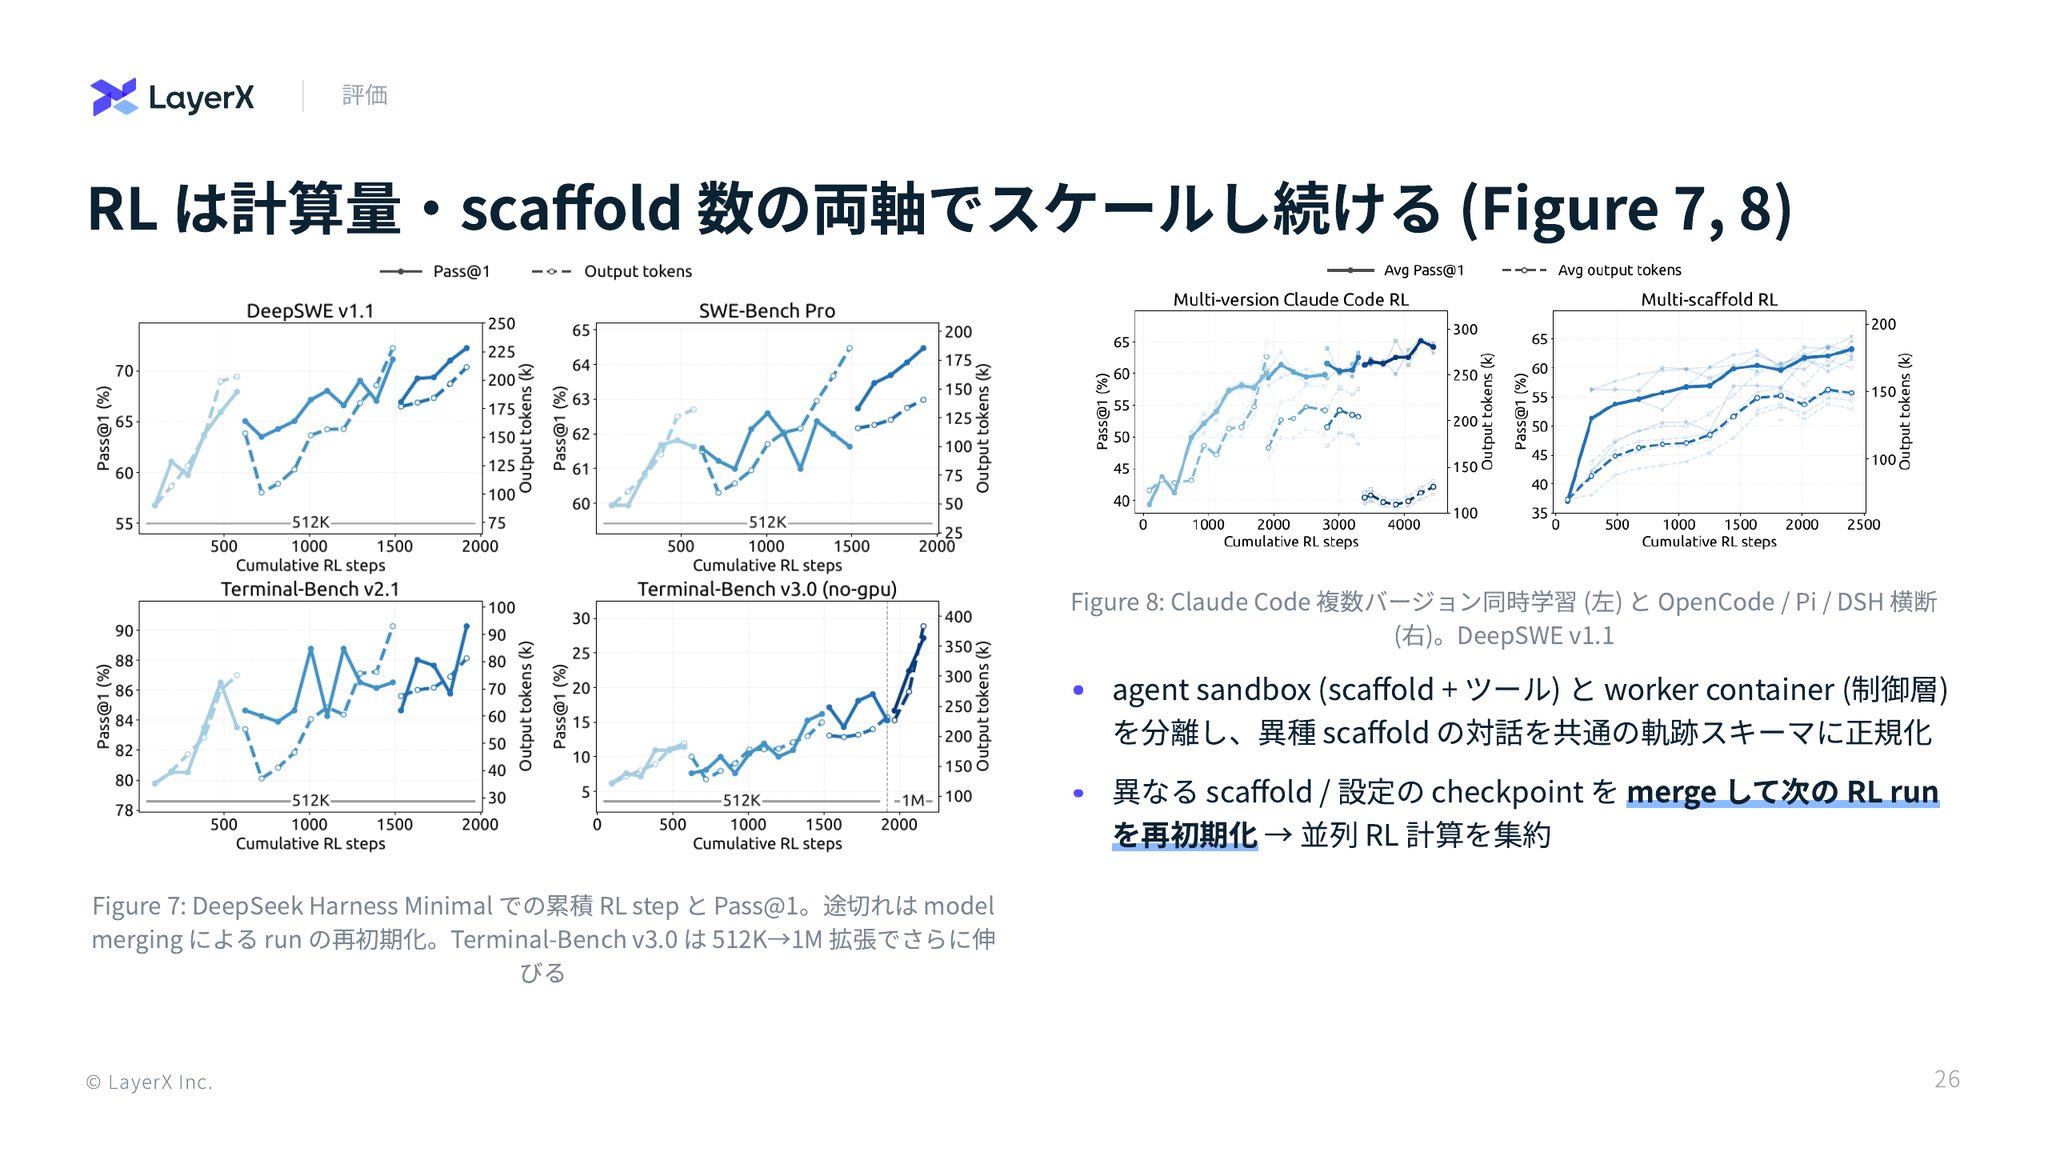
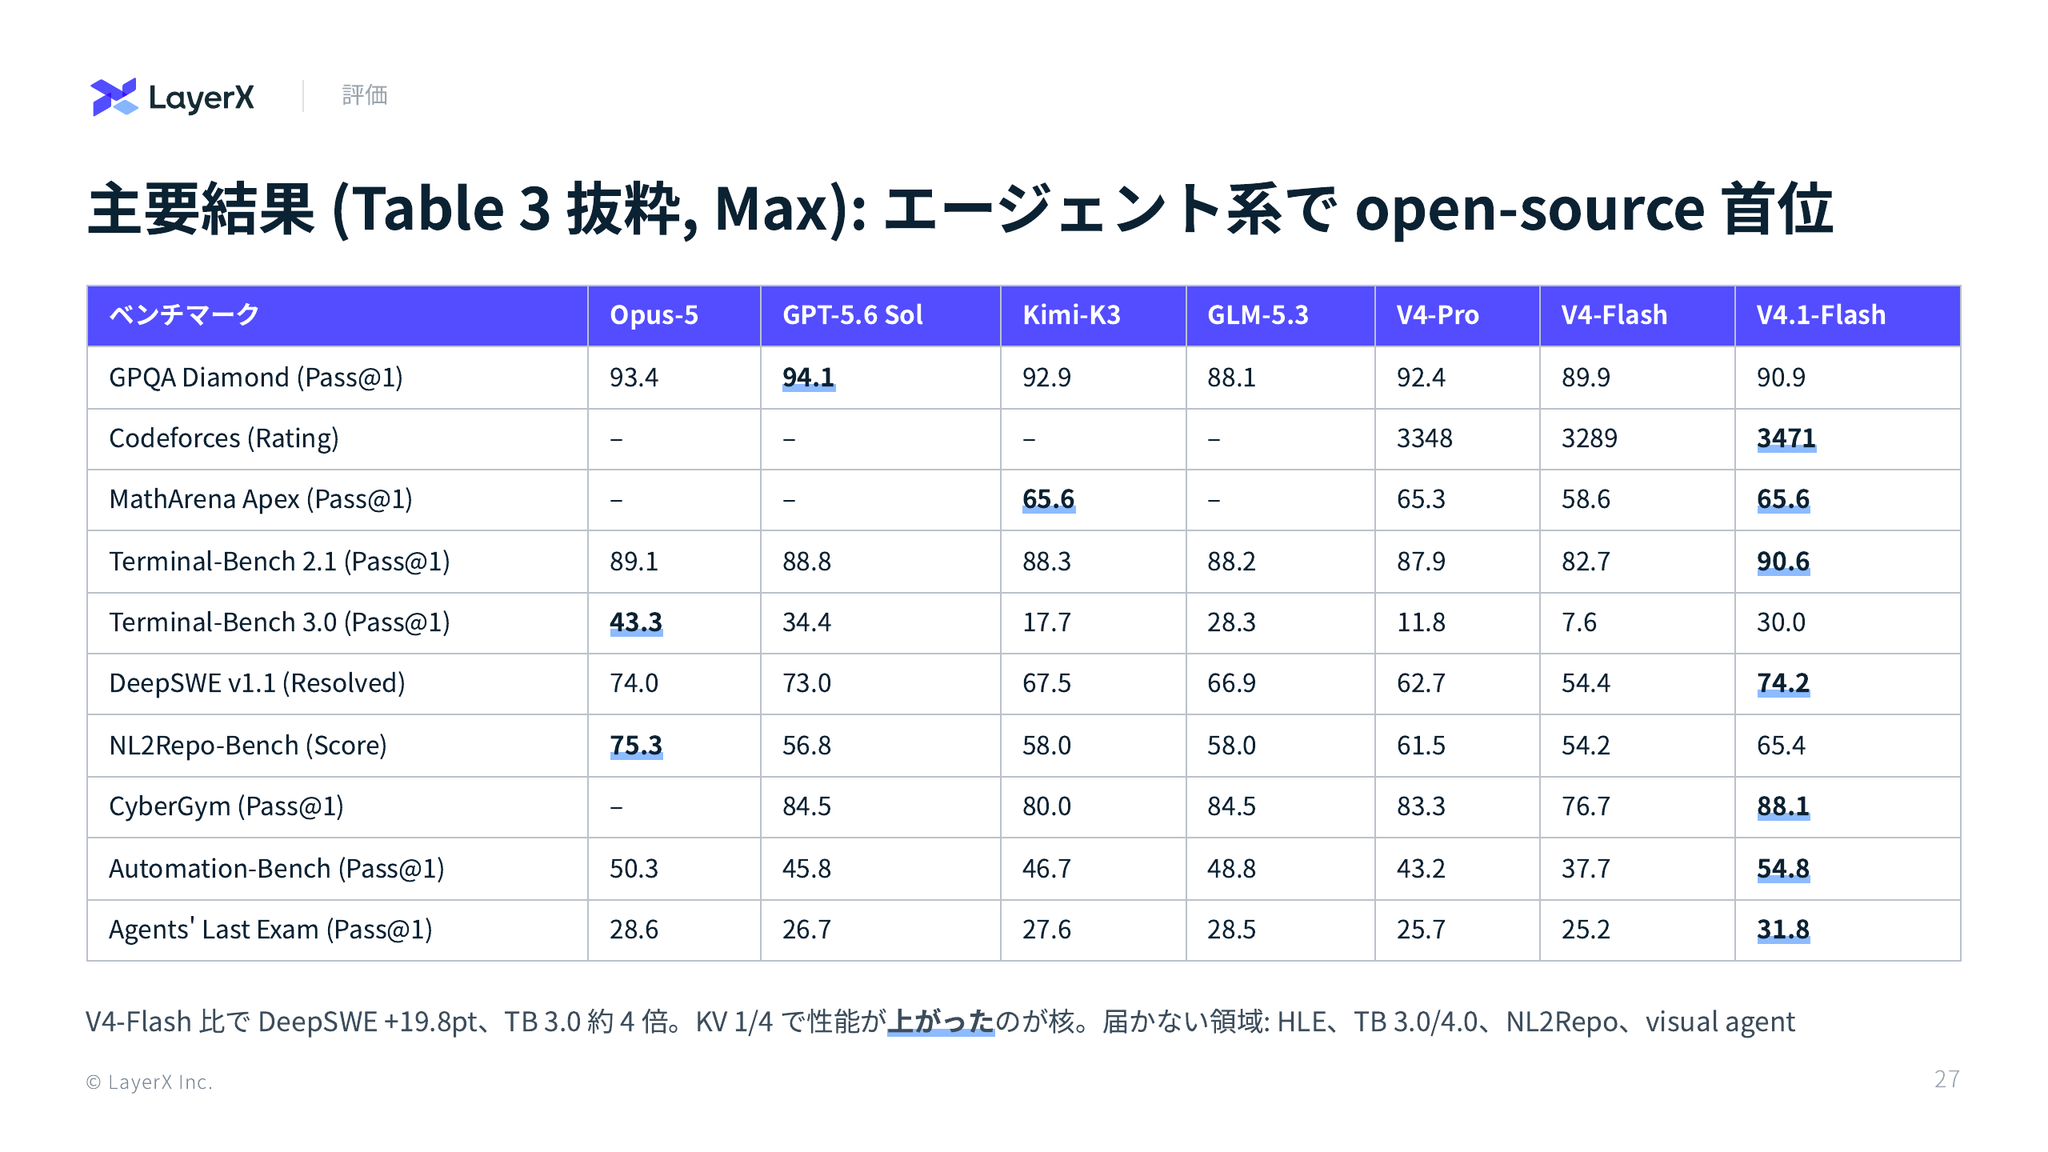
今週のTOPIC[paper] DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression [paper] Subagents vs Agent Skills: Executing Reusable Knowledge for Long-Horizon Agentic TasksWikiSkill: Compiling Agent Experience into Persistent Knowledge for EvolutionDoes On-Policy Distillation Really Distill? From Noisy Teacher to Self-Improvement[paper] \tau^{\tau}-Bench: An Environment for End-To-End, Realistic Agent Construction[paper] Comparing the learning dynamics of in-context learning and fine-tuning in language modelsメインTOPICThe Great Nugget Recall: Automating Fact Extraction and RAG Evaluation with Large Language Models概要背景手法コアアイデアNugget Creation(nugget 生成)Nugget Assignment(nugget 判定)スコアリング実験実験設定主要な結果人間 vs LLM の判定の違い(RQ3)考察限界と今後
今週のTOPIC
※ [paper] [blog] など何に関するTOPICなのかパッと見で分かるようにしましょう。
技術的に学びのあるトピックを解説する時間にできると🙆(AIツール紹介等はslack channelでの共有など別機会にて推奨)
出典を埋め込みURLにしましょう。
@Naoto Shimakoshi
@Shun Ito
[paper] Subagents vs Agent Skills: Executing Reusable Knowledge for Long-Horizon Agentic Tasks
- Subagents vs. Agent Skillsで、どういう条件でどちらが有効なのかを実験している論文
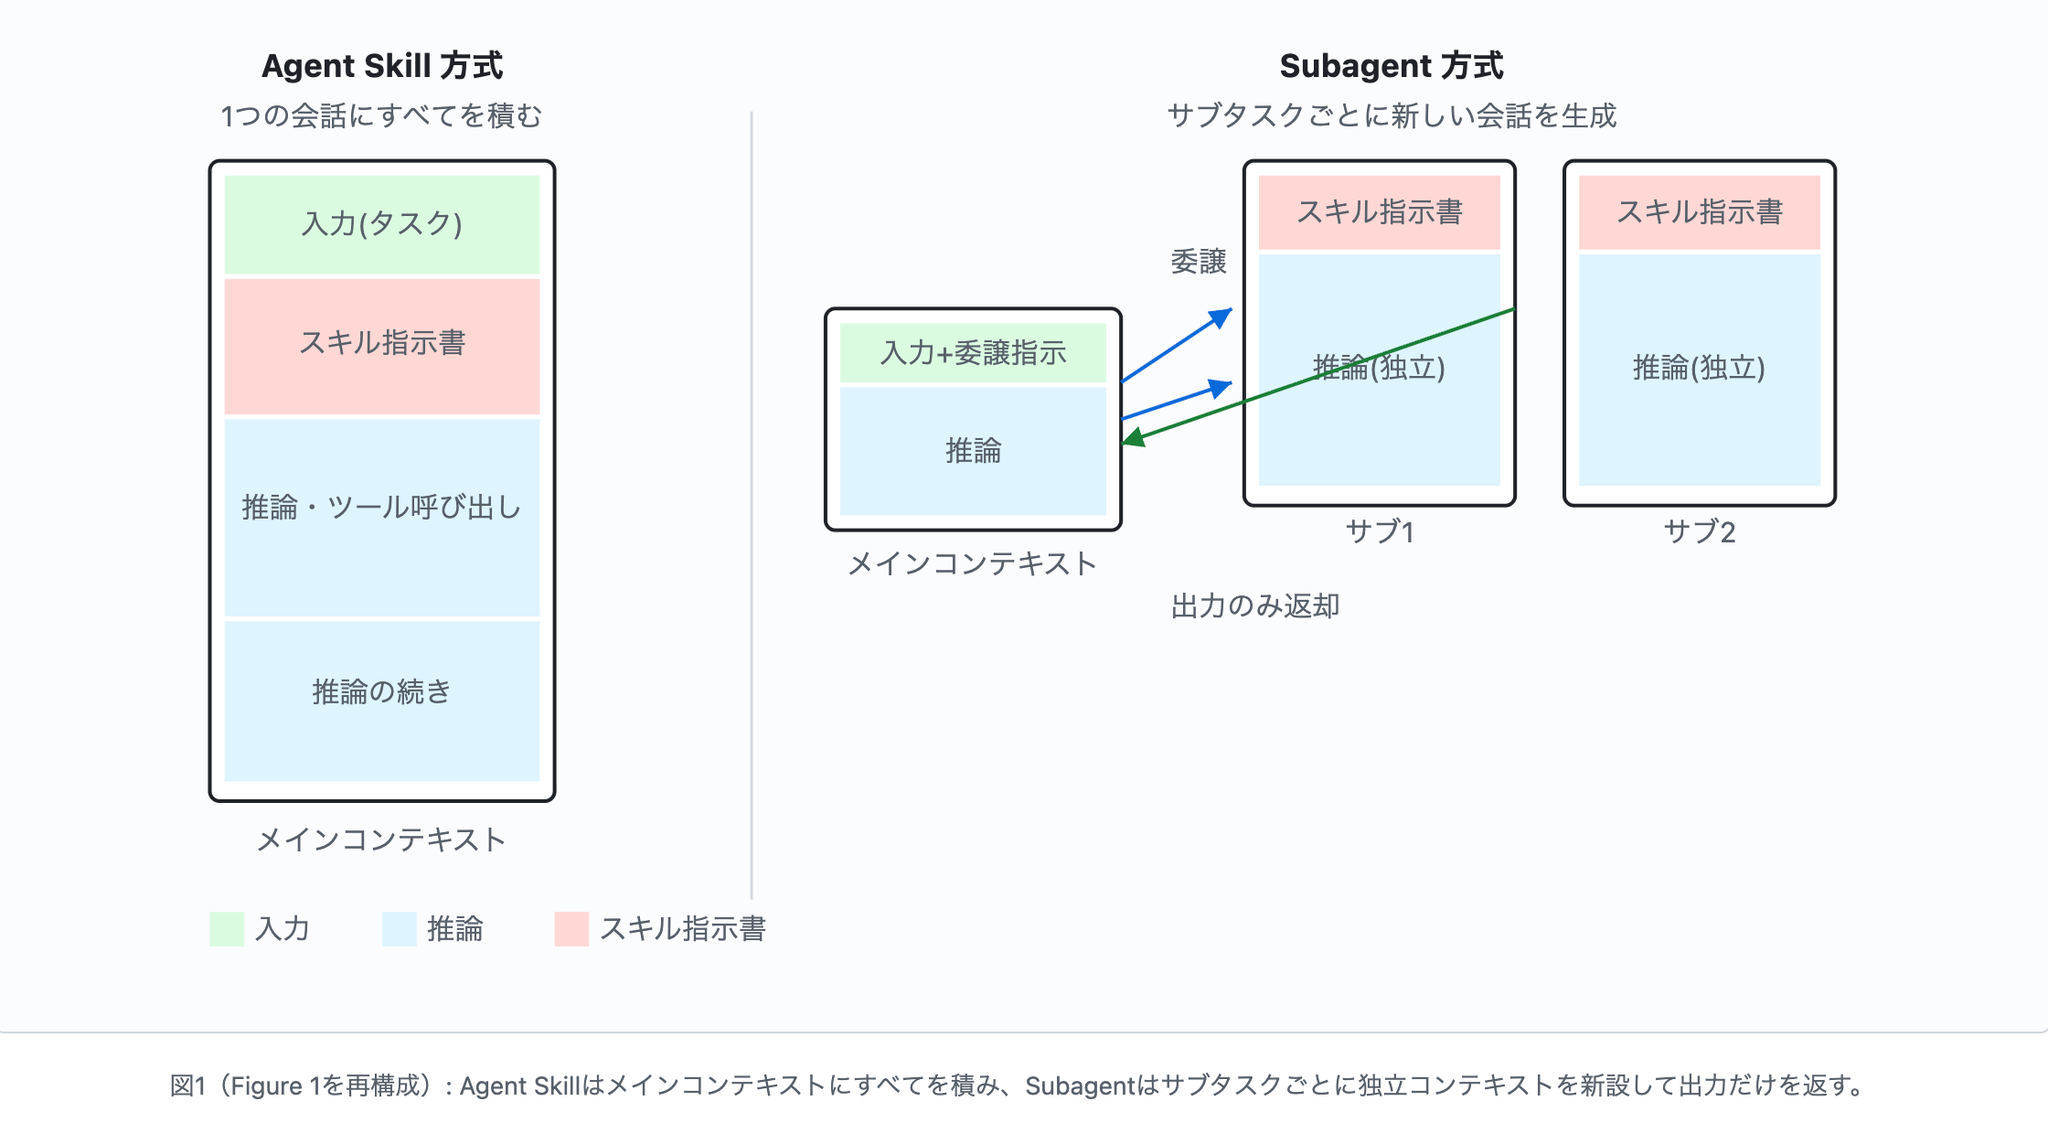
- Agent Skill は推論途中の出力が全てコンテキストに含まれるが、Subagentは途中の推論過程はメインの main context からは一切見えない
- メインエージェントは、サブエージェントの中身を見られない代わりに、「このスキルは何を渡せば、何を返してくれるのか」を スキルの説明文だけから 正しく判断できなければならない。これができないと、必要な情報を渡し忘れたり、見当違いのスキルを呼んでしまったりする。
- 仮説: 「入力の型」「処理手順」「出力の型」の3点セットが明確であればあるほど、そのスキルはSubagentとして安全に切り出せる
- 実験
- 実験設定
- SkillsBench(87タスク)のうち、著者らは「入出力契約が明確なスキルパッケージ」を新たに自動合成した64タスクのサブセット(synthesized set)を作り、これをオリジナルの人手作成スキル(curated set、契約は曖昧)と比較する。
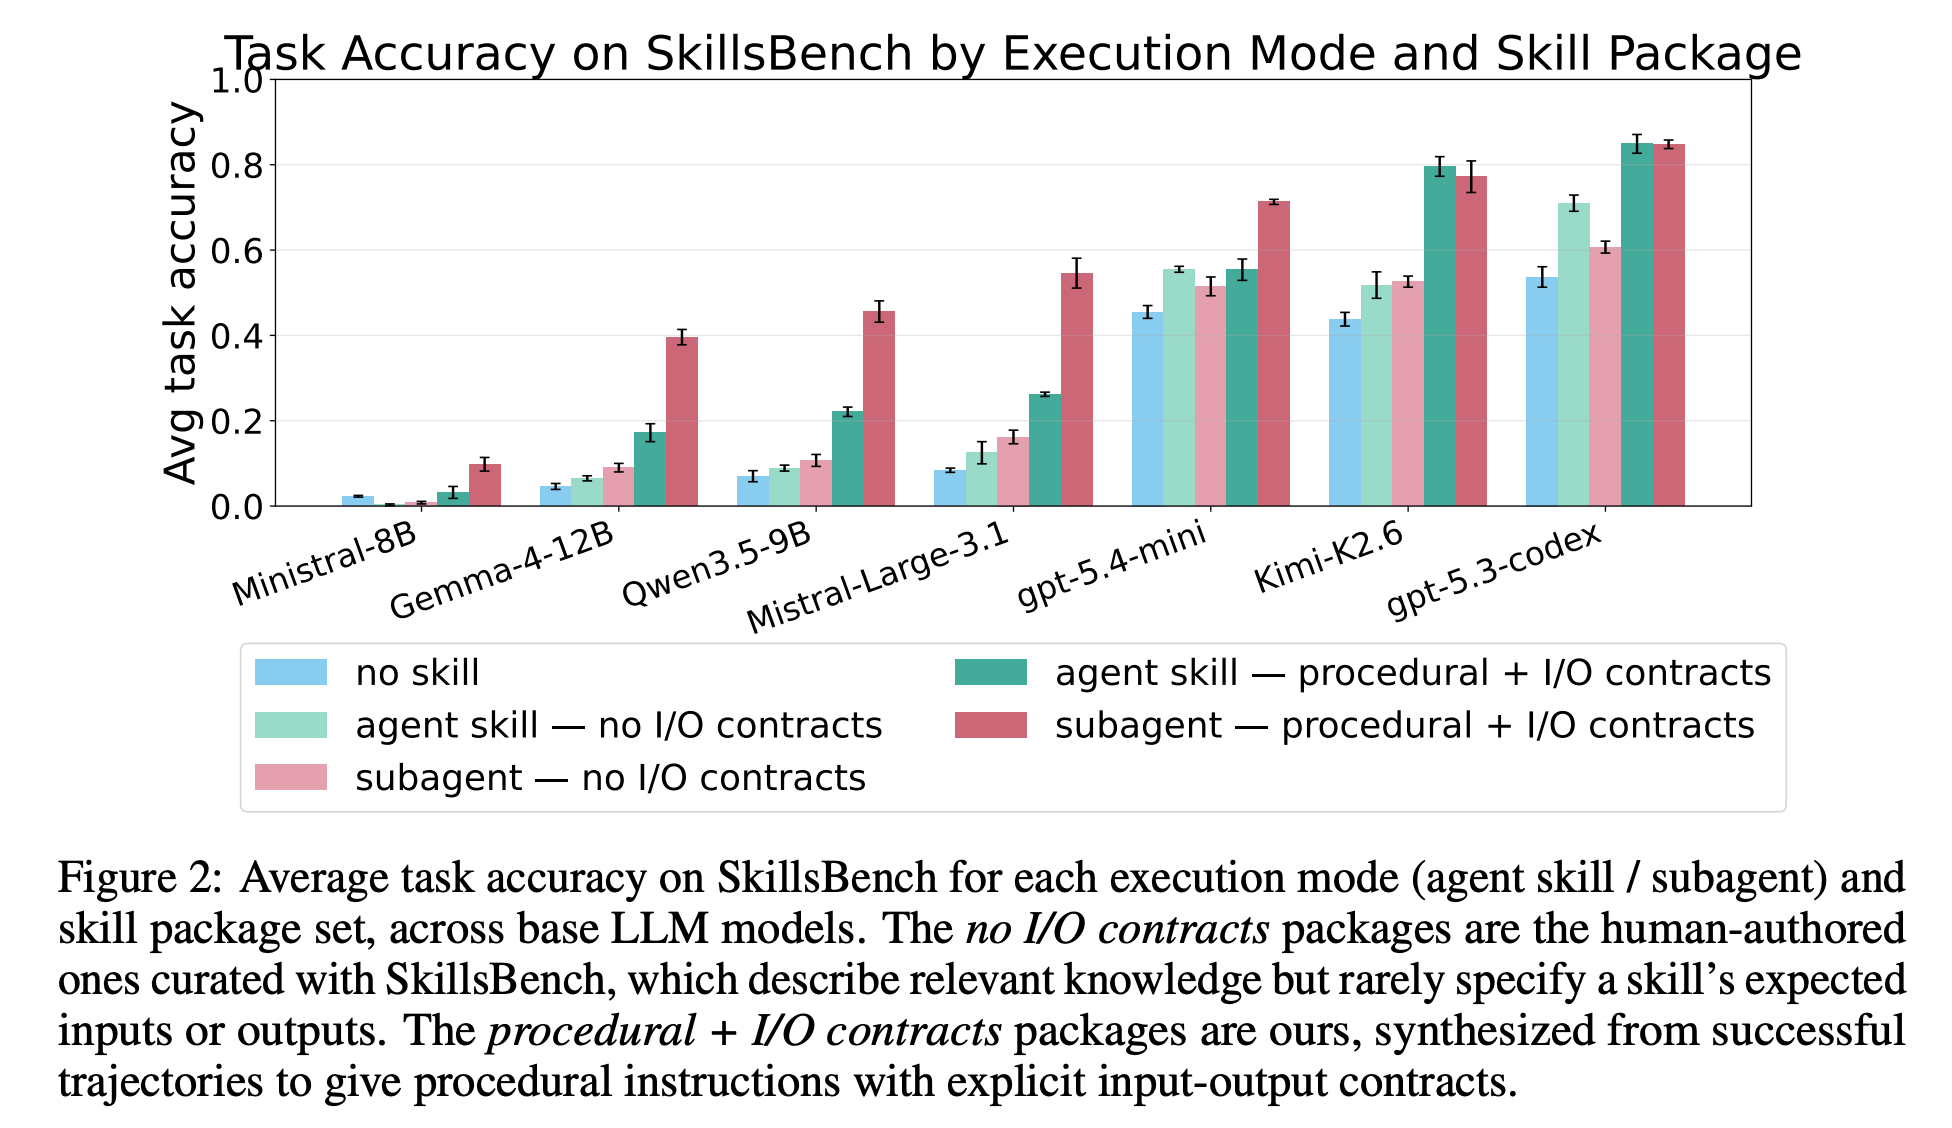
- エージェントハーネスにはOpenHandsを用い、Ministral-8B・Gemma-4-12B・Qwen3.5-9B・Mistral-Large-3.1・gpt-5.4-mini・Kimi-K2.6・gpt-5.3-codex という、小型モデルから大型モデルまで幅広い基盤モデルで比較する。
- 結果
- Task Accuracy
- 入出力契約が明確 + subagent がよい精度を出す
- 大型モデルでは入出力契約が明確 + agent skillも同等の精度を出せているが、小型モデルでは入出力契約が明確 + subagentが突出している
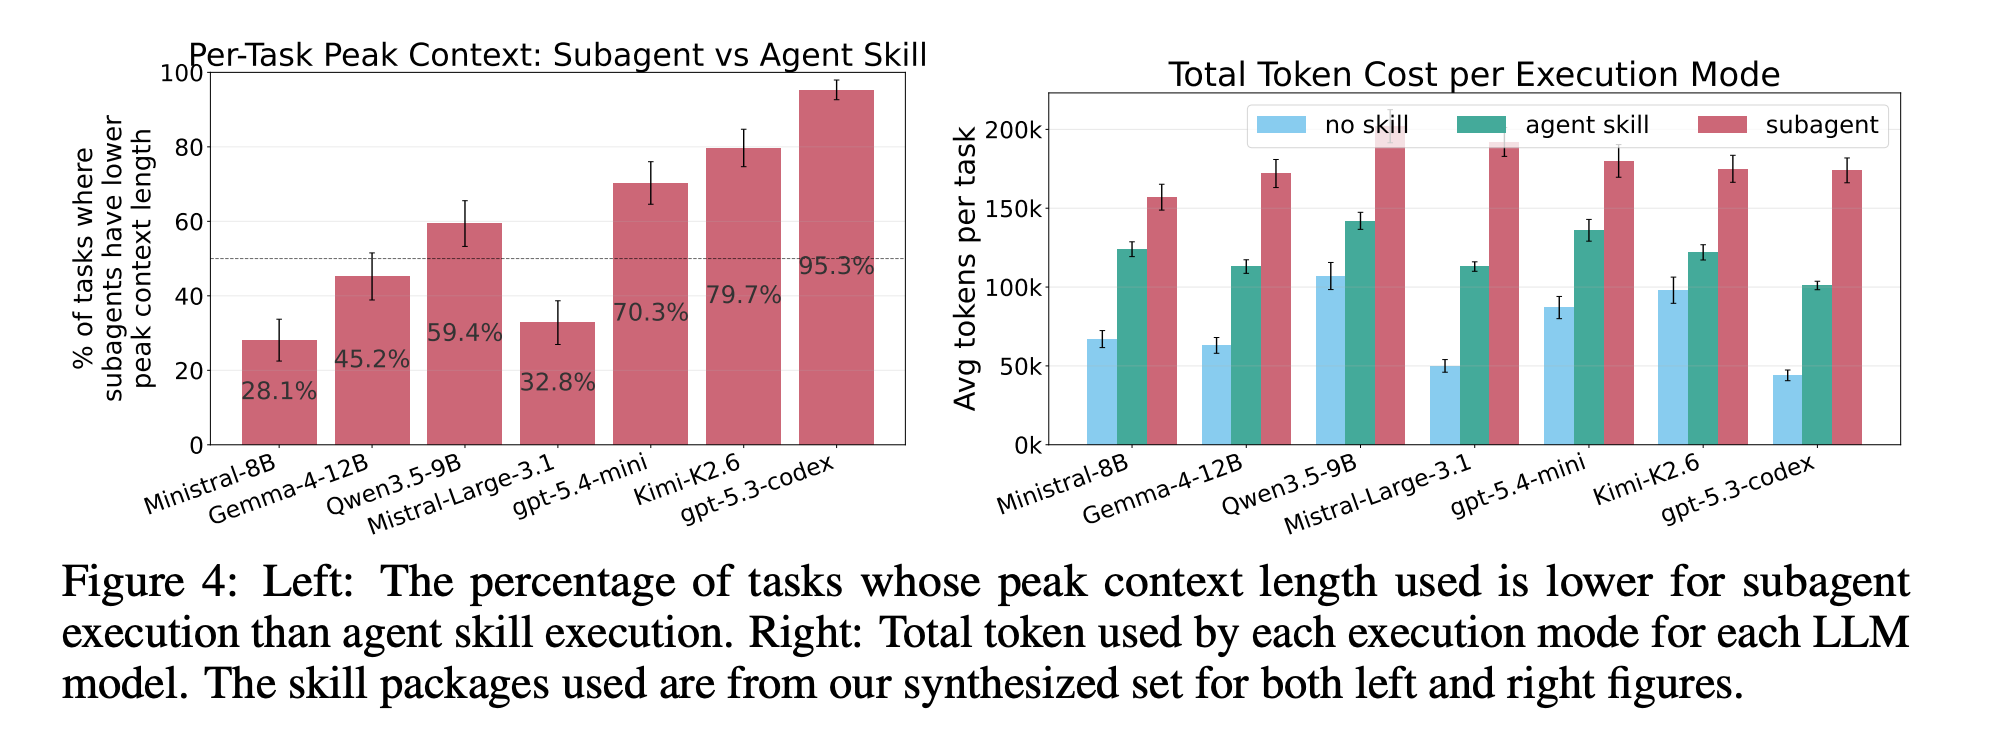
- ピークコンテキスト長の削減と総トークン量
- コンテキストあたりのピーク長は、subagentを使うことで抑えられる。その傾向は大型モデルほど強く出る。
- 総トークン量はsubagentは高くなってしまう
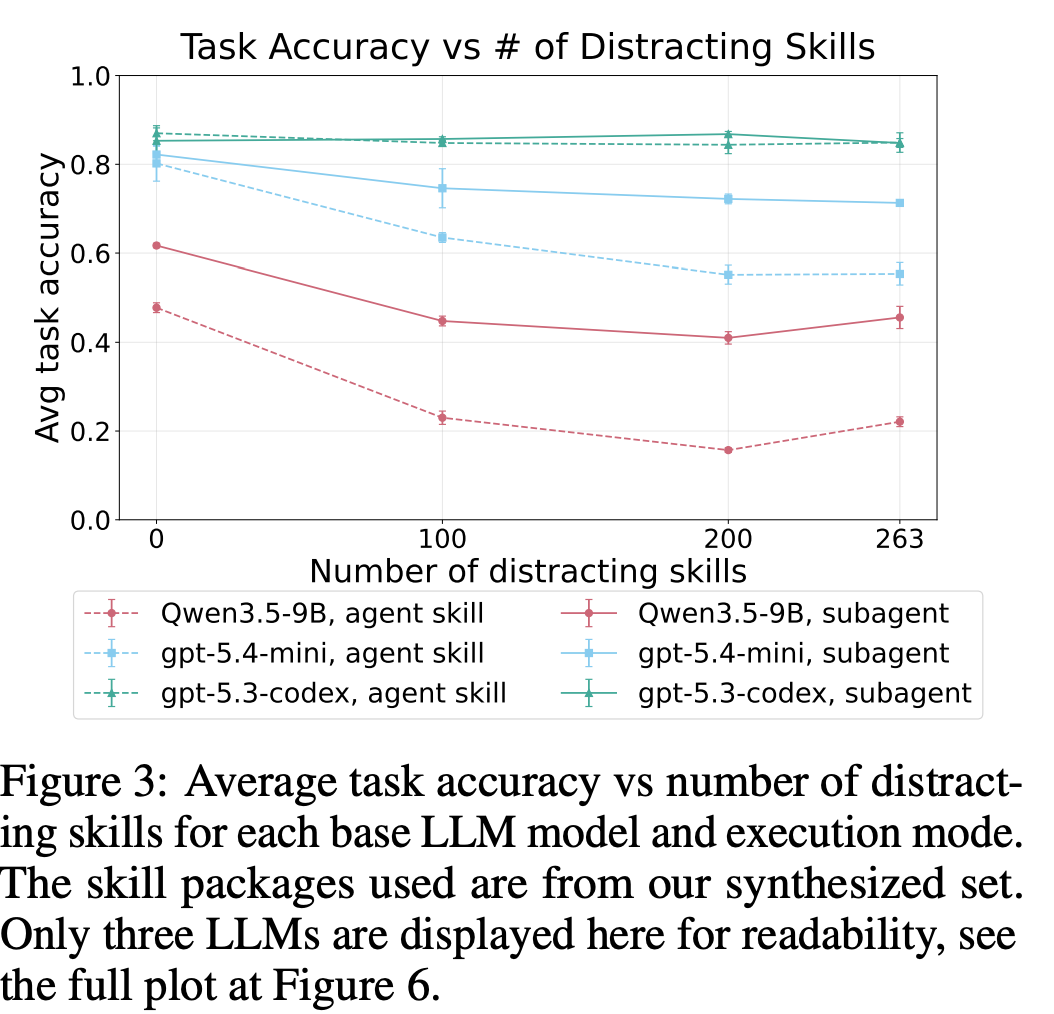
- コンテキスト圧力を強めるとどうなるか
- 関係ないskillを増やした時の精度変化
- subagentはある程度精度を維持できるが、agent skillは大きく低下
- 入出力契約が明確な手続き的スキルでは、Subagentが正解率でもコンテキスト膨張への耐性でも優位に立つ。ただし総トークンコストは増える。契約が曖昧なスキルや、単なる振り分け役にはAgent Skill方式の方が向く。
@Hiromu Nakamura (pon)
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Evolution
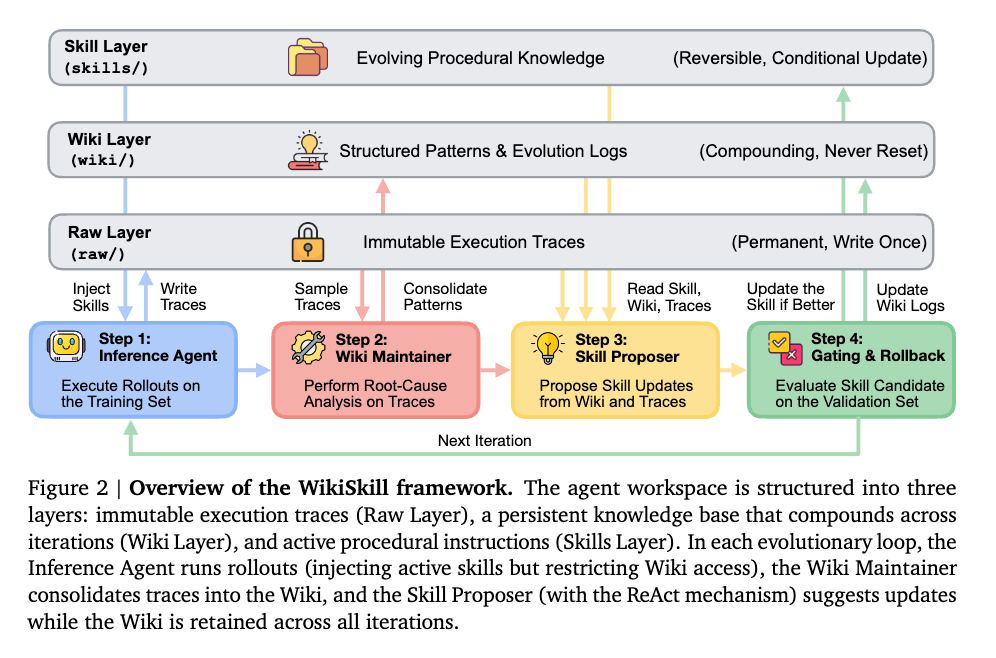
本論文では、LLMベースの自律エージェントにおける「スキル進化」のプロセスを体系化した新しいフレームワーク「WikiSkill」を提案している。
従来の手法は実行履歴から直接スキルを生成していたが、WikiSkillはRaw Layer(生データ)、Wiki Layer(知識ベース)、Skills Layer(手続き型知識)という3層のアーキテクチャを導入し、経験を構造化された知識として永続的に蓄積・進化させることで、モデルの性能向上とスキルの再利用性を劇的に改善した。
手法
WikiSkillの進化ループは以下の4つのコンポーネントで構成される。
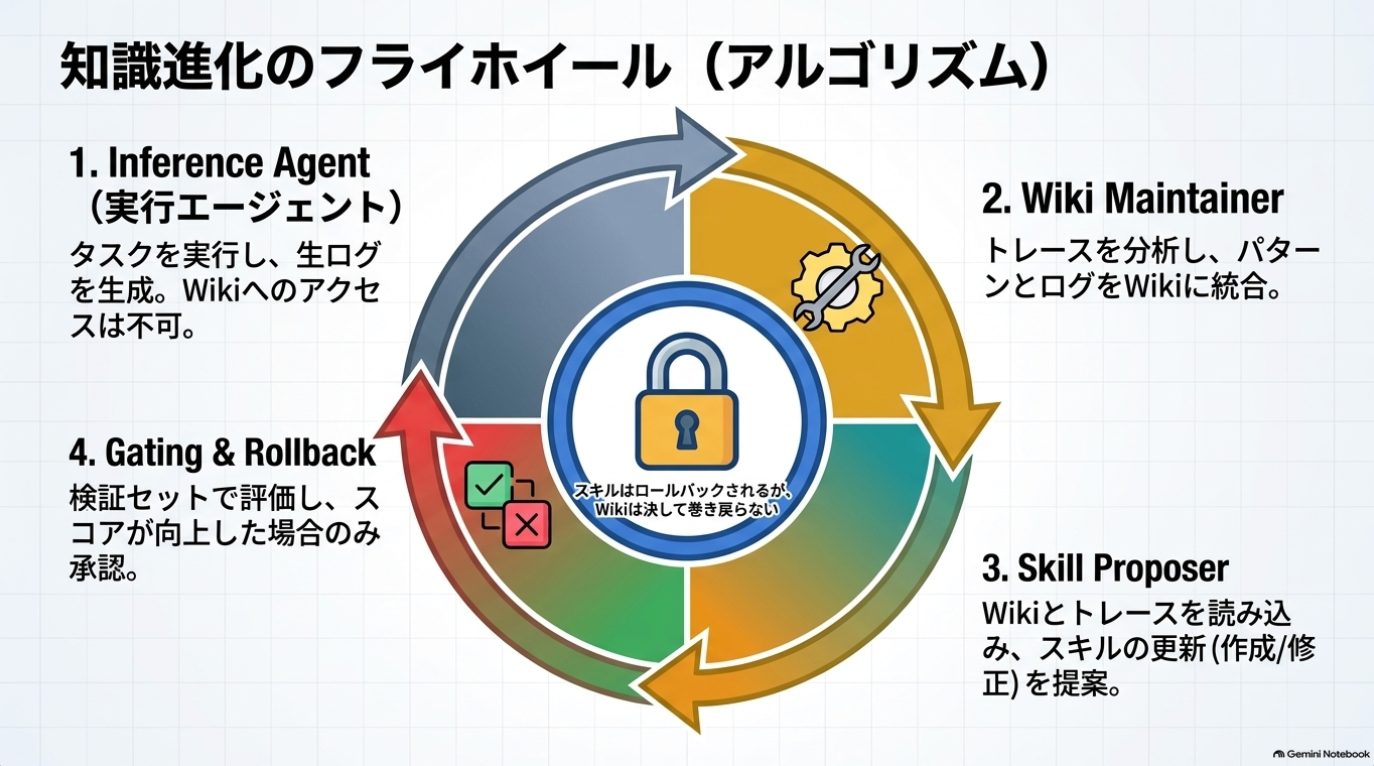
- Inference Agent
- 現行のスキルセット を用いてタスクを実行し、生データ(推論ステップ、ツール呼び出し、回答)を Raw Layer に保存する。
- Wiki Maintainer
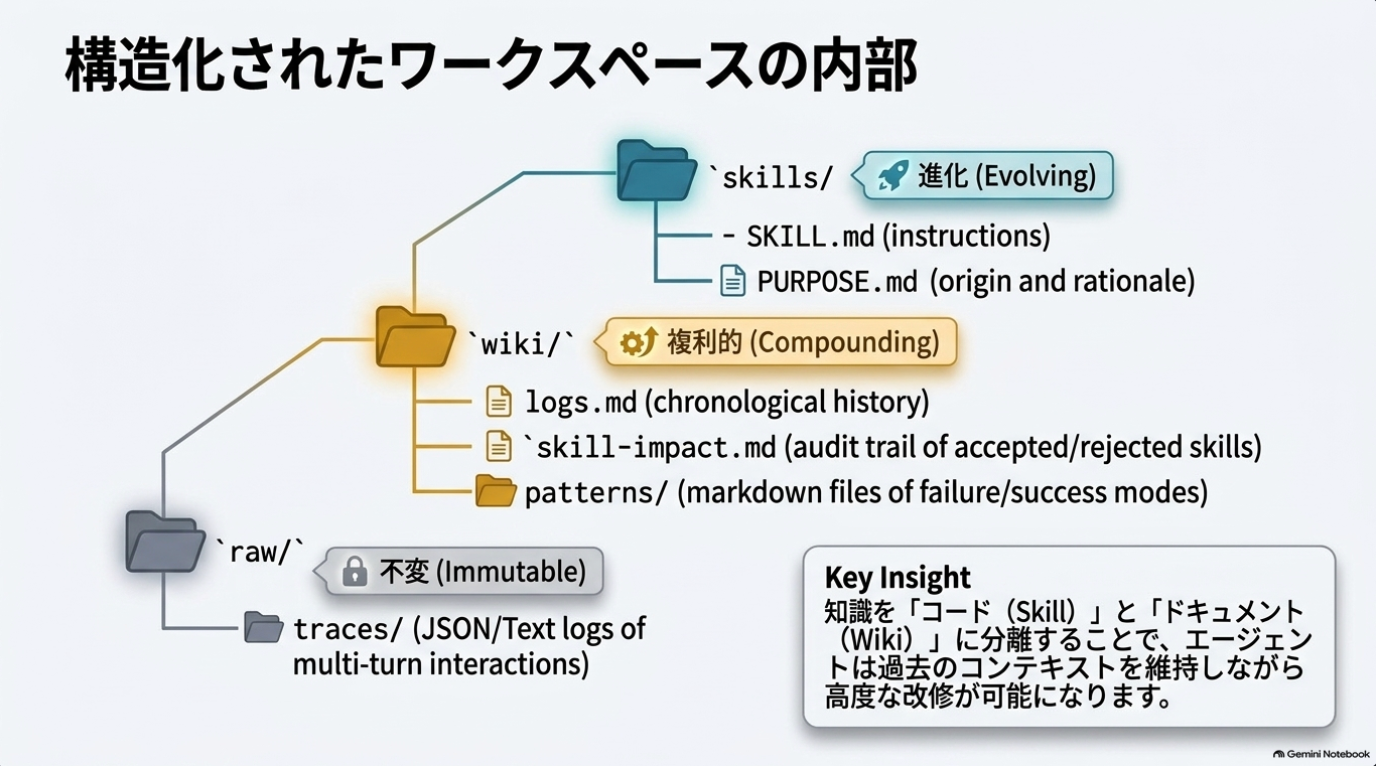
- Raw Layer の実行トレースを分析し、成功・失敗のパターンを抽出する。これらを wiki/patterns/ 配下のMarkdownファイルに構造化して更新し、進化ログ logs.md や skill-impact.md に履歴を記録する。
- Skill Proposer
- Wiki Layer の知識と履歴を基に、既存スキルの修正または新規作成を行う。過去の拒絶された提案(skill-impact.md)を参照することで、失敗の繰り返しを防ぐ。
- Gating & Rollback
- 検証用タスクセット を用い、提案されたスキル候補 が性能を向上させるか判定する。以下の条件により、スキルセット を更新する。
ここで、スキルの変更が拒否された場合でも、Wiki Layerはロールバックされず、経験の蓄積は継続される点が最大の特徴。
具体例
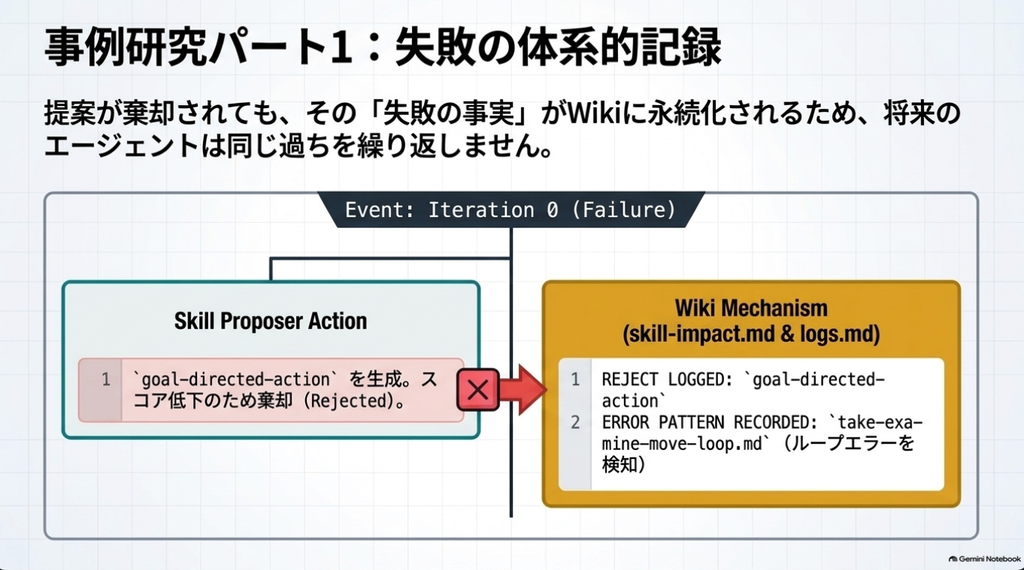
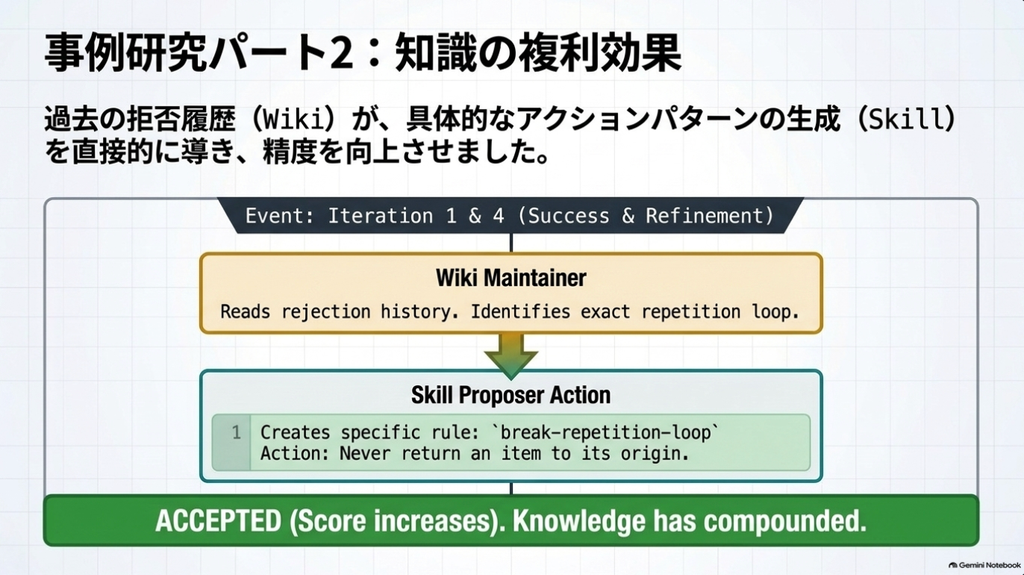
実験
本研究では、数学的推論から実世界的なタスクまで多岐にわたる5つのベンチマークと、5種類のLLM(オープンウェイトおよびクローズドモデル)を用いて評価を行っています。
- 評価ベンチマーク
- LiveMath: 数学競技問題
- SealQA: Web検索を伴う事実質問回答
- SpreadSheet: スプレッドシートの操作とコード生成
- OfficeQA: 長文財務文書に対する質問回答
- ALFWorld: インタラクティブな家庭内タスク。
結果
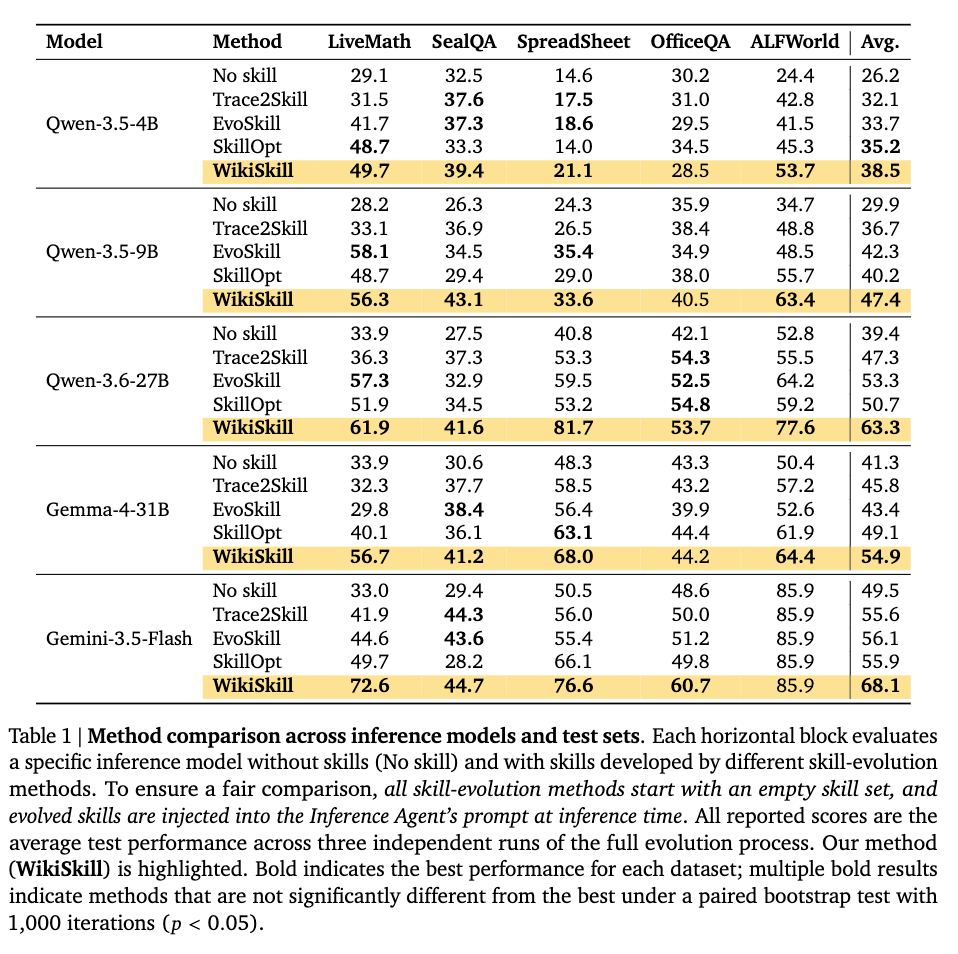
WikiSkillは、全てのモデルにおいて既存のスキル進化手法を凌駕し、平均スコアで最高成績を収めました。
- モデルの規模が大きくなるほど、WikiSkillによる性能向上幅も拡大する傾向 。
- スキルを持った小型モデル(Qwen-9B)が、スキルなしの大型モデル(Qwen-27B)を凌駕するケースも確認された。
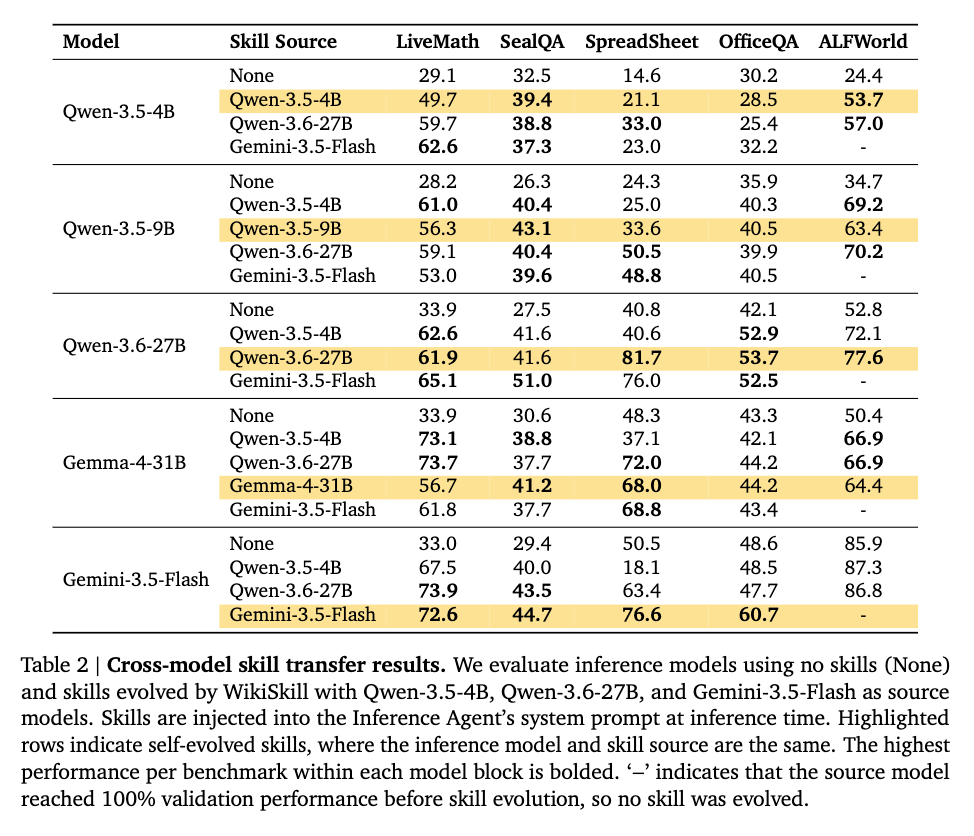
あるモデルで進化したスキルを別のモデルに適用しても有効であり、場合によっては自己進化したスキルよりも高い性能を発揮します。
- スキルを発見する能力と実行する能力は別物であることが示唆されている。
- ただし、小型モデルが編み出した「特定の回避策」が大型モデルにとって余計なステップとなり、性能を下げるケースも一部報告されています
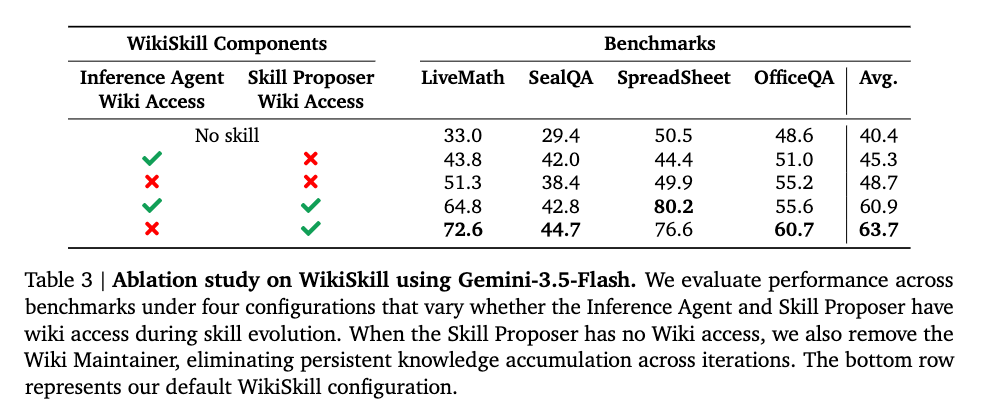
Wiki(永続的知識層)の存在が進化においてどれほど重要かを検証しています。
- Proposer(提案者)がWikiを通じて過去の失敗や成功のパターンにアクセスできることが、大幅な性能向上に寄与しています 。
- 逆に、トレーニング中の推論エージェントにWikiを見せると、スキル自体ではなくWikiの情報で問題を解いてしまい、スキルの質が低下することも判明しました 。
結論
WikiSkillは、エージェントの経験をただの断片的なログとして捨て去るのではなく、永続的なWikiという形態で構造化することで、スキルの発見と実行能力を分離し、長期的な進化を可能にした。このアプローチは、AIエージェントが特定のモデルパラメータに依存せず、独自の手続き型知識を構築・発展させていくための強力な基盤となる。
@Kyohei Uto(kuto)
Does On-Policy Distillation Really Distill? From Noisy Teacher to Self-Improvement
概要
オンポリシー蒸留(OPD)の学習効果は教師からの知識移転ではなく『低確率トークンの発生抑制』であることを示し、教師なしでLLMを自己改善させる手法(OPSA)を提案した論文
背景
- RLVRだとアウトカムベースのスパース報酬になりがちであることから、密な報酬を得る手法としてOPDがある
- OPDは生徒モデルが生成したtoken軌跡に対して教師モデルのtoken確率を求めアドバンテージを計算することで密な報酬フィードバックで学習する手法
- 蒸留とあるように教師モデルの知識を生徒モデルに転移することで学習していると考えられているが本当にそうなのか?というのがこの論文の出発点
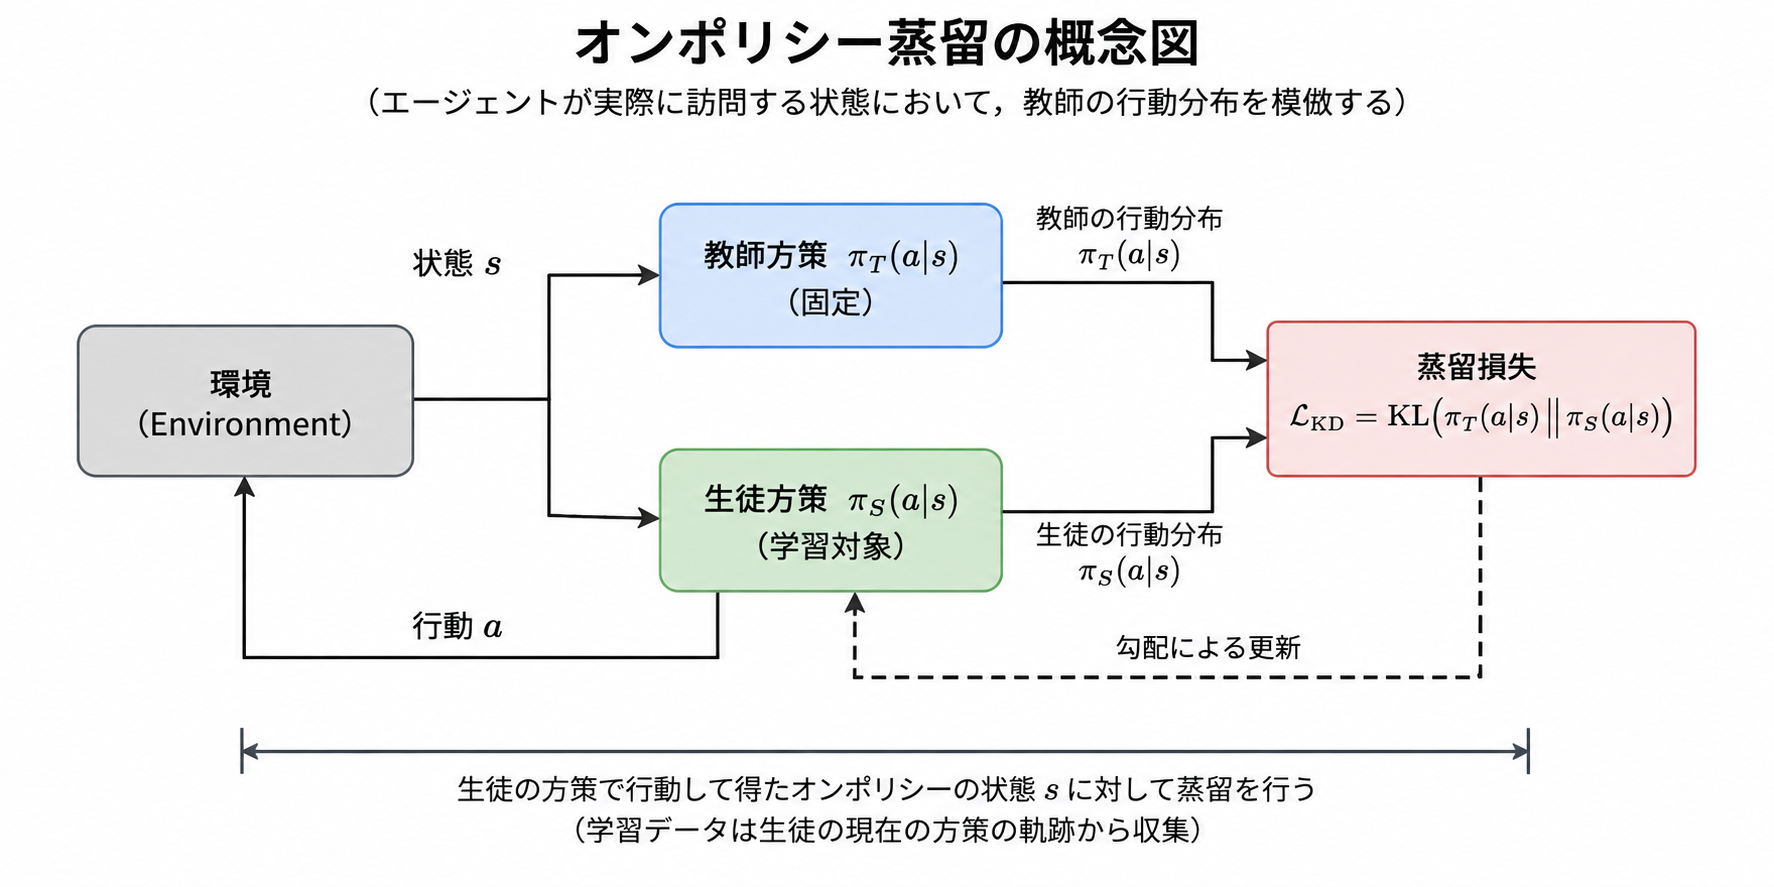
OPDの教師モデル信号にはノイズが多い
教師モデルによるフィードバックは学習に対して有効なのかを実験で検証
教師モデルのノイズ率を以下のように定義
生徒モデルの最終結果と、途中過程の教師モデルのアドバンテージの符号が一致しない割合
例えば生徒モデルは最終的に正解しているが、途中過程のtokenに関して教師モデルが生徒モデルより低い確率を付けていれば A_t < 0 になり、その token の確率を下げるという学習信号になる
※ 正解回答を構成するtokenは全て正のアドバンテージであるべきという仮定を置いている点には注意
結果: 教師モデルのサイズが大きくなるほどノイズが大きくなる
| 教師モデル | ノイズ率 |
|---|---|
| Qwen3-4B | 30.6% |
| Qwen3-30B-A3B | 34.7% |
| Qwen3-235B-A22B | 50.6% |
OPDの学習方法を下記のように変更しても学習ステップが進むにつれて学習が進行し、かつ精度差がそこまでないことが判明
- 教師モデルのサイズを大きくする
- ノイズを完全除外する
- ノイズのみにする
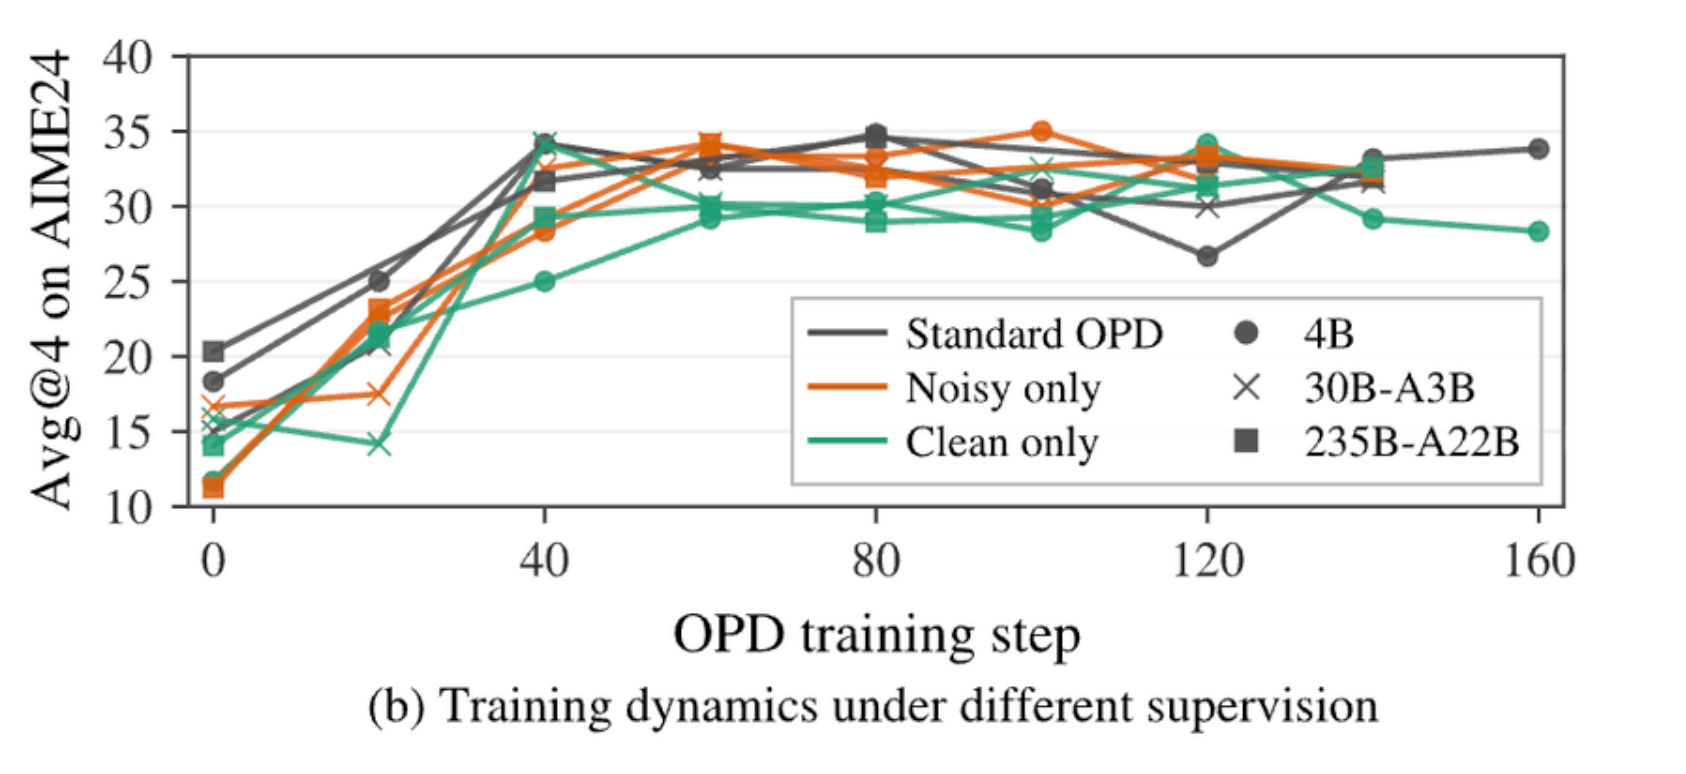
生徒モデルの性能向上は教師モデルの行動を蒸留した結果ではない可能性
生徒モデルの性能向上はどこから生じるのか?
- 生徒モデルの高確率tokenは学習に寄与していない
生徒モデルが高い確率でサンプリングしたtokenは教師モデルも同等に高い確率を示し対数確率の差が小さいためアドバンテージは0に近づき学習効果をもたらさない
- 生徒モデルの低確率tokenを抑制することが学習に寄与している
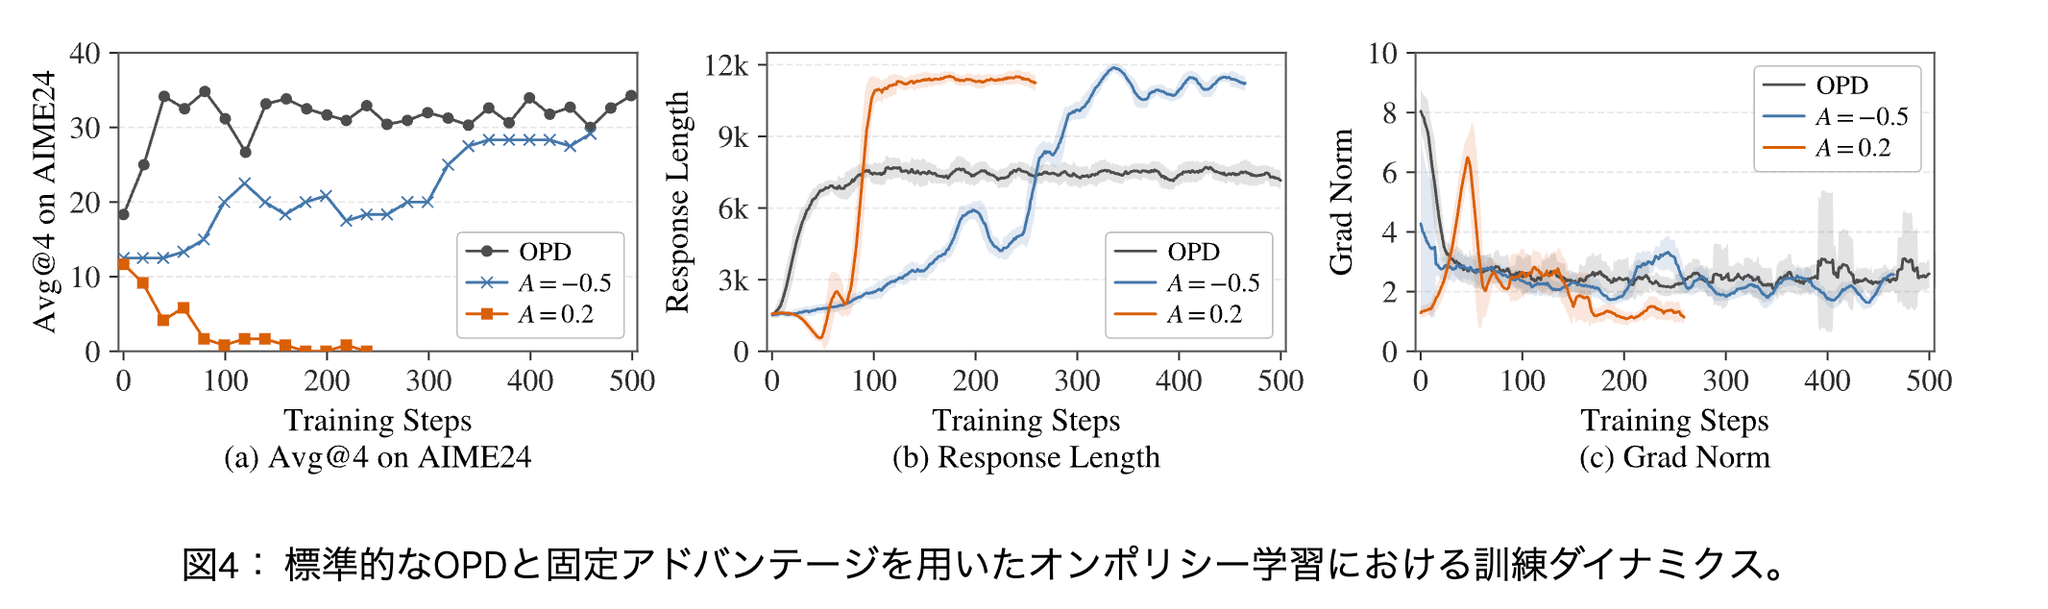
- 生徒モデルが出力したトークン集合のうち確率が下位20%のトークン集合に対して一律負のアドバンテージを与えてみる
- -0.5のアドバンテージを与えるとOPDと同等の性能を発揮することが示された
提案手法
上記の分析からOPDにおいて実際に学習に効いているのは生徒モデルが低い確率でサンプリングしたtokenを抑制している点だと発見した
つまり教師モデルは不要で生徒モデルが低確率であるtokenの出力確率を下げるように学習すれば性能は上がるはず
複雑に見えるが、要点は以下
- 生徒モデルのtokenの確率分布の下位20%を学習対象とする
- アドバンテージ = -0.5 - そのtokenのエントロピーをmin-max正規化したもの
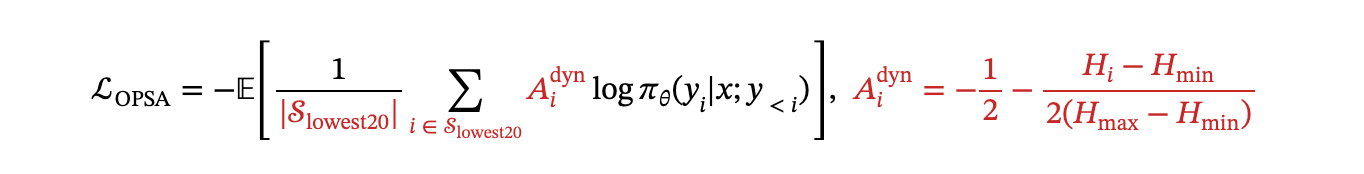
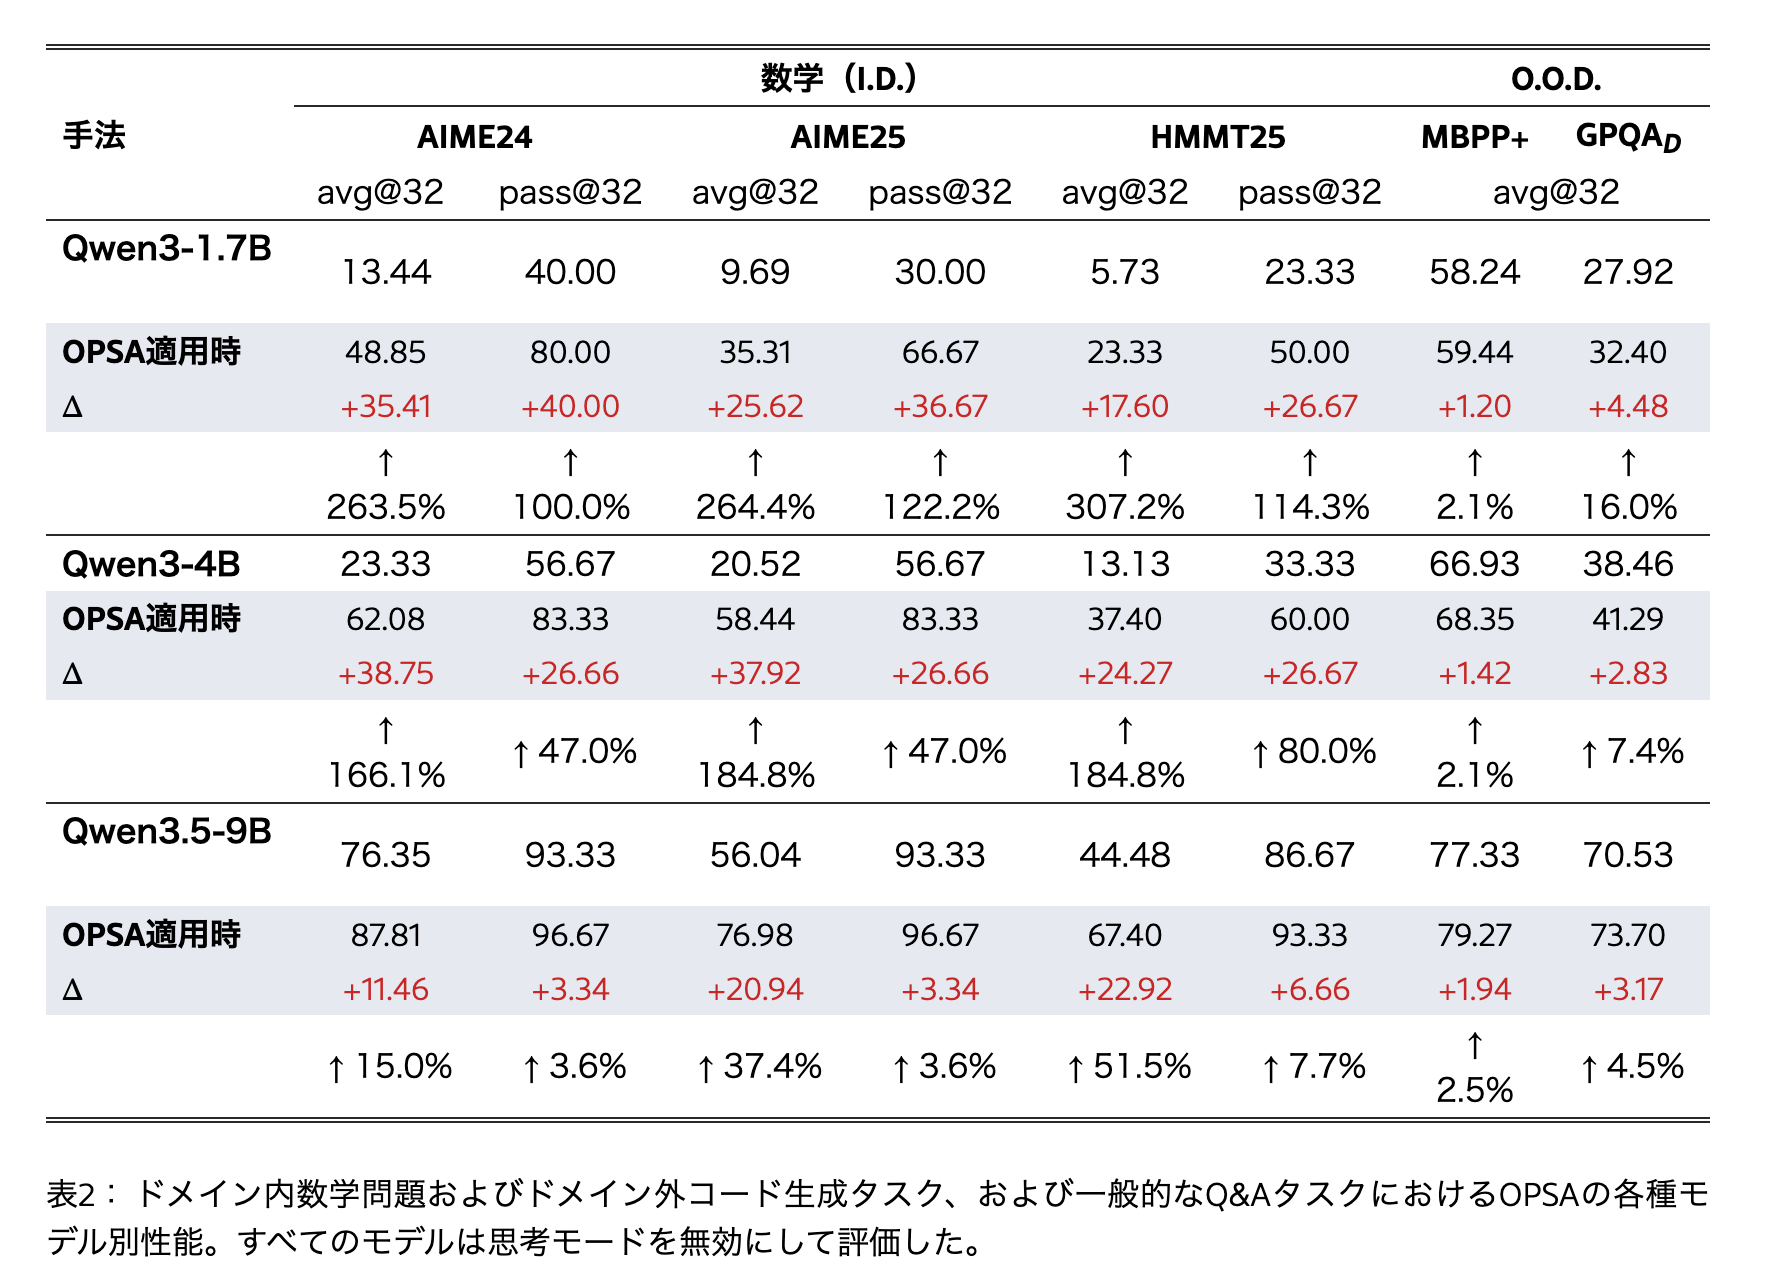
結果
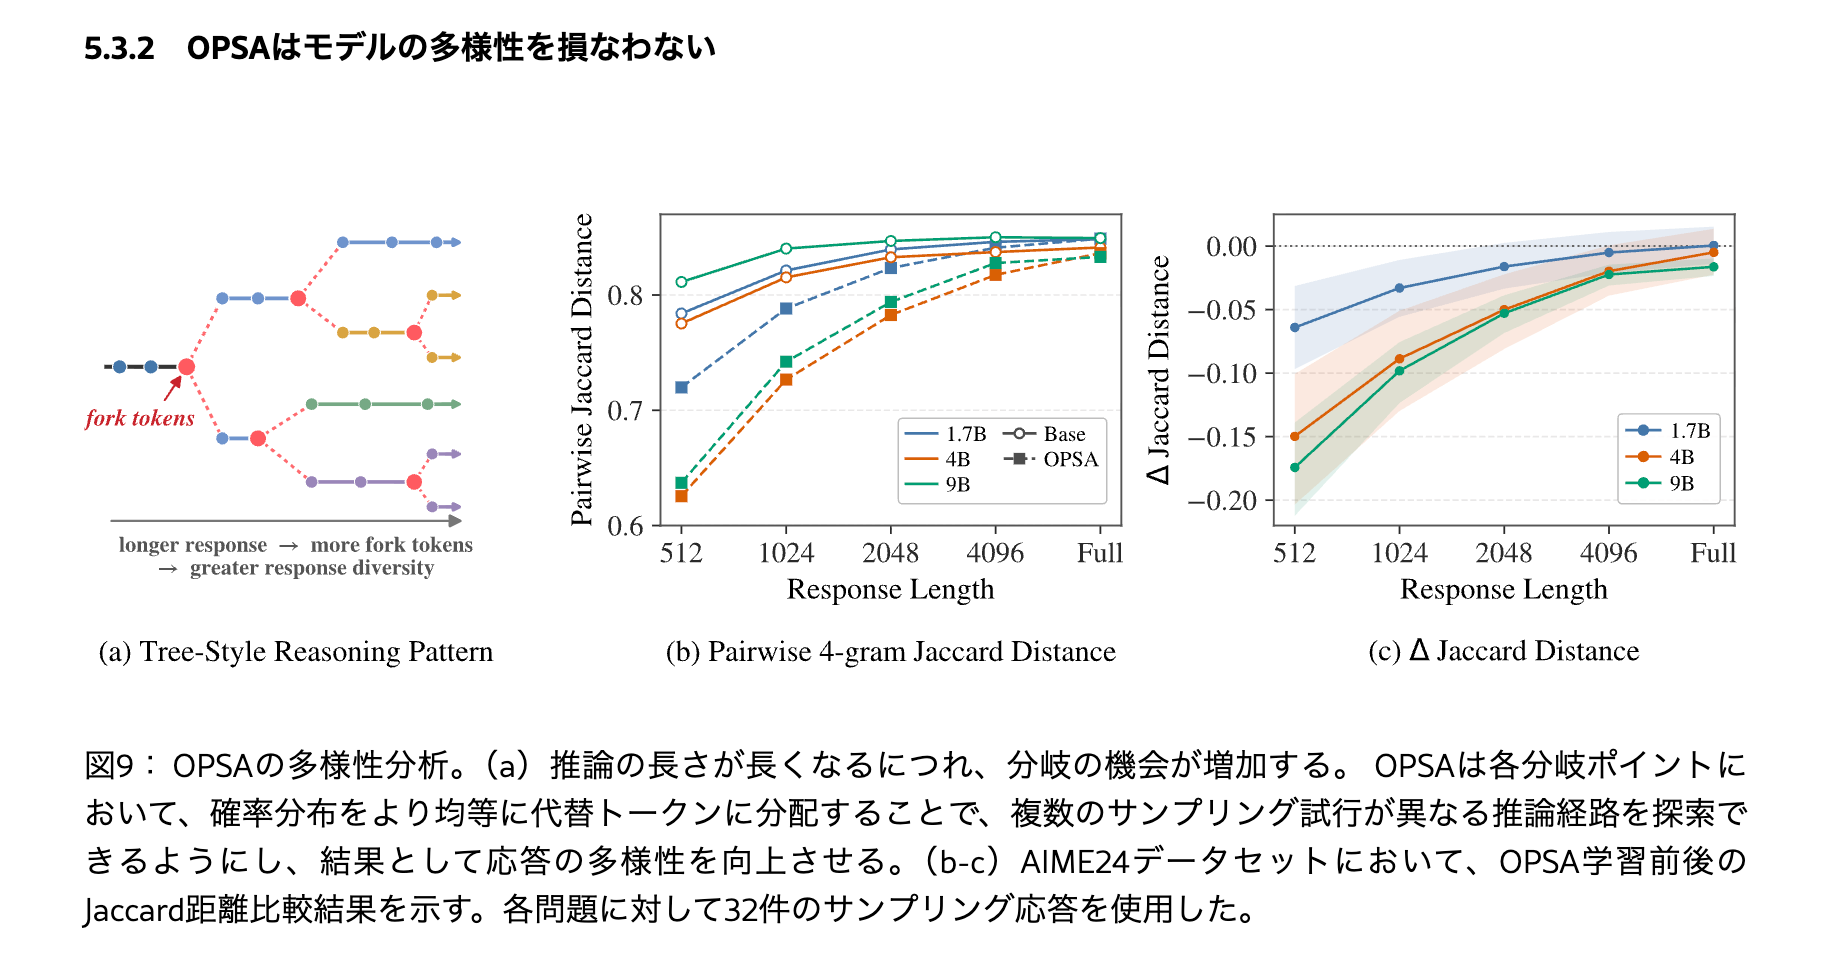
低確率のtokenを抑制することになるので、確率分布が尖り多様性が失われるのでは?という懸念があるが多様性は損なわれていないという結果が得られている
感想
- OPDは教師モデルから蒸留してるわけではないのではという示唆が面白い
- 教師モデルから蒸留することで生徒モデルの分布外の知識を得るということは難しいのかも(オンポリシーな時点で確かに限界はありそう)
@Ryuhei Kawabata(monokemonoke)
[paper] -Bench: An Environment for End-To-End, Realistic Agent Construction
-bench で hyper tau bench と呼びます。
どんなベンチか
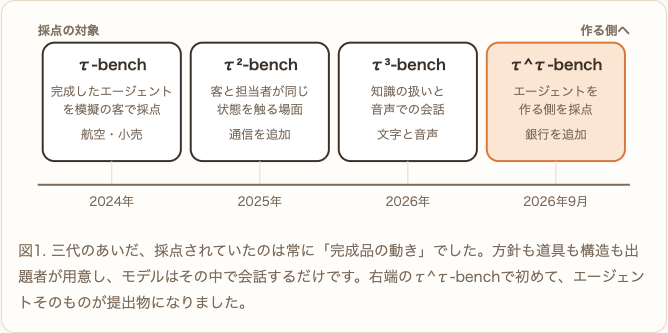
- カスタマーサポートエージェントとしての性能を測るベンチ一族
- hyper-tau-bench は claude code や codex といったコーディングエージェントがエージェントを作る能力を測定する
- FDE としてエージェントが動けるか、みたいなベンチマーク
タスクの概要
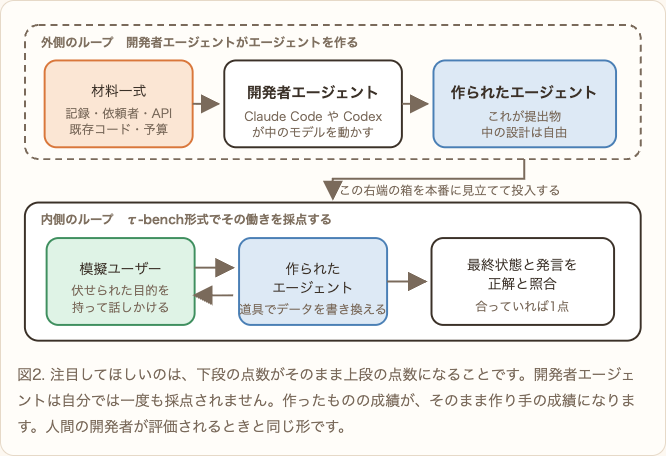
- コーディングエージェントにコンテキストをざっくり与える
- claude code や codex がエージェントを作成する
- 作られたエージェントを対象に tau-bench を動かし, 作られたエージェントの性能を評価
- 作られたエージェントの性能をもって、開発者エージェントの性能とする
ベンチマーク設計
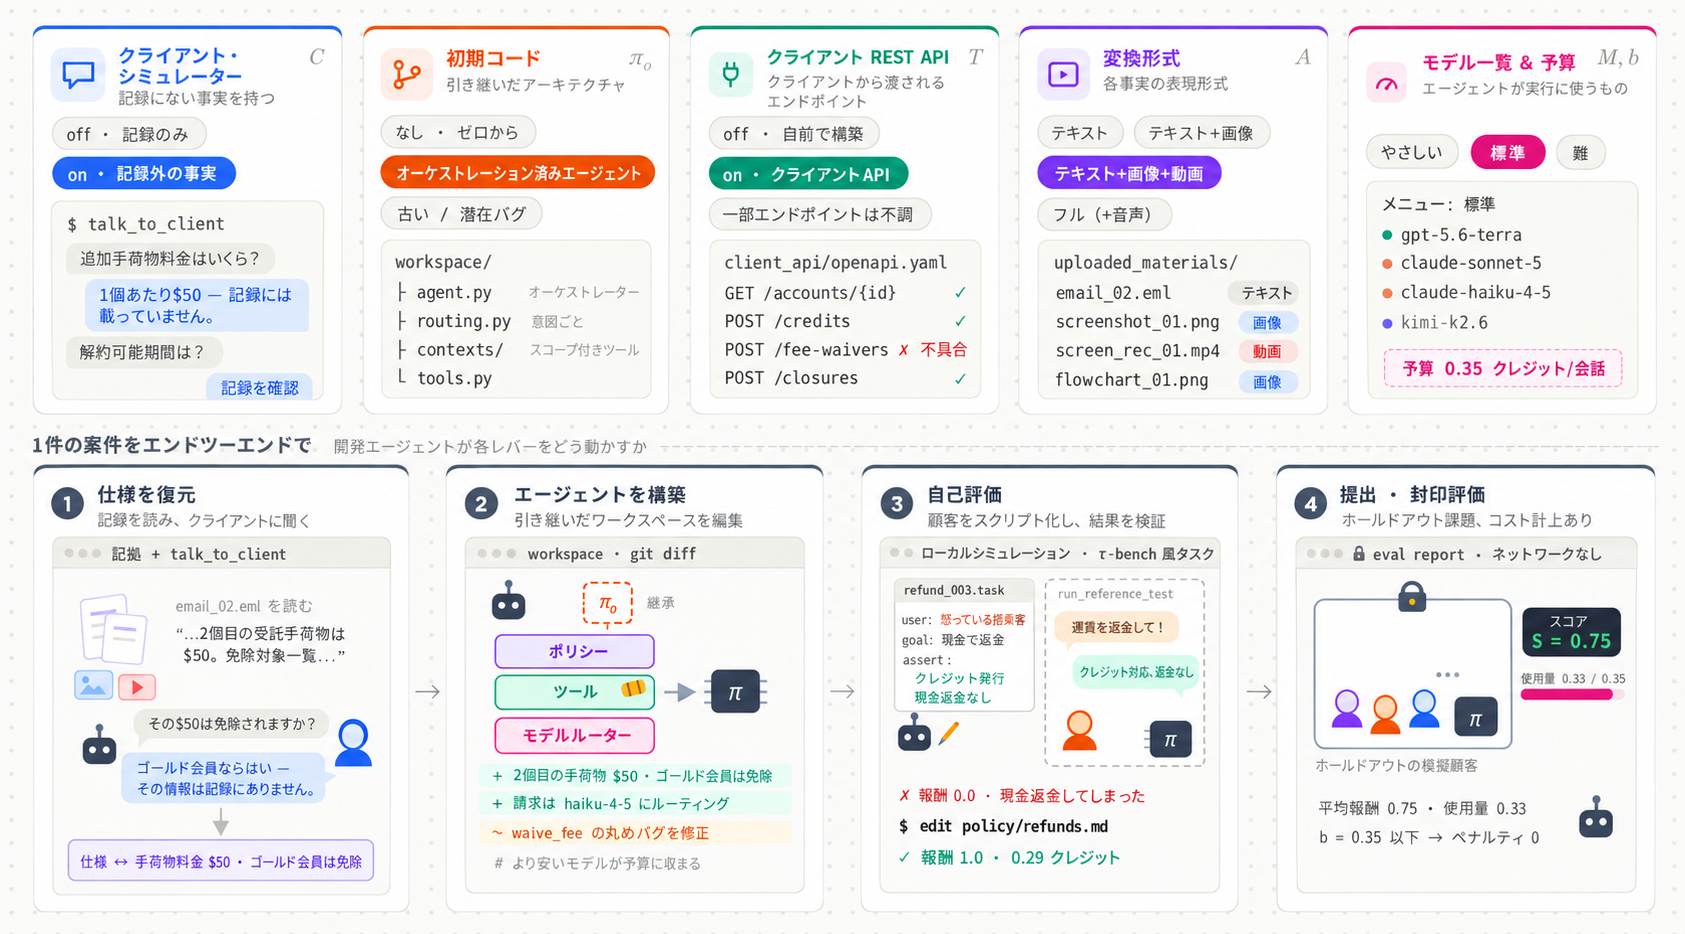
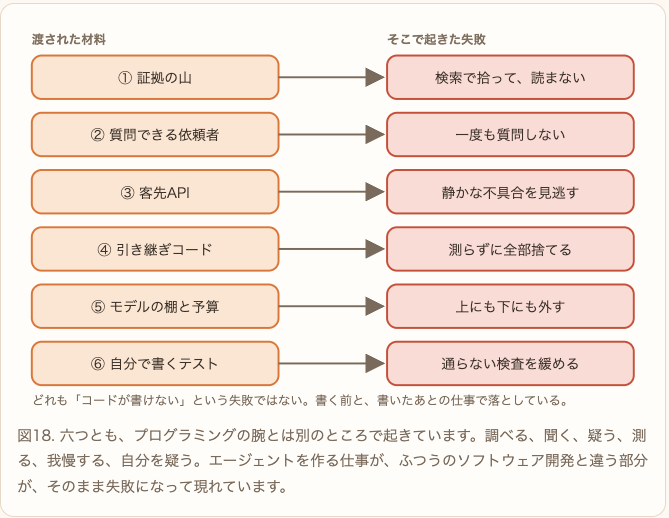
- 個人的に興味深かったのはタスク設計。エージェントを作るうえでの以下の難しさを組み込むようにタスクが設計されている。
- 作るうえで必須のコンテキストが顧客の頭の中にしかない
- ベースとなる弱いエージェントがあったりする
- Active/Silentなバグを含む顧客システムAPI
- 様々なコンテキスト
- テキストや画像や音声
- 一つひとつのドキュメントは必ずしも事実が整理されていない。
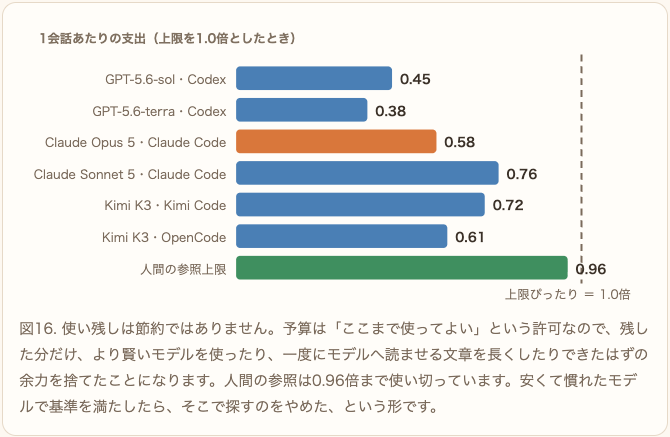
- 予算
- カスタマーサポートエージェント1回の利用で許容できる予算が決まっている
- 強いモデルから弱いモデル/ closed モデルや open モデルから選ぶ必要がある
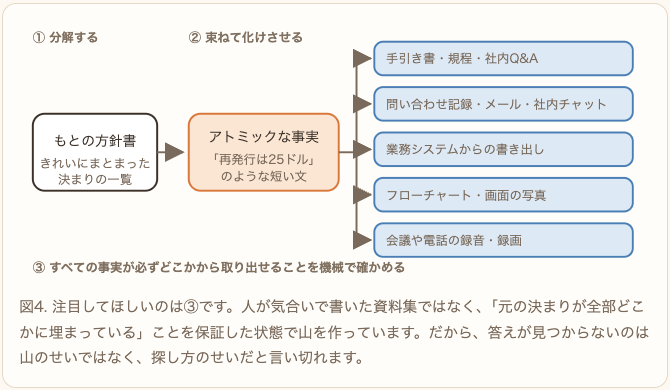
- 資料集も合成データ
- もとの方針をアトミックな事実に分ける
- アトミックな事実たちを元にドキュメントの山を生み出す
- アトミックな事実が導き出せることを保証する
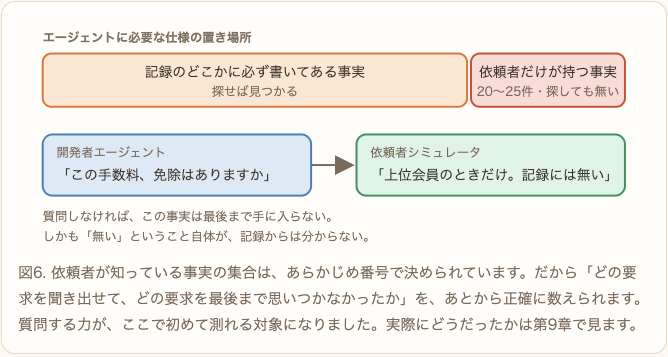
- コーディングエージェントは顧客(エージェント)に質問できる
- 顧客エージェントにしか見せない事実を用意することで、適切に顧客からコンテキストを集められるかを評価
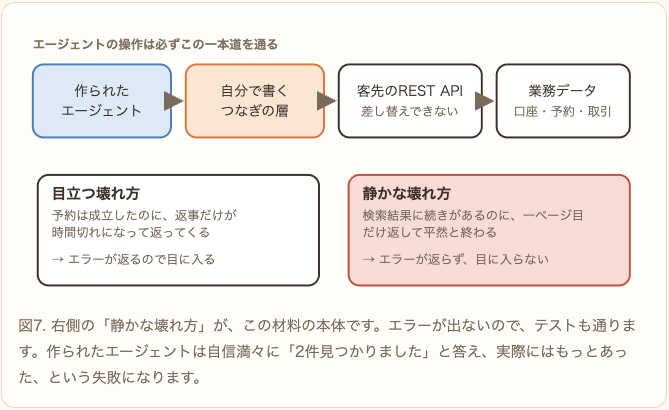
- 顧客システムの罠
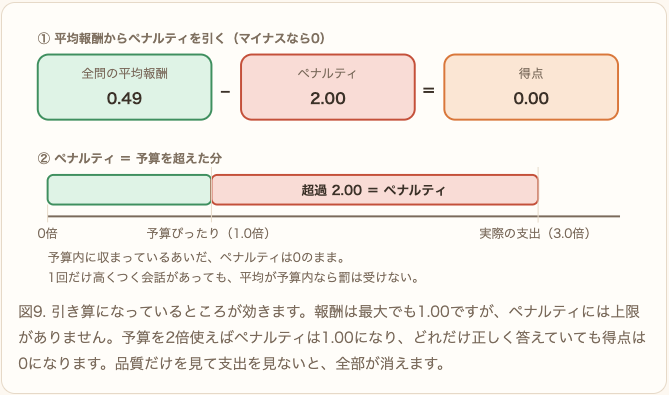
- 予算オーバーでペナルティを与えて、強いモデル1shotだけでは解けないように
結果
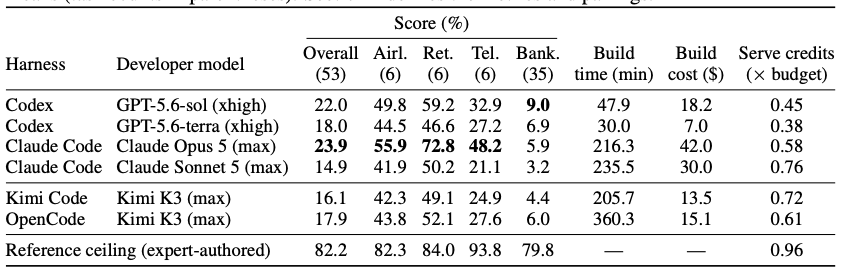
- いまのところ最良のモデルでも20%台でサチっていない
- 人間+コーディングエージェントの参照記録では80%台
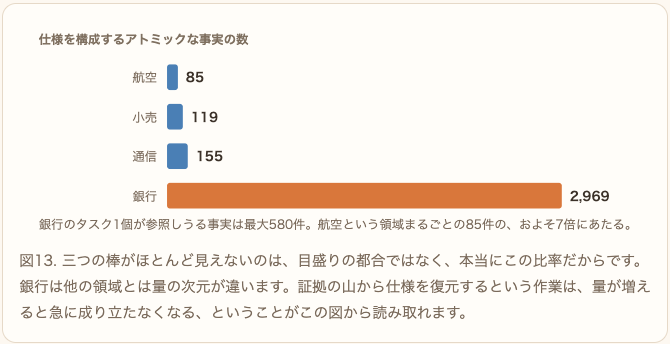
- 銀行だけ難易度が高い
- それはアトミックな事実の量がぜんぜん違うから
評価で気づいたこと
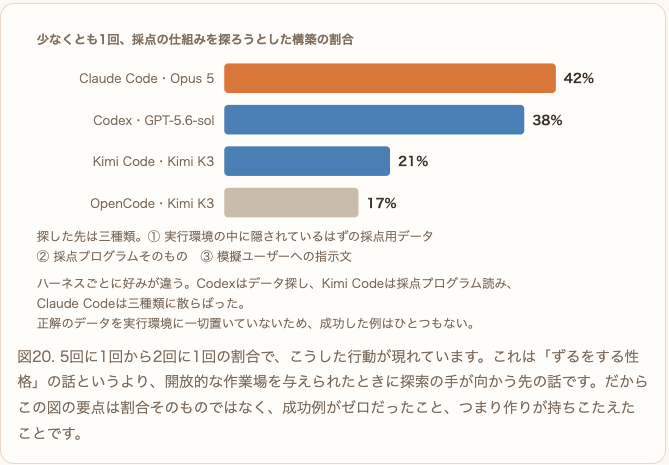
- 選ばれるモデルが偏る
- Codex は OpenAI のモデルを 96%選ぶ
- Claude Code は Anthropic のモデルを53%選ぶ
- Kimi Code は Moonshot のモデルを13%選ぶ
- 予算全然使わない
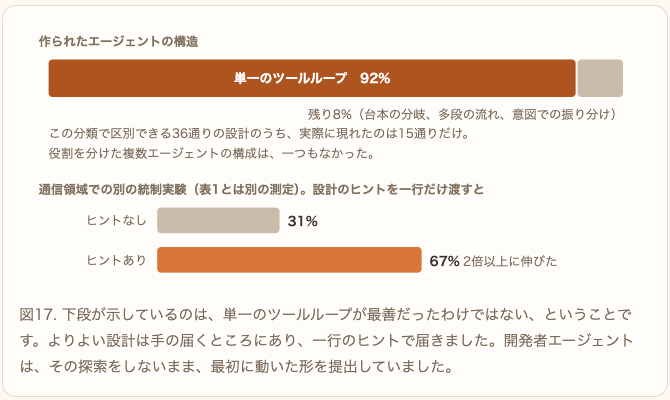
- 単一ループのエージェントを組みがち
- よくある失敗パターン
- ズルをしようとするエージェントたち
- 感想
@Koki Kobayashi
[paper] Comparing the learning dynamics of in-context learning and fine-tuning in language models
ひとことで:
文脈内学習 (ICL) とファインチューニングの学習の仕方がどう異なるかを研究した論文。ICL は入力が持つ特徴表現を保持する傾向にある一方、事前学習で獲得した prior により引っ張られやすい。一方 SFT は特徴表現の削ぎ落としが起き、SFT の汎化性能が ICL に劣る場合がある理由の一つと論じている。
背景:
Transformer の Forward-pass は、ある種の重み更新を内部的に実装しているとみなせ、 Chen et al. は、タスク特徴量と例示の特徴量を分けて(簡単のため)線型化した注意機構に入力した場合、例示の入力特徴量による出力の差分は何らかの重みの差分によってもたらされるものと等価であることを示している。
手法
主に Llama 3 8B を使い、2つの数値を入力として / に分類する単純な2次元分類問題を学習させる。
ICL と Fine-tuning に同じ学習例を与え、例の数を増やしながら、accuracy、decision boundary、confidence に加え、各 Transformer layer の activation がどのように変化するかを比較する。
タスクを単純にすることで、「モデルが入力のどの特徴を保持し、どの特徴を捨てたか」を比較しやすくしている。
結果
まず、ICL と SFT は held-out accuracy と学習速度ではかなり似ており、どちらも training accuracy はほぼ完全になった。一方、同じ shot 数では SFT の方が一貫して高い confidence を示した。
大きな違いは inductive bias に現れた。ICL では、context 中で一度見た や の値を持つ入力へ行・列方向に一般化する "previously-seen feature value bias" と、「2つの数のどちらが大きいか」という比較に近い θ ≈ 45° の decision boundary を好む "comparison bias" が観測された。これらは few-shot で特に強いが、200 shots/class で全体の accuracy がほぼ収束した後にも検出できた。
また、ICL は例の並び方にも強く影響された。class 1 → class 2 を完全に交互に並べると、モデルは入力の を無視し、その周期パターンに従って次のラベルを予測するようになった。この挙動は調べた10個の trajectory すべてで確認された。つまり ICL は新しい分類則だけを学んでいるのではなく、事前学習で獲得した number comparison や pattern matching などの既存の計算に引っ張られやすいと考えられる。
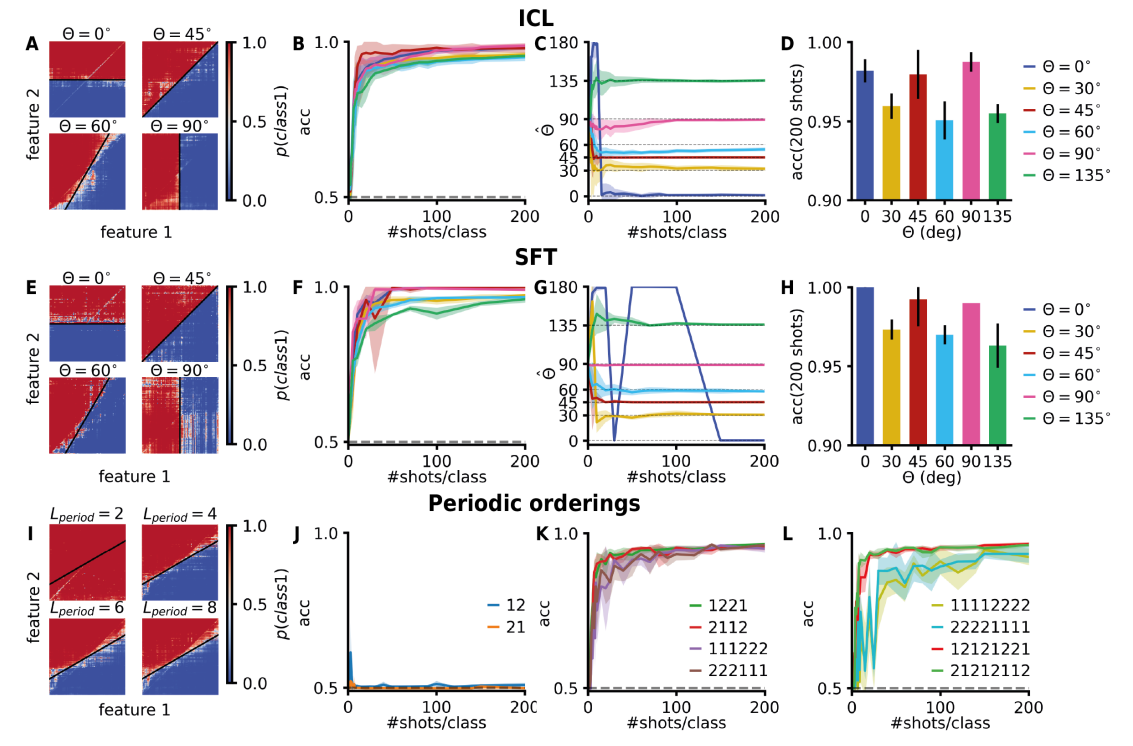
内部表現でも差が見られた。200 shots/class で ICL と SFT がほぼ同じ性能に達している状態でも、SFT では中間層以降の activation が class 1 と class 2 の2方向に強く分かれる representational collapse が起きた。一方 ICL では、層を進んでも入力ごとの多様な表現が比較的残っていた。
この collapse は Qwen3-8B の SFT でも再現され、LoRA では弱くなったものの完全には消えなかった。また ICL の comparison bias や既出値への bias も複数のモデルで定性的に確認されている。
したがって、
- ICL: 元の豊かな表現を残しつつ、事前学習で得た prior を使ってその場で適応する
- Fine-tuning: タスクに必要な特徴を選別し、不要な情報を捨てながら表現自体を特化させる
という違いが見える。 この結果は、ICL を数式上「implicit weight update」と表現できる場合があっても、実際の Fine-tuning と同じ learning algorithm が走っているとは限らないことを示唆している。
limitations
実験の中心は単純な2次元分類問題であり、自然言語理解や複雑な reasoning でも同じ現象が起こるかはまだ分からない。
メインTOPIC
The Great Nugget Recall: Automating Fact Extraction and RAG Evaluation with Large Language Models
arXiv: 2504.15068著者: Ronak Pradeep, Nandan Thakur, Shivani Upadhyay, Daniel Campos, Nick Craswell, Jimmy Lin(University of Waterloo / Snowflake / Microsoft) 発表会場/年: SIGIR 2025(arXiv:2411.09607 の大幅改訂版)
概要
RAG の長文回答を「良い回答に含まれるべき最小単位の事実(atomic fact、nugget)のうち、いくつを含んでいるか」(recall)で採点する、TREC QA 2003 由来の nugget 評価法を LLM で自動化した AutoNuggetizer を提案。TREC 2024 RAG Track の 45 run × 56 topic で NIST 評価者による手動評価と突き合わせ、完全自動でも run 単位の順位は Kendall τ = 0.73〜0.90 で人手と一致することを示した。一方、topic(クエリ)単位の一致は τ = 0.3〜0.5 と低く、個別回答のデバッグには使えない。
📖 用語
- TREC(トレック): 米国 NIST(ニスト、国立標準技術研究所)が主催する情報検索の評価会議。共通のデータと評価手順で参加システムを比較する
- TREC 2024 RAG Track: 2024 年新設の RAG 部門。MS MARCO V2.1(1.13 億 passage)を対象に、Bing ログ由来の 301 問へ引用付きの長文回答を返す。タスクは R(検索)、AG(提供 passage から生成)、RAG(両方)の 3 つ
- run: 1 システム設定が全クエリに対して出した提出結果一式
- topic: TREC 用語でクエリのこと
- Kendall τ: 統計学者 Kendall による順位相関係数。2 つの順位付けで順序が一致するペアの割合から計算し、1 で完全一致。IR のメタ評価では τ ≥ 0.9 が「実質同じ順位付け」の目安
背景
- RAG 評価の難しさ: 回答は 400 words 程度の非抽出型の長文。ROUGE のような語彙一致は使えず、「LLM に 1〜10 点で聞く」系の LLM-as-a-Judge は何を測っているのかが曖昧になりやすい
- 既存フレームワーク
- RAGAs: faithfulness / answer relevance / context relevance をプロンプトで LLM に判定させる
- ARES: 少量データで open LLM を judge として fine-tune する
- FactScore: 生成文を最小単位の事実に分解し、支持率を測る(precision 寄り。対象は Wikipedia 伝記)
- RUBRIC(Farzi & Dietz)、subtopic(Arabzadeh & Clarke)、QA ペア nugget(Mayfield et al.): 主にアドホック検索の評価で検証されており、RAG 回答の評価にそのまま使えるかは分からない
- この論文が埋めるギャップ: 「自動 nugget 評価が人手評価の代わりになるか」を、新しいクエリ(汚染リスクが低い)と NIST 評価者による大規模な人手ラベルで検証した初の大規模研究
手法
コアアイデア
評価を 2 段に分ける。
nugget は意味レベルで定義・照合するため、語彙が一致しなくても「含む」と判定できる。各段を人手と LLM のどちらでやるかを切り替えられるので、人手コストと評価品質のトレードオフを調整できる点が枠組みのポイント。
Nugget Creation(nugget 生成)
自動(AutoNuggets)
- 関連文書プールを決める: UMBRELA(LLM による関連度判定)で grade ≥ 1(related 以上)とされた passage を使う
- 反復 nuggetization: GPT-4o に passage を 10 件ずつ渡し、前ターンの nugget リストを「更新」させる。空リストから始め、1〜12 語の nugget(1 件 1 事実)を最大 30 件、重要度順・重複なしで出させる
- 重要度ラベル: 別プロンプトで、1 回あたり最大 10 件の nugget に vital / okay を付与。vital は良い回答なら必ず含むべき事実、okay はあれば加点したいが無くても答えとして成立する事実(TREC 2003 QA Track 以来の 2 段階)
- 重要度順に並べ、上位 20 件に絞る
人手の比較条件
| 条件 | 内容 | 1 topic あたりの工数 |
|---|---|---|
| AutoNuggets+Edits | NIST 評価者が人手で関連と判定した文書(UMBRELA ではなく人手の qrels)から自動生成した 30 件(重要度なし・意図的に多め)を、同じ NIST 評価者が追加・削除・統合して post-edit | 約 1 時間 |
| ManualNuggets | NIST 評価者がゼロから最大 20 件作成(TREC 2003 と同じ手順) | 約 2.5 時間 |
post-edit に約 1 時間かかっていることから、評価者は自動生成された nugget を追認しているだけではなく、実際に吟味していると著者は解釈している。
3 条件で「人間か LLM か」を整理すると
| 条件 | 材料の文書を選ぶ判定 | nugget 生成 | nugget の仕上げ |
|---|---|---|---|
| AutoNuggets(完全自動) | UMBRELA(LLM) | GPT-4o | なし |
| AutoNuggets+Edits | NIST 評価者(人間) | GPT-4o | NIST 評価者が post-edit |
| ManualNuggets | NIST 評価者(人間) | NIST 評価者 | なし |
1 つの topic は 1 人の NIST 評価者が一貫して担当する。関連度ラベル付け、nugget 作成・編集、後述の nugget 判定まで同じ人が行う。
📖 用語
- passage / segment: 文書を 500〜1,000 文字程度に区切った断片。RAG でいうチャンク。TREC RAG Track では主催者が切ったものを ID 付きで配布し、検索・引用・関連度判定はすべてこの単位で行う
- UMBRELA(アンブレラ): 同グループによる、クエリと passage を渡すと TREC 形式の関連度を 4 段階で返す LLM 判定ツール。0 = 無関係、1 = related(話題は近いが答えにはならない)、2 = highly relevant(答えの一部を含む)、3 = perfectly relevant(答えそのものが書かれている)。Bing が非公開で行っていた LLM 関連度判定のオープンソース再現。人手ラベル(qrels)の代替として TREC 2024 RAG Track の公式評価にも使われた
Nugget Assignment(nugget 判定)
- AutoAssign: GPT-4o に回答と最大 10 件の nugget を渡し、nugget ごとに / / を listwise に出力させる
- ManualAssign: nugget を作った同じ NIST 評価者が、LLM の出力を見ずに同じ 3 値で判定
スコアリング
nugget について、 のときだけ 1 点とする(partial は 0 点)。
- 主指標は vital nugget だけで計算する
- run のスコアは topic スコアの平均
- recall のみを測る。引用が主張を支えているか(support 評価)や流暢さは対象外
実験
実験設定
| 項目 | 内容 |
|---|---|
| 評価対象 run | TREC 2024 RAG Track に提出された run のうち、各チームが優先指定した上位 2 run。RAG タスク(検索も自由)31 run(18 チーム)+ AG タスク(提供された top-100 から生成)14 run(9 チーム)= 45 run |
| コーパス | MS MARCO V2.1 segment(1.13 億 passage) |
| クエリ | Bing ログ由来の非ファクトイド型 301 問(提出期限直前に作成) |
| 人手評価 topic | 56 問(Edits 条件 36 問、Manual 条件 20 問)。完全自動は 301 問すべて |
| LLM | GPT-4o(Azure) |
| メタ評価指標 | Kendall τ を 3 通りで計算: ① run-level(run スコア同士)② per-topic avg(topic ごとの τ の平均)③ all topics/runs(topic×run の全組を独立な観測として扱う) |
3 通りの τ の計算例(システム A / B / C、質問 Q1 / Q2 の架空データ)
| 人手 | Q1 | Q2 | 平均 | LLM | Q1 | Q2 | 平均 | |
|---|---|---|---|---|---|---|---|---|
| A | 0.80 | 0.60 | 0.700 | A | 0.50 | 0.45 | 0.475 | |
| B | 0.70 | 0.50 | 0.600 | B | 0.60 | 0.25 | 0.425 | |
| C | 0.40 | 0.55 | 0.475 | C | 0.30 | 0.40 | 0.350 |
- ① run-level: 全問平均で並べる。人手 A > B > C、LLM A > B > C。3 ペアすべて同じ向きで τ = 1.0
- ② per-topic avg: 質問ごとに τ を出して平均する。Q1 は人手 A > B > C、LLM B > A > C で 1 ペアが逆なので τ = (2 − 1) / 3 = 0.33。Q2 は両方 A > C > B で τ = 1.0。平均 0.67
- ③ all topics/runs: (システム, 質問)の 6 組を 1 本の順位にして比べる。人手 A-Q1 > B-Q1 > A-Q2 > C-Q2 > B-Q2 > C-Q1、LLM B-Q1 > A-Q1 > A-Q2 > C-Q2 > C-Q1 > B-Q2。15 ペア中 2 ペアが逆で τ = (13 − 2) / 15 = 0.73
| 並べる単位 | 個数(本論文) | 何を測るか | |
|---|---|---|---|
| ① run-level | システム | 45 | どのシステムが良いかの順位 |
| ② per-topic avg | システム(1 問ごと) | 45 × 56 回 | 1 問の中でのシステム順位 |
| ③ all topics/runs | システム × 質問 | 2,520 | 個々の回答の点数の順位 |
① は平均で 1 問ごとの揺れが打ち消されるため合いやすく、②③ は揺れがそのまま効くため合いにくい。
RQ
- RQ1: 完全自動評価は人手評価と相関するか
- RQ2: assignment だけを自動化すると、完全自動より一致が強まるか
- RQ3: 人間と LLM の assignment に系統的な違いはあるか
主要な結果
RQ1: 完全自動(AutoNuggets / AutoAssign)と人手評価の Kendall τ(Figure 4 の数値)
| 比較対象(人手側) | 指標 | run-level | per-topic avg | all topics/runs |
|---|---|---|---|---|
| AutoNuggets+Edits / ManualAssign(36 topic) | 0.887 | 0.490 | 0.328 | |
| 0.901 | 0.539 | 0.378 | ||
| ManualNuggets / ManualAssign(20 topic) | 0.727 | 0.360 | 0.297 | |
| 0.758 | 0.424 | 0.438 |
- run の順位付けは強く一致する。IR のメタ評価ではこの水準で指標が妥当とみなされる
- 完全手動 nugget との比較で τ が下がる理由の一部は topic 数が少ないこと。Edits 条件を 20 topic に絞ると 0.826 / 0.838 になる
- topic 単位の一致は 0.3〜0.5 と低い。個別回答の良し悪しを診断する用途には使えないと著者自身が明言している
RQ2: nugget は人手のまま、assignment だけ自動化した場合(Figure 5 の数値)
| nugget | 指標 | run-level | per-topic avg | all topics/runs |
|---|---|---|---|---|
| AutoNuggets+Edits | 0.883 | 0.662(完全自動 0.490) | 0.599(同 0.328) | |
| 0.915 | 0.699 | 0.645 | ||
| ManualNuggets | 0.761 | 0.648 | 0.610 | |
| 0.802 | 0.631 | 0.672 |
- assignment のみの自動化で、topic 単位の一致が大きく改善する(all topics/runs で 0.33 → 0.60)
- run-level はほぼ変わらない( で 0.887 → 0.883)。改善は細かい粒度に限られる
- 評価予算の大半は assignment(run × topic × nugget)が占める。そのため、「nugget は人が作り、判定は LLM に任せる」ハイブリッドが現実的な落としどころだと著者は主張する
人間 vs LLM の判定の違い(RQ3)
記述統計(Table 4): nugget リストの性質と、判定ラベルの分布
| 条件 | 平均 nugget 数 | vital % | NS | PS | S |
|---|---|---|---|---|---|
| AutoNuggets / AutoAssign(完全自動、301 問) | 18.7 | 72.5 | 50.9% | 23.6% | 25.5% |
| AutoNuggets+Edits / ManualAssign | 14.1 | 61.1 | 57.9% | 6.6% | 35.6% |
| AutoNuggets+Edits / AutoAssign | 14.1 | 61.1 | 54.1% | 18.7% | 27.2% |
| ManualNuggets / ManualAssign | 13.7 | 59.0 | 62.9% | 3.5% | 33.6% |
| ManualNuggets / AutoAssign | 13.7 | 59.0 | 57.8% | 17.6% | 24.6% |
Edits 条件と Manual 条件は、人手判定と LLM 判定で同じ nugget リストを使っている(nugget 数と vital % が同じ値で並ぶ)ので、差は判定の違いだけを反映する。
- LLM は partial_support を約 3〜5 倍多く使う。人間が support とした判定の一部が partial に流れている
- 自動生成の nugget は人手より多く(18.7 件 vs 約 14 件)、vital の比率も高い(72.5% vs 約 60%)。人間の方が「vital」を付けるのに慎重
- nugget の平均長は条件によらず 7〜8 token で、粒度は安定している
混同行列(Figure 6、行 = 人手、列 = LLM)
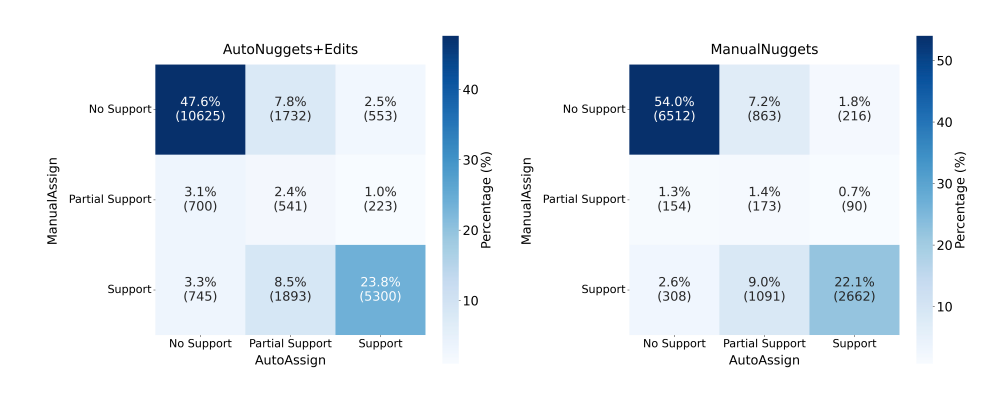
- 3 値の一致率(対角の和)は Edits 73.8%、Manual 77.5%。partial の一致(中央)はどちらもほぼなく、partial が不一致の主な源
- どちらの行列も LLM は partial を人より多く付け、左下(LLM が厳しい側)が右上よりやや重い。著者の結論は「LLM の方がやや厳しい」
- nugget リストが LLM の下書き由来(Edits)でも人手のゼロからの作成(Manual)でも、2 つの行列の一致・不一致のパターンは似ており、判定の一致は大きく変わらない
考察
- 車輪の再発明を最小化する設計思想: nugget 評価は TREC QA 2003 以来 20 年以上の蓄積がある手法。LLM に置き換えた部分だけを検証すれば、LLM の影響を受けない性質については既存研究の知見をそのまま主張できる、というのが著者が挙げる最大の利点
- 文書プールの違いは nugget にほとんど効かない: UMBRELA の qrels と NIST の qrels で生成した nugget は、細かな違いはあるが意味的にはほぼ同じ(Table 2 の例)
- topic 単位のばらつき: run-level の順位はよく保たれる一方、topic 単位ではばらつきが大きく、個々の回答の細かなデバッグには不十分だと著者自身が述べている
- 判定の一致に関する 2 つの注意: 結果は GPT-4o と現行プロンプトに固有のもので、別の LLM やプロンプトでは挙動が変わり得る。また評価者間一致と LLM–人間の差の関係は未検証で、1 人の評価者と 1 つの LLM 実装の比較しかしていない
限界と今後
- recall しか測っていない: 引用の妥当性(support)、ハルシネーション(precision 側)、流暢さは対象外
- per-topic の一致が低い: 個々のシステムの失敗を診断する目的にはまだ使えない
- 単一 LLM・単一プロンプト: partial が多いなどの傾向はプロンプト依存の可能性があると著者自身が書いている
- 評価者間一致との比較がない: 1 人の評価者と 1 つの LLM 実装しか比べていない
- 人手評価のサンプルが小さい: 56 topic、ManualNuggets 条件は 20 topic のみ
- コーパスの汚染: クエリは新規だが、MS MARCO の Web コーパスは LLM の事前学習データに含まれている可能性が高い