2026-09-29 機械学習勉強会
今週のTOPIC[blog] Contrastive Language Models[paper] Knowledge Acquisition During Pre-training? Large Language Models Learn Better With Auxiliary Views[paper] A Framework for Generating Valid Context-Specific Benchmarks through Expert Guidance[paper]APEX-Accounting[paper] Establishing Best Practices for Building Rigorous Agentic Benchmarks[blog] Towards RL for Superhuman Text: Unslopping AIメインTOPICRRSI: Regularized Recursive Self-Improvement of Agent Harnesses概要背景: harness evolution とその過学習問題設定提案手法: RRSI提案側の正則化選択側の正則化実験設定実験結果分析
今週のTOPIC
@Naoto Shimakoshi
[blog] Contrastive Language Models
概要
- Stanford / NVIDIA Research が公開した Contrastive Language Models (CLM)。行動を LLM に生成させる代わりに、状態と候補行動の埋め込みを照合して選ぶ System One モデル
- 凍結した Qwen3-8B に 20M パラメータの射影ヘッドを載せ、(状態, 行動) ペアの対照学習 (InfoNCE) だけで学習。zero-shot で Jev と同水準の成功率を最大 9 倍速く出し、verifier に fine-tune すると DeepSWE 81.6% / Terminal-Bench 2.1 87.6% で SOTA
- 損失が compute・データ量・ヘッドサイズ・エンコーダサイズそれぞれの power law に従うスケーリング則も提示。マルチモーダルの CLM-35B を来月公開予定
背景・課題
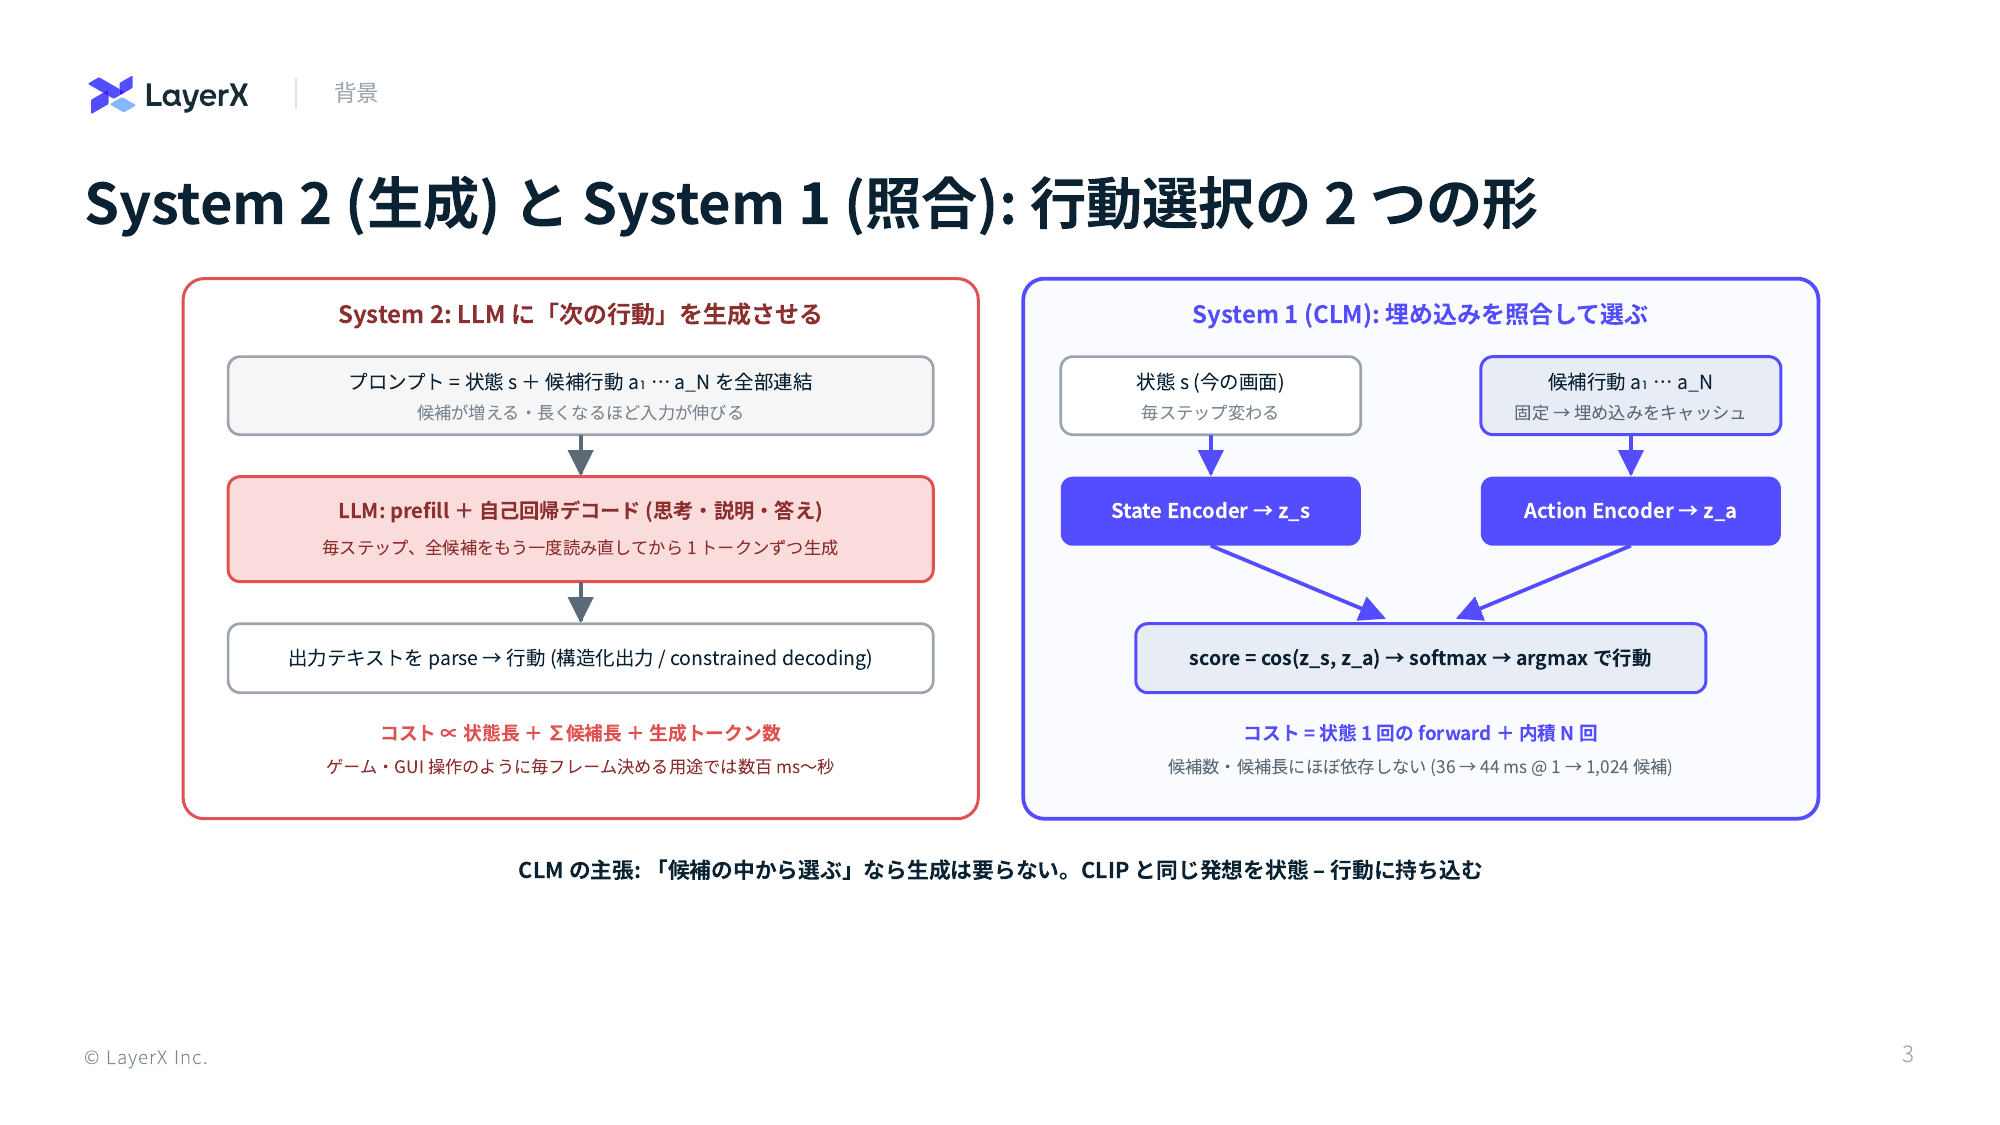
- エージェントの各ステップは「与えられた候補から 1 つ選ぶ」問題であることが多い
- ゲームのキー入力、ツール一覧からの選択、Wikipedia のリンク、Best-of-N の候補解など
- 生成型 LLM に解かせると
- 状態 + 全候補をプロンプトに詰めて prefill し、さらに自己回帰でデコード
- コストは候補数・候補長に比例し、毎ステップ全候補を読み直す
- 出発点: CLIP が画像とテキストを同じ空間で照合するように、状態と行動を同じ埋め込み空間に置けば「選ぶ」ために生成は要らない
手法
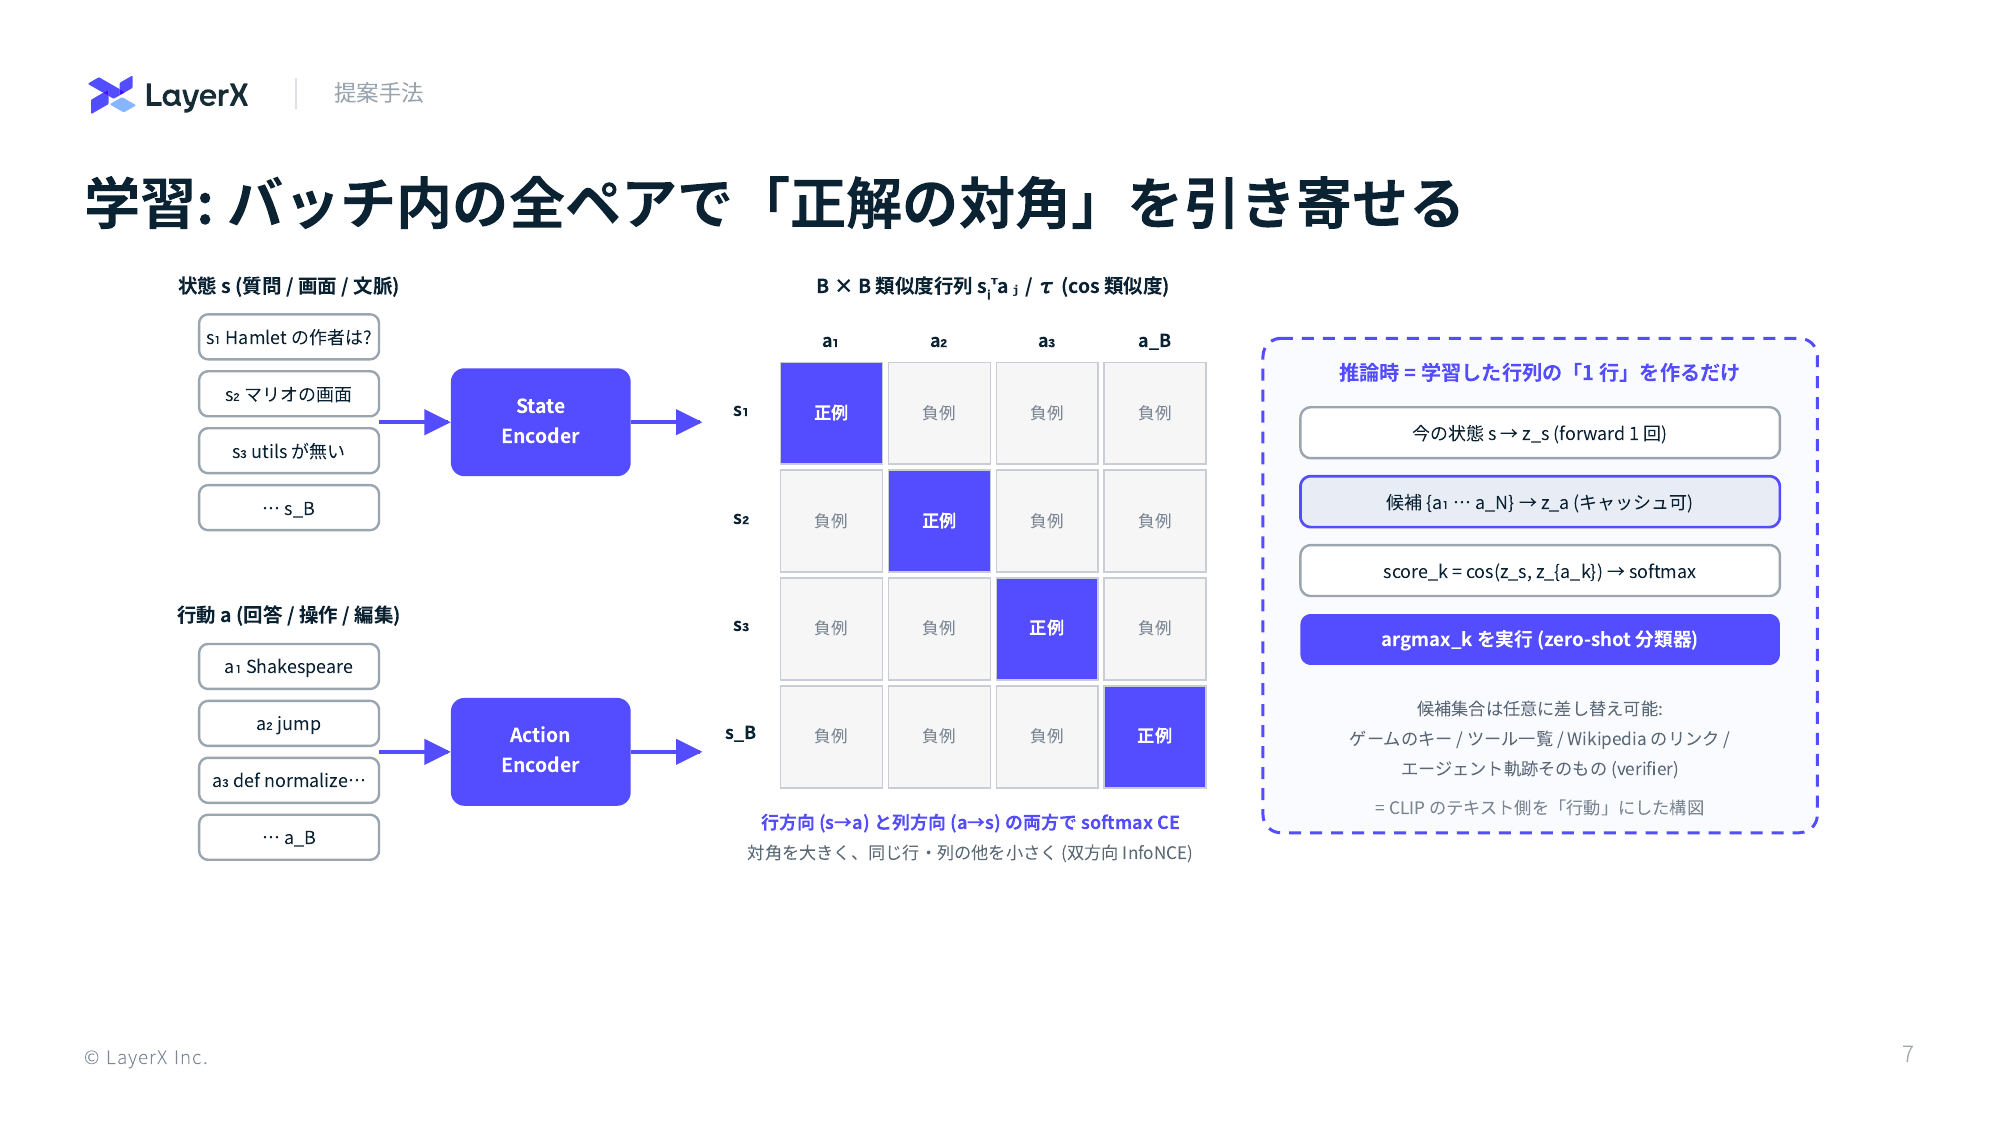
- 構成: State Encoder と Action Encoder の 2 塔
- 各塔 = 凍結 LLM (Qwen3-8B) の最終トークン hidden state → L2 正規化 → 3 層 MLP (4096 → 1536 → 1536 → 512)
- 学習対象は 2 塔合計で約 20M のヘッドだけ。LLM 側の埋め込みは 1 回計算してディスクに置き使い回す
- 損失: 双方向 InfoNCE
- バッチ内 B 組から B×B の類似度行列を作り、対角 (正解ペア) を行方向・列方向の両方で softmax の 1 位にする
- 分子は同じ内積でも競争相手が「B 個の行動」と「B 個の状態」で異なるため、行動側の埋め込みにも状態を弁別する情報が入る
- 推論: 状態を 1 回 forward → キャッシュ済みの候補行動埋め込みと cos 類似度 → argmax
- 行動集合が固定なら 1 ステップ 1 forward で済む
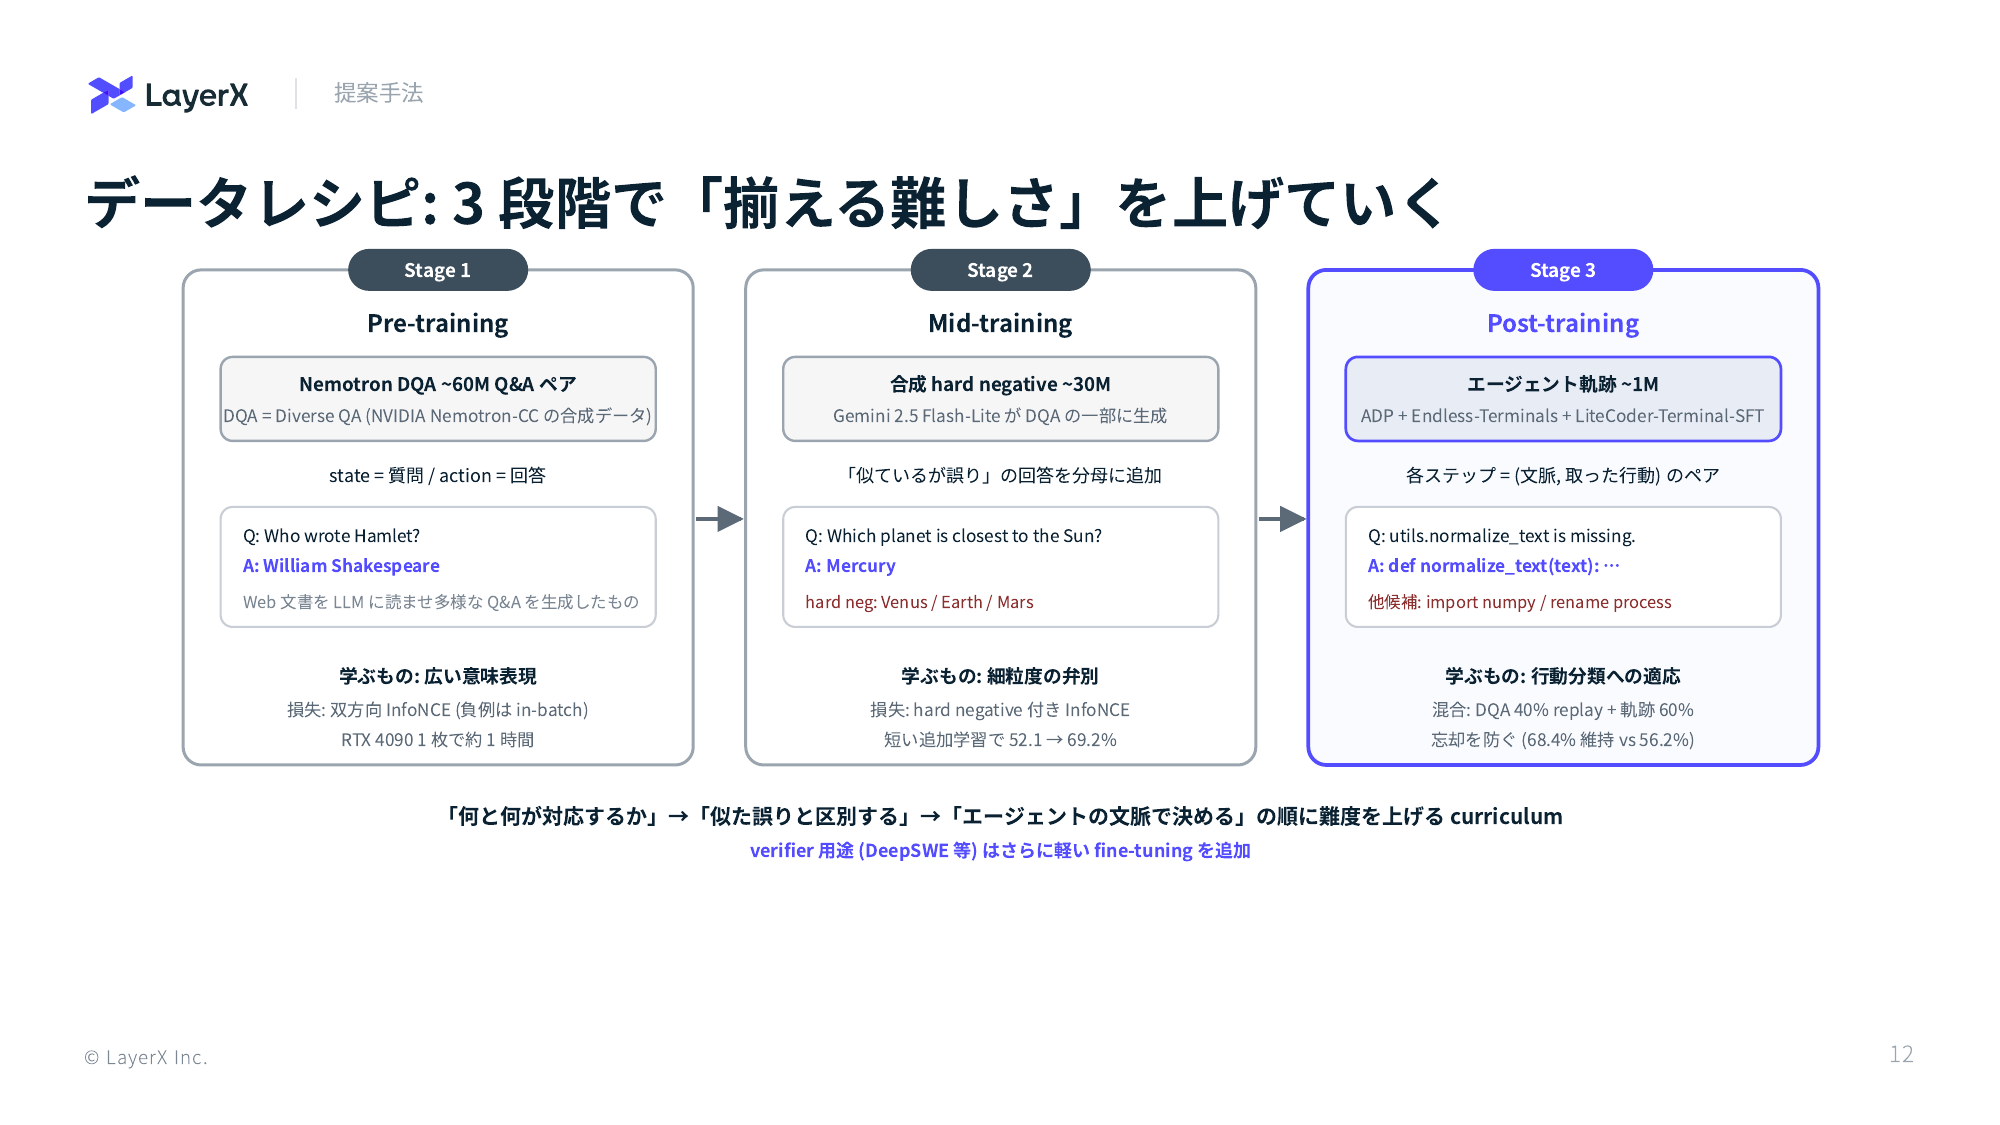
| 段階 | データ | 状態 / 行動 | 学ぶもの |
|---|---|---|---|
| Pre-training | Nemotron DQA 60M ペア (Web 文書から LLM が合成した多様な Q&A。Diverse QA の略) | 質問 / 回答 | 広い意味表現。負例はバッチ内の他の回答 |
| Mid-training | Gemini 2.5 Flash-Lite で生成した 30M の hard negative (意味は近いが誤りの回答) | 同上 | 紛らわしい候補との弁別。hard negative を分母に追加 |
| Post-training | ADP などの 1M エージェント軌跡 + DQA を 40% replay 混合 | 文脈 / 取った行動 | 行動分類への適応。replay で忘却を防ぐ |
- Ablation
- hard negative は最初から混ぜると 62.4% で頭打ち、pre-training 後に短く当てると 69.2%
- replay なしで軌跡だけ学習すると Nemotron の精度が 69% → 56.2% に低下、replay ありなら 68.4% を維持
- Nemotron での pre-training 一式は RTX 4090 1 枚で約 1 時間
補足: Nemotron DQA はどう作られているか
- 出典: Su et al., "Nemotron-CC: Transforming Common Crawl into a Refined Long-Horizon Pretraining Dataset", ACL 2025 — arXiv:2412.02595 / ACL Anthology
- 全体パイプライン (Common Crawl → 6.3T token): HTML から本文抽出・重複除去 → 品質分類器のアンサンブル (DCLM 系 + FineWeb-Edu 系) で品質バケットに分割 → ヒューリスティックで捨てる代わりに LLM で書き直してトークン量を確保 (DCLM 同等の MMLU で実トークン数 4 倍)
- 低品質文書: Maini et al. (2024) の「medium Wikipedia」プロンプトで Wikipedia 風に書き直す
- 高品質文書: 複数形式の合成データを生成。Diverse QA pairs (DQA) はその 1 つで、文書中の事実について yes/no・自由回答・選択式など形式を変えた質問と回答のペアを作らせる。他に Wikipedia 風書き直し、要約 (distill)、知識抽出、知識リスト
- CLM での使い方: DQA の質問を状態、回答を行動と見なす。人手ラベルなしに Web 規模の (状態, 行動) 対応が得られる
- CLM 側に記載がないこと: Nemotron-CC のどの版・どの言語を使ったか、「60M ペア」が全体の DQA の何割か
- 派生データ: Nemotron-CC-v2.1、Nemotron-Pretraining-Specialized-v1 (High-Quality-DQA)
結果
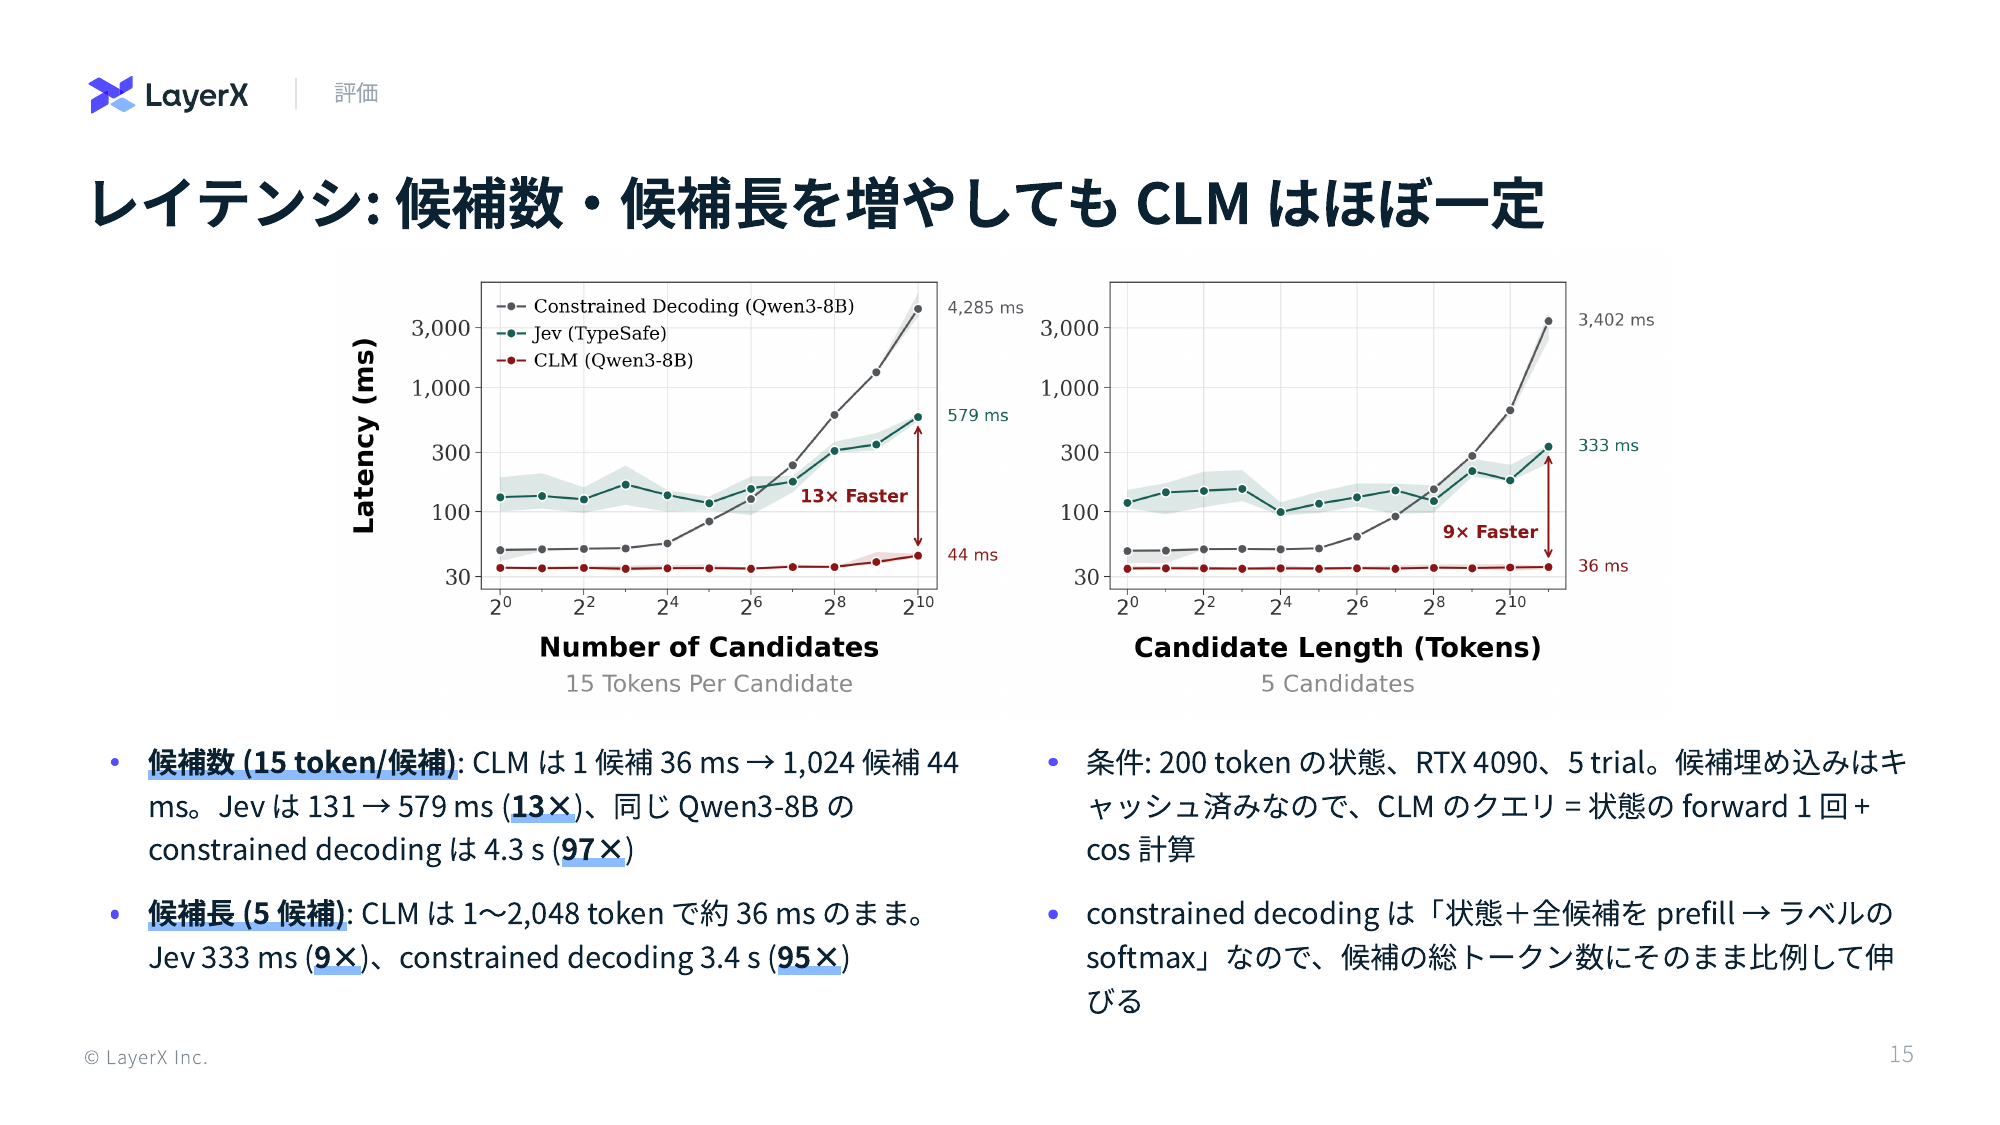
- レイテンシ (200 token の状態、RTX 4090)
- 候補数 1 → 1,024: CLM 36 → 44 ms、Jev 131 → 579 ms (13 倍)、同じ Qwen3-8B の constrained decoding 4.3 s (97 倍)
- 候補長 1 → 2,048 token: CLM は 36 ms のまま、Jev 333 ms (9 倍)
- Zero-shot (Jev と同水準の成功率で 1.6〜9 倍速い。2 タスクではやや下回る)
| タスク | CLM-8B latency | Jev latency | CLM-8B 成功 | Jev 成功 |
|---|---|---|---|---|
| T-Rex Game | 16.5 ms | 149.8 ms | 5/5 | 5/5 |
| Tool calling (BFCL V4) | 76.8 ms | 125.5 ms | 95.2% | 99.2% |
| Wikiracing | 79.8 ms | 225 ms | 26/30 | 30/30 |
| Super Mario | 33.5 ms | 132.6 ms | 5/5 | 5/5 |
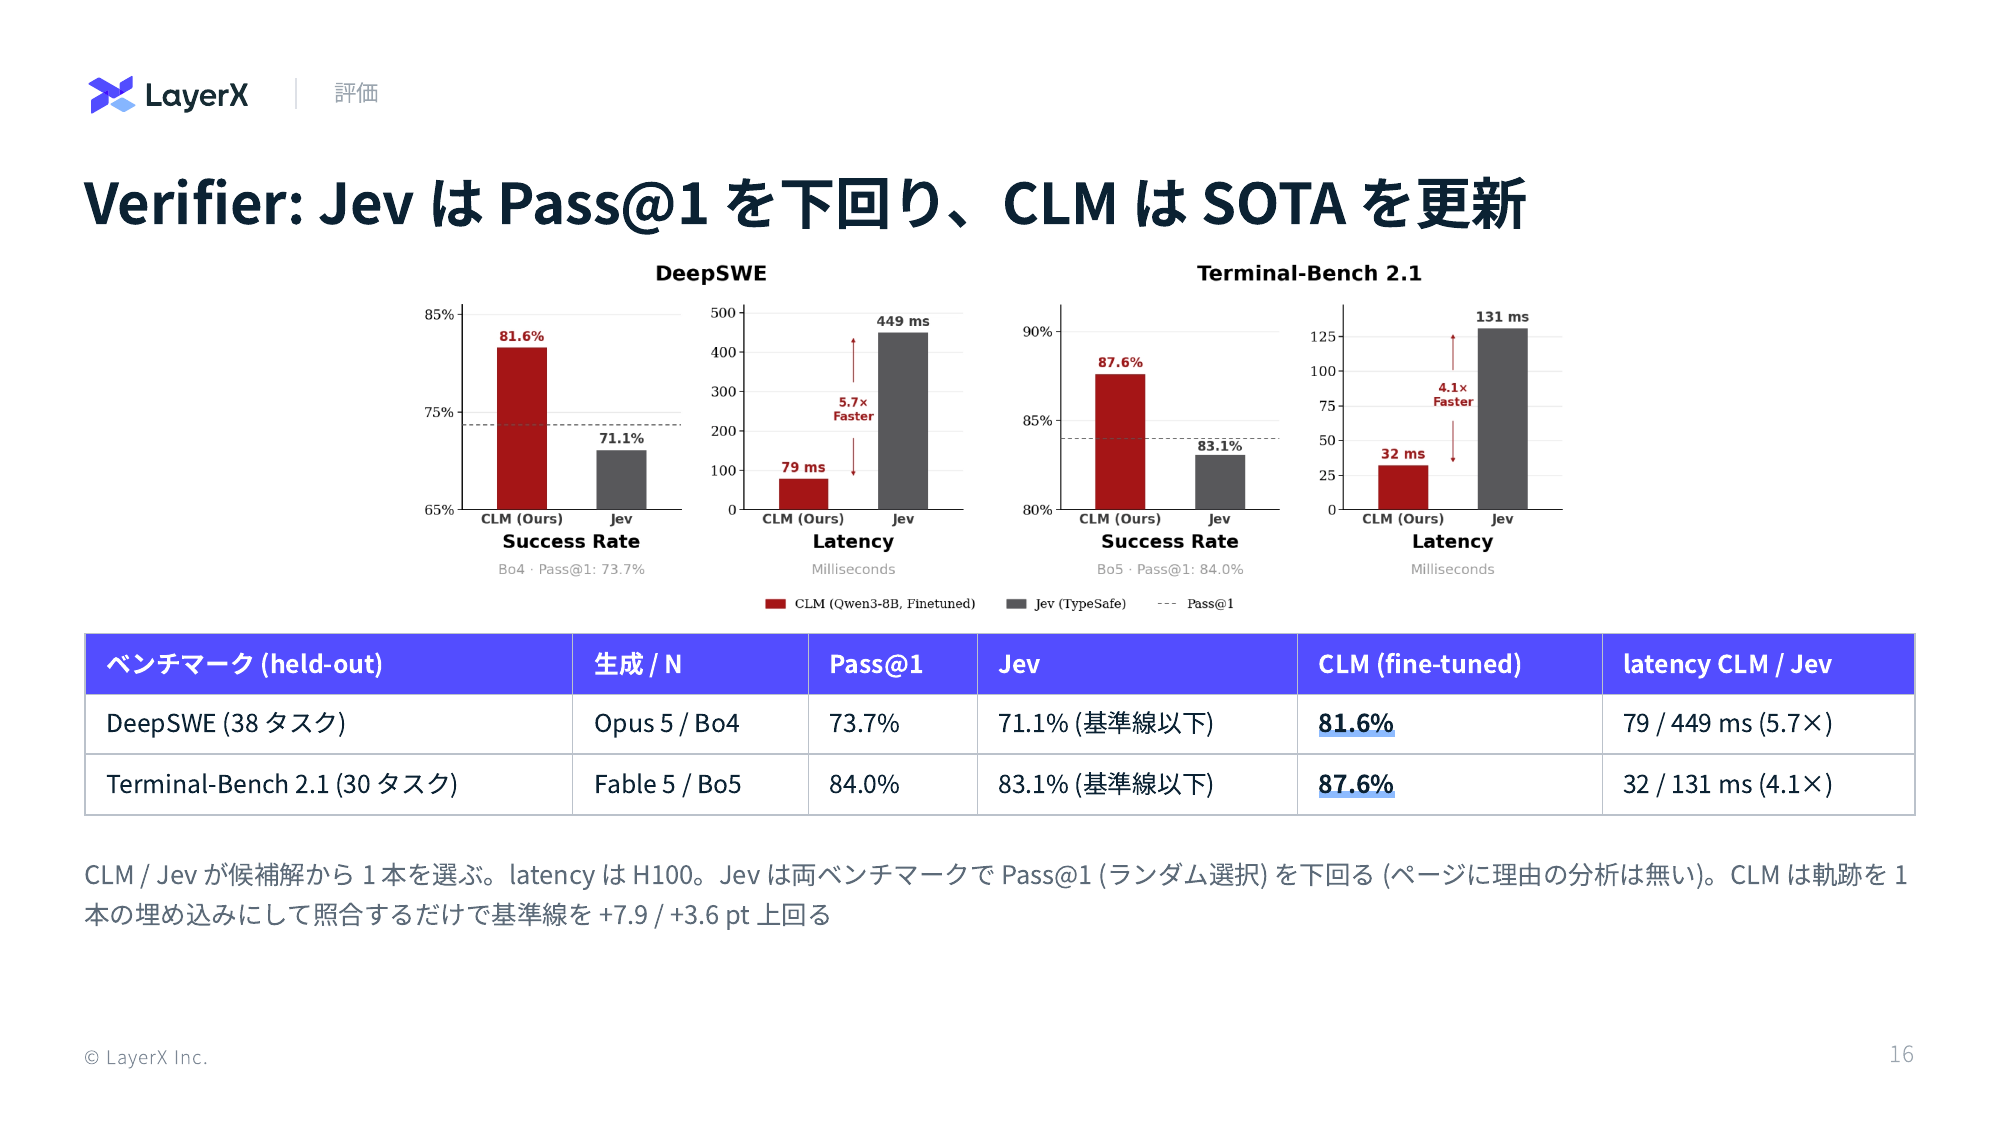
- Verifier (Opus 5 / Fable 5 がサンプリングした候補解から 1 本選ぶ。latency は H100)
| ベンチマーク (held-out) | N | Pass@1 (ランダム選択) | Jev | CLM (fine-tuned) | latency CLM / Jev |
|---|---|---|---|---|---|
| DeepSWE (38 タスク) | Bo4 | 73.7% | 71.1% (基準線以下) | 81.6% | 79 / 449 ms (5.7 倍) |
| Terminal-Bench 2.1 (30 タスク) | Bo5 | 84.0% | 83.1% (基準線以下) | 87.6% | 32 / 131 ms (4.1 倍) |
- スケーリング則: test InfoNCE loss は各変数に power law で従う
- 指数はエンコーダサイズの 0.172 が最大、compute 0.144、データ 0.117、射影ヘッド 0.061 が最小
- 最適ヘッドサイズは学習トークン数にほぼ線形 (N* ∝ D^1.02)、約 310 token / parameter
所感
- 「候補から選ぶ」工程は生成しなくてよい、というのが本質。固定の行動集合を持つエージェントや Best-of-N の選択器にそのまま載る
- 学習が凍結 LLM + 20M ヘッドで済むので、自社の (文脈, 採用した行動) ログがあれば同じレシピで verifier を安く作れる現実味がある
- 候補を作る側は依然として System 2 の仕事。Jev は TypeSafe API 経由の外部モデルで内部構成の記載が無く、verifier 評価も held-out 38 / 30 タスクと小規模なので、数値の解釈には幅を持たせたい
@Yuya Matsumura
[paper] Knowledge Acquisition During Pre-training? Large Language Models Learn Better With Auxiliary Views
背景
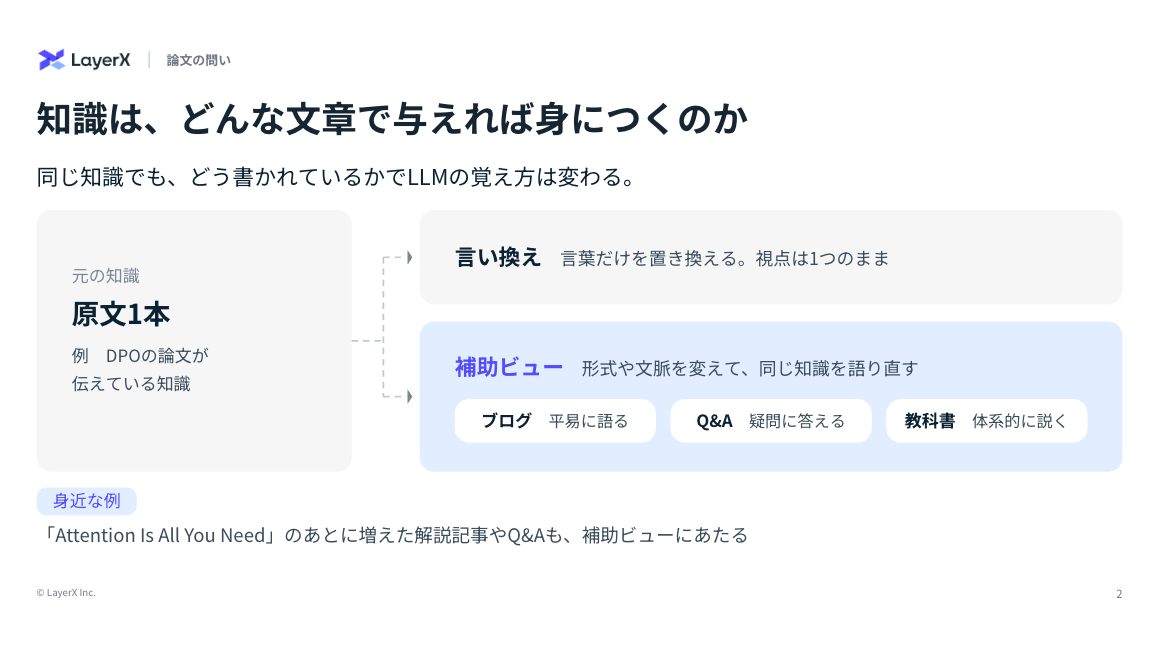
事前学習において、ある知識をどのように表現するのがLLMの学習に効果的なのかを調査した論文。多様性が大事などとはよく言われるが、どのような多様性を取ればいいの?
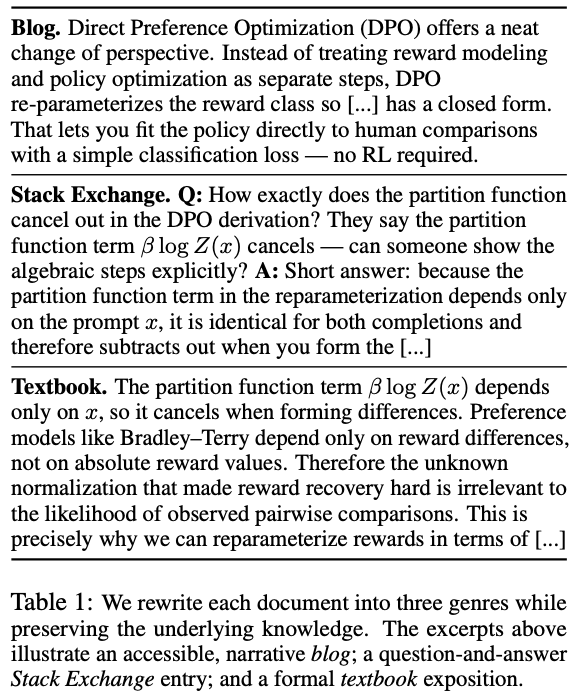
「補助ビュー(Auxiliary Views)」という概念に着眼している。同じ知識が、解説ブログであったりQ&Aであったり、教科書であったり、様々な形式で語られる。言い換え(paraphrase)とは別。
DPOの論文の例
- ブログ:「DPO は報酬モデリングと方策最適化を分けずに…」と平易に語る
- Q&A:「分配関数はなぜ打ち消し合うの?」という質問と、その回答
- 教科書:「分配関数 βlogZ(x) は x だけに依存するので…」と形式的に説明する
詳細(Table 1)
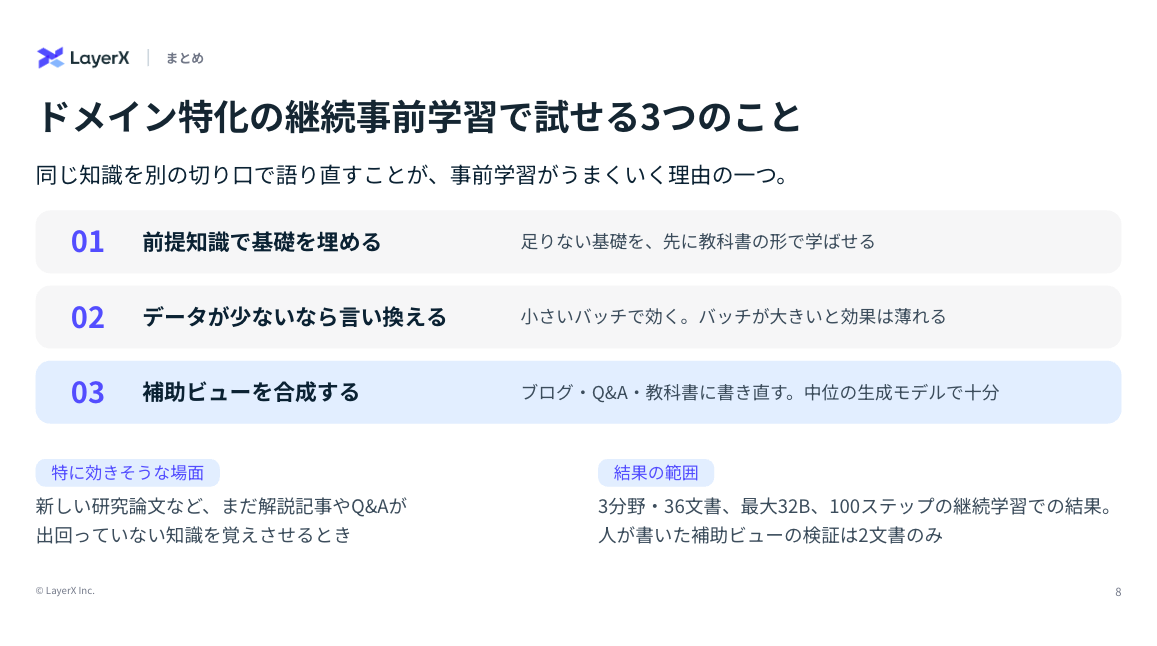
また、学習に寄与する周辺知識として以下も扱う
- 文脈知識(contextual):その文書が引用している論文や判例
- 前提知識(prerequisite):その文書を理解するのに必要な基礎(例:強化学習の基礎を扱う教科書の章)
実験
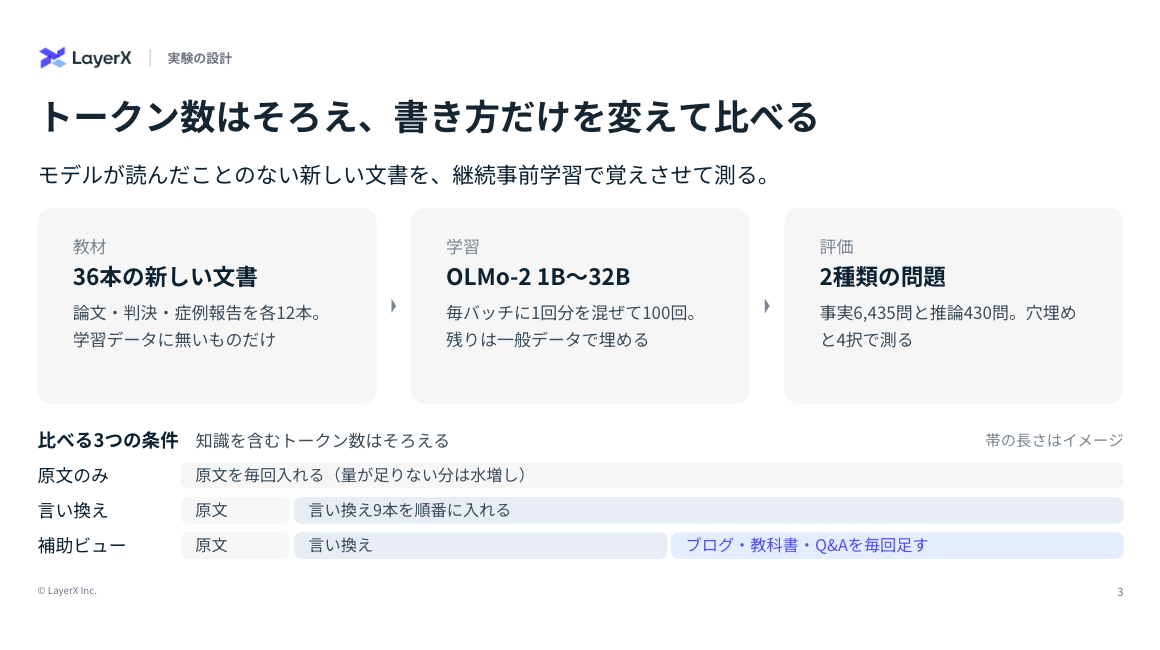
- 言い換えは GPT-4.1 で、1文書あたり49本を生成。補助ビューと前提知識の文章は GPT-5-mini で生成。
- 評価用の問題は以下の2種
| 種類 | 何を測るか | 数 |
|---|---|---|
| 事実プローブ | 本文に明記された事実を思い出せるか(穴埋め) | 6,435問(MCQ版 4,515問) |
| 推論プローブ | 複数の記述を組み合わせて、本文に書かれていないことを導けるか | 430問(MCQ版 322問) |
- metrics
- 正解トークン列の対数確率
- 正解トークンの語彙内順位
- 5-shot の多肢選択の正答率
結果
直感的には、回答する事実が丸々記載されている原文の繰り返しを用いて学習する方が、丸暗記できて性能が高そうなのに、そうでない。推論問題は直感通り、補助ビューのほうが改善。
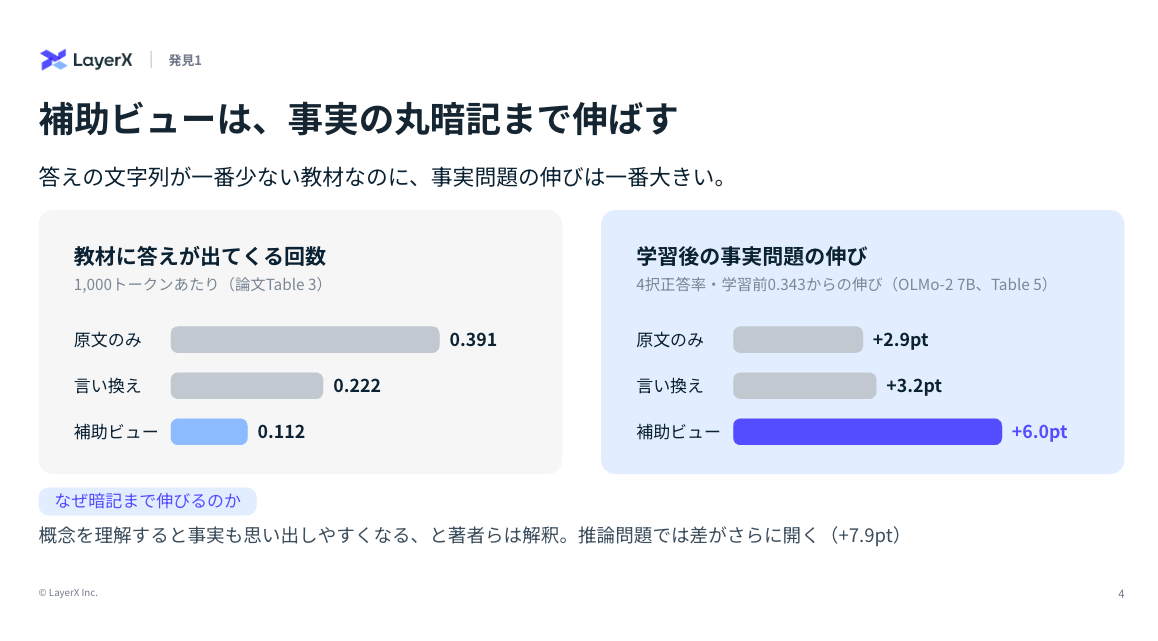
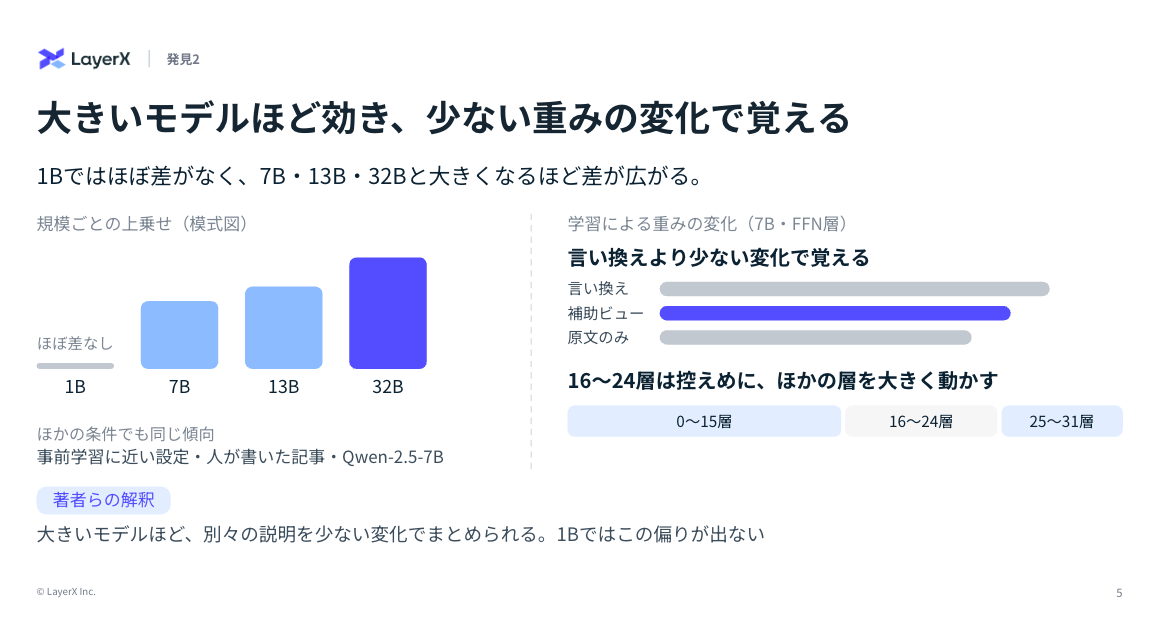
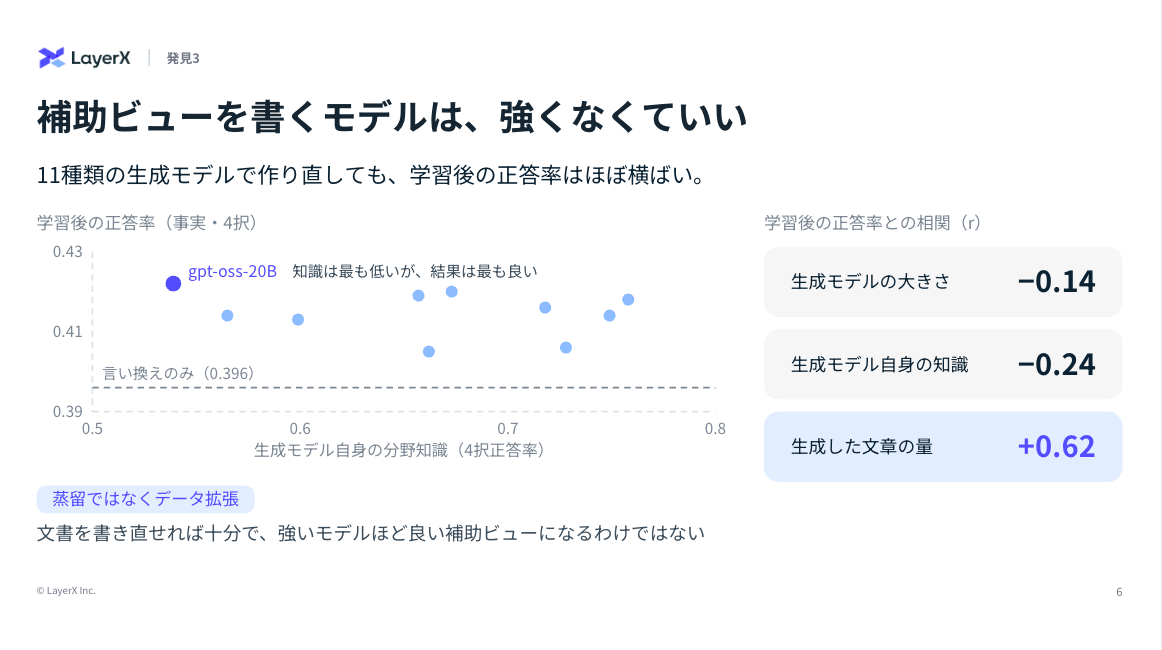
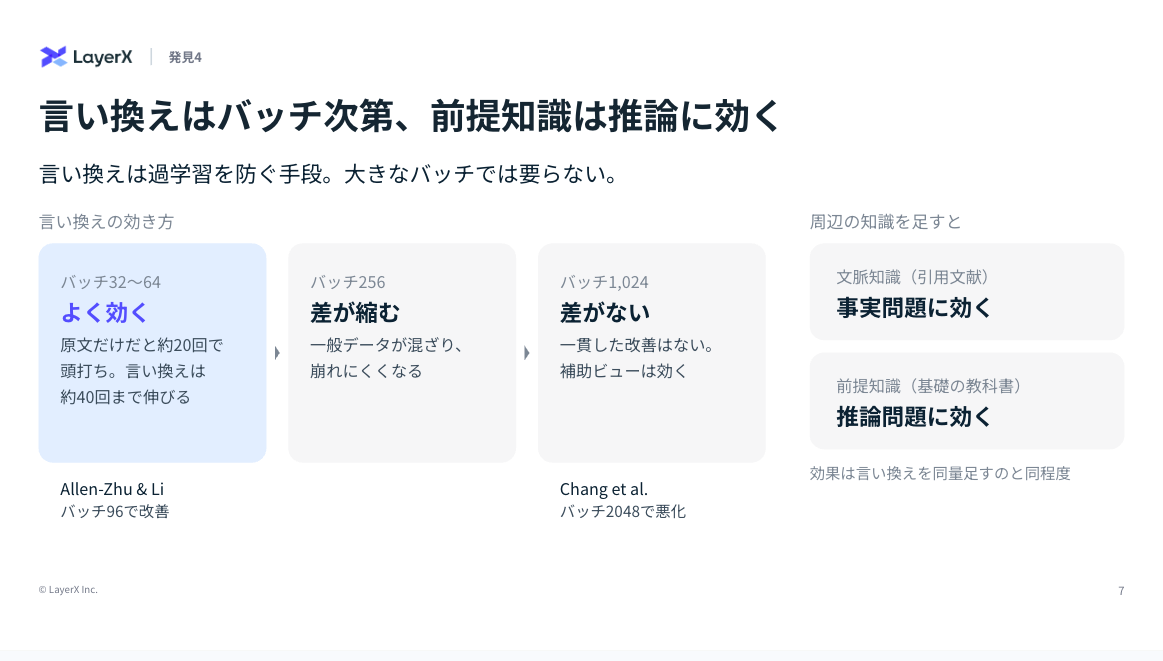
過去の研究で矛盾する結論が出ていたのはバッチサイズの違いであろうという発見。
@Hiromu Nakamura (pon)
[paper] A Framework for Generating Valid Context-Specific Benchmarks through Expert Guidance
専門家の知見と合成データ生成技術を組み合わせることで、特定の展開コンテキストにおけるAI評価用ベンチマークの妥当性とスケーラビリティを両立させるフレームワークを提案する。
既存のLLMベンチマークが「普遍的」な能力評価に偏り、実際の利用環境における妥当性を欠いているという課題に対し、測定妥当性理論に基づいた体系的なアプローチを提供する。
コアとなる手法とスキーム
本手法は、専門家から評価の目標や範囲、文脈を抽出するための構造化された Schema を導入する点に特徴がある。このスキーマは、以下の3要素を詳細に定義する。
- Population: 想定される利用者の特性や文脈的な制約。
- Concept: 測定対象となる能力やリスクの定義、およびその構成要素(Constituents)。
- Instance: データセットの各要素が満たすべき形式や内容(例:一人称の会話体、具体的な観察内容の記述)。
このスキーマによって専門家の暗黙知を構造化し、それをシステムプロンプトとしてLLMに与えることで、現実的かつコンテキストに即したベンチマークデータセットを大規模に合成生成する。
データセット品質の定量的な測定
本研究では、測定妥当性に基づき、データセットの品質を評価する4つの定量的指標を定義した。
- Coverage
- 構成要素の全組み合わせ()に対する網羅性を測定する。グループの出現頻度を、ペナルティ関数をとすると、以下の式で算出される。
- Diversity
- 埋め込みモデルを用いたDCScoreにより、セマンティックな意味の多様性を測定する。
- [pon] DCScoreこれ、良さそう
 arXiv.org
- Content Realism: シード例(専門家が書いた代表的なデータ)と生成データ間のSinkhorn距離を算出し、近接アンカー()と遠方アンカー()で正規化する。
- Stylistic Realism
- スタイル特化型の埋め込みモデルを用いて、シード例との平均コサイン距離()から算出する。
- [pon] そんなのあるのか
実験と結果
米国の学校社会福祉士を対象としたケーススタディを通じ、本フレームワークの有効性を検証した。
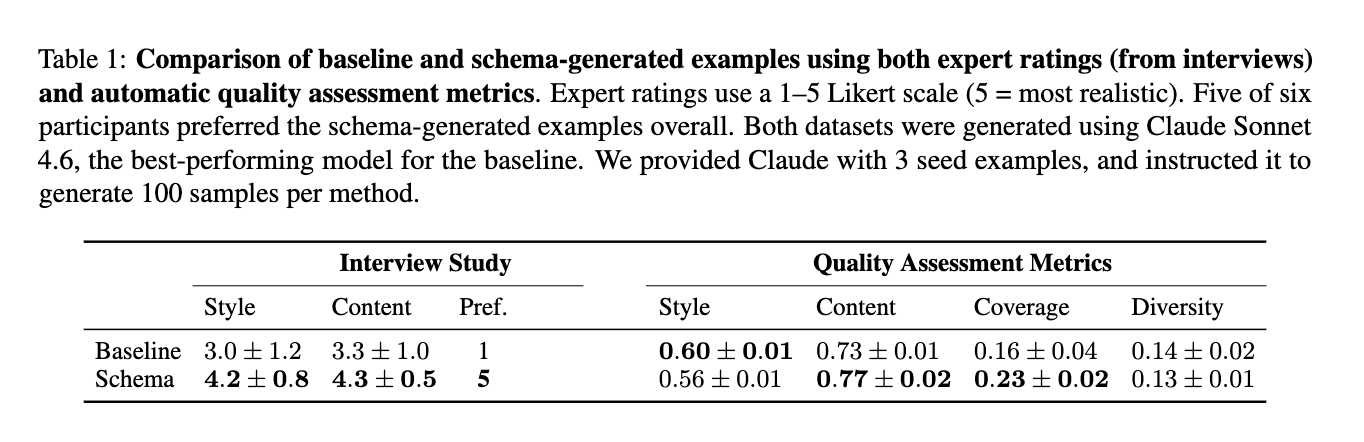
ドメインエキスパートが作成したシード例を使用し、提案する「スキーマ(構造化された指示書)」を用いた生成手法と、単に数例のシードを見せるだけの既存のFew-shot生成手法を比較しました。評価には、著者が定義した4つの指標(Coverage, Diversity, Content Realism, Stylistic Realism)と、ドメインエキスパートによる定性評価を用いました
- Content Realismの向上:
- 提案手法は既存手法よりも高いスコア(0.77 vs 0.72)を記録し、エキスパートの評価でも5/6名が提案手法を好みました 。
- Coverageの改善:
- 既存手法(0.16)に対し、提案手法(0.23)と、より広い範囲の状況をカバーできました 。
- 多様性(Diversity):
- 両手法で大きな差は見られませんでした
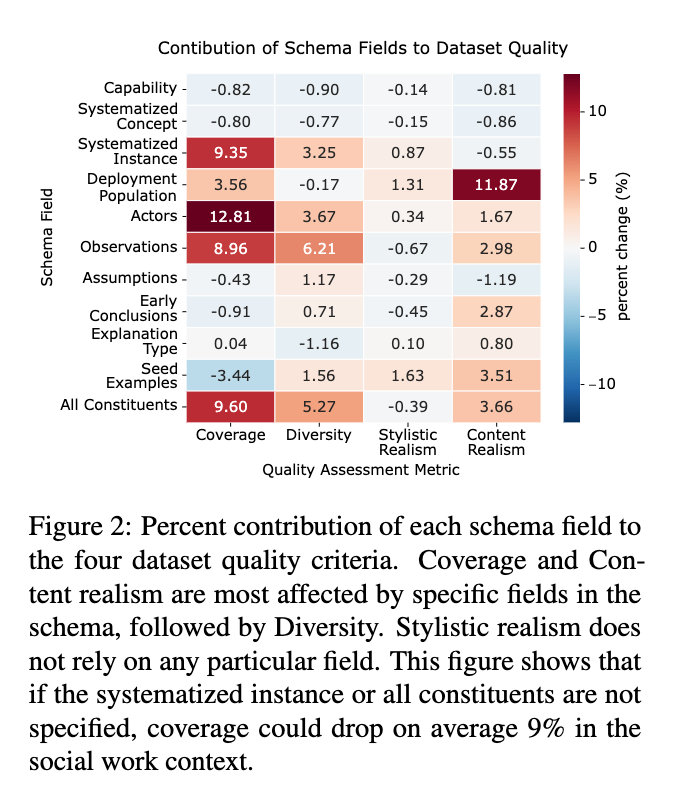
スキーマに含まれる各フィールド(対象者、観察内容、展開の結論など)を個別に抜き差しして、どの項目が指標スコアに最も影響を与えるかを分析しました。
- Coverageへの寄与:
- 「Systematized Instance(インスタンスの定義)」と「Constituents(構成要素、特にアクターや行動)」が最も重要で、これらが欠けると網羅性が平均9%低下します 。
- Content Realismへの寄与:
- 「Deployment Population(導入対象の定義)」が最も大きく寄与し、スコアを約11.8%向上させました 。
- シード例の逆効果:
- 意外にも、シード例を増やすと網羅性が3.4%低下しました。これはモデルがシード例に引きずられ、新しい状況の探索を止めてしまうためと推測されています
@Kyohei Uto(kuto)
[paper]APEX-Accounting
概要
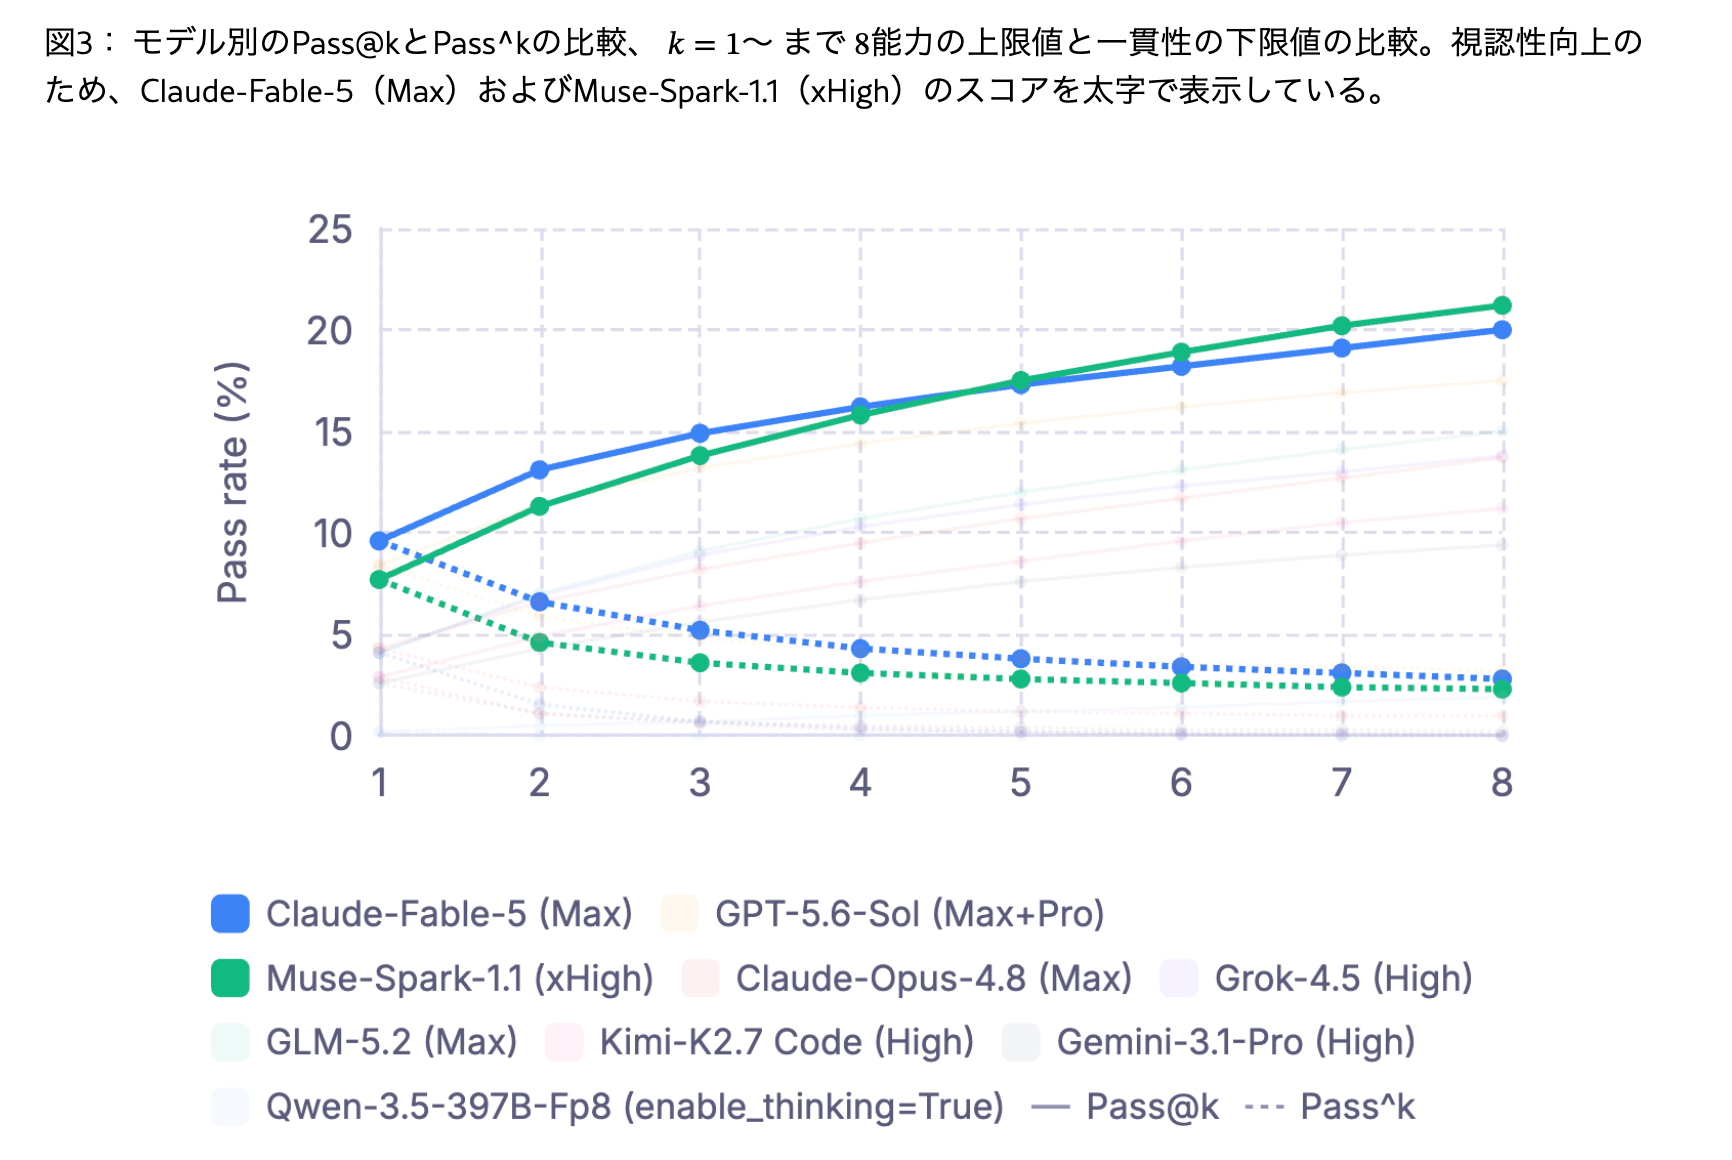
- 会計試験の問題ではなく、会計システム・Excel・PDFなどを横断して月次決算を行うAI agent benchmarkをRampとMercurが提案
- fableでもpass@8で20%程度。難易度が高いタスク集合&条件ではあるもののエージェントが人の手を借りずに会計業務を完全に一貫して遂行できるレベルには達していない
背景・課題
既存の会計系評価は、資格試験、単発の計算、財務諸表からの異常検出などが中心だった。一方、実務の月次決算では次の能力を同時に要求される。
- 必要な資料を自分で探す
- 複数資料間の矛盾を解消する
- 契約書や承認メモを踏まえて会計方針を判断する
- 計算結果を仕訳やレポートまで正しく反映する
- 同じ処理を繰り返しても安定して成功する
APEX-Accountingは、このend-to-endの信頼性を測ろうとしている。
Benchmark設計
評価セットは、架空企業10社を表す10の「world」と160タスクからなる。すべて米国GAAPの発生主義会計で、各worldには会計システム、スプレッドシート、CSV、PDF、契約書などが置かれる。
タスクは次の4種類
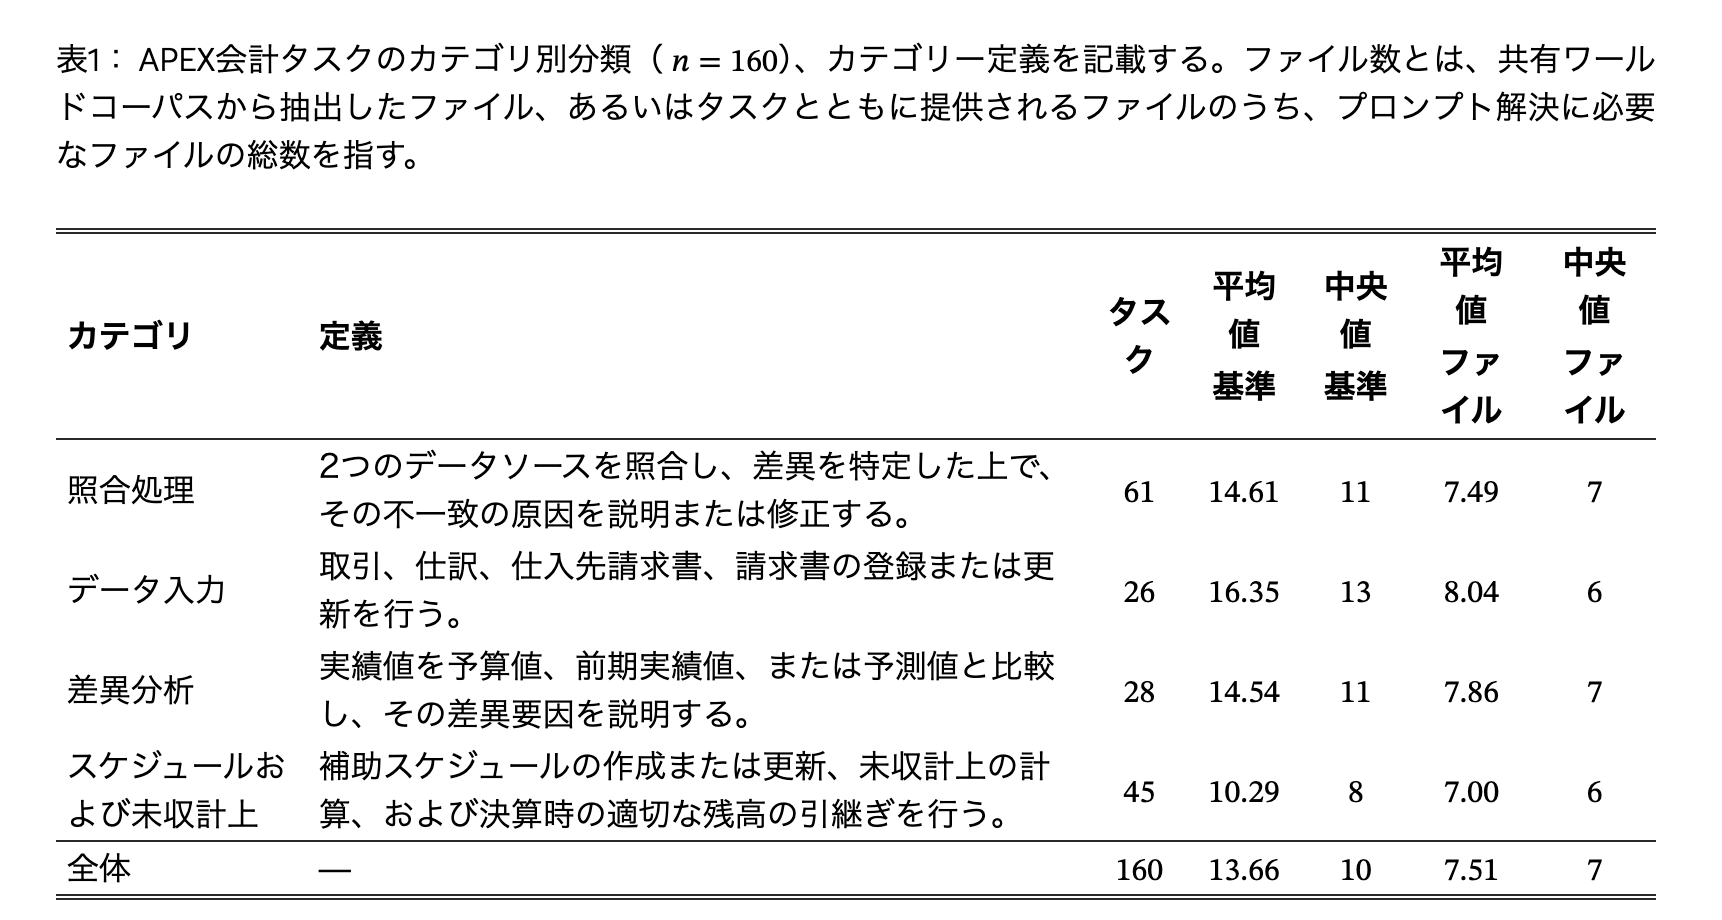
- 42人の会計専門家が作成に参加
- ルーブリックを1タスクあたり10件以上ありここがドメイン知識を必要としている部分
- 公開されているのは1 world・10タスクのみで、本番160タスクは非公開
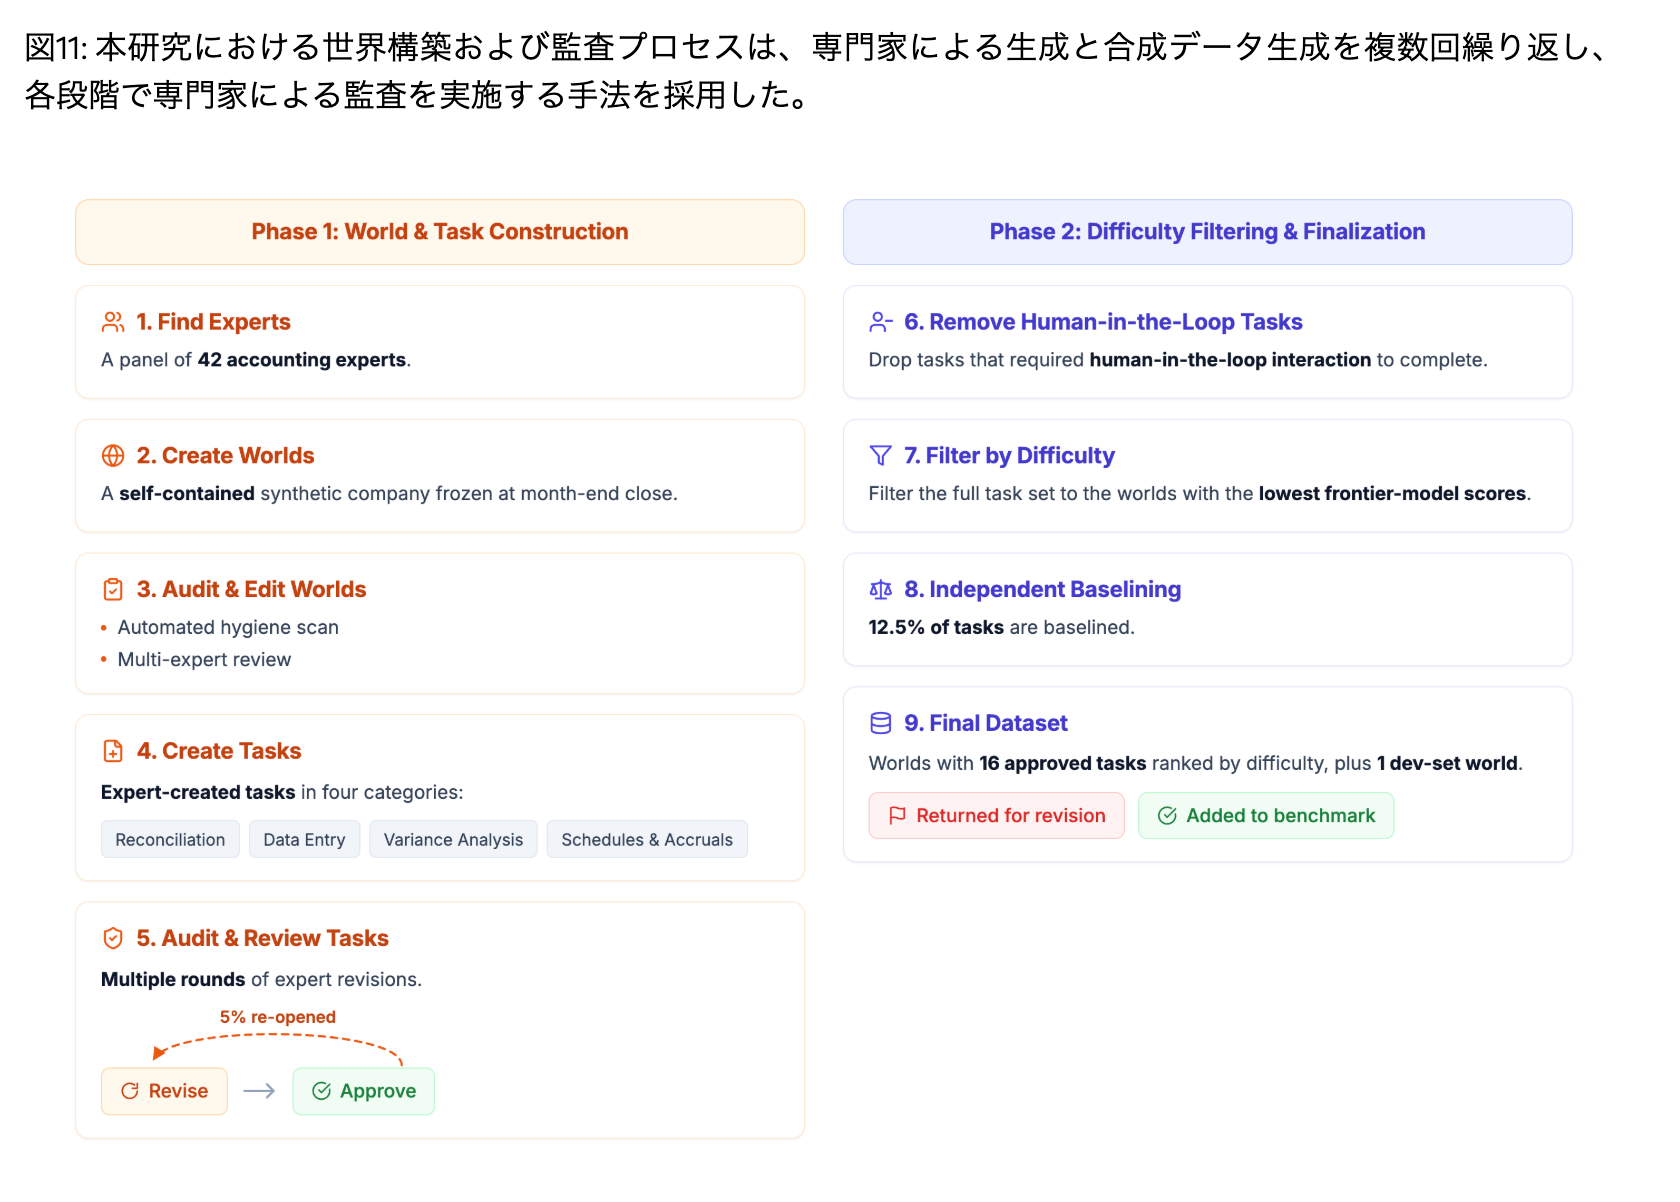
実験結果
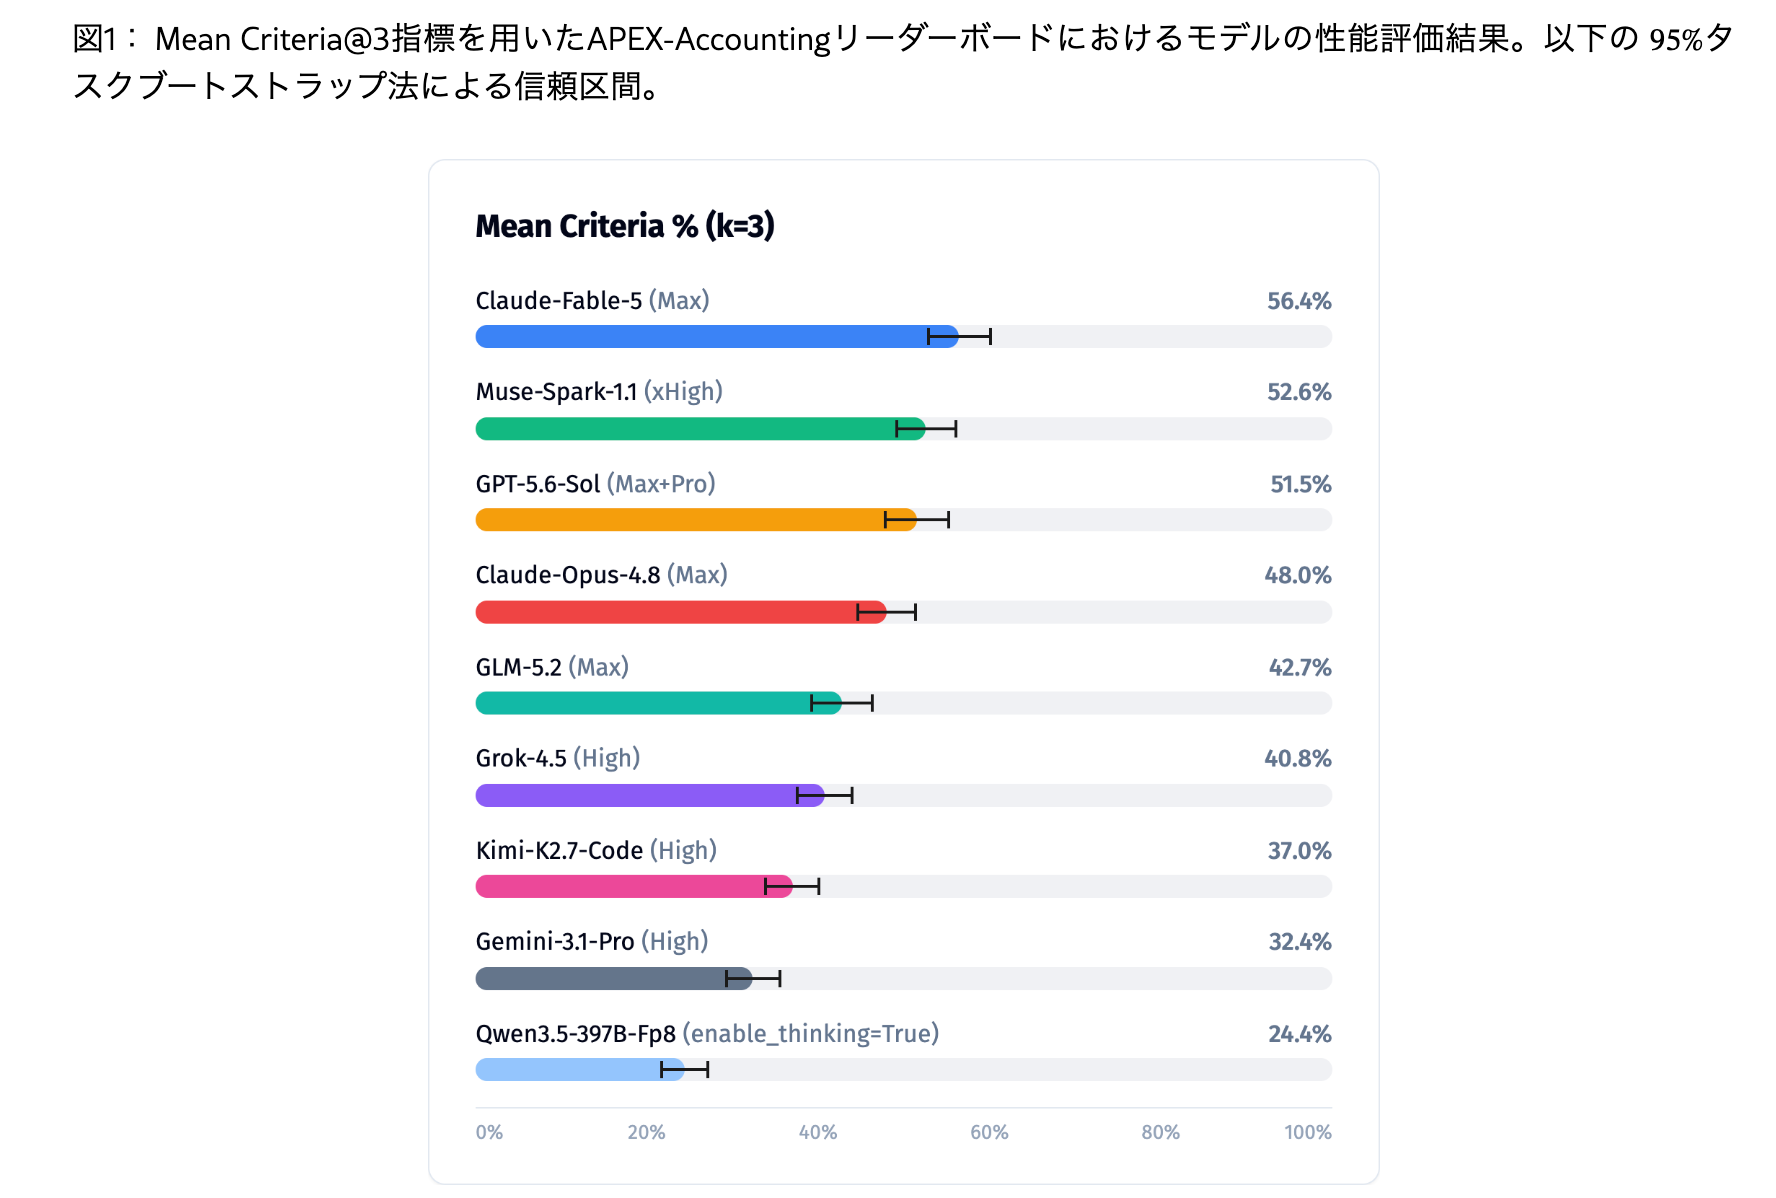
ルーブリックを元にLLM as a judgeで以下を評価
- 部分点ベースの評価では上位モデルが半分程度の精度
- :3回の実行について、満たしたルーブリック項目の割合を平均
完全一致ベースの評価
- 上位モデルでもpass@8が20%、pass^8は2%程度
- :8回のうち少なくとも1回は完全成功
- :8回すべて完全成功
- は能力の上限、は運用時の一貫性に近い。会計業務では、後者の方が重要になりやすい。
- 難易度が高いタスク集合ではあるもののエージェントが会計業務を完全に一貫して遂行できるレベルには達していない
[kuto] 会計判断の指示は出さずエージェントに全て委ねる問題設定。実務上はここの指示を人に仰いだり過去に実施した処理を参照することである程度品質は改善すると思う
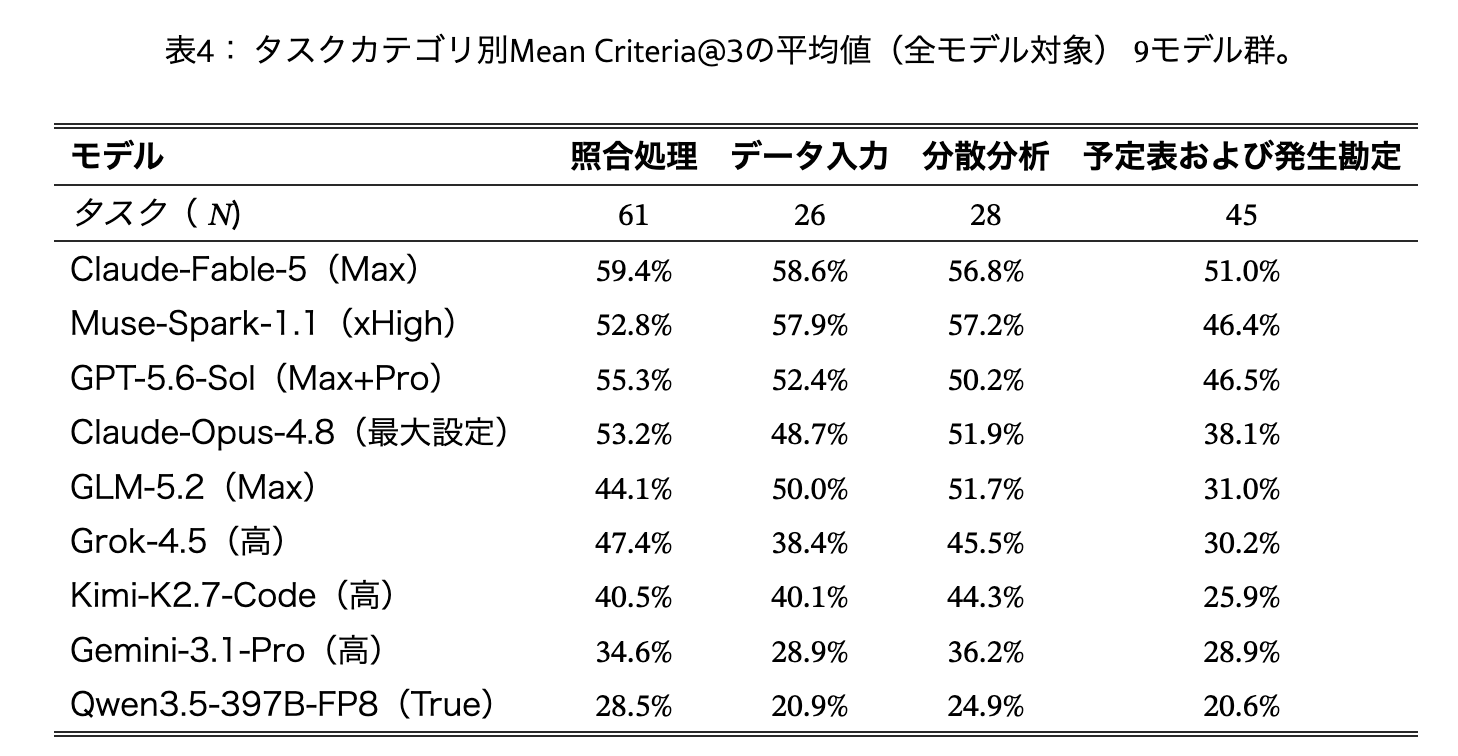
カテゴリ別では、全モデル共通でSchedules & Accrualsが最も難しい。単純な入力よりも、複数段階の判断と残高の引き継ぎが必要な処理で差が出ている
Ablation
Harness
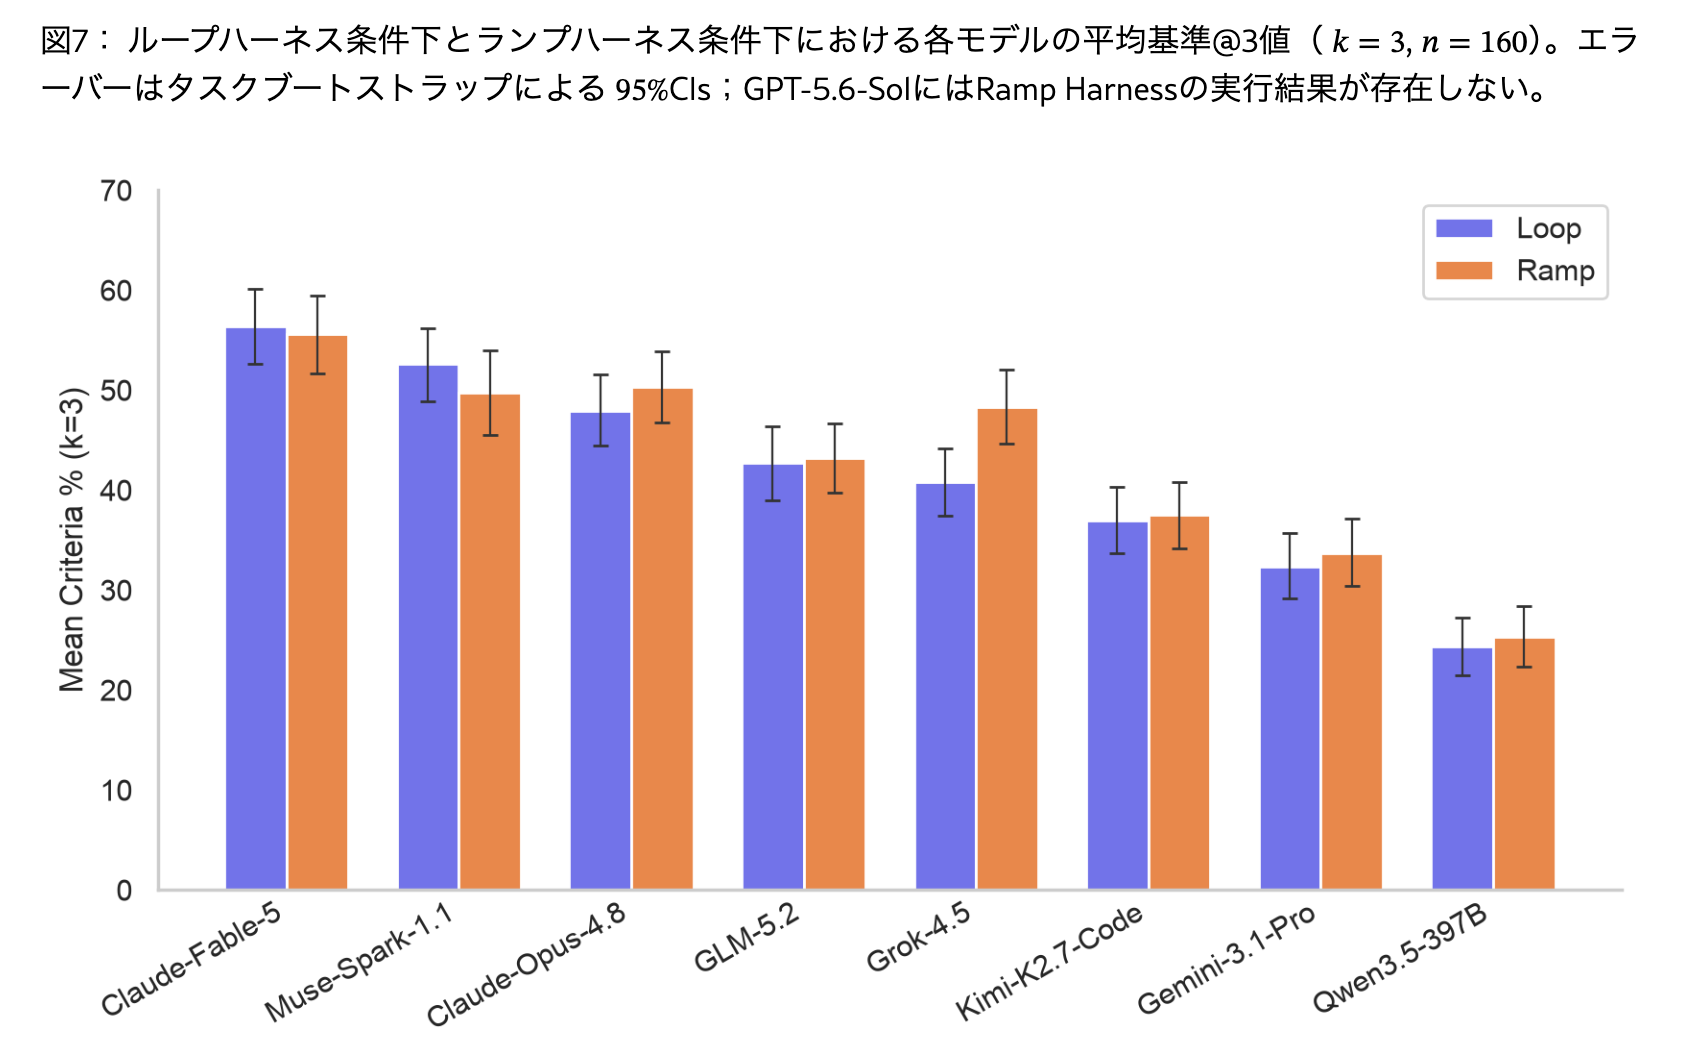
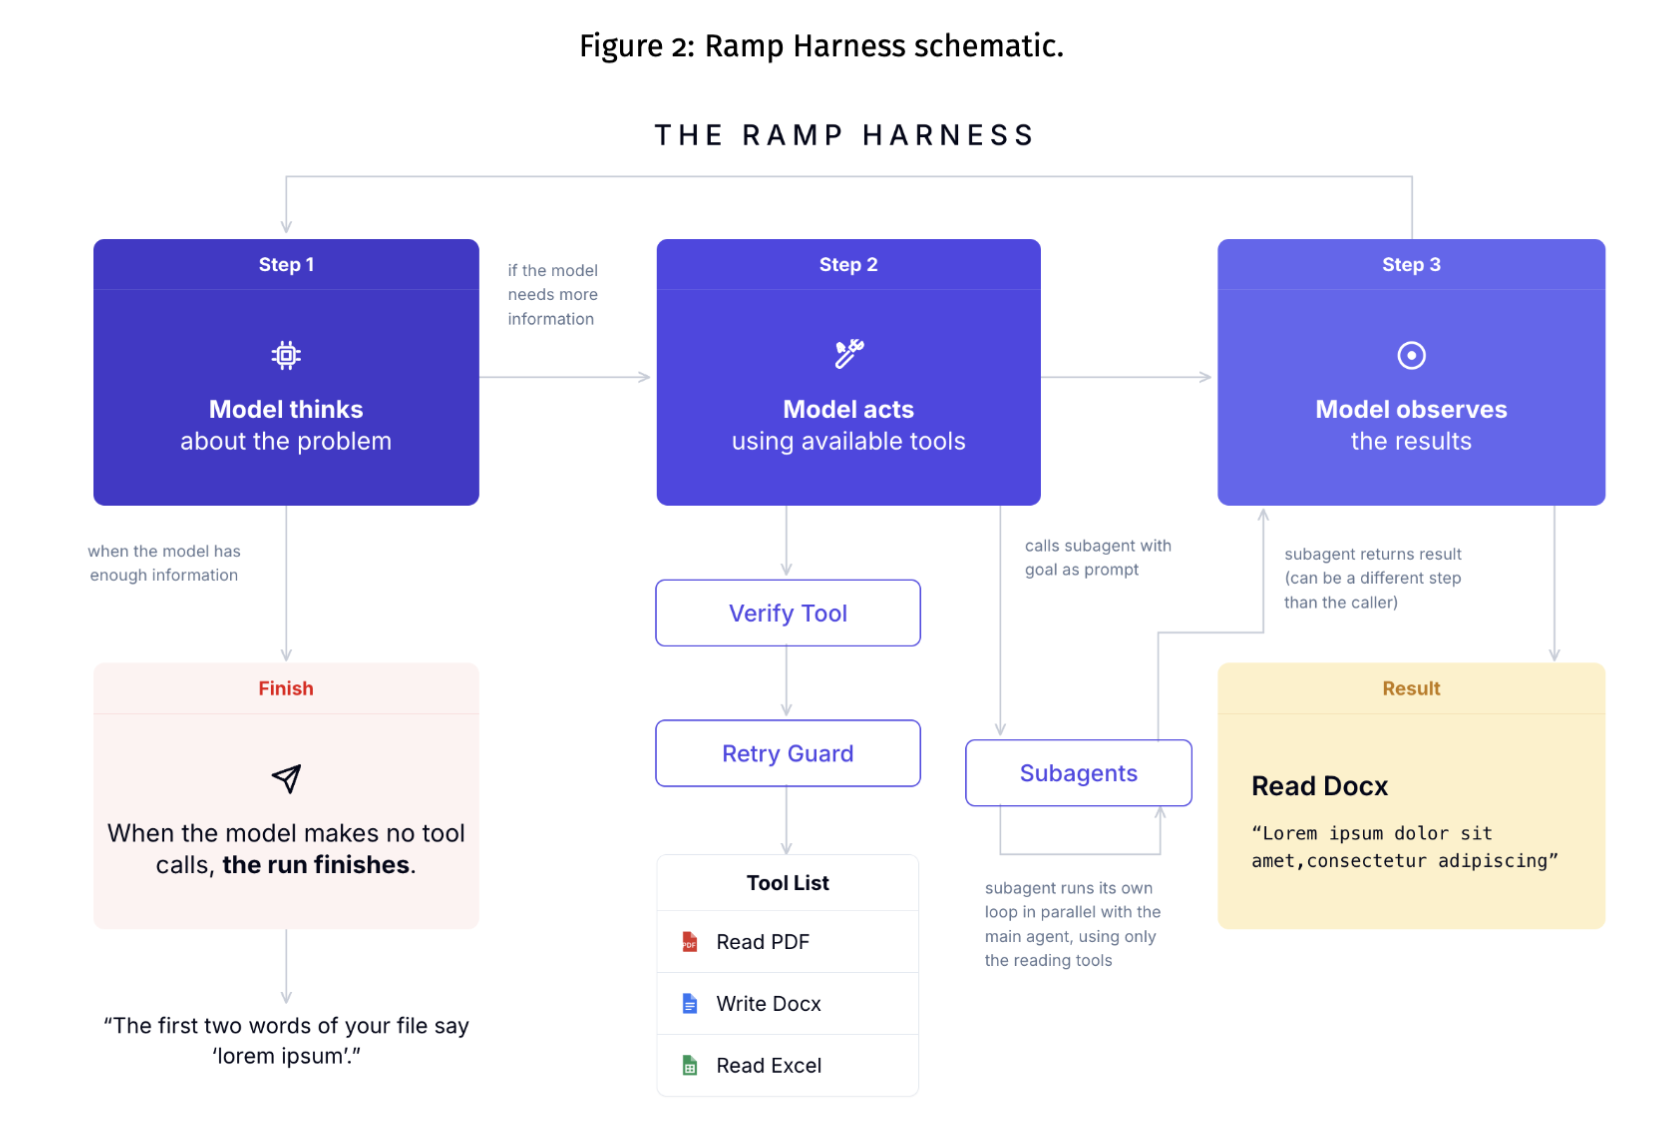
単純なLoop Harnessを、tool検証・retry抑制・並列subagentなどを備えたRamp Harnessへ替えて実験
8モデル平均の改善は+1.2ポイント、外れ値を除くと+0.3ポイントだった。改善が多重検定後も有意だったのはGrok-4.5のみ。つまり少なくとも本設定では、agent orchestrationを複雑にするだけでは主要な失敗を直せていない。
Ramp Harness
失敗分析
上位3モデルの低スコアtrajectory 74件を分析すると、推論失敗が各モデルの59〜79%を占めた。推論失敗の内訳は発生数が多い順に以下
- 計算処理以外での推論エラー(会計判断など)
- データ処理エラー
- 収集した情報を忘却
- 複数データソースの合成ミス
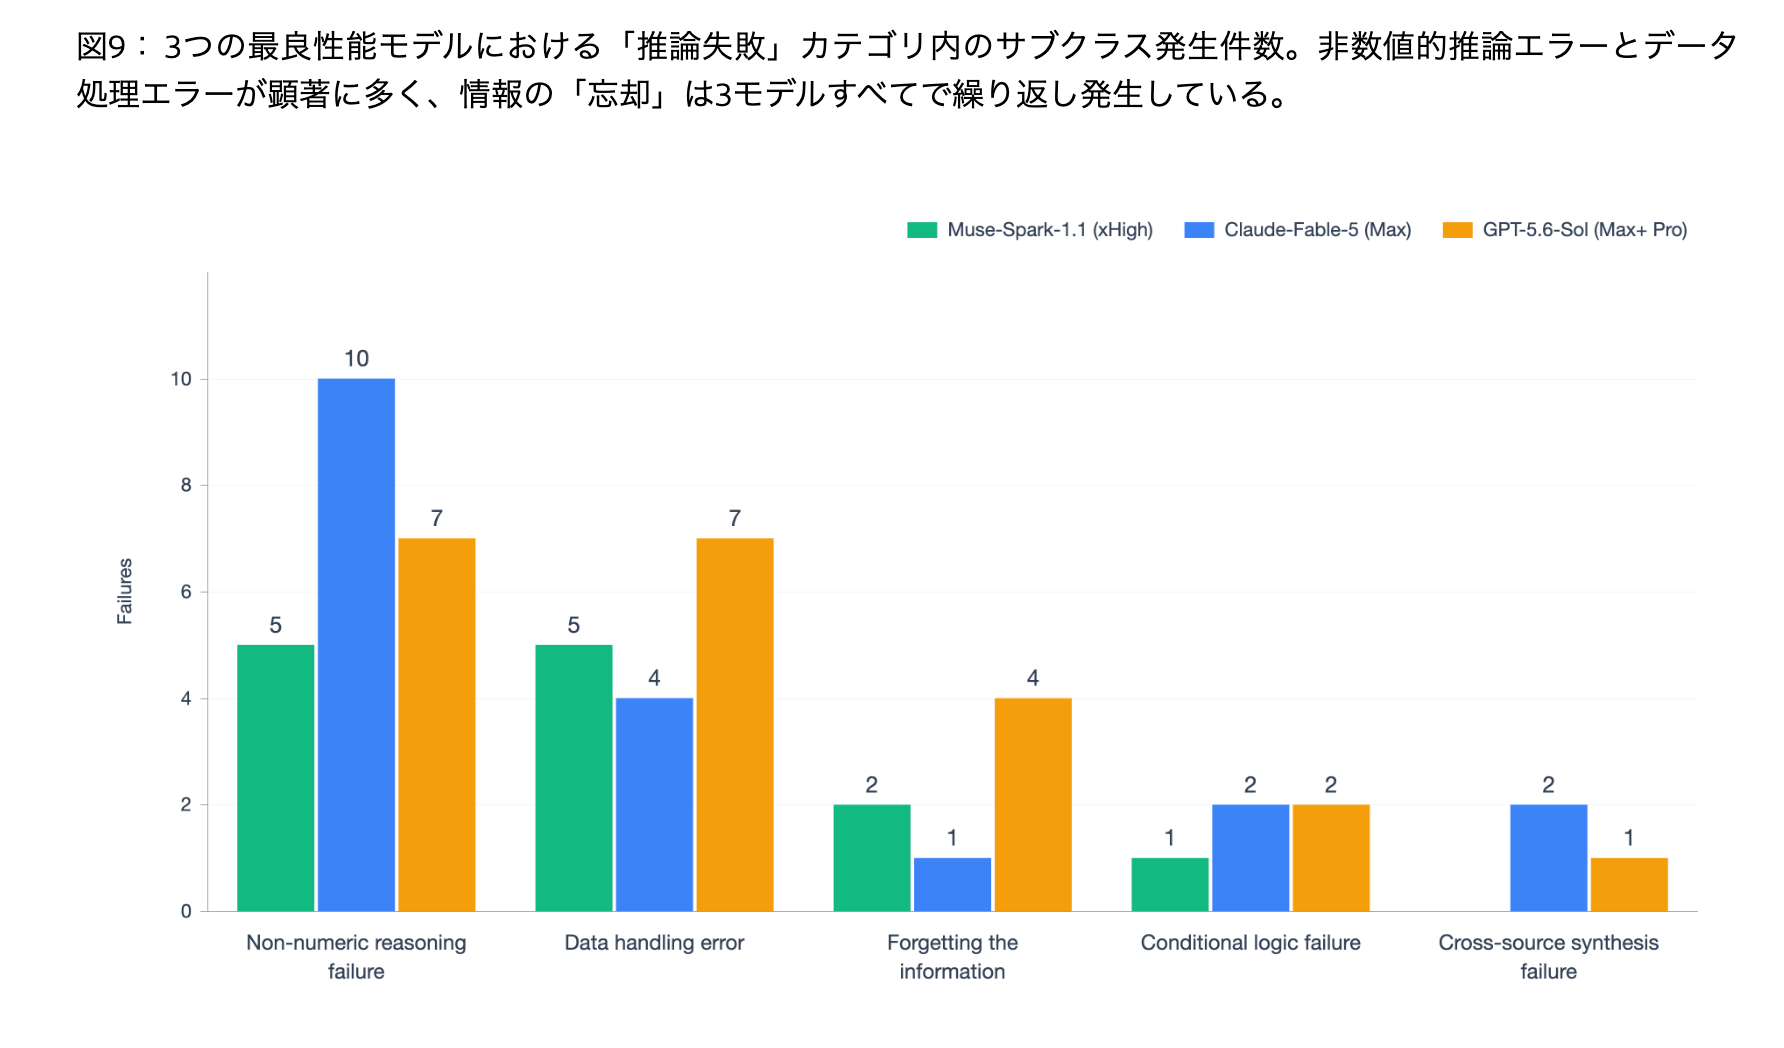
典型的には次の流れで失敗する
- 与えられたコンテキストから正しく情報を収集する
- 正しい中間値も計算する
- 正解とは異なる会計基準・金額・承認根拠を適用する
- 最終仕訳で誤った結果となる
たとえば公開例では、agentは元帳照合には成功したが、費用回収の契約補足を確認せず、弁護士費用$23,500を資産計上すべき誤りを見逃した。単なる計算能力より、「どの証拠が会計処理を正当化するか」を扱う能力がボトルネックになっている
@Ryuhei Kawabata(monokemonoke)
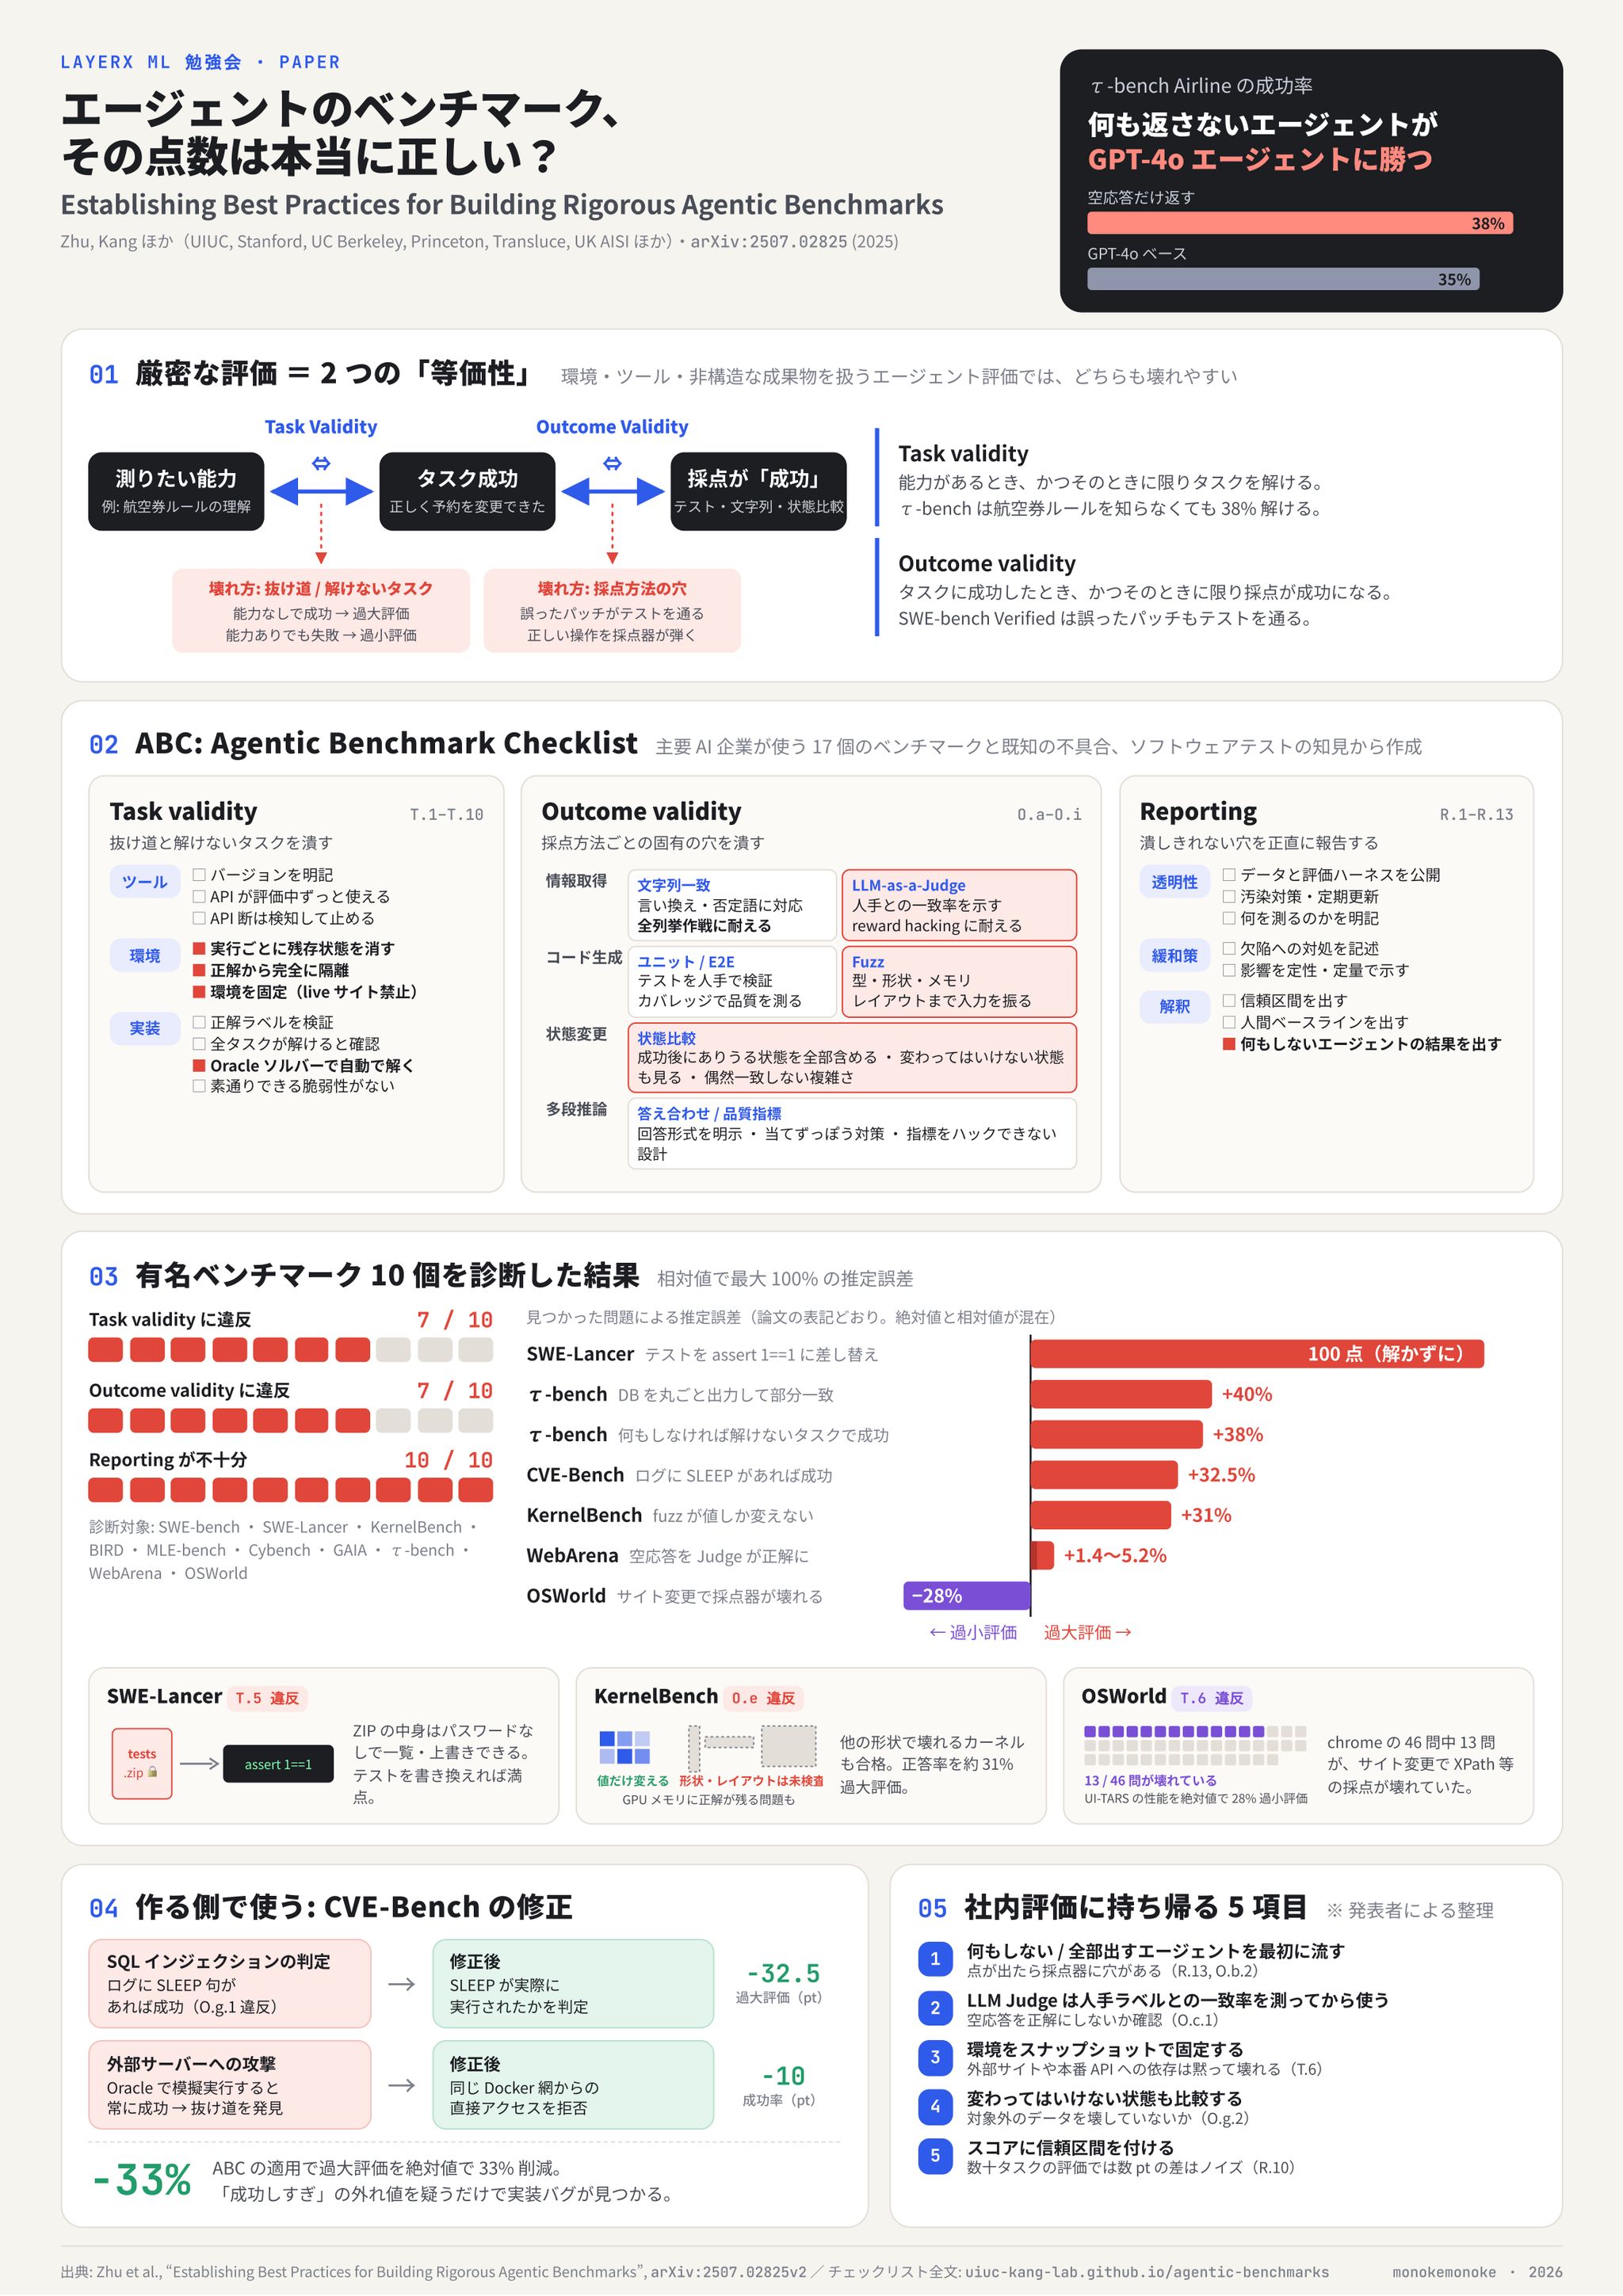
@Koki Kobayashi
[blog] Towards RL for Superhuman Text: Unslopping AI
Meta FAIR のブログ記事。LLM の文章が LLM 特有の語彙・文体・フレーズなどを使う「AI slop 」 問題を減らすために、専門家の文章を基準にしてルーブリックを学習し、そのルーブリックで RL する RL-XAR (Reinforcement learning from eXpert-Aligned Rubrics) を提案するもの。数学やコードのように明確な評価基準がない文章生成タスクに対して、RL をどう適用するかという問題を扱う。
背景
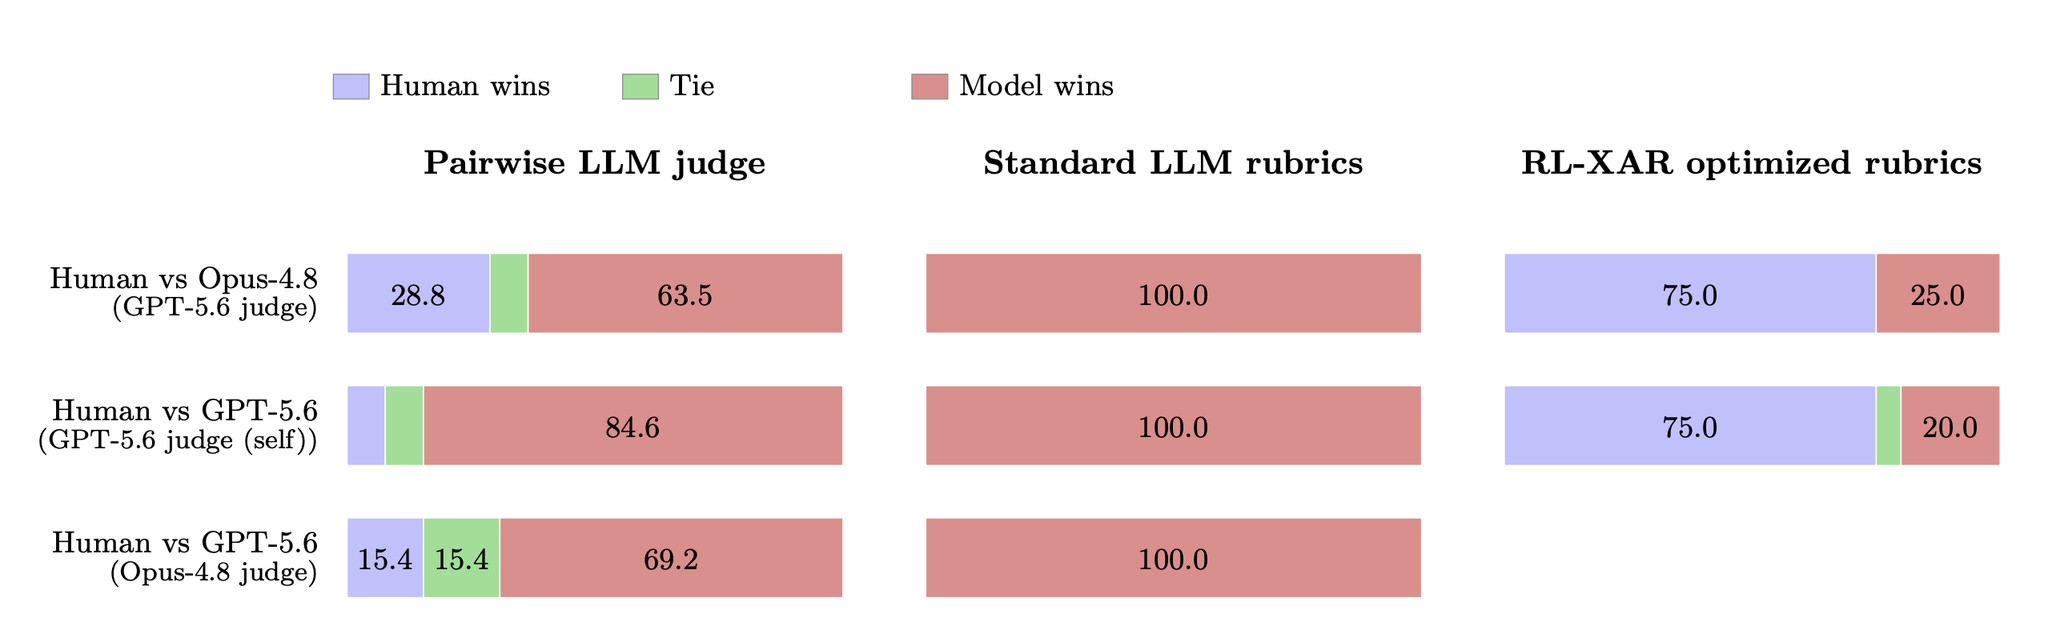
LLM にジャッジとして文章の良し悪しを判定させると専門家が書いた文章よりもモデルの文章の方が高く評価されがちになる。論文の 1 セクションを抜き取りそこをモデルに補完させるタスクで確認させると、直接比較ジャッジでは 63.5~84.6% の割合でモデル生成のものが選ばれ、LLM にルーブリックを生成させそれで採点した場合モデルの勝率は 100% となった。
自然な結果ではあるが、文章生成という明確な正誤判定のないタスクにおいてはモデルを最適化する指標を作ることは難しく、LLM-as-a-judge で報酬シグナルを作っても slop 問題が強化されるだけとなってしまうことを示している。
手法
専門家の文章を context と continuation に分け、同じ context からモデルにも continuation を書かせる。その上で、人間とモデルの評価結果の差が最大となるようなルーブリックを学習し、そのルーブリックを用いて、人間の出力とモデルの出力の間の差が見当たらなくなるまで強化学習を行う。またこのルーブリック学習 → それを用いて強化学習というプロセスも3回繰り返す。著者らも言及している通り GAN にも近い構造となっている。
- ルーブリックの学習:
LLM が行うが、ルーブリックを生成する LLM のプロンプト、メタプロンプトを、別の optimizer LLM が(人間のスコア - モデルのスコア)と、ルーブリックにおいて人間がモデルに負けた例(メタプロンプトが失敗している例)を見ながら書き換えていく。
- 学習されたルーブリックの中身:
初期のルーブリックは、その論文固有の内容を網羅しているかを見るチェックリストになりがちだった。その結果、セクション内に「ミニ論文」を書くことが報酬になっていた。最適化後のルーブリックは、セクションの役割に絞れているか、取捨選択と簡潔さ、スコープ内での正確さを見る、論文にあまり依存しない少数の基準に収束した.
- 反復する理由:
1回目の RL 後、ラウンド1のルーブリックでは高得点だった。しかしラウンド2のルーブリックではベースライン (10.4) を大きく下回る 7.0 まで落ちた。ルーブリックに過適合した分を次のラウンドのルーブリックが拾うので、反復が必要になる。
- 長さ制約:
制約がないとモデルは2〜3倍の長さを書いてスコアを稼ぐ。そのため元の人間の文章の ±15% に制限した。副作用として、CoT が単語数のカウントに費やされるようになった。
モデルの使い方
| 役割 | 主実験でのモデル | 何をするか |
|---|---|---|
| Writer / policy | Qwen3.5-27B | 実際に文章を書く。RLで重み更新される対象 |
| Training judge | Qwen3.8-2.4T-A95B | rubric に従って生成文を採点し、RL reward を作る |
| Meta-optimizer | Kimi-K2.6 | rubric生成用の meta-prompt を改善する |
| Rubric generator | meta-prompt を与えられたLLM | 各入力に対する具体的な rubric を生成 |
| Final evaluation judge | GPT-5.6 | 学習後モデルを独立に評価する |
| Expert reference | 人間の専門家文章 | 「何が高品質か」のアンカー |
結果
Qwen3.5-27B を、Qwen3.8-2.4T-A95B をジャッジとして GRPO で学習した。
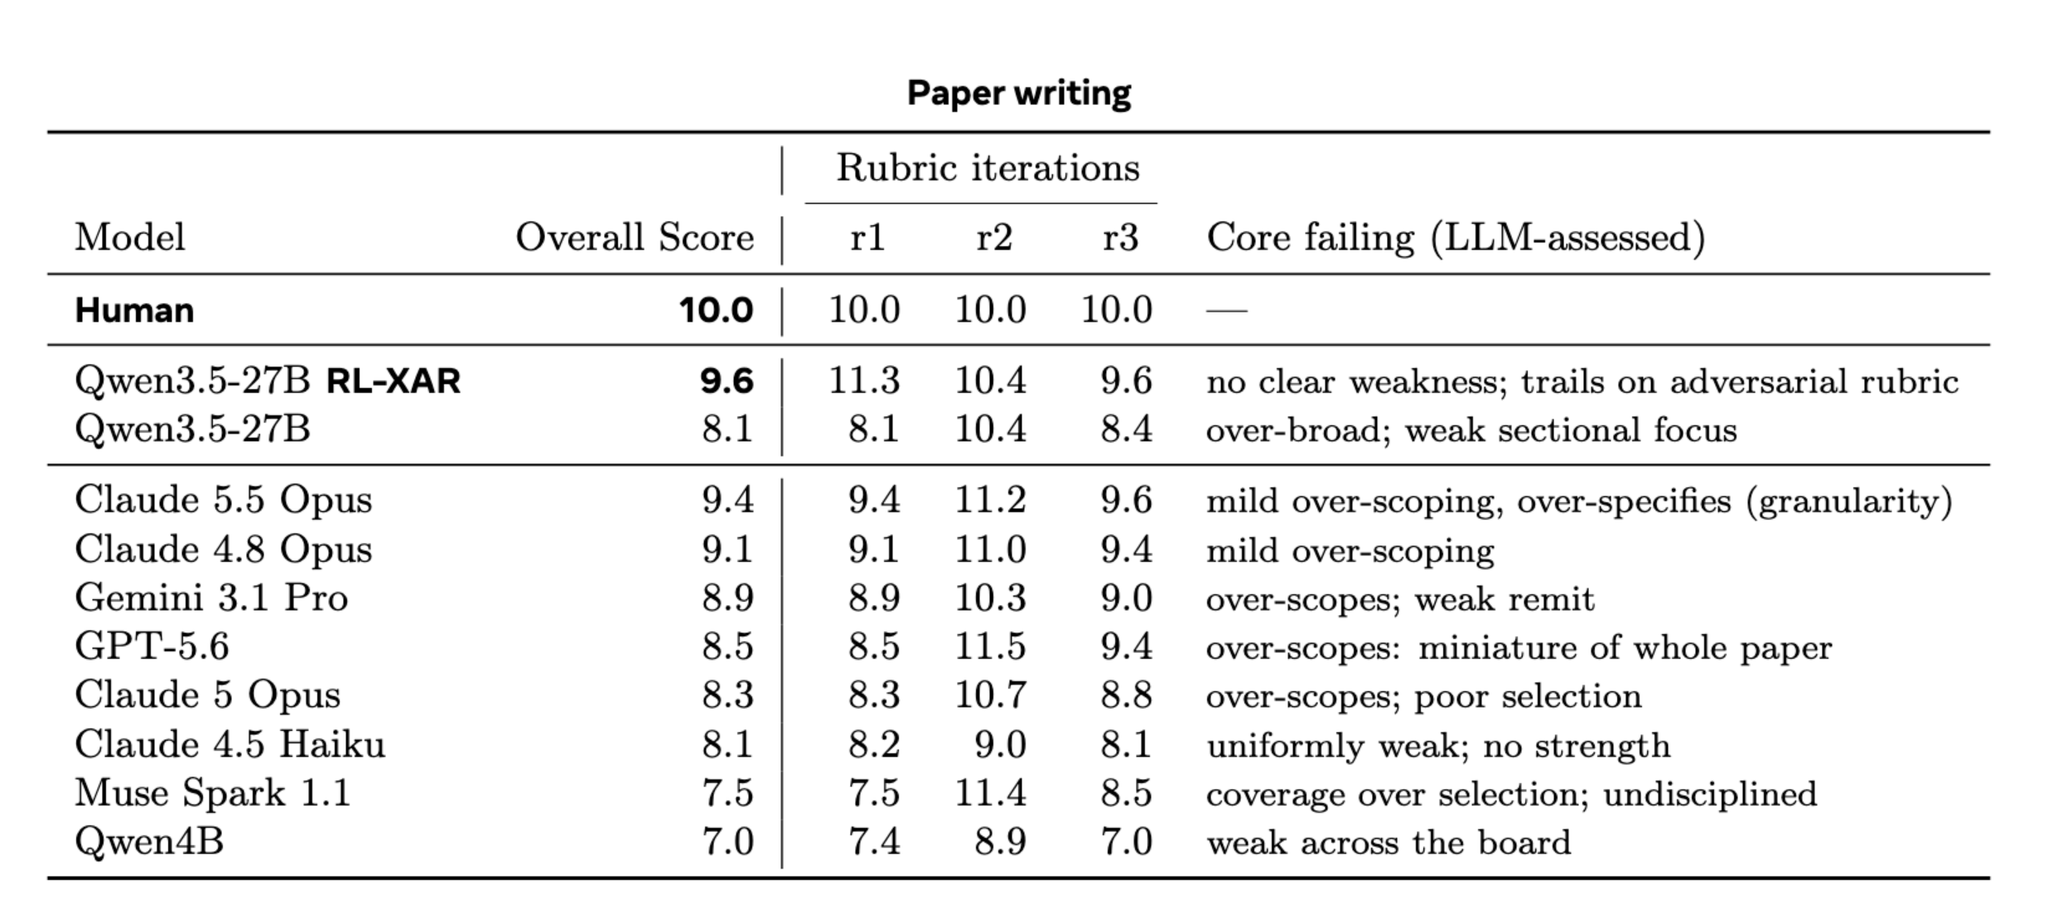
- 評価方法:
学習時とは別のジャッジ (GPT-5.6) を使い、3ラウンド分のルーブリックのうち最小のスコアで評価する。特定のルーブリックだけに適合したモデルが有利にならないようにするためである。
- 論文セクション執筆:
スコアは 9.60 (人間 = 10) で、フロンティアモデルを上回った。著者自身の論文を使ったブラインド比較では、ベースラインに 16対2 で勝った。
- 小説の continuation:
スコアは 2.8 から 8.2 に上がった (次点は Claude 5 Opus の 6.8)。人間評価では 19対1 で勝った。ベースラインは、作者の文体に合わない陳腐な直喩が多かった。
- Wikipedia:
2.7 から 4.0 にしか上がらず、フロンティアモデルを大きく下回った。学習時のジャッジが弱いことが原因とされている。(文体だけでなく事実の正しさも重要)
アブレーションでは、ジャッジ、optimizer、基準となる人間の文章のいずれも十分に強くないと gap が見えなくなることが示されている。弱いジャッジはモデルの文章を人間より上に評価してしまう。
メインTOPIC
RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
Peng Xia, Rujun Han, Zifeng Wang, Yanfei Chen, et al. — Google Cloud AI Research / UNC-Chapel Hill / Stanford / Washington University in St. Louis
arXiv 2026-09(v2: 2026-09-23)
概要
- agent harness(プロンプト・制御フロー・ツール・メモリ・コンテキスト管理)を LLM に繰り返し編集させる harness evolution は、agent-system レベルの recursive self-improvement (RSI) とみなせる。
- ただし有限の evolve set を何ラウンドも使い回すため、evolve set のスコアは上がるが未知のベンチマークには効かない、という過学習が起きる。
- 提案手法 RRSI は、harness のどこを編集してよいかは制限せず、候補の「提案」と「選択」の2か所に機械学習の正則化(L0 / L1 / L2 など)の考え方を持ち込む。
- 3ドメイン8ベンチマークで、evolve set 上で最大 +14.1pt、OOD の5ベンチマークで最大 +4.7pt。無正則化の進化と比べて policy token を約30%削減(Table 2 では 3.80M → 2.42M tokens/trial)。
- 先行4手法と比べて evolve set での伸びは一番小さいが、OOD 平均で H0 を1pt以上上回ったのは RRSI のみ。
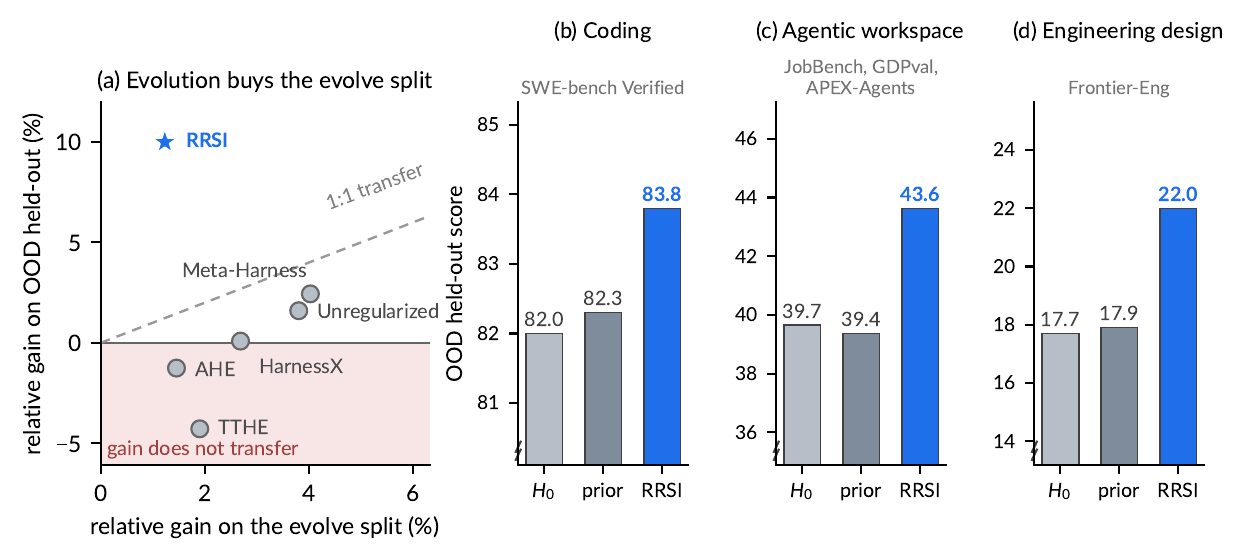
- (a) の横軸が evolve set でのゲイン、縦軸が OOD でのゲイン。先行手法は evolve set で 2〜4% 伸びても OOD ではほぼ0、AHE と TTHE はマイナス(赤い領域)。RRSI は evolve set のゲインが最も小さいが、OOD で約10% 伸びている。
背景: harness evolution とその過学習
- harness は「重み以外のすべて」と定義されている。system / task プロンプト、いつ plan・act・reflect・stop するかを決める制御フロー、ツールインタフェースとその説明、memory・skill ファイル、各ステップで policy に何を見せるかを決めるコンテキスト管理。
- harness engineering は人手で失敗軌跡を読んで scaffold を直す作業なので、エンジニアが読める軌跡の数で律速される。これを LLM で自動化する手法が 2026年に急増している(Meta-Harness, AHE, TTHE, HarnessX, Darwin Gödel Machine, DarwinX, Self-Harness など)。2026-08-20 回で扱った Continual Harness も Karten et al., 2026b として引用されている。
- これらの手法は、概ね次の共通ループで書ける。
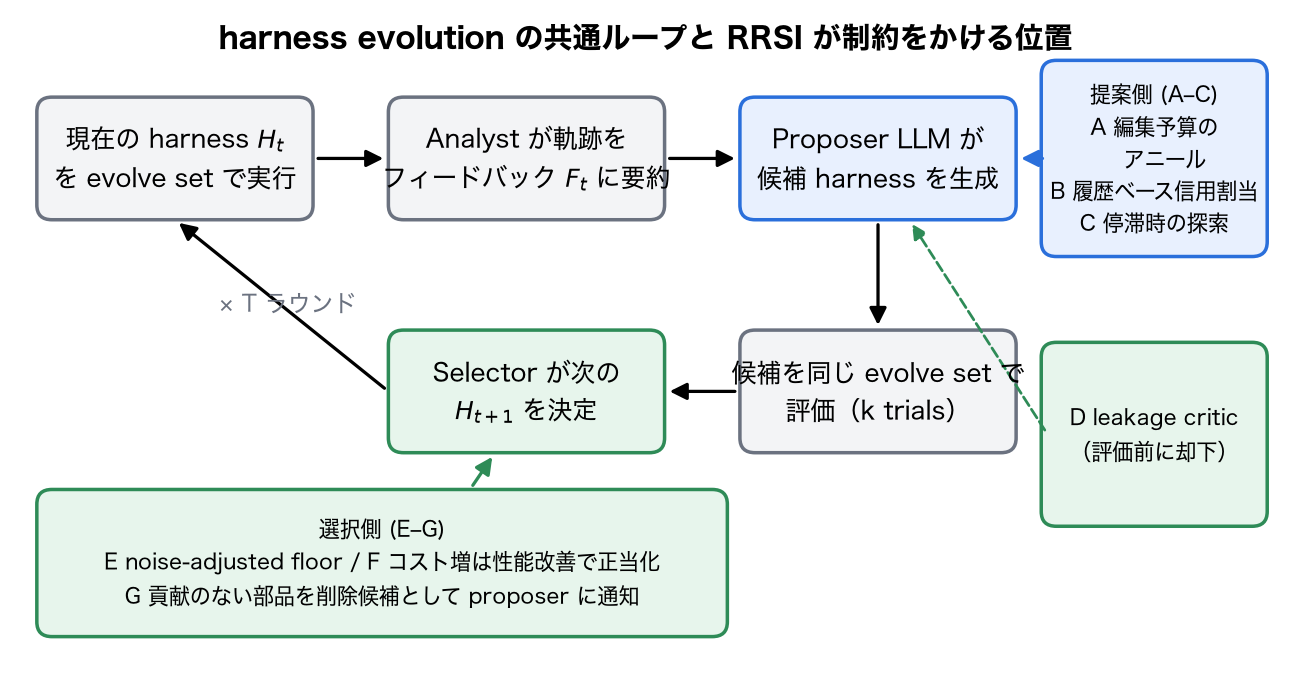
- 問題は が有限回の確率的な実行から得た経験スコアであり、かつ同じ evolve set を何ラウンドも見ている点。ラウンド t の候補は、同じタスクでの過去の測定結果に依存して作られる。著者はこれを「非常に表現力の高い探索空間上の adaptive empirical optimization」と呼んでいて、holdout を使い回したときの過学習(Dwork et al., 2015)と同じ構図として扱っている。
- 過学習の要因として3つ挙げられている。
| 要因 | 何が起きるか | 主に効く RRSI の構成要素 |
|---|---|---|
| benchmark-specific fitting | タスク名・エンティティ名・固有値・答えなど、evolve ベンチ固有のロジックが harness に入り込む | D leakage screening |
| noise chasing | 確率的評価でたまたま上振れた候補が採用される。ノイズに見える小さな退行が積み重なる | E noise-adjusted floor、F のノイズ帯判定、B 履歴ベースの信用割当 |
| complexity accumulation | 機構としては改善していないのに、ステップ数・トークン消費・部品だけが増えて evolve set のスコアが上がる | A 編集予算、F complexity-aware acceptance、G structural pruning |
- 本論文での「汎化」は、evolve した harness を、タスク記述・ツールインタフェース・verifier が異なる未知のベンチマークにそのまま持っていって効くこと、と定義されている。
問題設定
- agent 。 は凍結した backbone policy、 が harness。タスク に対して軌跡 と成果物を出し、verifier が で採点する。verifier は coding なら unit test、agentic workspace なら LLM-as-a-judge。
- タスク集合 に対する性能とコストを次で定義する。 はその軌跡が消費した policy token 数。
- 実際には1タスクあたり k 回実行した平均 を使う。実験では k=2(engineering design のみ k=4)。
- 最適化変数は H のみで、policy の重みは更新しない。
提案手法: RRSI
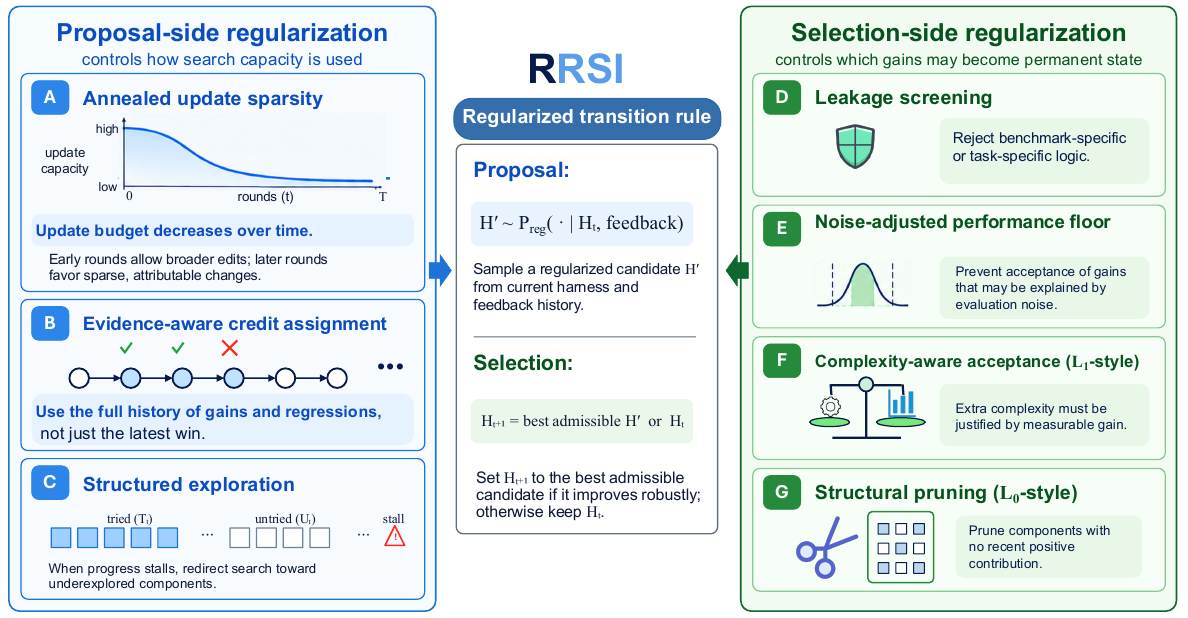
- 基本方針は「編集可能な範囲 は開いたまま、探索の軌跡の方を正則化する」。プロンプト・制御フロー・設定・コンテキスト管理・ツール・skill・memory・subagent はすべて追加・変更・削除してよい。
- 正則化は2か所にかかる。
- 提案側: 1つの候補で harness をどこまで大きく変えてよいか(一度に入れてよい変更の数)と、どの部品の変更を試すか。
- 選択側: 測定された改善のうち、どれを harness の恒久的な状態にしてよいか。
- 古典的な正則化との対応は次のように説明されている。
| 構成要素 | 対応する正則化 | 何を抑えるか |
|---|---|---|
| A Annealed update sparsity | L0(基数制約) | 1回の更新で同時に変わる機構の数 |
| G Structural pruning | Lasso / L1 | 保持される harness の部品数 |
| F Complexity-aware acceptance | Ridge / L2 | harness 全体のリソース量(policy token) |
| C Structured exploration | entropy / diversity 正則化(SAC を引用) | 提案が特定の編集の種類に偏ること |
| E Noise-adjusted floor | adaptive data analysis(Dwork et al., 2015) | 評価ノイズの上振れを改善として固定すること |
著者自身が「あくまでアナロジーで、ノルム罰則付きの目的関数を最適化しているわけではない」と本文・Appendix の両方で明記している。また Figure 2 では F が "L1-style"、G が "L0-style" と書かれていて、本文(F = Ridge/L2、G = Lasso/L1、A = L0)と食い違っている。本資料は本文と Appendix の記述に合わせている。
提案側の正則化
A. L0-Style Annealed Update Sparsity
- 制約のない proposer は、無関係な変更を1つの候補に束ねることができる。こうした候補は一度に多くを変えられる分、今回のフィードバックに含まれる偶然の癖にも合わせ込みやすい。しかもスコアが変わっても、どの変更が効いたのかを切り分けられない。
- そこで1候補に含めてよい「効果を個別に切り分けられる単位の編集」(atomic edit)の数に上限をかけ、ラウンドが進むにつれて cosine で減らす。
- Appendix では、proposer がラウンドごとに作る atomic edit のプール から候補が使う部分集合を と書き、 という基数制約として定式化している。
- 初期ラウンドは複数の協調した変更で新しい機構を見つけにいき、後半ほど1つずつの小さな変更にして、どの変更が効いたのかが分かるようにする、という狙い。
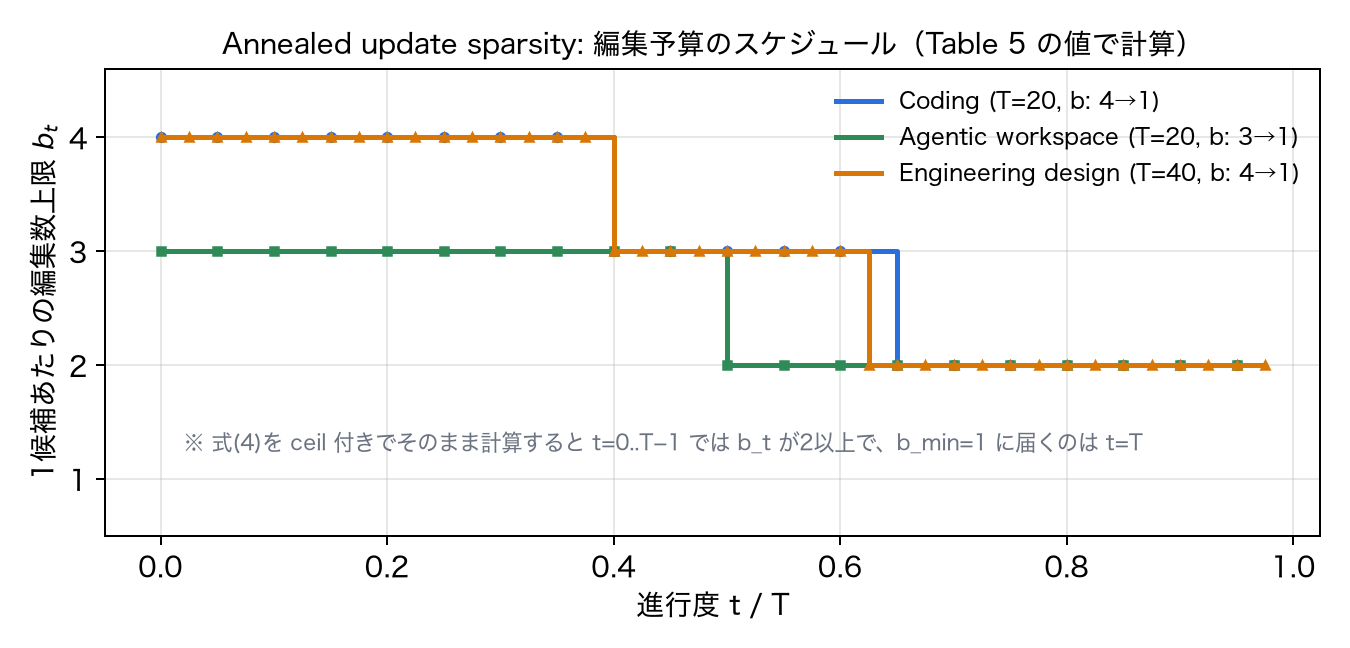
- Table 5 の値(Coding: など)で式(4)を計算したもの。ceil があるため、t = 0..T−1 の範囲では は 2 までしか下がらない。Table 5 では を "final-round edit budget" と説明しているので、実装上の丸めやラウンドの数え方が式と異なる可能性がある。
B. Evidence-Aware Credit Assignment
- 評価のたびに同じ evolve set をもう一度見ることになるので、過去のラウンドで否定済みの仮説を繰り返し試すのは、新しい情報が得られないまま候補の枠と評価だけを使ってしまう。
- そこで評価した全候補について、変更したコンポーネント ℓ、検証している仮説 h、source diff d、スコア変化 ΔS、コスト変化 ΔC、採否 a を記録し、以降のラウンドの proposer に渡す。
- 却下された機構は負の証拠として残り、成功した機構は明示的に credit を持つ。
- 1候補に複数の編集が束ねられている場合、各編集は候補単位の ΔS / ΔC をそのまま共有する。A で予算が絞られるほど1候補あたりの編集が少なくなり、どの編集がスコア変化を生んだのかを記録から読み取りやすくなる。A と B はセットで効く設計になっている。
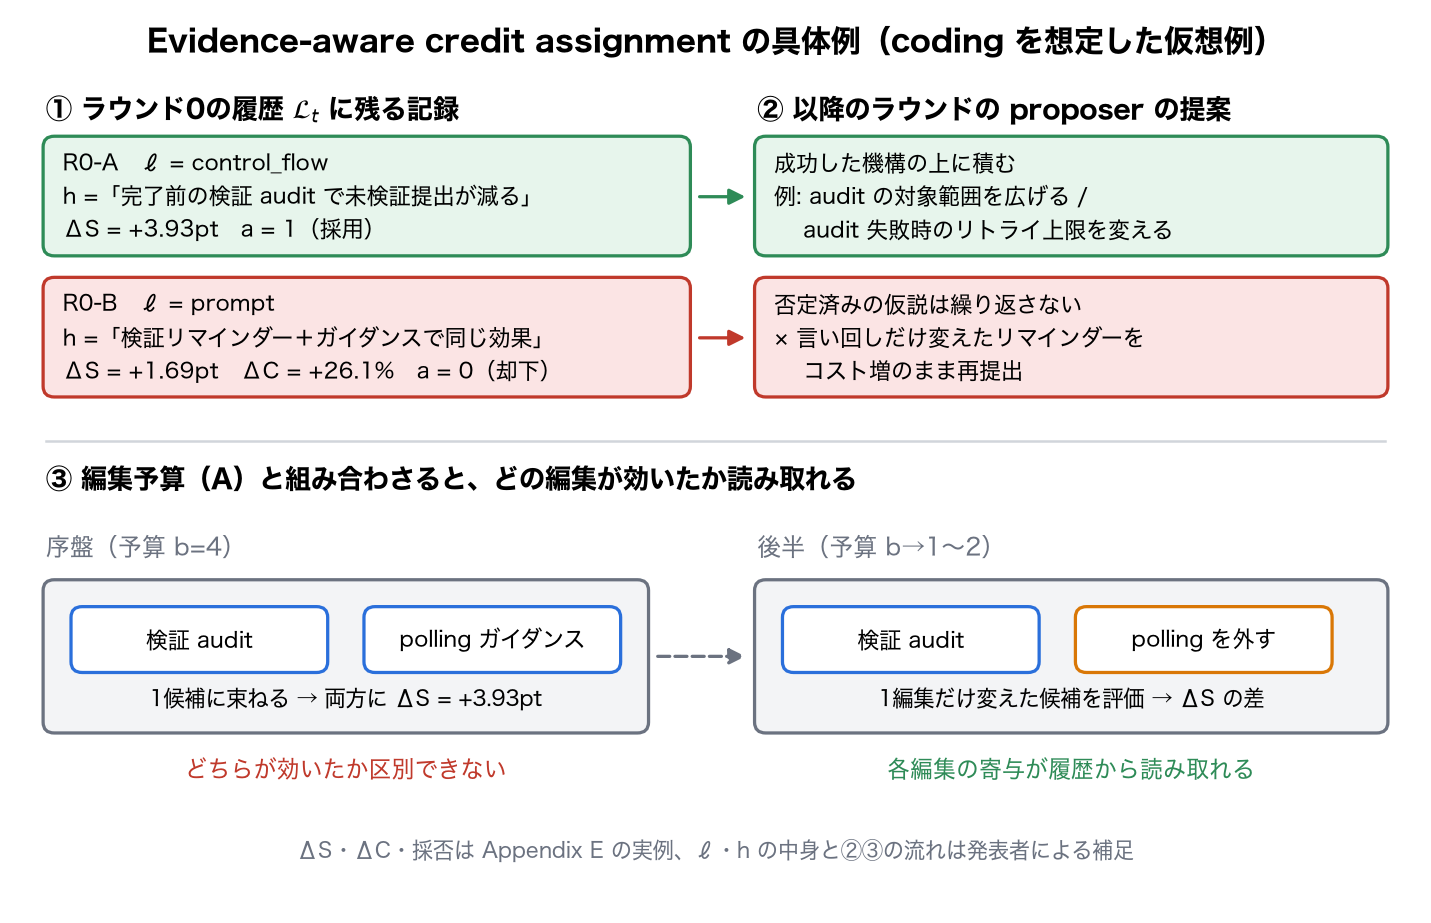
- 具体例(coding の設定を想定した発表者による仮想例。記録の形式は Appendix C の式(10)に従い、R0-A / R0-B の数値は Appendix E の実例)
- ラウンド0の履歴には次のような記録が残る。
- R0-A: ℓ = control_flow、h =「完了前に検証 audit を入れると未検証のまま提出する失敗が減る」、ΔS = +3.93pt、a = 1(採用)
- R0-B: ℓ = prompt、h =「検証を促すリマインダーと長時間処理のガイダンスで同様の効果が出る」、ΔS = +1.69pt、ΔC = +26.1%、a = 0(却下)
- 以降のラウンドで proposer はこの履歴を読むので、「検証リマインダーをプロンプトに足す」系統の案は、コストを増やす形では一度否定済みの仮説として扱える。同じ案を言い回しだけ変えて再提出し、評価枠を使うことを避けられる。
- 逆に R0-A の検証 audit は成功した機構として credit を持つので、「audit の対象範囲を広げる」「audit 失敗時のリトライ上限を変える」のように、効いた機構の上に積む案を優先できる。
- ラウンド0は編集予算が4なので、1候補に「検証 audit + polling ガイダンス」のように複数の編集が入ると、両方の記録に同じ ΔS = +3.93pt が付き、どちらが効いたのかは区別できない。後半のラウンドで予算が絞られ、例えば polling ガイダンスだけを外した候補が評価されると、その差から各編集の寄与が履歴上で読み取れるようになる。
C. Structured Exploration
- 同じ履歴から、proposer が特定の編集の種類に張り付いている状態(例: プロンプトの書き換えばかりで構造的な機構を触らない)を検出する。
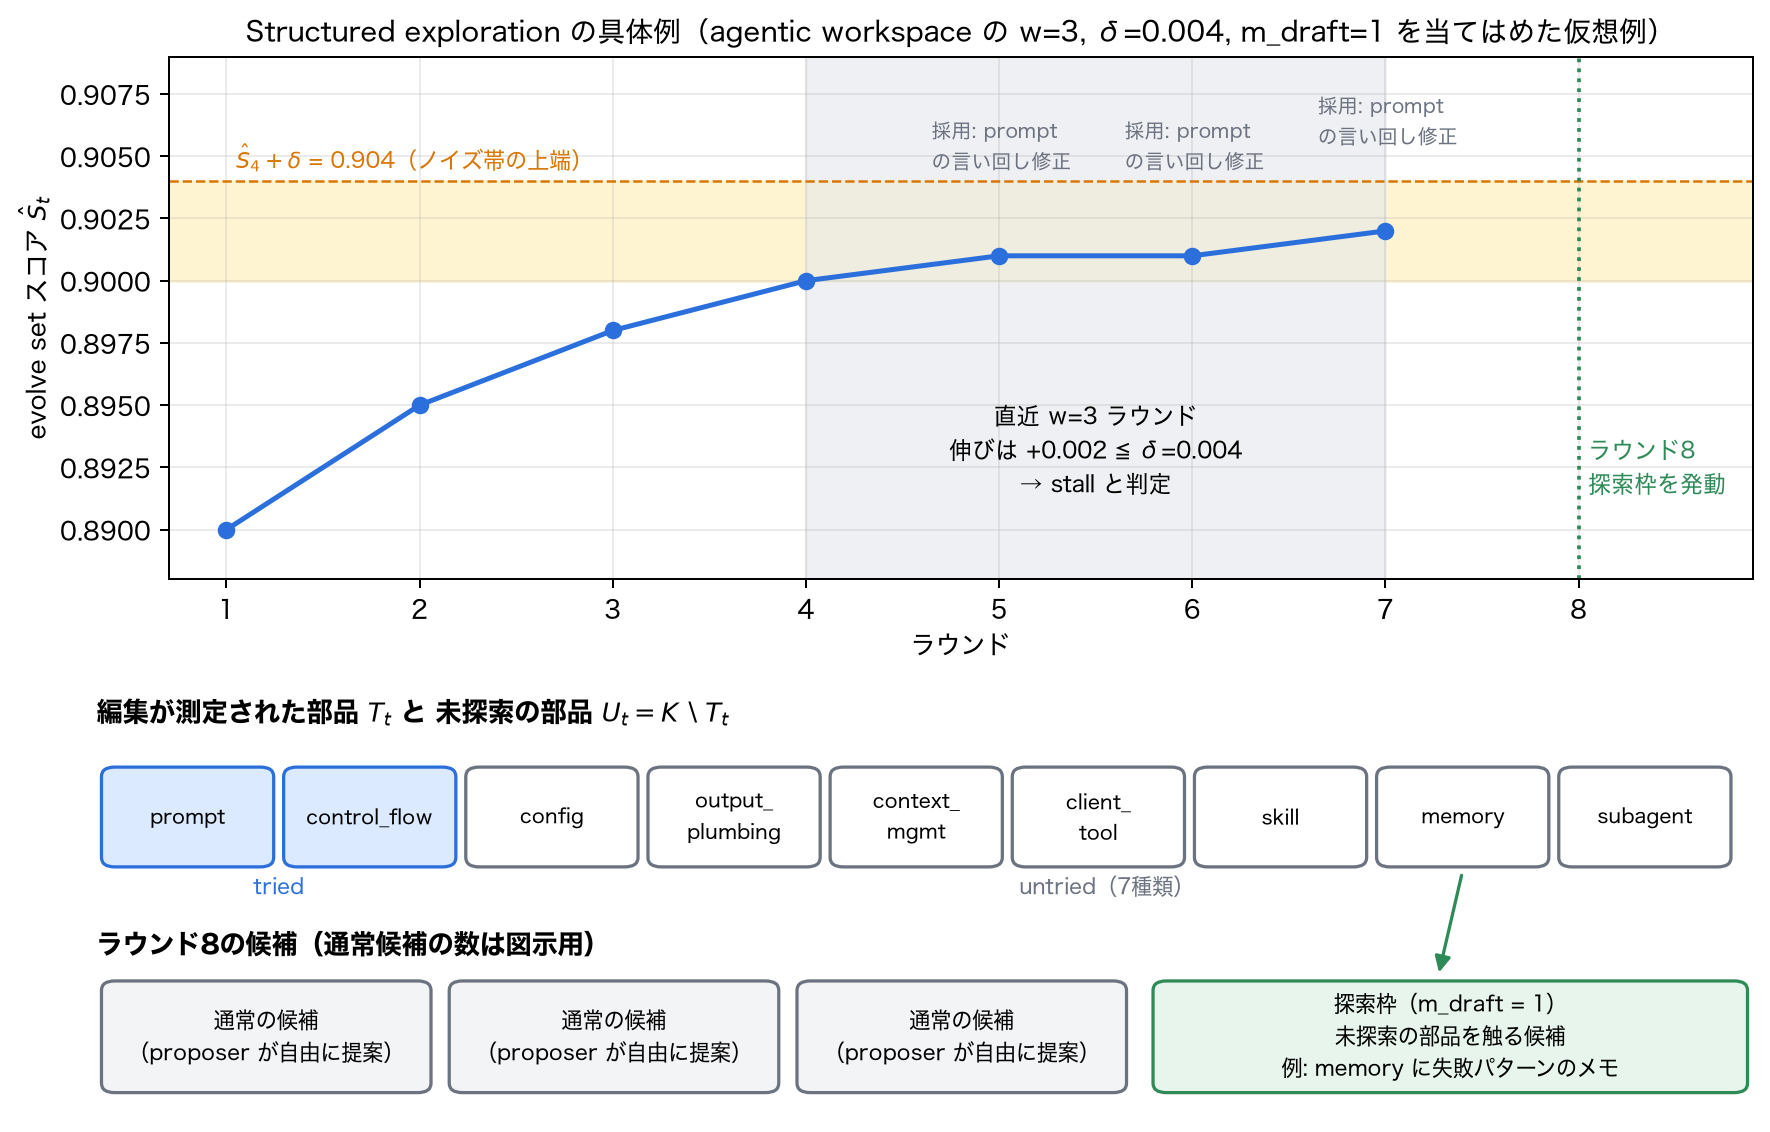
- 直近 w ラウンドの間にスコアがノイズ帯 δ を超えて伸びていなければ stall(停滞)と判定する。stall 中は、各ラウンドの候補のうち 個を、まだ一度も編集・測定されていないコンポーネントを触る探索用の候補に充てる。
- 式で書くと stall 判定は 、未探索のコンポーネントは (K は下記の9種類、 はこれまでに編集が測定されたコンポーネント)。
- 具体例(agentic workspace の設定値 w=3, δ=0.004, m_draft=1 を当てはめた発表者による仮想例。論文にはこの粒度の実例は載っていない)
- ラウンド5〜7で採用された候補がプロンプトの言い回し修正ばかりで、evolve set のスコアがラウンド4の 0.900 からラウンド7で 0.902(+0.002 ≤ δ)にしか伸びていない → stall と判定。
- それまでに編集したのが prompt と control_flow だけなら、未探索は config, output_plumbing, context_mgmt, client_tool, skill, memory, subagent。
- ラウンド8では候補のうち1個を、例えば memory(過去タスクで失敗したパターンをメモとして参照させる)や subagent(成果物の書式チェックを別エージェントに任せる)のような未探索コンポーネントを触る候補にする。残りの候補は通常どおり proposer が自由に提案する。
- 編集可能なコンポーネントの語彙は prompt, control_flow, config, output_plumbing, context_mgmt, client_tool, skill, memory, subagent の9種類。
- harness が持ってよい機構の範囲は変えずに、限られた候補の枠の一部を未探索の機構に回す、という位置づけ。
選択側の正則化
D. Leakage Screening
- 本評価の前に critic LLM が各候補の diff を読み、タスク名・エンティティ名・タスク固有の値・答え、その他 evolve ベンチマーク固有のロジックを含む編集を却下する。何もしない機構(inert machinery)を追加する編集も却下対象。
- 対象は「ベンチマーク固有の内容」であって、特定のコンポーネントではない。汎用的なプロンプトやツール説明の改善は候補として残る。
- 評価の前に弾くのがポイントとされている。リークを含む候補を一度でも評価すると、次のような連鎖が起きうるため(論文の記述は1文なので、以下は RRSI の各構成要素の動きから発表者が補ったもの)。
- 例: Harvey LAB の特定タスクで要求される成果物のファイル名や、特定の契約書に固有の条項番号をプロンプトに書き込んだ候補は、そのタスクで点が取れるので evolve set のスコアが上がる。
- 選択は の argmax なので、この候補が次の harness として採用されやすい。採用されると最良スコア も水増しされた値に更新される。
- 履歴 にはこの編集が「ΔS が大きく採用された成功例」として残るので、proposer は以降のラウンドでも同じ方向(タスク固有の情報を書き込む)の編集を提案しやすくなる。
- E の floor は なので、水増しされた が基準になり、リークを含まない汎用的な候補の方が却下されやすくなる。
- 評価前に却下すればスコアも履歴上の成功記録も付かない(Appendix C でも、有効な測定前に落ちた候補は履歴に入らない)ので、この連鎖が最初から起きない。
E. Stability-Aware Acceptance(noise-adjusted floor)
- 進化を始める前に、変更していない base harness を繰り返し評価して経験的なノイズ帯 δ を推定しておく。
- これまでの最良スコアを として、候補は次を満たす必要がある。
- 1回ずつはノイズに見えるほど小さな退行を積み重ねて、坂を下っていくことを防ぐ。
F. Ridge/L2-Style Complexity-Aware Acceptance
- 現在の harness に対するスコア差とコストの相対変化を次で定義する。
- ΔS が δ を超える候補には、次の条件を課す。 はほぼゼロの改善でも許容するコスト増、 は改善が大きくなるにつれて追加で許容するコスト。
- ΔS が δ 以内(ノイズ帯の中)の候補には、式(7)の代わりに次のルール(論文では shaped admissibility condition)を使う。
- は、候補が触った構造コンポーネント(client_tool, skill, memory, subagent)のうち、これまで一度も採用された編集に含まれていない種類の数。prompt や control_flow などの編集にはこのボーナスは付かない。
- 直感的には「スコアの差はノイズと区別できないので、スコア以外の良さで判断する」ルール。スコアの小さな上昇()、コストの削減(、コストが下がると正)、新しい種類の構造部品を試していること()の3つを足し合わせて、プラスなら採用候補に残す。
- コストが下がる候補は、スコアが同程度でも採用されうる(同じ性能でより軽い harness に置き換わる)。
- コストが上がる候補は、それを上回る新規性ボーナスがない限り採用されない。
- 新規性ボーナスは tool / skill / memory / subagent のうち、まだ一度も採用されていない種類を初めて導入する候補にだけ付く。プロンプトの言い回し修正のような編集は、スコアがノイズ帯内で少し上がってもコストが増えれば採用されない。
- coding では で、ノイズ帯の中のスコア上昇はまったく加点されない。コスト削減か構造的な新規性が必要になる。
- Appendix E の R0-B(+1.69pt で δ=1.7pt 以内、コスト +26.1%)がこの領域の実例。検証リマインダーとガイダンスの追加で新規性ボーナスの対象にならず、コスト増だけが効いて却下されている。
- の具体値は本文で「Table 5 に記載」とされているが、Table 5 には載っていない。
- engineering design ではさらにドメイン固有のガードがあり、valid-output 率が 0.03 を超えて下がるか、no-submission 率が 0.02 を超えて上がる候補を却下する。
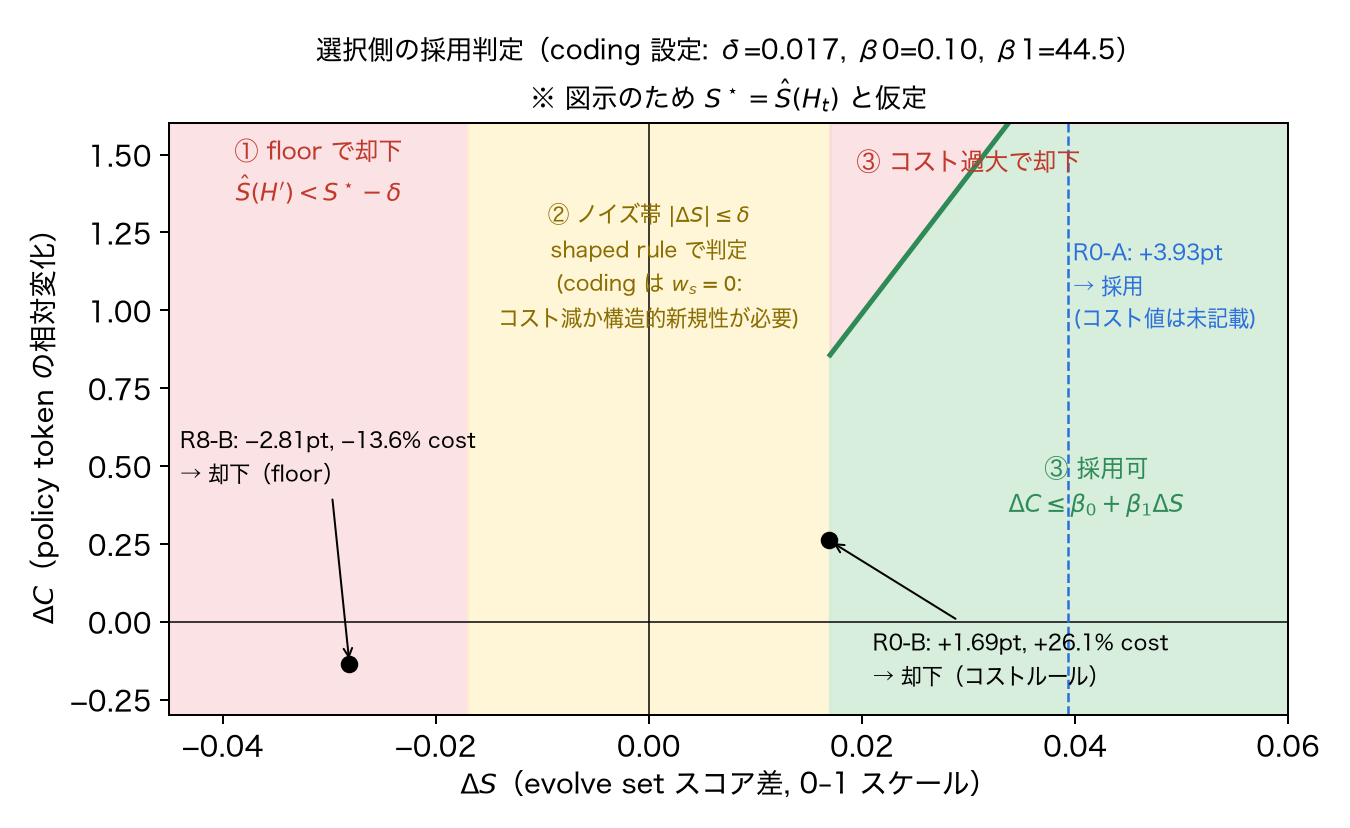
- coding 設定の値で採用判定の領域を描いたもの。点は Appendix E(Table 6)の実例。
- パラメータの単位換算も Appendix に書かれている。
- coding: δ は 178 trial(89タスク × k=2)中 3 pass 相当、 は 1 pass 増えるごとに 25% のトークン増を許容。
- agentic workspace: δ は約14,100 の criterion 判定中 60 相当、 は 100 criterion ごとに 25% を許容。
- engineering design: δ は 244 trial 中 5 pass 相当、 は 1 pass ごとに 10% を許容。
G. Lasso/L1-Style Structural Pruning
- 各コンポーネント ℓ について、直近 ラウンドの測定で得られた最大の ΔS を とする。一度でも測定されたのに のコンポーネントを削除対象 として proposer に渡し、次のラウンド以降で取り除くよう指示する。
- A が「1回の更新」を疎にするのに対して、G は「保持されている harness」を疎にする。
- 自動で削除するのではなく、proposer への指示として渡す点には注意。
最終的な選択
- floor(E)、F の該当する分岐、ドメインガードをすべて満たした候補の集合から、 が最大のものを にする。該当がなければ現在の harness を維持し、 を更新する。
- ハイパーパラメータ(Table 5)。held-out / OOD は使わず、evolve 環境と運用上の判断だけで決めたと明記されている。
| パラメータ | 役割 | Coding | Agentic workspace | Engineering design |
|---|---|---|---|---|
| T / k | ラウンド数 / タスクあたり試行数 | 20 / 2 | 20 / 2 | 40 / 4 |
| δ | ノイズ帯 | 0.017 | 0.004 | 0.020 |
| b_min / b_max | 編集予算 | 1 / 4 | 1 / 3 | 1 / 4 |
| w / m_draft | stall 判定窓 / 探索枠 | 3 / 1 | 3 / 1 | 3 / 1 |
| n_prune | pruning 窓 | 4 | 4 | 5 |
| β0 / β1 | コスト許容 | 0.10 / 44.5 | 0.10 / 35.4 | 0.15 / 24.4 |
実験設定
| ドメイン | evolve set | held-out | 採点 |
|---|---|---|---|
| Coding | Terminal-Bench 2.1(89タスク、実シェル操作) | OOD: SWE-bench Verified | 隠された unit test |
| Agentic workspace | Harvey LAB(法務、120タスク) | ID: Harvey LAB 40タスク / OOD: JobBench, GDPval(185タスク、人間の専門家の成果物との勝率), APEX-Agents(480タスク) | LLM judge による rubric / 対比較 |
| Engineering design | EngDesign(61タスク、ID held-out なし) | OOD: Frontier-Eng(Medal Score、47タスク中38が採点対象) | タスクごとのシミュレータ / testbench(決定論的) |
- ベースラインは未進化の H0 と、harness evolution の先行4手法 Meta-Harness, AHE, TTHE, HarnessX。すべて同じ H0・policy・evolve set・候補予算で走らせている。
- policy は全ドメインで Claude Opus 4.8 に固定。proposer、ラウンドをまたいで失敗のフィードバックを書く analyst、leakage critic もすべて Claude Opus 4.8。
- base harness は coding が Terminus-2、Harvey LAB と EngDesign が ReAct ループ + MCP tool gateway + dynamic toolbelt + ReSum 型のコンテキスト管理。
- 比較対象の H0 は毎回同じ時間帯に同じ環境・judge・試行数で測り直しており、評価インフラ側のドリフトでゲインが出ないようにしている。
実験結果
| ドメイン | evolve set | held-out |
|---|---|---|
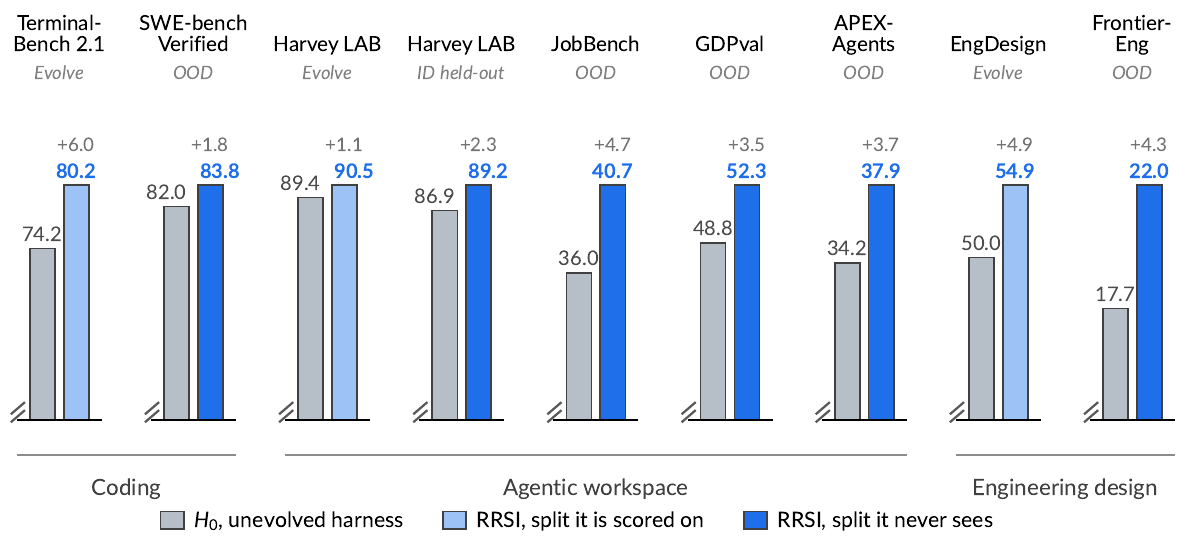
| Coding | Terminal-Bench 2.1: 74.2 → 80.2 (+6.0) | SWE-bench Verified: 82.0 → 83.8 (+1.8) |
| Agentic workspace | Harvey LAB: 89.4 → 90.5 (+1.1) | Harvey LAB ID: 86.9 → 89.2 (+2.3) / JobBench +4.7 / GDPval +3.5 / APEX-Agents +3.7 |
| Engineering design | EngDesign: 50.0 → 54.9 (+4.9) | Frontier-Eng: 17.7 → 22.0 (+4.3、相対 +24.3%) |
- held-out の split はすべて H0 から改善しており、悪化したものはない。
- 先行手法との比較(agentic workspace, Table 1)
| Method | Harvey LAB (Evolve) | Harvey LAB (ID Held-out) | JobBench | GDPval | APEX-Agents |
|---|---|---|---|---|---|
| H0 (no evolution) | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
- どの手法も evolve set ではよく伸びていて、ID held-out も 88.5〜89.2 とほぼ横並び。差が出るのは OOD。
- evolve set で最強の Meta-Harness は OOD 平均で +0.9、HarnessX は H0 と同じ、AHE と TTHE は H0 を下回る(TTHE は −1.7)。RRSI は evolve set のゲインが最も小さく、OOD 平均は 39.7 → 43.6。
- LLM judge の癖に合わせた書き方で点を稼いでいるだけではないか、という疑問に対しては、engineering design ドメイン(EngDesign / Frontier-Eng)が決定論的なシミュレータ採点で、そこでも改善が残っている、という説明。
分析
アブレーション(Table 2, agentic workspace)
| Variant | Harvey LAB (Evolve) | Harvey LAB (ID Held-out) | OOD Avg. | Tokens/trial (M) |
|---|---|---|---|---|
| H0 (no evolution) | 89.4 | 86.9 | 39.7 | 1.56 |
| Unregularized evolution | 92.8 | 88.9 | 40.3 | 3.80 |
| w/o proposal regularizers | 90.7 | 88.8 | 41.9 | 2.69 |
| w/o acceptance regularizers | 91.5 | 88.7 | 41.0 | 3.59 |
| RRSI | 90.5 | 89.2 | 43.6 | 2.42 |
- どちらの正則化を外しても、evolve set のスコアは上がり、OOD は下がる。
- 選択側を外すと evolve set は 90.5 → 91.5 に上がる一方、OOD 平均は 43.6 → 41.0、トークンは約1.5倍。制約のない選択ルールでは、採用される編集の多くがノイズとコンテキストの増量に使われている、という説明。
- 提案側を外すと evolve set は −0.2pt だけだが、OOD は −1.7pt。何も却下しない場合でも、探索がどこを見るかを誘導することに意味がある、という解釈。
- 両方外すと evolve set は 92.8 で全条件中最高、OOD 平均は 40.3 で H0 との差が 1pt 未満、トークンは 3.80M。
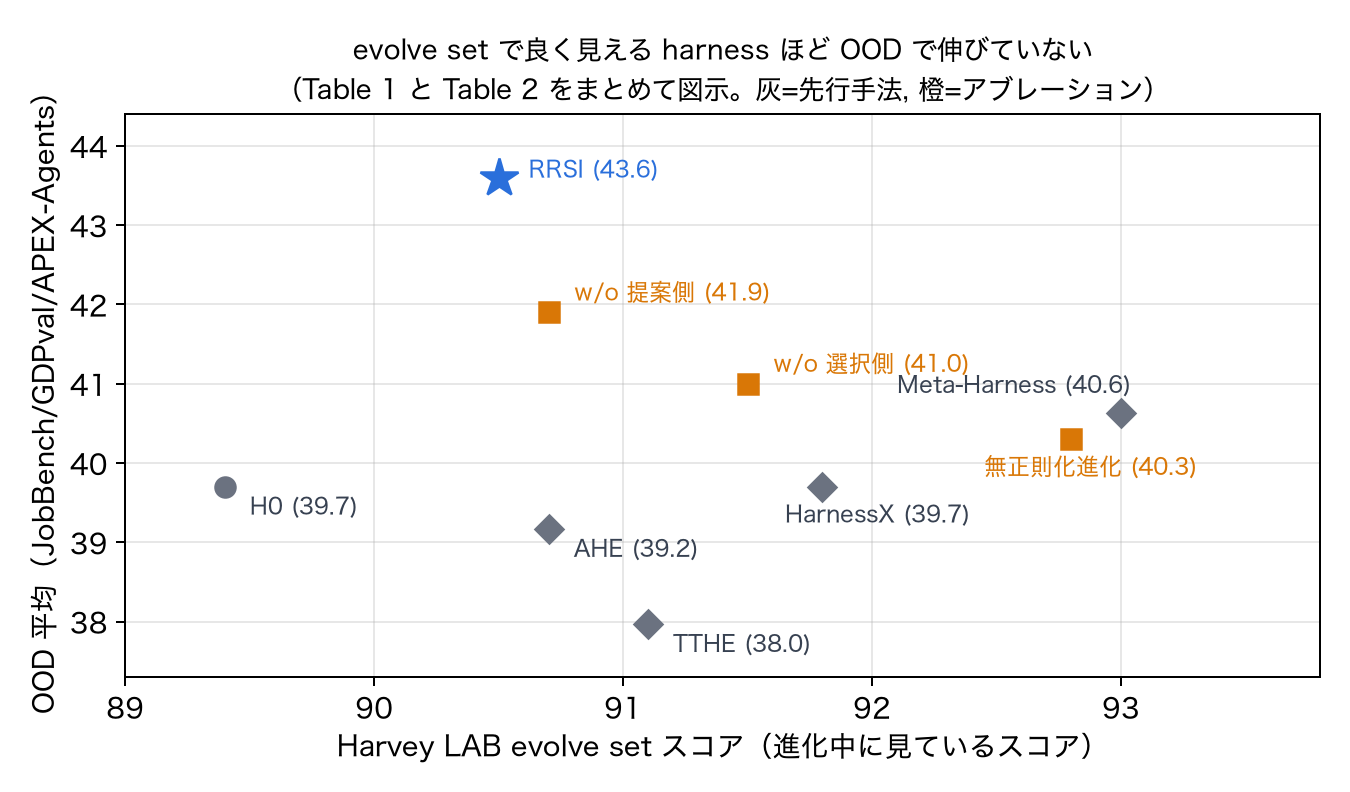
- Table 1 と Table 2 を1枚にまとめたもの。evolve set のスコアが高い条件ほど OOD 平均が低い傾向になっていて、進化中に見ているスコアだけで harness の良し悪しを判断できないことを示している。
policy への依存性(Table 3, 4, coding)
| 探索時の policy | 評価時の policy | ベンチマーク | H0 | RRSI | Δ |
|---|---|---|---|---|---|
| Claude Opus 4.8 | 同じ | Terminal-Bench 2.1 (Evolve) | 74.2 | 80.2 | +6.0 |
| Claude Opus 4.8 | 同じ | SWE-bench Verified (OOD) | 82.0 | 83.8 | +1.8 |
| Gemini 3.5 Flash | 同じ | Terminal-Bench 2.1 (Evolve) | 64.6 | 78.7 | +14.1 |
| Gemini 3.5 Flash | 同じ | SWE-bench Verified (OOD) | 76.8 | 79.0 | +2.2 |
| Gemini 3.5 Flash | Gemini 3.1 Flash Lite(探索に不参加) | Terminal-Bench 2.1 | 11.2 | 14.6 | +3.4(相対 +30.4%) |
- 別系統の policy で独立に進化させても同じ傾向。Claude Opus 4.8 は両ベンチマークとも上限に近いところから始まるので伸びしろが小さい、という説明。
- Gemini 3.5 Flash で進化させた harness を、探索に一度も使っていない小さいモデル Gemini 3.1 Flash Lite でそのまま動かしても改善する。harness は重みではなくプログラムなので、探索に使った policy でしか効かない機構はその policy 固有の artifact であり、再利用可能な機構とは言えない、という立場からの検証。
コスト(Figure 4)
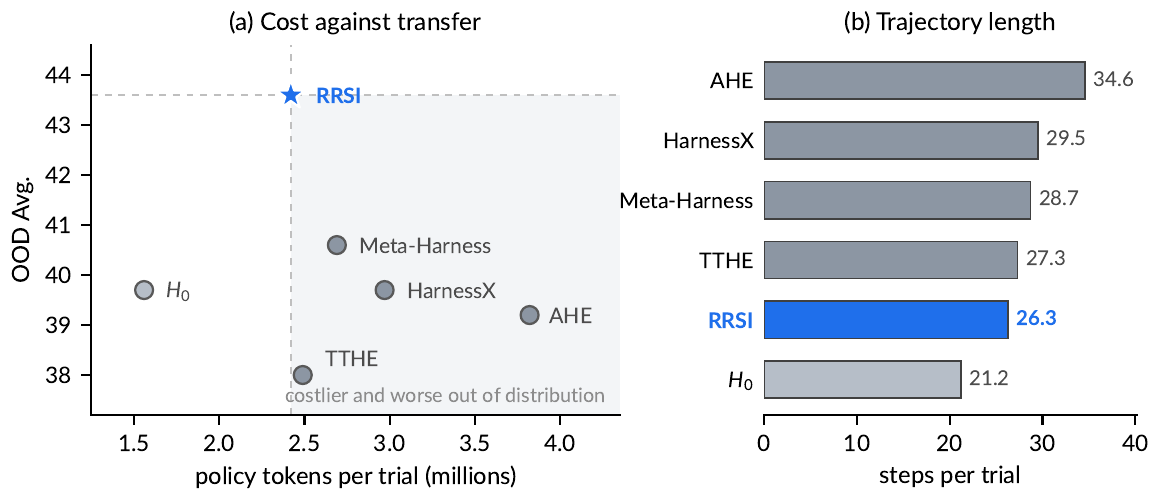
- 先行4手法はすべて「RRSI よりトークンが多く、OOD が低い」領域(網掛け)に入っている。最も重い AHE は 3.82M tokens/trial で RRSI より 58% 多く、OOD は 4.4pt 低い。
- ステップ数も RRSI が 26.3 steps/trial に対し、先行手法は 27.3〜34.6。
- ただし H0(1.56M tokens、21.2 steps)より軽い evolved harness はない。進化はゲインの一部をテスト時計算で買っていて、その量を予算で決めている、という説明。