2026-10-06 機械学習勉強会
過去の勉強会今週のTOPIC[paper] SkillRefiner: Offline Skill Refinement from Historical Agent Traces[blog] AutoBenchmark: benchmark creation & the role of humans[paper] Context Language ModelsメインTOPICLess Context, Better Agents: Efficient Context Engineering for Long-Horizon Tool-Using LLM Agents1. Introduction1.1 背景: ツール応答がエージェントの文脈を食い潰す1.2 対象業務: 経費明細化(expense itemization)1.3 貢献2. Related Work3. Methodology3.1 システム構成3.2 4 つの構成3.3 Algorithm 1: ConstructContext3.4 評価指標3.5 データセット4. Experiments4.1 主結果(ホテル 50 タスク、5 run 平均)4.2 統計4.3 感度分析(Appendix H)4.4 他カテゴリへの一般化(§4.8)4.5 Claude Sonnet 4.5 での再現(Appendix I、ユーザーモデルなし)5. Failure Analysis(§5、Appendix F)実例(Appendix F より要約)6. お気持ち7. デモ: 疑似 ERP で確かめたこと7.1 環境7.2 結果(難度を上げた 12 タスク: 10〜22 行、最大 5 泊。1 run)7.3 論文と結果が違う理由
過去の勉強会
今週のTOPIC
※ [paper] [blog] など何に関するTOPICなのかパッと見で分かるようにしましょう。
技術的に学びのあるトピックを解説する時間にできると🙆(AIツール紹介等はslack channelでの共有など別機会にて推奨)
出典を埋め込みURLにしましょう。
@Naoto Shimakoshi
[paper] SkillRefiner: Offline Skill Refinement from Historical Agent Traces
TL;DR: 新しいロールアウトを一切生成せず、過去の実行トレースと結果だけでエージェントのスキル ( 的な手順書) を改善する。8 設定すべてで初期スキルを上回り、改善コストは Trace2Skill の 1/1.4〜1/13、GEPA の 1/2.4〜1/42になる。
背景: 教師信号は本番ログに既にある
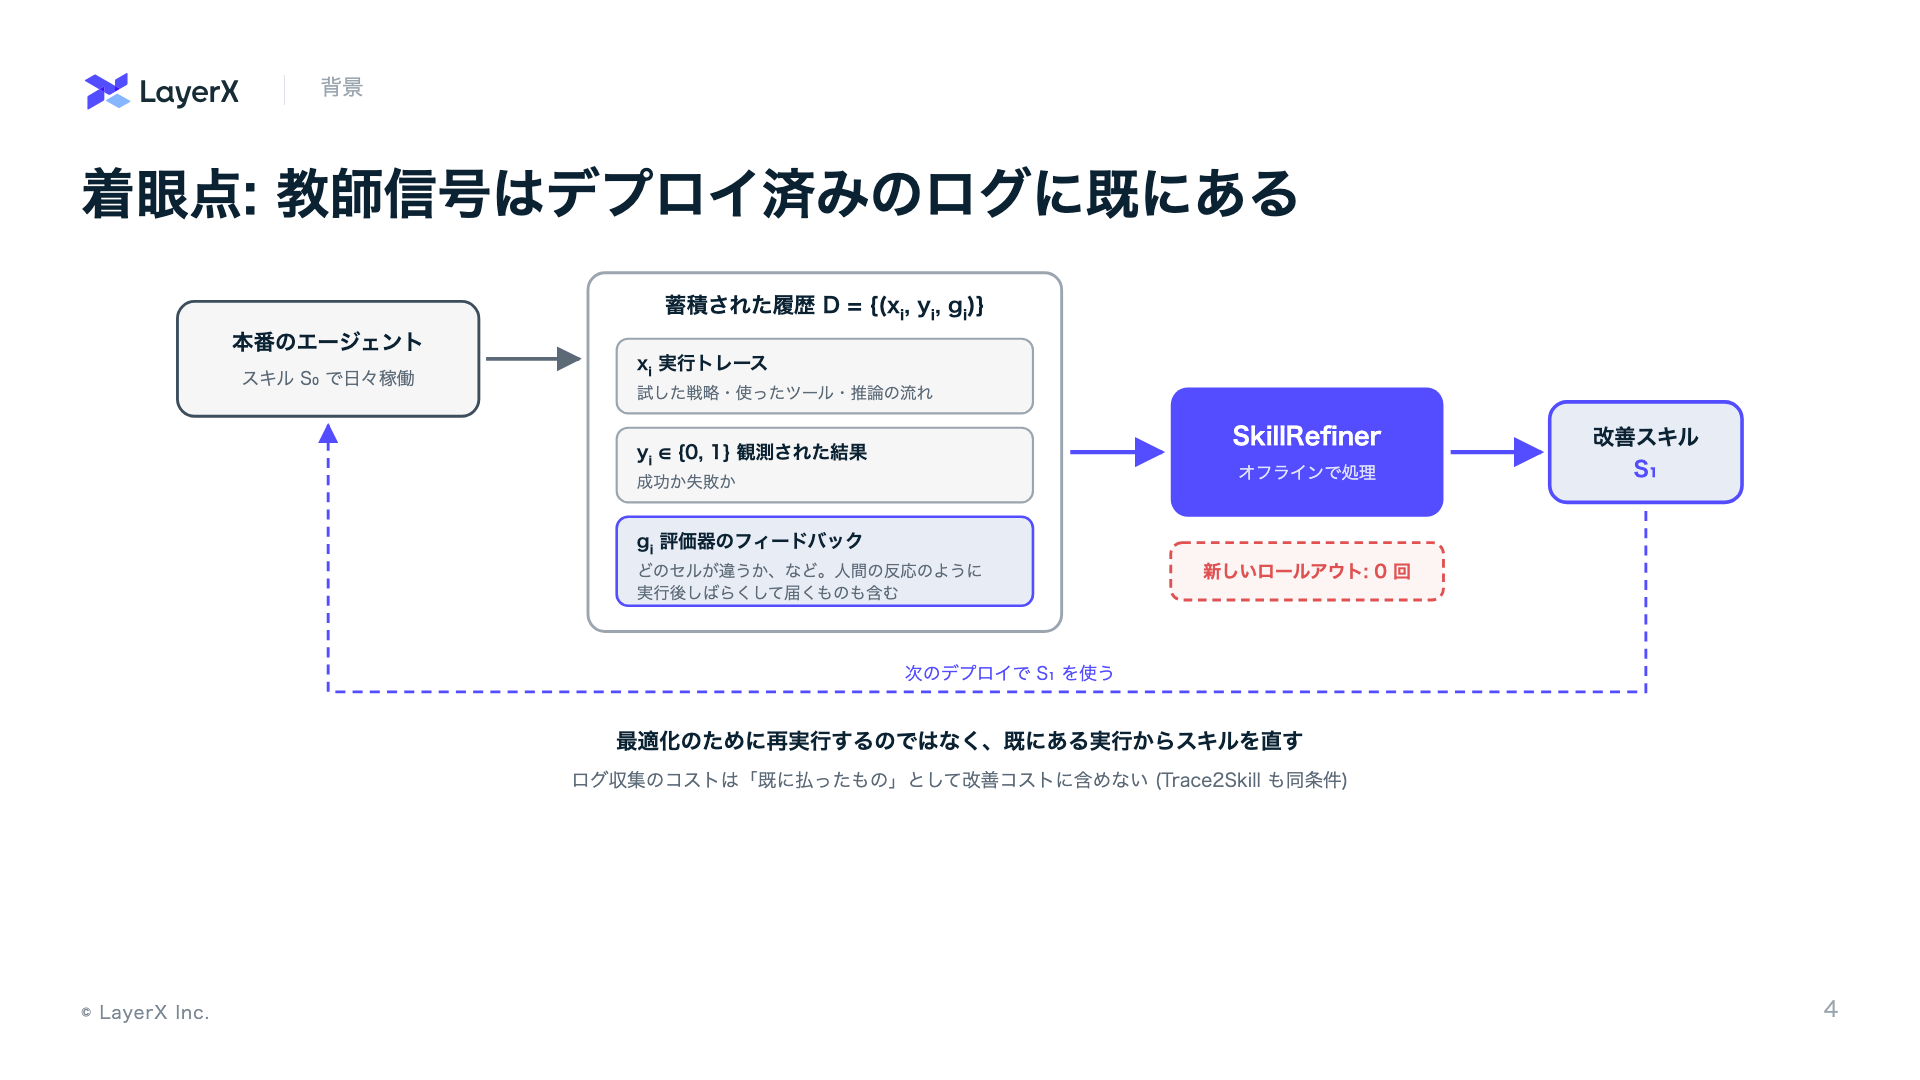
- GEPA などのスキル最適化は「候補を作る → 再実行 → すぐ評価」のループ。タスクを replay でき、結果をすぐ評価できることが前提
- PR レビューのように、指摘が有用だったかが開発者の修正・マージ後 (数日〜数週間後) にしか分からないタスクではこの前提が崩れる
- そこで、本番で溜まったトレース・成否・評価器のフィードバックからオフラインでスキルを直す
手法: 5 段のパイプライン
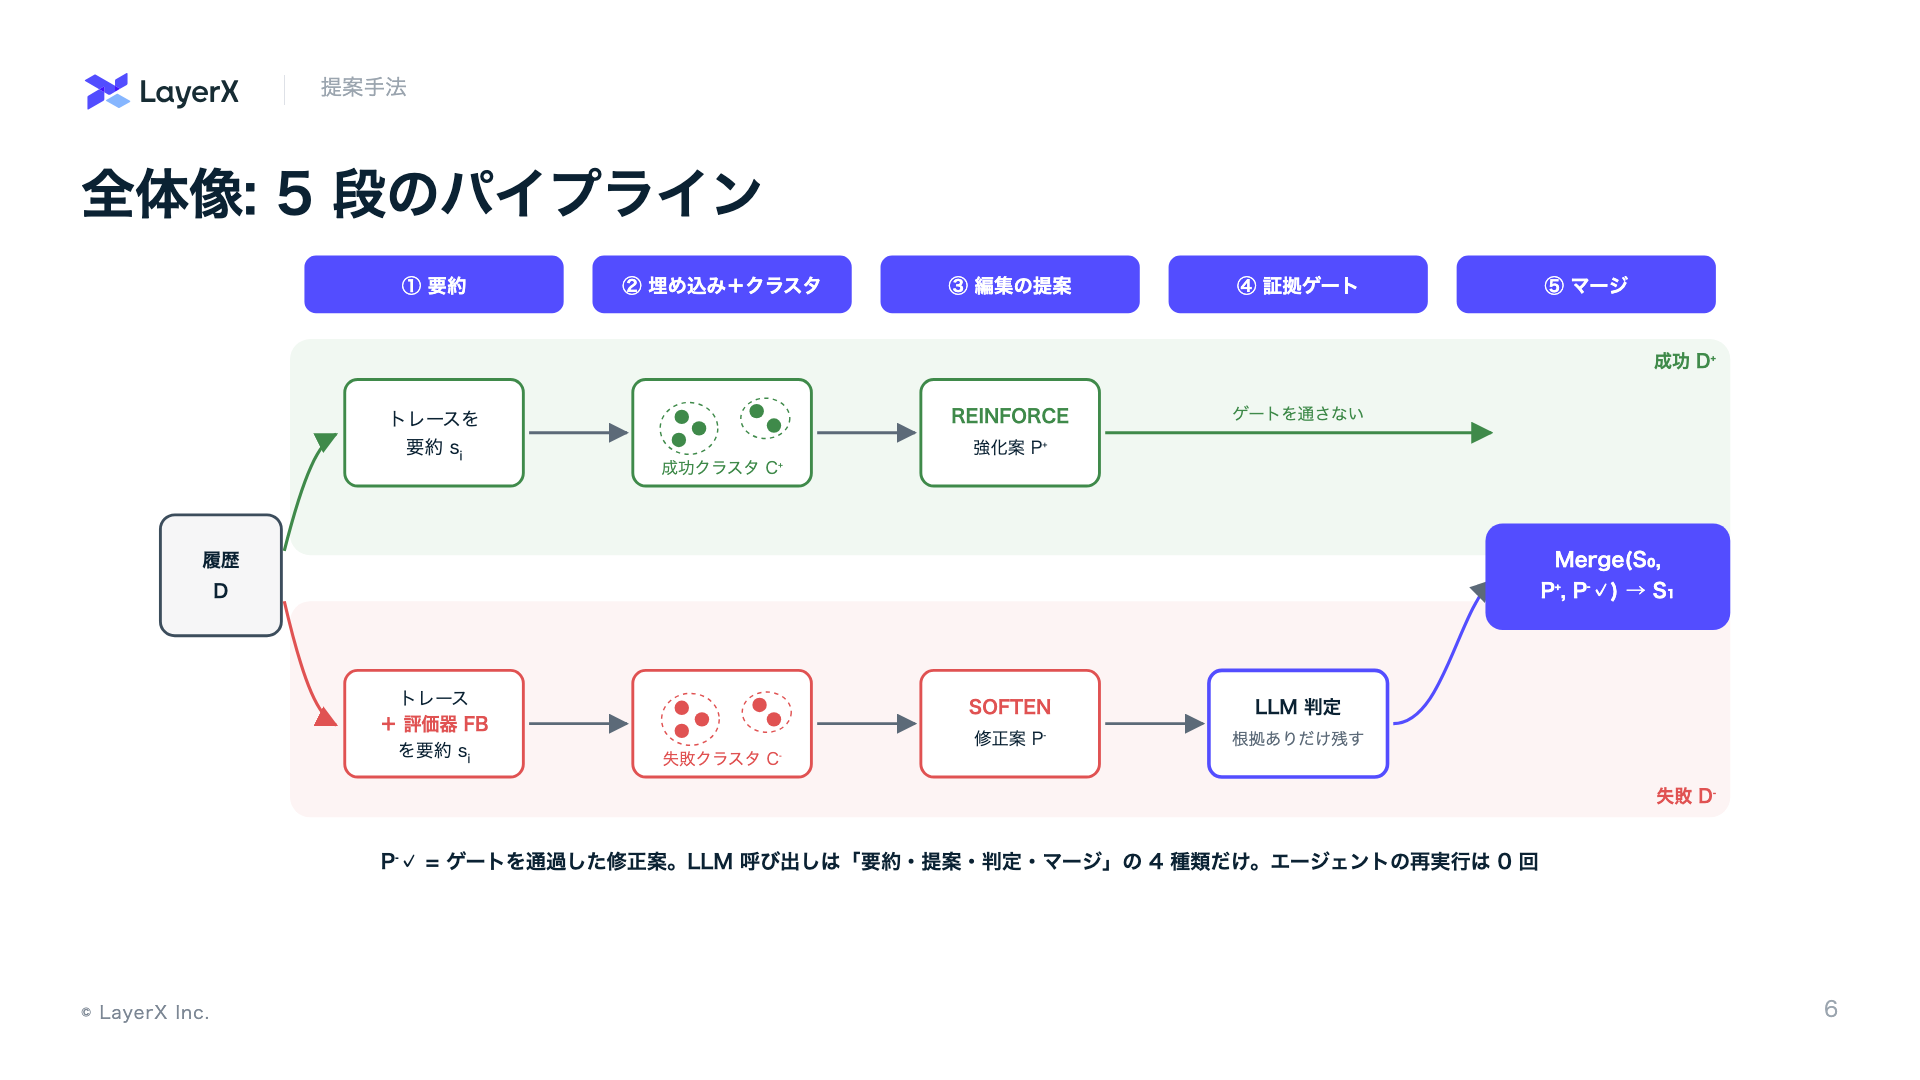
- ① 要約: 長いトレースを「スキルに書ける行動ルール」の粒度に圧縮。失敗トレースには評価器の指摘 (どのセルが違うか等) を添える
- ② クラスタリング: 成功と失敗を別々に埋め込み → UMAP → HDBSCAN。改善の単位をトレースではなくクラスタにして、1 回きりの事象を除く
- ③ 提案: クラスタごとに編集を 1 つ。成功は REINFORCE (効いた行動を固定)、失敗は SOFTEN (ガードレール追加 / 誤誘導する指示の削除)
- ④ 証拠ゲート: 失敗由来の修正案だけ、証拠に基づくかを別の LLM が審査 (後述)
- ⑤ マージ: 衝突したら指示を消すのではなく、元の指示に適用範囲を書き込む (例: 「数式を優先。ただし FIFO や多条件集計は Python で」)
③ 提案: 成功と失敗で指示を変える
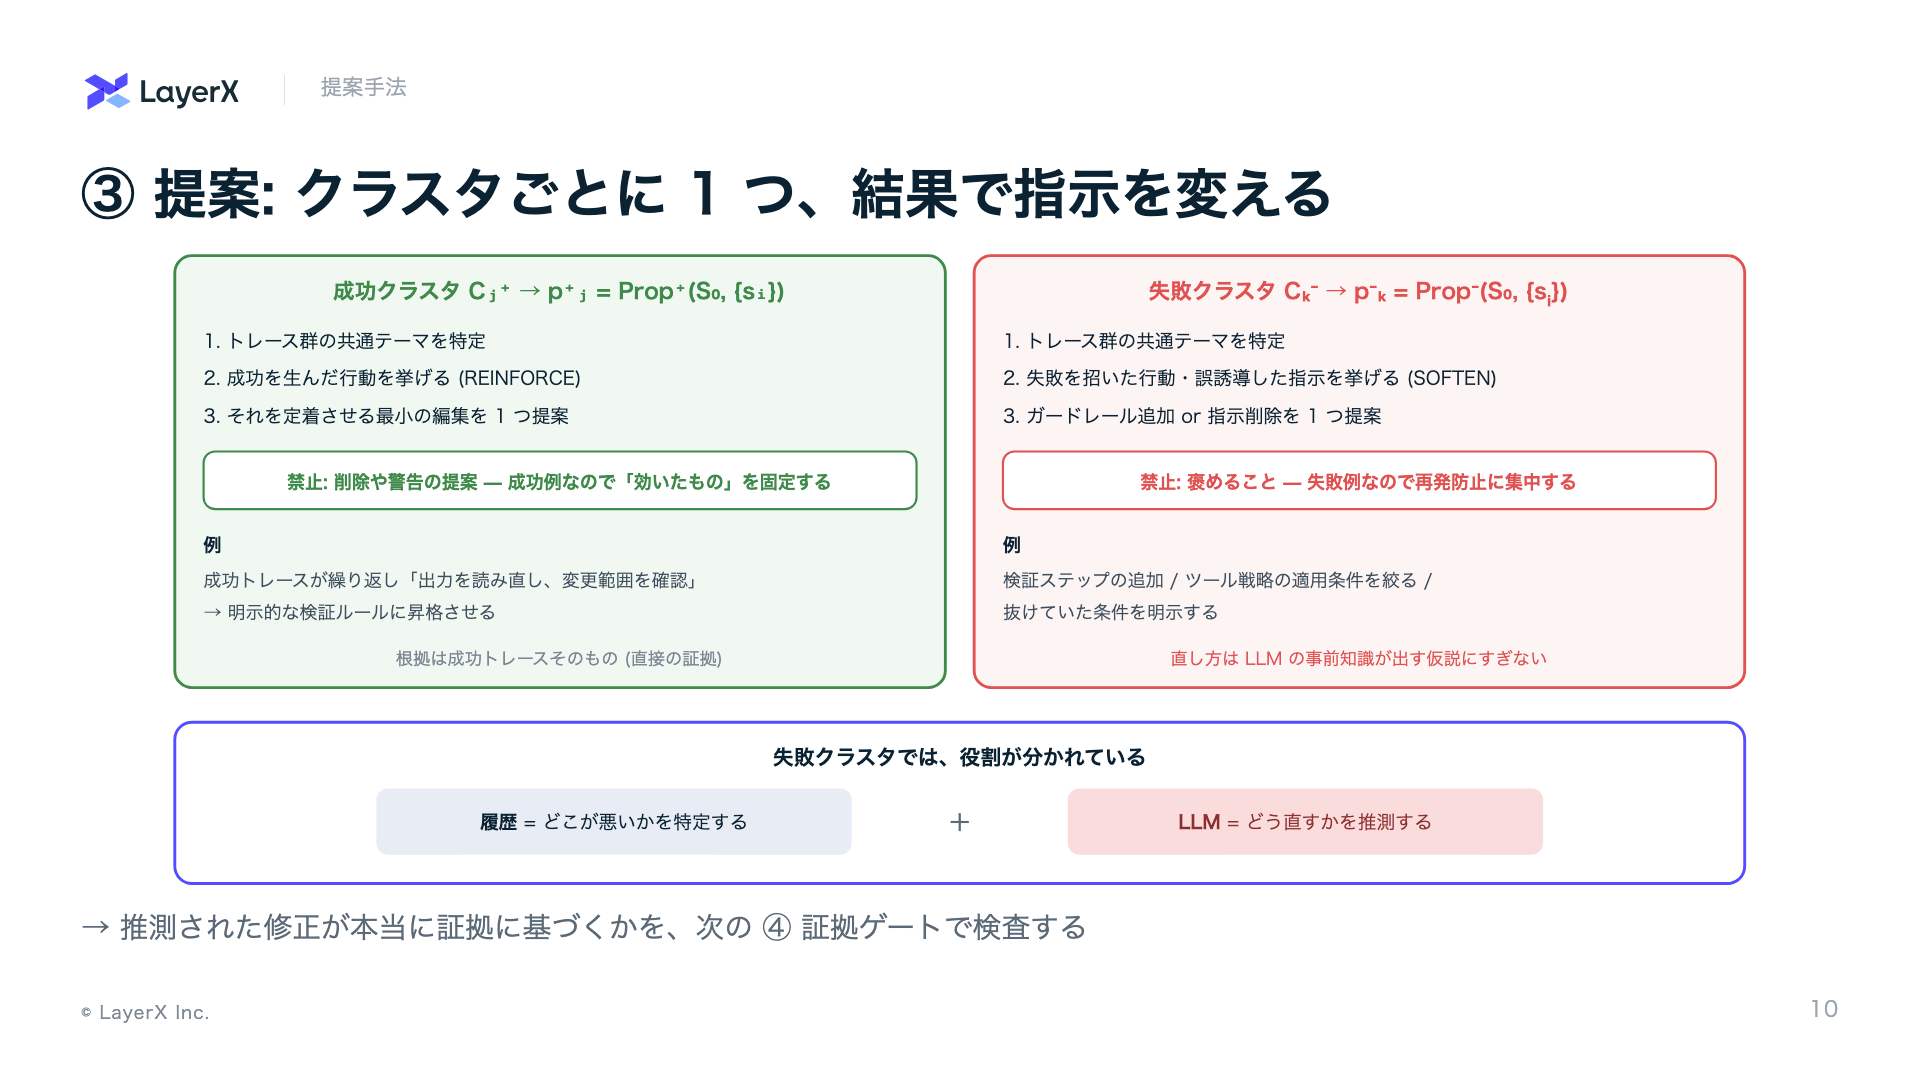
- 成功クラスタ: 効いた行動を挙げ、それを定着させる最小の編集を 1 つ提案する。削除や警告の提案は禁止
- 失敗クラスタ: 失敗を招いた行動や誤誘導した指示を挙げ、ガードレール追加か指示削除を 1 つ提案する。褒めることは禁止
- 失敗クラスタでは、履歴が「どこが悪いか」を特定し、LLM が「どう直すか」を推測する。この推測を次の証拠ゲートで検査する
手法の肝: 証拠ゲート
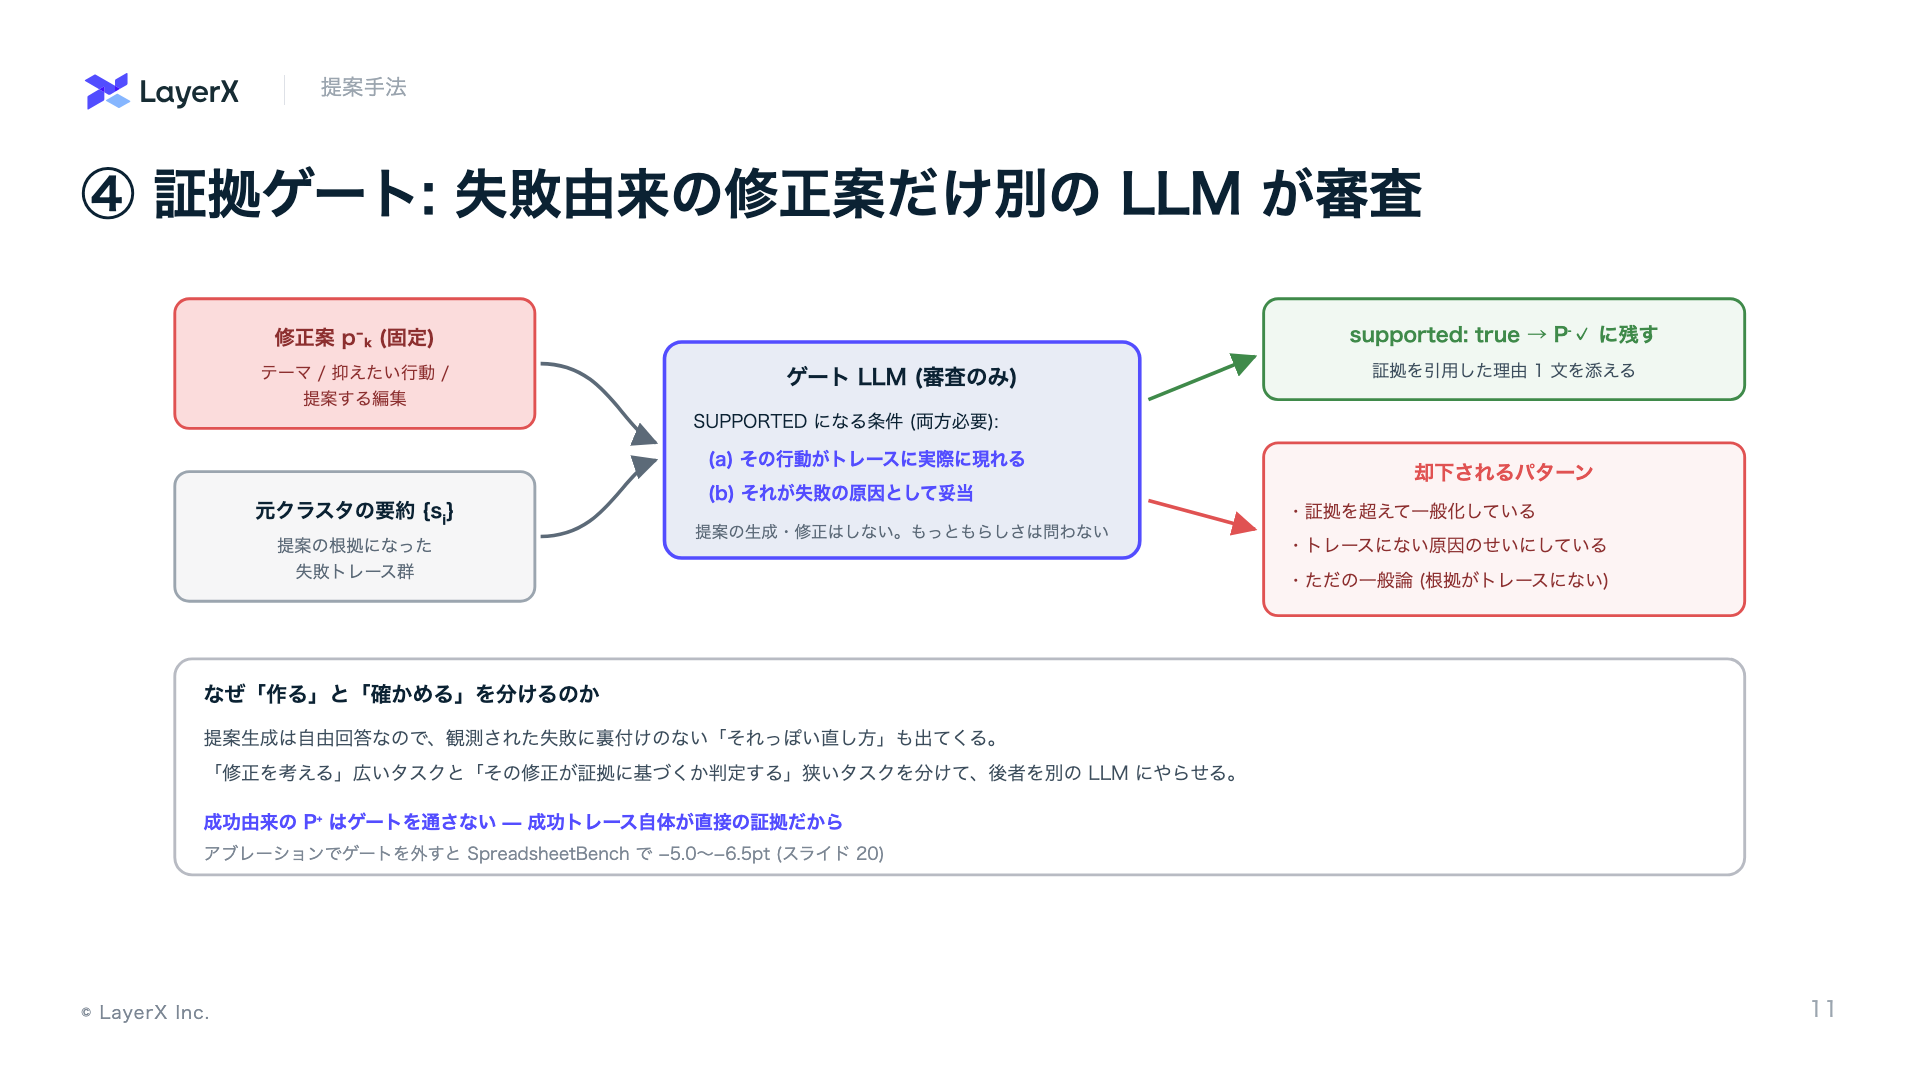
- 失敗クラスタでは「どこが悪いか」は履歴が示すが、「どう直すか」は LLM の推測にすぎない
- 別の LLM が、修正案の対象行動がトレースに実際に現れ、かつ失敗の原因として妥当かだけを審査する。一般論や証拠を超えた一般化は却下
- 成功由来の提案は成功トレース自体が証拠なのでゲートを通さない
結果: 性能
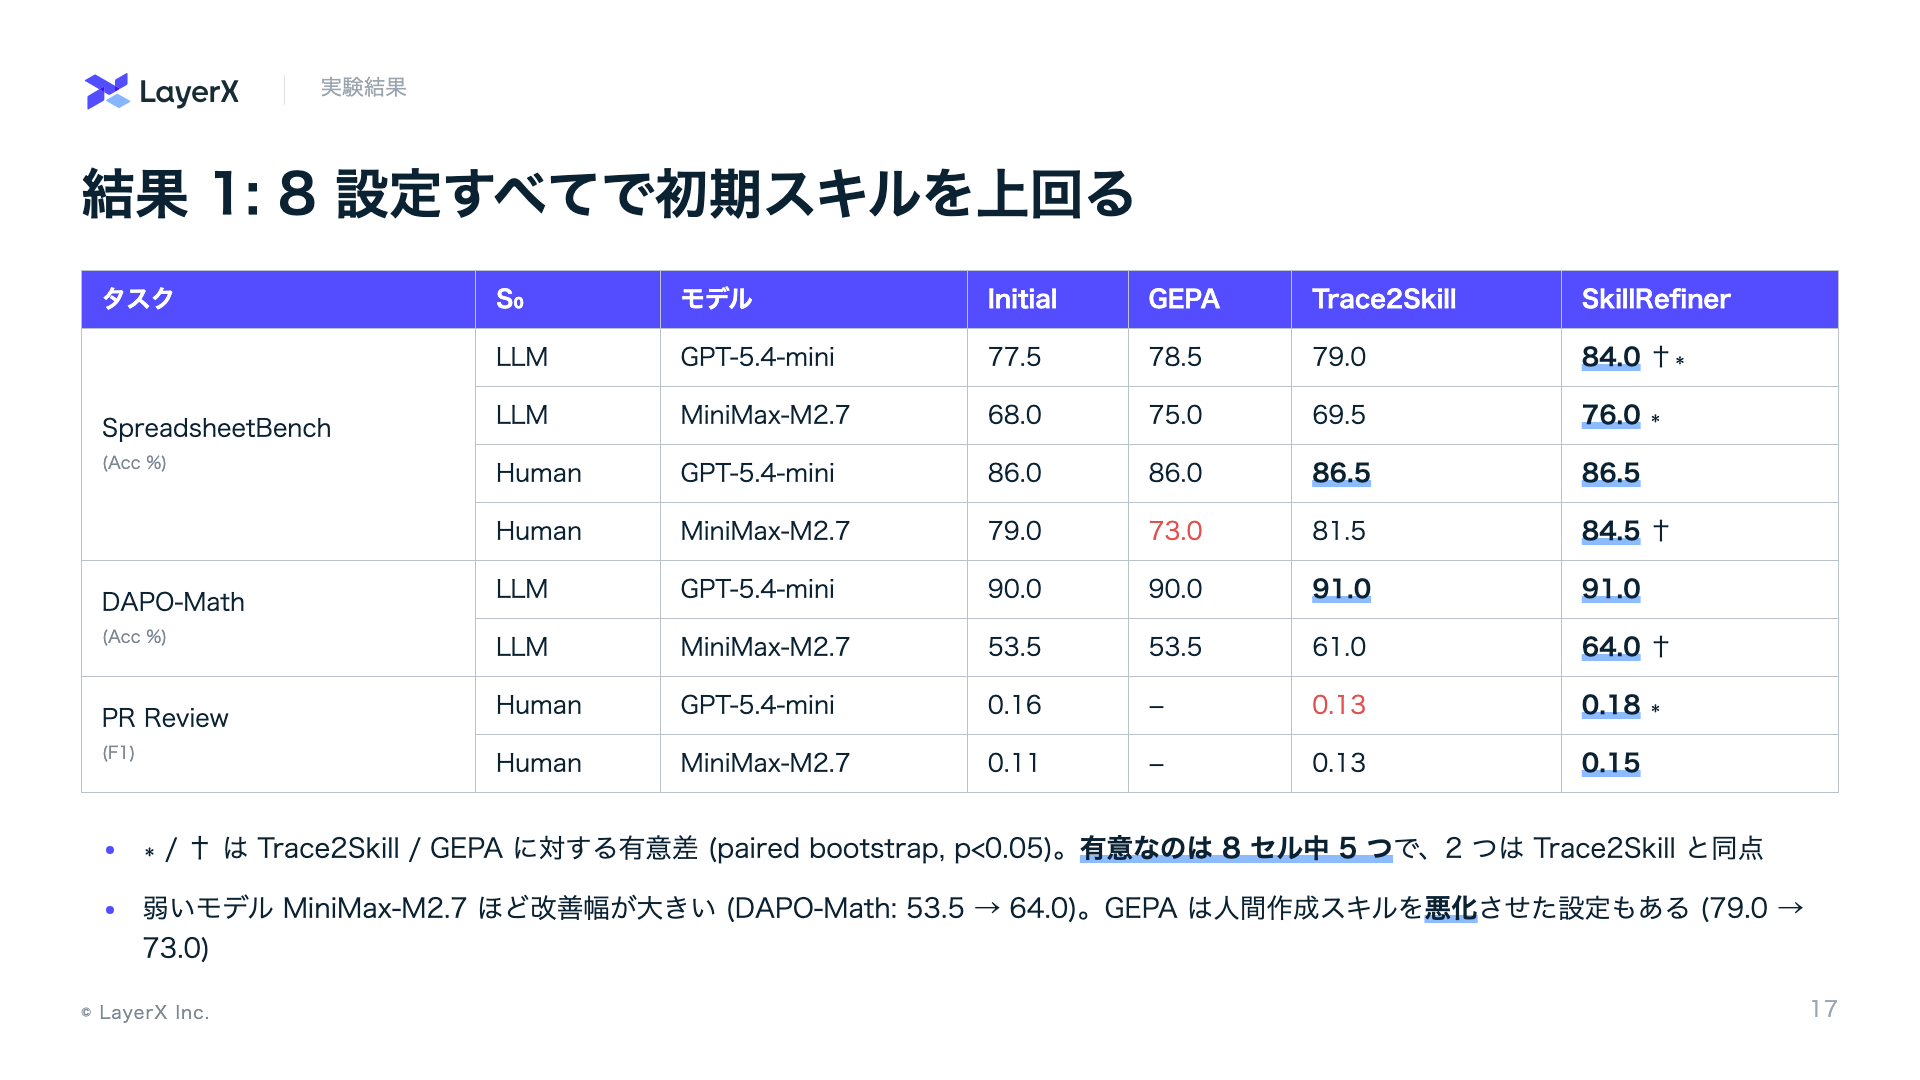
- SpreadsheetBench / DAPO-Math / 本番 PR レビューの 3 ドメイン × 2 モデル (GPT-5.4-mini / MiniMax-M2.7)
- 8 設定すべてで初期スキルを上回る。弱いモデルほど伸びる (DAPO-Math × MiniMax: 53.5 → 64.0)
- ただし有意差が付いたのは 8 つ中 5 つ。評価セットは 145〜200 件と小さい
結果: コスト
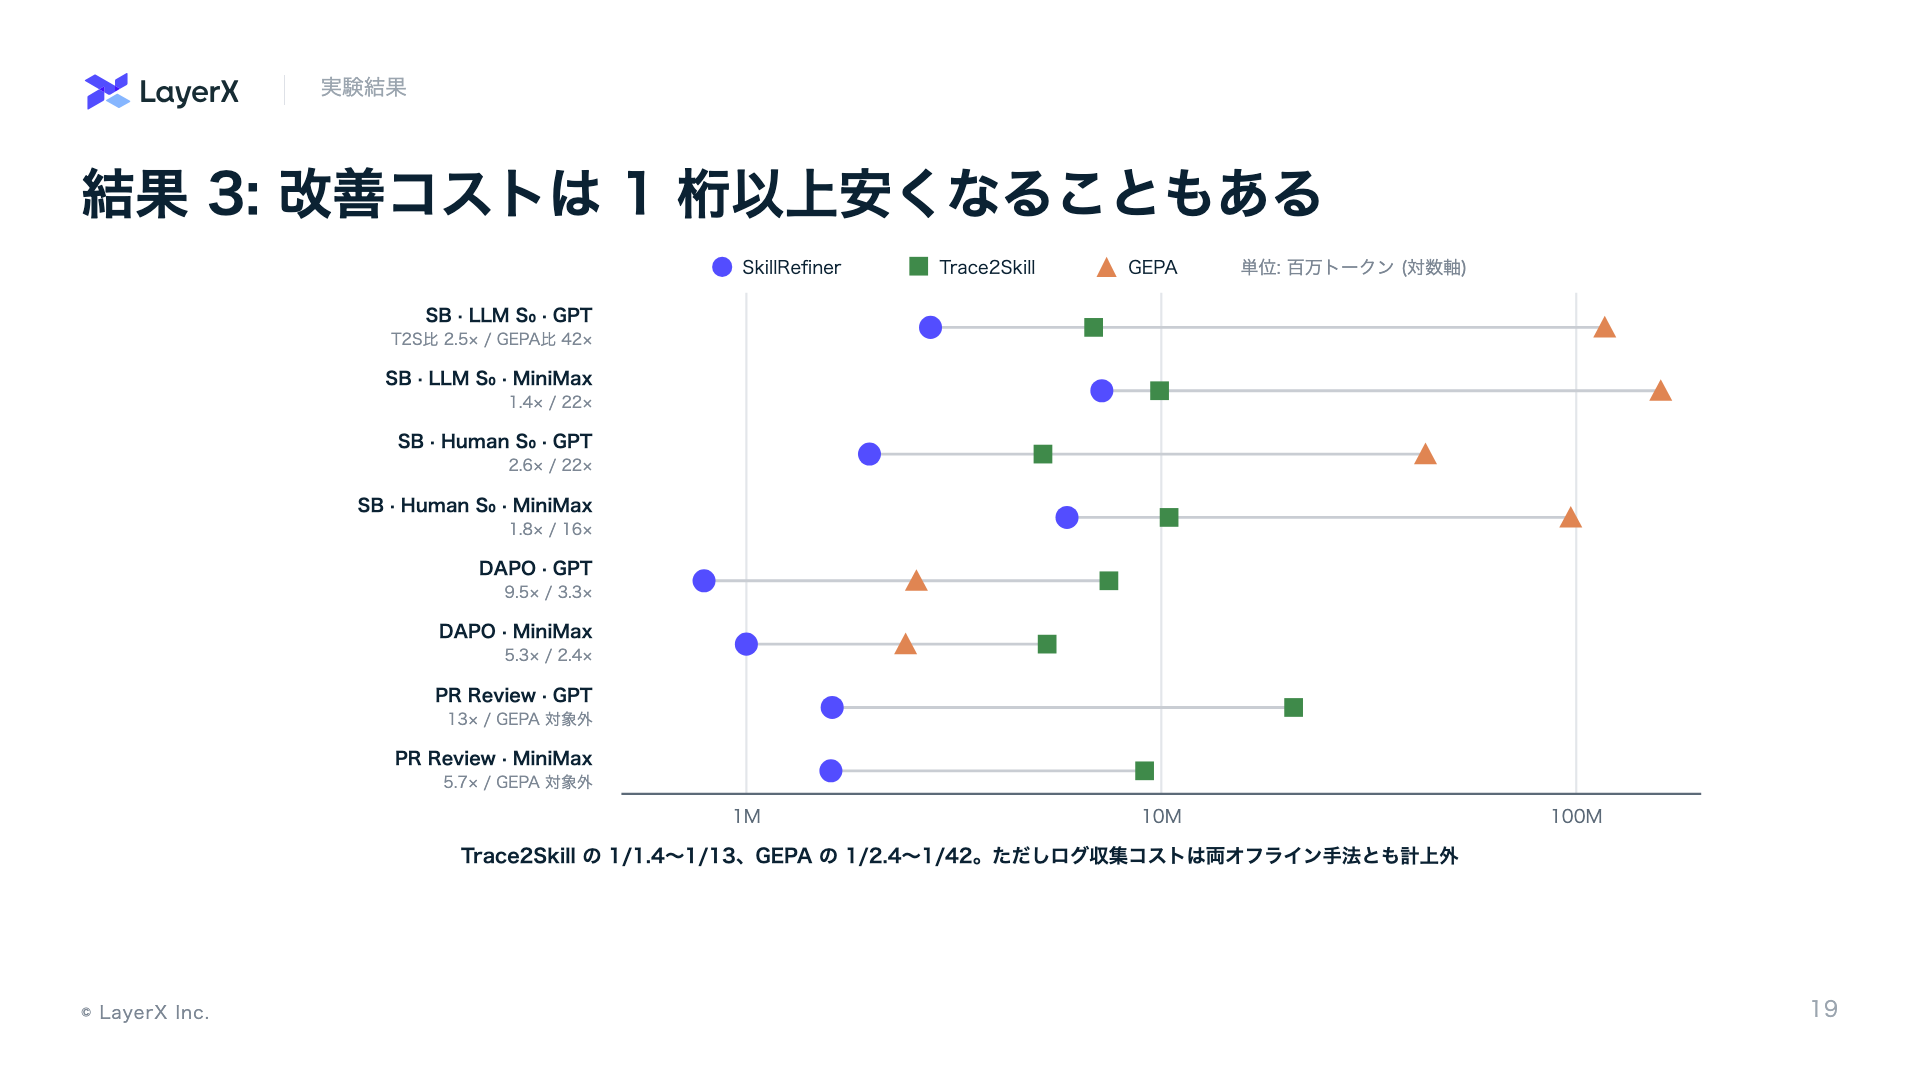
- 改善に使うトークンは Trace2Skill の 1/1.4〜1/13、GEPA の 1/2.4〜1/42
- ログ収集のコストは「既に払ったもの」として計上外。PR レビューは replay できないので GEPA は適用不可
アブレーション: 効いているのは失敗側
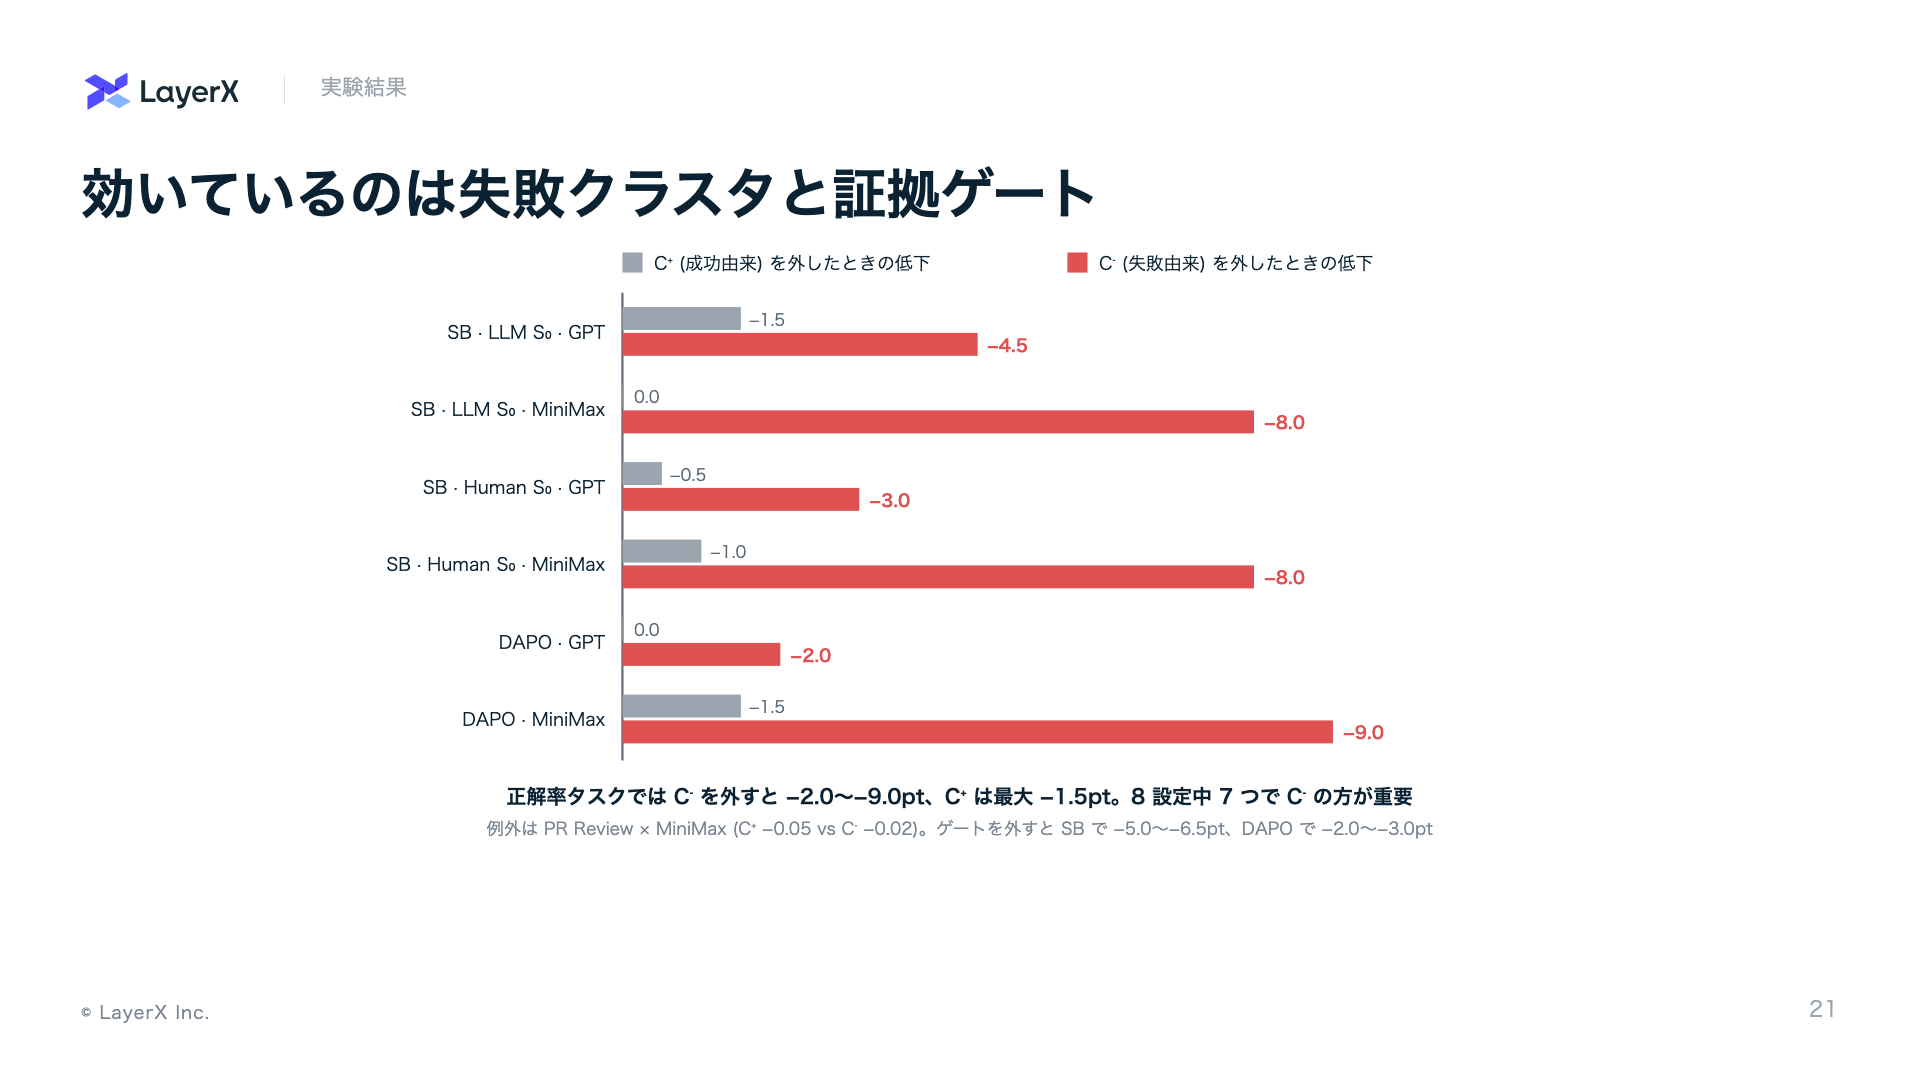
- 失敗クラスタ由来の修正を外すと正解率タスクで −2.0〜−9.0pt、成功クラスタ由来の強化を外しても最大 −1.5pt
- 証拠ゲートを外すと SpreadsheetBench で −5.0〜−6.5pt
具体例: 実際に見つかったクラスタと編集
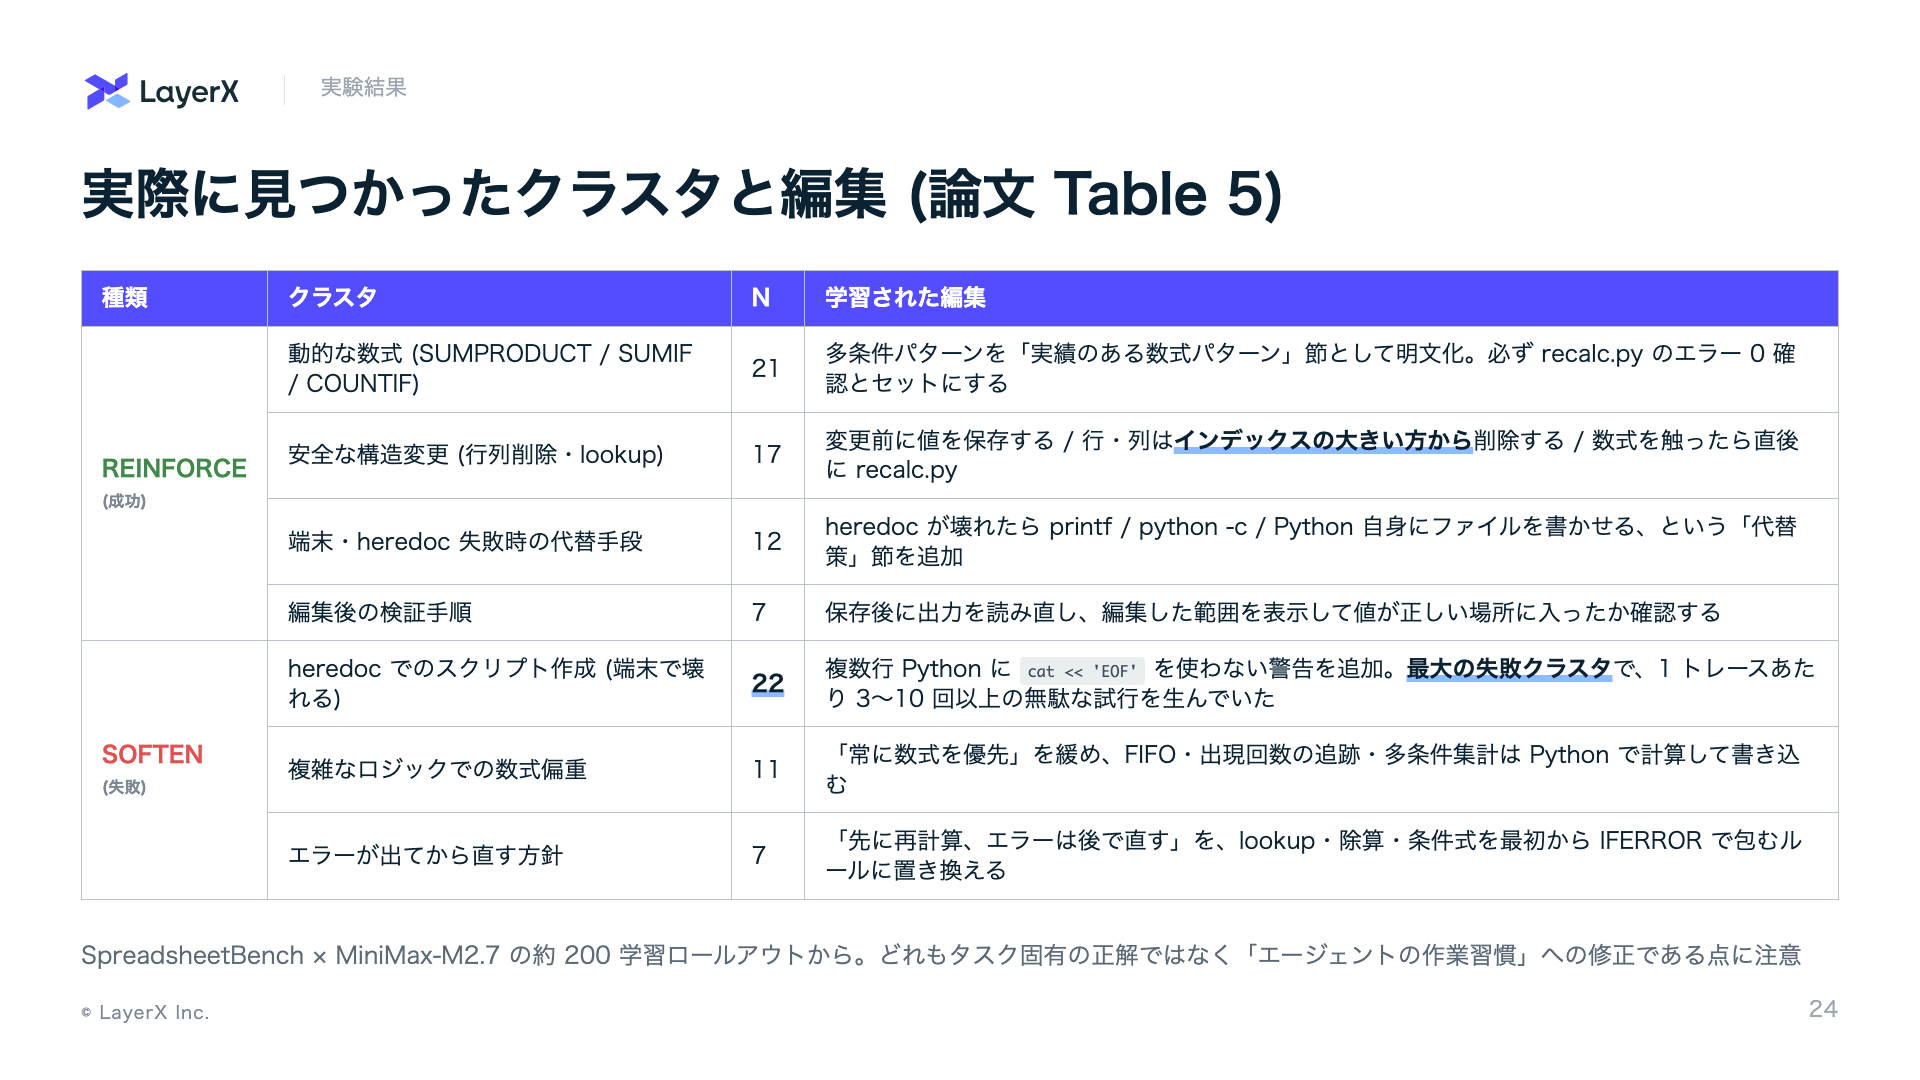
- SpreadsheetBench × MiniMax-M2.7 の約 200 件の学習ロールアウトから見つかったもの
- 最大の失敗クラスタ (N=22) は heredoc での Python スクリプト作成。端末でクォートや改行が壊れ、1 トレースあたり 3〜10 回以上の無駄な試行を生んでいた → を使わない警告を追加
- 「常に数式を優先」は FIFO・出現回数の追跡・多条件集計で壊れやすい数式の連鎖になる (N=11) → これらは Python で計算して書き込むよう条件を付けた
- 成功側からは「行・列はインデックスの大きい方から削除する」「保存後に出力を読み直して範囲を確認する」などが明文化された
- どれもタスク固有の正解ではなく、エージェントの作業習慣への修正になっている
所感
- 「replay できない」タスクの改善ループを、本番ログだけで回せる形にした点に価値がある
- 「修正案を作る LLM」と「証拠に基づくか確かめる LLM」を分ける構成と、「消すより条件を付ける」マージ方針は、承認ルールのように遅れて届くフィードバック (差し戻し等) からルールを直す場面にもそのまま使えそう
@Hiromu Nakamura (pon)
[blog] AutoBenchmark: benchmark creation & the role of humans
[pon] ベンチマーク作りたいよねぇ
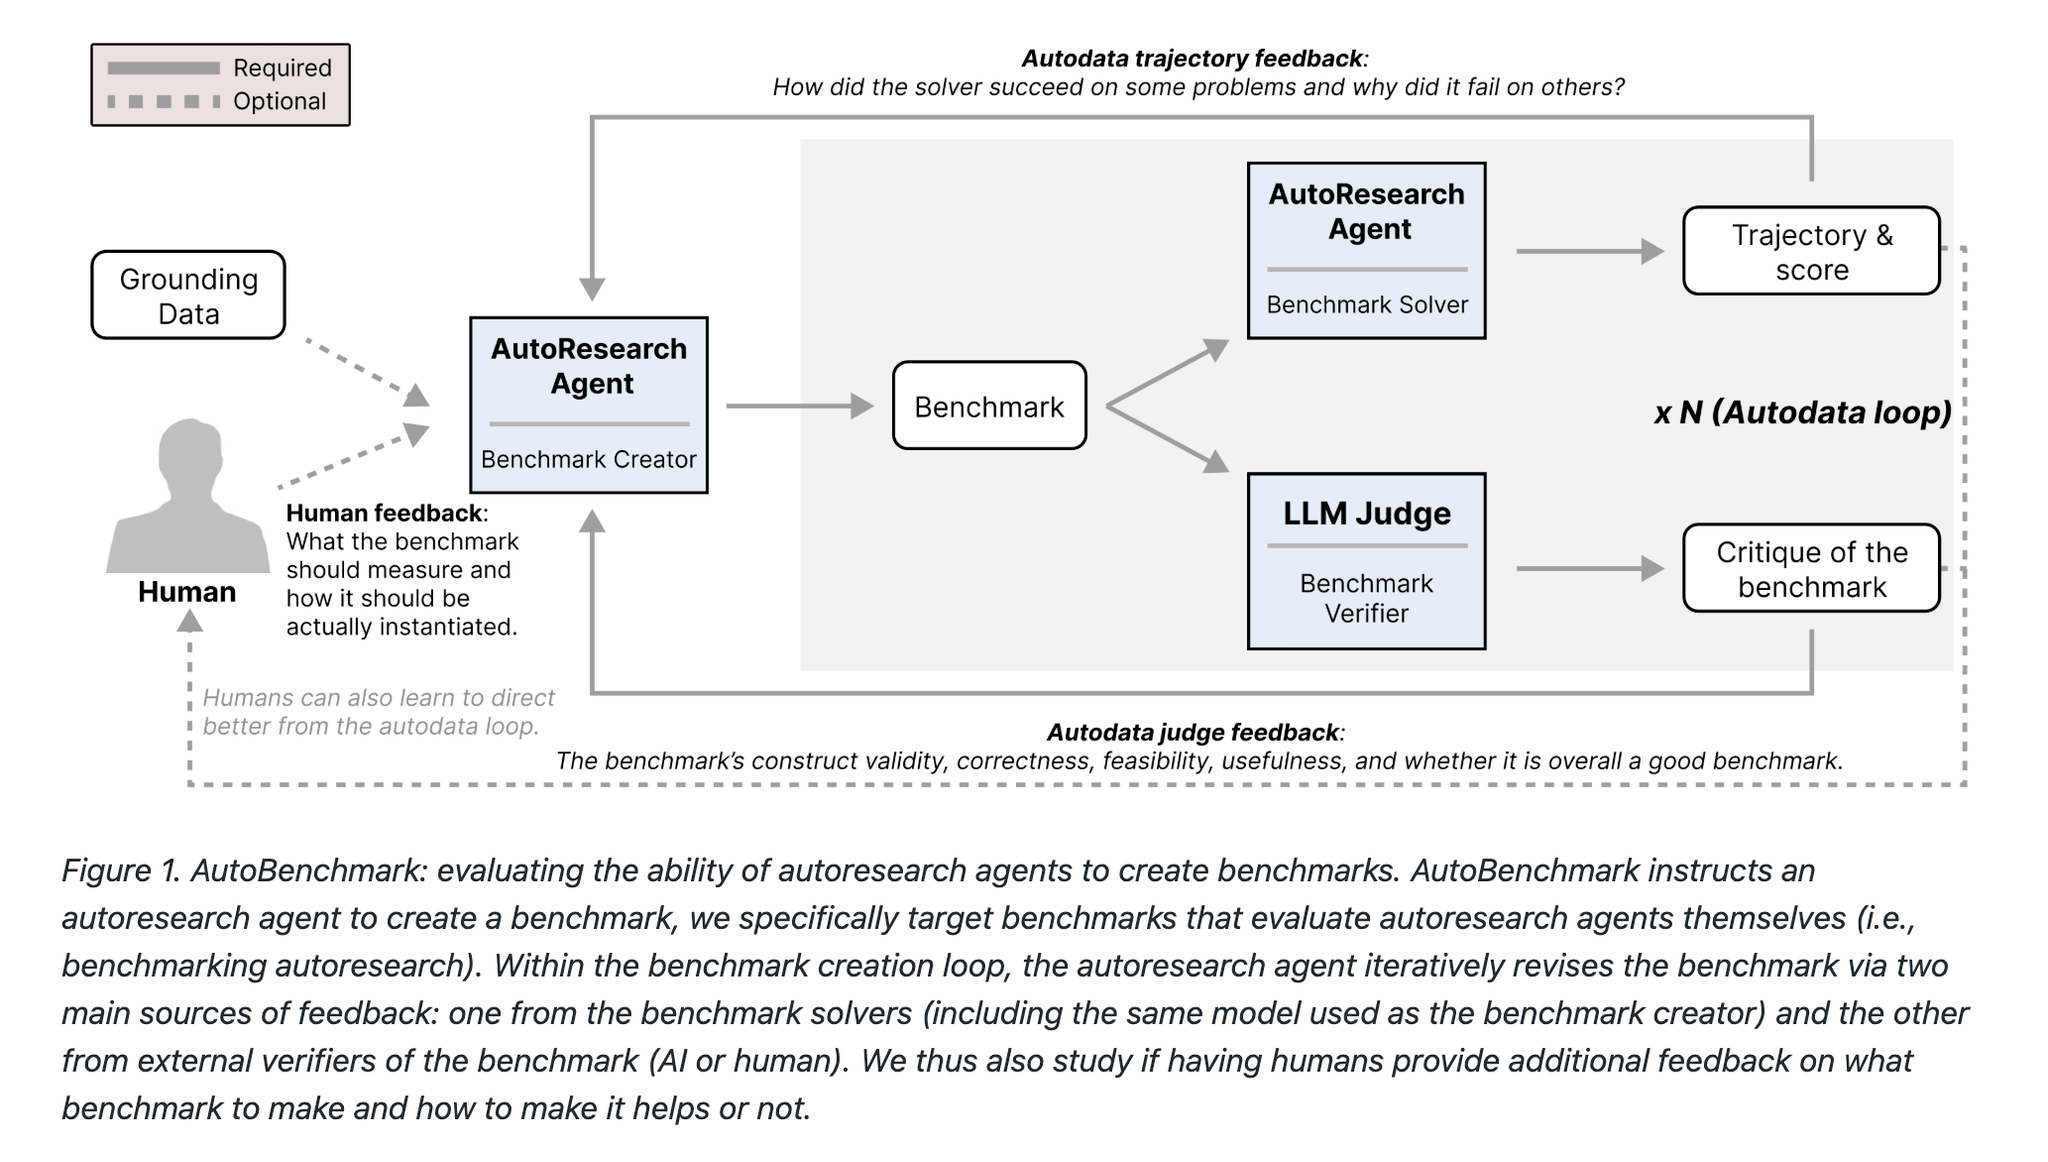
本論文では、autoresearch agentsが自律的にベンチマークを作成・改良するプロセスを評価するためのフレームワーク「AutoBenchmark」を提案している。
AIモデルが自身の能力を向上させる「Recursive Self-Improvement (RSI)」が注目される中、AIが自ら評価指標となるベンチマークを作成する能力は極めて重要である。本研究は、このプロセスにおけるAIの自律性と、人間のフィードバックが果たすべき役割を実験的に解明することを目的としている。
AutoBenchmarkは、研究エージェントがタスク仕様書から開始し、反復的なサイクルを通じてベンチマークを構築・修正する仕組みである。このプロセスは以下の3つのステージで構成される。
- Benchmark Proposal (ベンチマーク提案): 研究エージェントはタスクの定義、運用化、参照ソリューションの作成、および評価基準の策定を行う。ここでは、人間によるフィードバックの介入レベルを変えることで、生成されるベンチマークの質と難易度を制御する。
- Benchmark Solving (ベンチマーク求解): 構築されたタスクを複数のsolver agentsに解かせる。solverのtrajectoryとスコア(正解率)を収集し、難易度を測定する指標とする。スコアが飽和(100に近い)している場合、そのベンチマークはfrontierモデルの評価には不十分であると判断される。
- Benchmark Review (ベンチマーク評価): LLM judgeを用いて、Construct validity、Correctness、Feasibility、Usefulness、Overall verdictの5つの観点から生成されたベンチマーク自体を評価する。この審査を通過したiterationのみが、次世代のベンチマーク構築のベースとなる。
人間のフィードバックの重要性
本研究では、人間によるフィードバックを以下の4段階に分類し、実験を行った。
- (i) No feedback: 完全自律型。
- (ii) Coarse-grained human feedback: 目的の提示のみ。
- (iii) Fine-grained human feedback (Proposal stage): 詳細な仕様策定とGrounding materialの提供。
- (iv) Fine-grained human feedback (Proposal & Execution stage): 実行過程における継続的な指導。
実験の結果、完全自律型ではベンチマークが容易に飽和してしまうことが判明した。一方、Fine-grained feedbackを導入することで、solverのスコアを大幅に低下させ(例: 90から43.5へ)、より挑戦的かつ検証可能なベンチマークを作成できることが証明された。
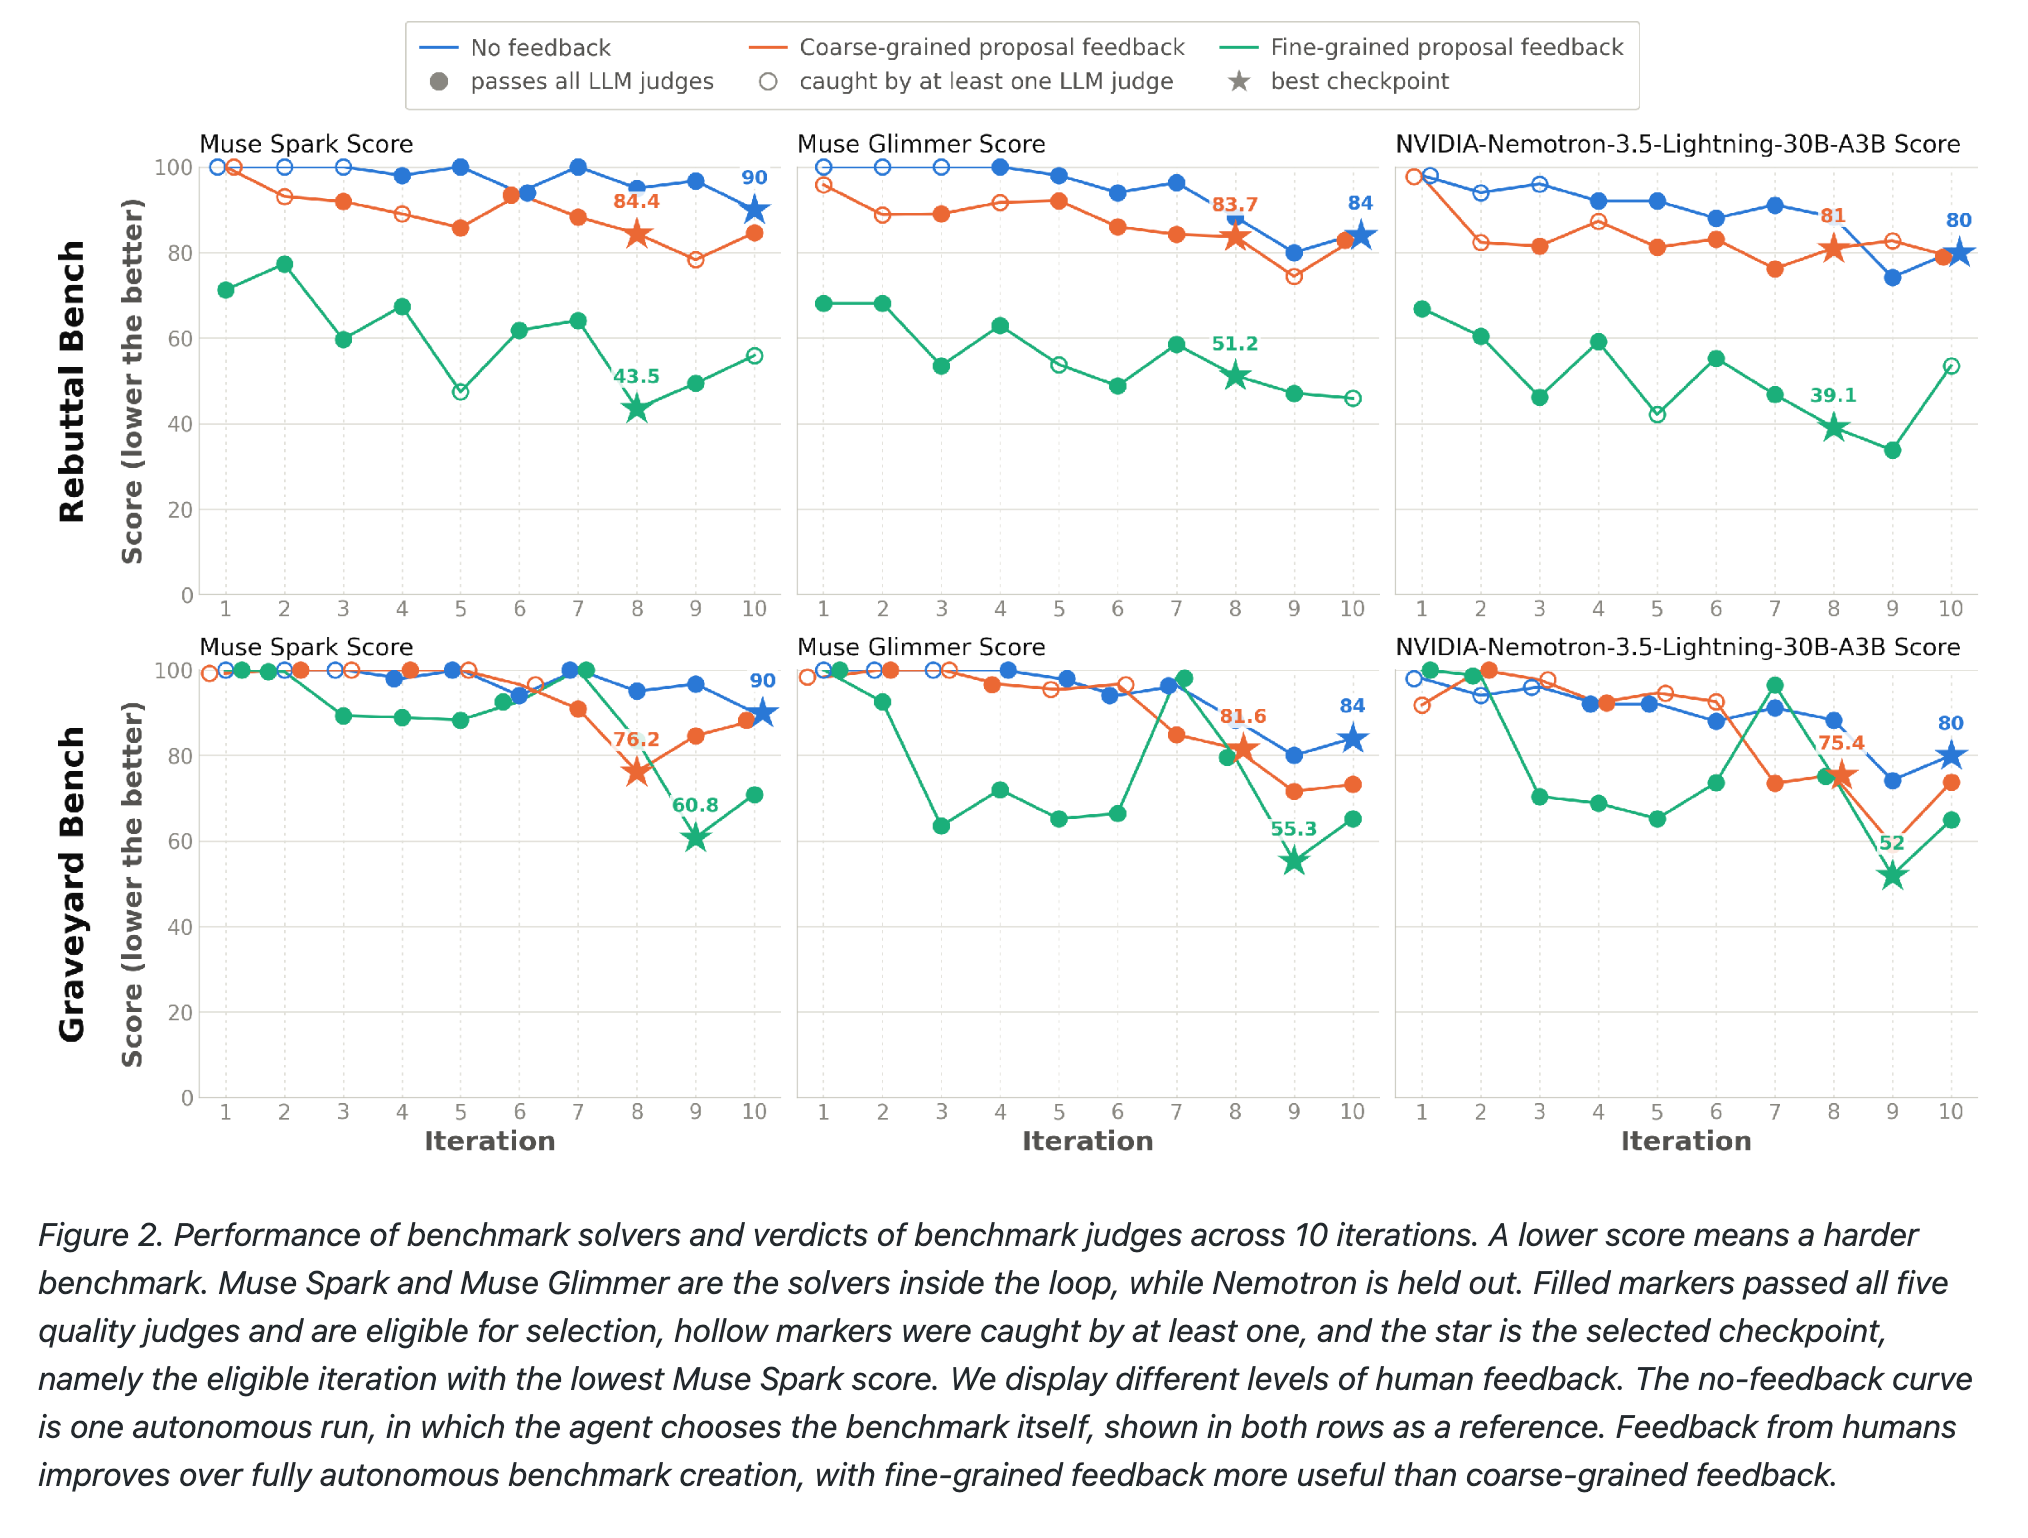
特に、実行過程が停滞した際、人間がinstantiation(具体化)の手順を指導することで、ループを再活性化させる効果も確認された。
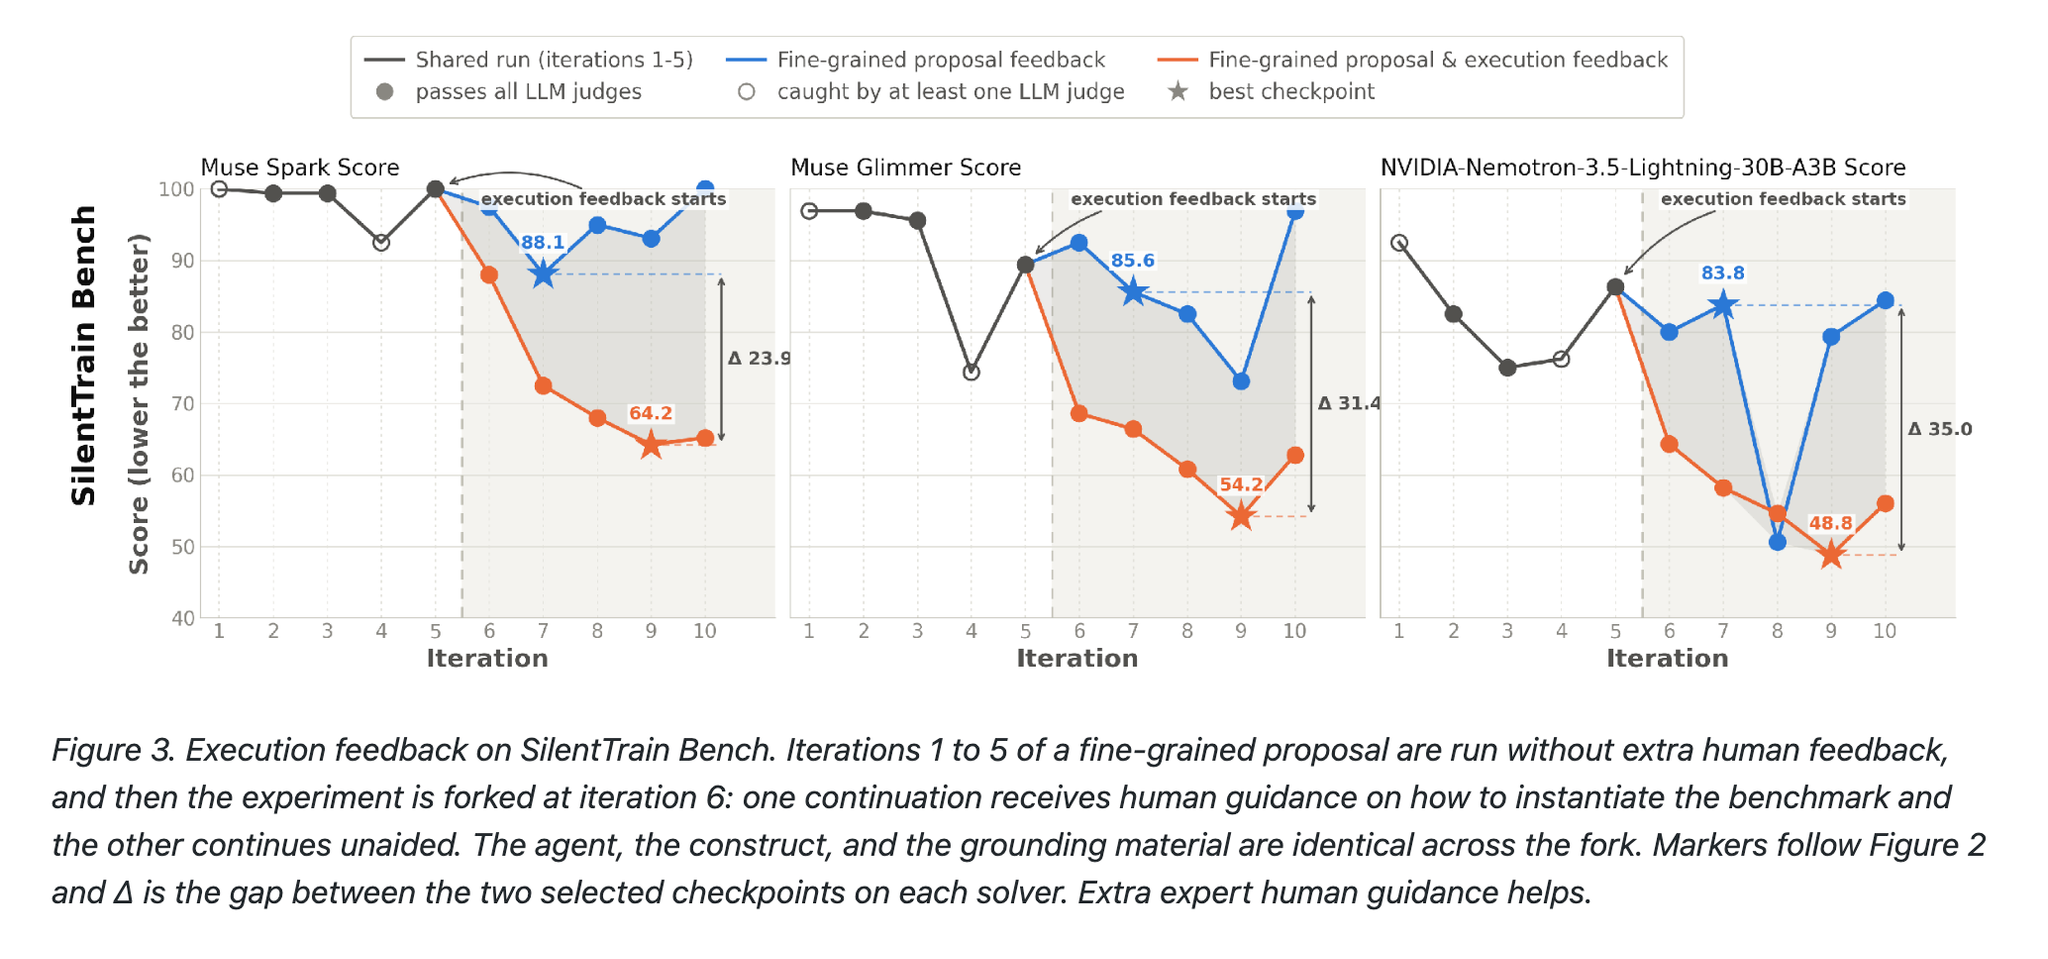
結論
現在のautoresearch agentsは、適切なガイドラインと反復の機会があればベンチマークを構築できるが、その限界を押し広げるには依然として人間による詳細な方向付けが不可欠である。結論として、以下の2点が重要である。
- 問題設定の具体性: 抽象的な目標よりも、詳細な仕様と素材提供がsolverのスコアを適切に抑制する。
- 実行過程への関与: エージェントが学習サイクルで行き詰まった際の「実行手法」に対する人間からのフィードバックは極めて有効である。
[pon] メソドロジー「人間」強い
@Koki Kobayashi
[paper] Context Language Models
背景
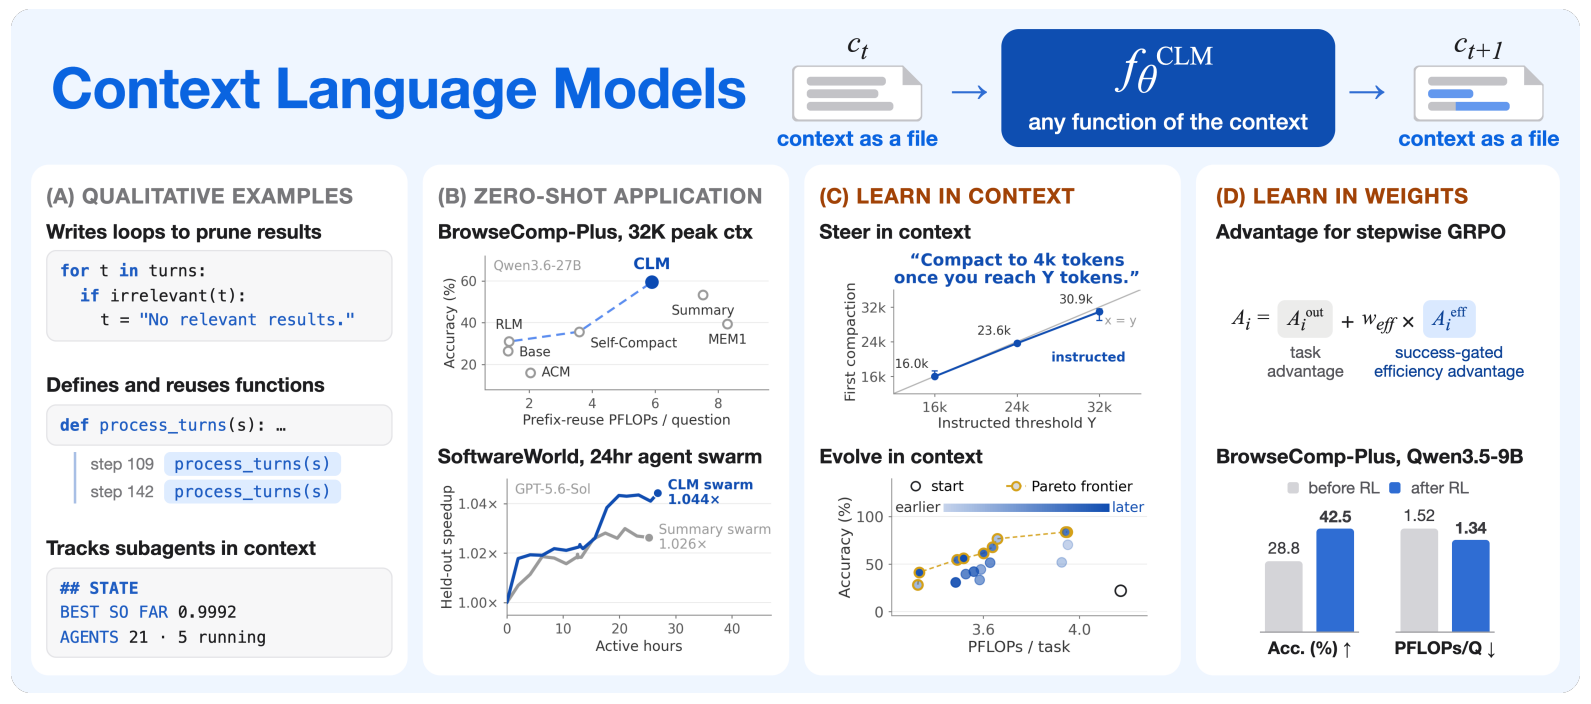
時間ホライゾンの長いタスクについて、エージェントのコンテキスト管理は Codex/Cursor のように一定の長さに達したら要約する方式や、 compaction / offload / retrieval と言ったツールをモデルに渡す方式が主流でした。
後者はモデルの自律性は増すものの、人間が定義したアクション空間の範囲にとどまる点が課題とされています。著者らは診断用の合成ベンチマーク ContextBench を作り、既存手法はどれも単純なタスクですら完璧にはこなせないことを確認したうえで、Bitter Lesson(参考:The Bitter Lesson)的に「モデルに全部任せる」方向を提案しています。
手法
通常のLMは文脈を のように追記していくだけですが、CLMは として次の文脈そのものを生成します。実装上は、ライブコンテキストを編集可能なファイルとしてミラーし、モデルはBashでそれを自由に書き換え、その編集が次ターンの文脈に自動で同期されます。編集しなかった場合は通常どおり追記されます。マルチエージェントの場合は、複数のコンテキストファイルを並存させるだけで対応できます。
これに加えて、以下の3つを提案しています。
- 文脈管理の方針を指示文やスキル文書で与え、それをプロンプト進化で最適化する方法
- RL:stepwise GRPOに「成功軌跡の中でだけ推論コストが低いものを優遇する」効率アドバンテージを加えたもの
- 推論サーバー向けのSuffix Cache Reuse(SCR):編集後も残ったトークンのKVキャッシュを再利用(編集前の prefix を見ているので stale だが近似として)し、RoPEを新しい位置に合わせて回転し直す仕組み
結果
- 学習なし(zero-shot)、Qwen3.6-27B、32K文脈の設定で、BrowseComp-Plusでは59.4%を記録し、最強ベースラインのCodex風要約を相対11.4%上回りつつ、FLOPsは21.5%少なく済んでいます。TerminalBench 2.1では同等の精度をFLOPs 70%で達成しました。
- 長時間タスクでは、12時間のEdgeBench-10で44.6(Codex風要約は42.3)、計算量は179 PFLOPs対437 PFLOPsでした。24時間のマルチリポ・エージェントスウォームでは同じ予算で65%大きい下流スピードアップを得ています。数学最適化でもOpenEvolveを4問すべてで上回りました。
- スキル進化ではContextBenchのheld-out精度が最大35.9ポイント向上しました。RLではQwen3.5-9BのBrowseComp-Plus精度が28.8%から42.5%に上がり、同条件で学習した要約ハーネスと同等の精度を、1問あたり1.34対2.19 PFLOPsで達成しています。
- 定性的には、サブエージェント管理用のスコアボードを作る、メモ用の新しいroleを作る、再利用可能なcompaction関数を定義するといった振る舞いが自発的に現れたと報告されています。
限界
論文自身が挙げている点は次のとおりです。
- 安全性:編集可能な文脈が、プロンプトインジェクションや自己生成した指示がターンをまたいで残る経路になりうる。
- 小型モデルの弱さ:9Bモデルは学習前だと文脈管理能力が足りず、要約ハーネスより6ポイント低かった。
- キャッシュの問題:文脈の途中を編集すると通常のprefix cacheが効かなくなり、再prefillのコストが発生する。SCRは編集前の文脈で計算した状態を流用するので、あくまで近似である。しかもSCRによる節約の多くは、CLMの編集ではなく推論トークンの除去に由来している。
Agent 自身に編集させるところは本質的だがそれを enable する技術としてのキャッシュのリユースと、近侍でもうまくいくところというところが驚き7
メインTOPIC
Less Context, Better Agents: Efficient Context Engineering for Long-Horizon Tool-Using LLM Agents
Abhilasha Lodha, Mahsa Pahlavikhah Varnosfaderani, Abir Chakraborty, Abhinav Mithal(Microsoft)。arXiv:2606.10209、2026 年 6 月 8 日投稿
一言でいうと: ERP(Dynamics 365 Finance and Operations)の経費明細化を、MCP ツール経由でエージェントにやらせた論文です。会話履歴を全部持たせるより、「直近 5 回分のツール呼び出しだけ残し、捨てた分は短く要約する」方が、完了率は 71% から 92% に上がり、トークンは 63%、実行時間は 60% 減りました。古い文脈は冗長なだけでなく有害だ、というのが著者の主張です。
なぜこの論文を選んだか: 題材が経費精算の明細分割という、バクラクの業務そのものだからです。手法は数十行で実装でき、既存のエージェントループに今日からでも入れられます。一方で「本当に効いているのは何か」「ツール設計で先に潰せないか」「コストの主張はプロンプトキャッシュを無視していないか」と突っ込みどころも多く、議論向きです。
1. Introduction
1.1 背景: ツール応答がエージェントの文脈を食い潰す
LLM エージェントが ERP のような業務システムをツール経由で操作すると、ツール応答が非常に冗長になります。フォーム全体の状態スナップショット、フィールドのメタデータ、パンくず、システム情報など、意思決定には関係のない情報が大量に返ってくるためです。
- ※ いい感じに設計されたAPI/RPCがなく、毎回画面全体の情報を送られたり、そのタスクの遂行には不要なメタデータが含まれたりしている状態を想定している。
- 1 回のツール応答が 500〜3,000 トークンに達し、1 タスクで 15〜30 回呼ぶと合計は 5 万〜15 万トークンを超えます
- 大きな文脈窓を持つモデルでも、タスク完了前に使い切ることがあります
- 推論コストは文脈長に比例するので、全履歴を保持する作りは本番規模では高くつきます
- 上限に達する前から、トークンが増えるほど想起精度が落ちる現象も知られています(Anthropic のブログでいう context rot)
1.2 対象業務: 経費明細化(expense itemization)
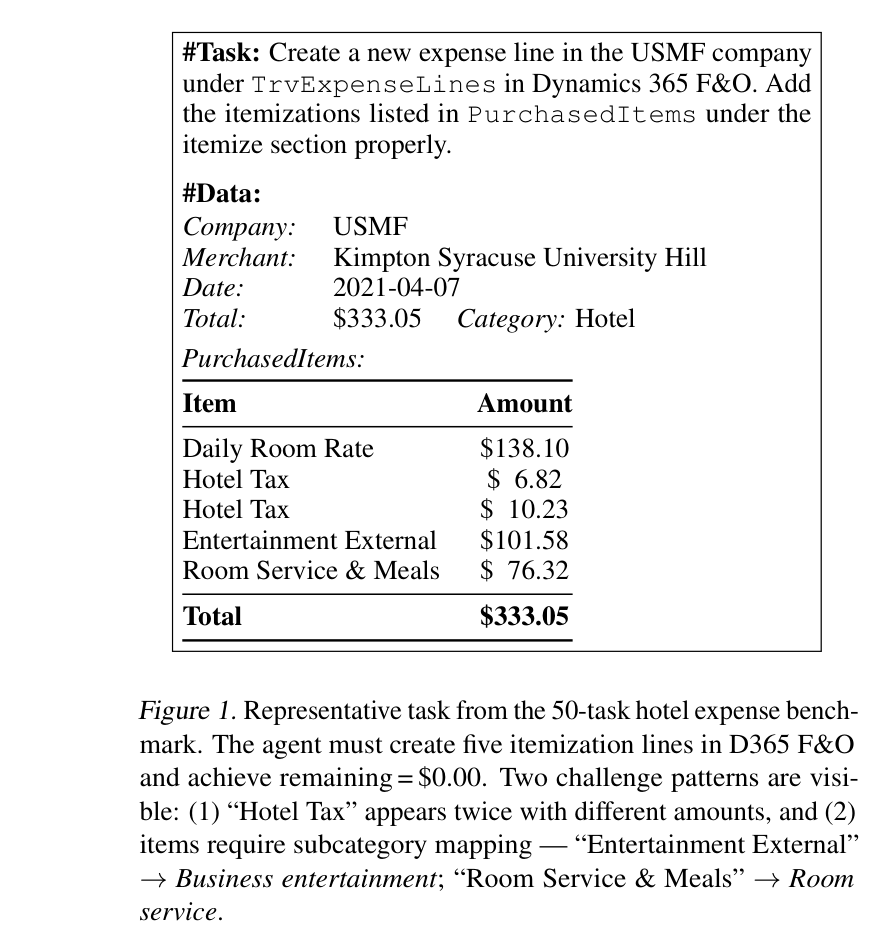
領収書 1 枚(例: ホテル 333.05 ドル)を、ERP の経費行に対して明細行に分解して登録する業務です。
- 各明細行に、サブカテゴリ(Room charge、Room tax、Resort fee、Breakfast など)と金額を入れます
- 残額(remaining)がちょうど 0.00 になったときだけ完了とみなされます
- 1 セントでも残ると経費報告を確定できず、コンプライアンス審査に回ります
- つまり部分完了は、業務上は「失敗」です
- 難しいのは次の 2 点で、どちらも図の例に含まれています
- 同じ名前で金額の違う行が繰り返されること(Hotel Tax が 6.82 ドルと 10.23 ドル。3 泊なら Room も 3 行)。「もう入れた」と思って飛ばすと残額が残ります
- 領収書の項目名を、ERP の 23 種類の固定語彙に写像すること(Entertainment External → Business entertainment、Room Service & Meals → Room service)。Room tax と Non-Room tax、Restaurant と Room service と Lounge bar のような紛らわしい語があります
1.3 貢献
- ツール呼び出しと応答のペアを単位にした、意味レベルの文脈ポリシー(直近を残す刈り込み + 追い出した分の要約)を Algorithm 1 として明示したこと。トークンレベルの圧縮や外部記憶とは別物だと位置づけています
- 50 タスクのホテル経費ベンチマークで、ユーザーモデルを固定した比較により、完了率が 71.0% → 79.0% → 91.6% と上がり、トークンが 62.7%、実行時間が 60.2% 減ったこと
- run 間の分散、95% 信頼区間、保持窓 N と要約窓 W の感度分析を報告したこと
- 失敗を 6 種類に分類し、3 つの経費カテゴリと 2 つのモデル系統(Claude Sonnet 4.5)で一般化を確かめたこと
2. Related Work
著者は先行研究を 3 つの軸で整理し、自分たちの手法を「ツール呼び出しと応答のペア」を単位にする点で区別しています。
| アプローチ | 単位 | 本論文との関係 |
|---|---|---|
| LLMLingua / Selective Context | トークン | プロンプト内の低情報トークンを削る。フォーム状態(コントロール名や金額)を壊す恐れがある |
| MemoryBank / LongMem、LoCoMo / LongMemEval | 外部記憶 | 複数セッションにまたがる事実の想起が対象。単一セッション内の「古い状態」の問題とは別 |
| ACON(Microsoft Research、ICML 2026) | 軌跡 | 失敗分析から圧縮ガイドラインを学習し、小さいモデルに蒸留する。本論文は「学習しない固定窓」で十分だと示す |
| Context as a Tool(2025 年 12 月) | 軌跡 | 圧縮をエージェントが呼ぶツールにする。SWE-bench Verified で 57.6% |
| Anthropic の compaction / tool result clearing | ツールペア | プロダクト機能として同じ発想。本論文の W=−1(全履歴要約)が compaction に、C3 が tool result clearing に相当する |
| MCP-Bench | ベンチマーク | 幅広いツール群を評価する。本論文は 1 つの業務を深く、コストまで測る |
3. Methodology
3.1 システム構成
| 部品 | 役割 |
|---|---|
| Agent LLM(GPT-5) | 詳細なシステムプロンプトを持つ。手順、23 種のサブカテゴリ一覧、写像規則(Hotel Tax → Room tax など)、「残額 0 まで止まらず続けろ」という指示 |
| User model(GPT-4.1) | エージェントの確認質問に答える「ユーザー役」。完了プロトコル(行が保存済み、残額 0.00、フォームを閉じた)を持ち、添付要求は断り、完了確認を促す。C2〜C4 のみ |
| D365 F&O MCP server | フォーム操作 13、OData エンティティ操作 6、カスタム API 2 の計 21 ツール |
| 評価ハーネス | 非対話で人間不在。文脈ポリシーの適用と計測を担う |
D365 F&O MCP serverのツール(Appendix B)
具体的なツール一覧は記載なし。できることベースで記載あり。人間がGUIを操作する際の処理ごとにツールが準備されているイメージ。
- フォームとタブの遷移(経費報告の詳細フォームを開く、Itemization タブに切り替える)
- メニュー項目とコントロールの探索(画面上にどのボタン・入力欄があるかを列挙する)
- コントロール値の読み取りと設定(Amount 欄に金額を入れる、Description を書く)
- ルックアップを開く(SubCategory の選択肢一覧を開いて選ぶ)
- グリッドのフィルタ・ソート・行選択(明細グリッドで対象行を選ぶ)
- コントロールのクリック(「Itemize」「Add line」「Save」ボタン)
- フォームの保存
3.2 4 つの構成
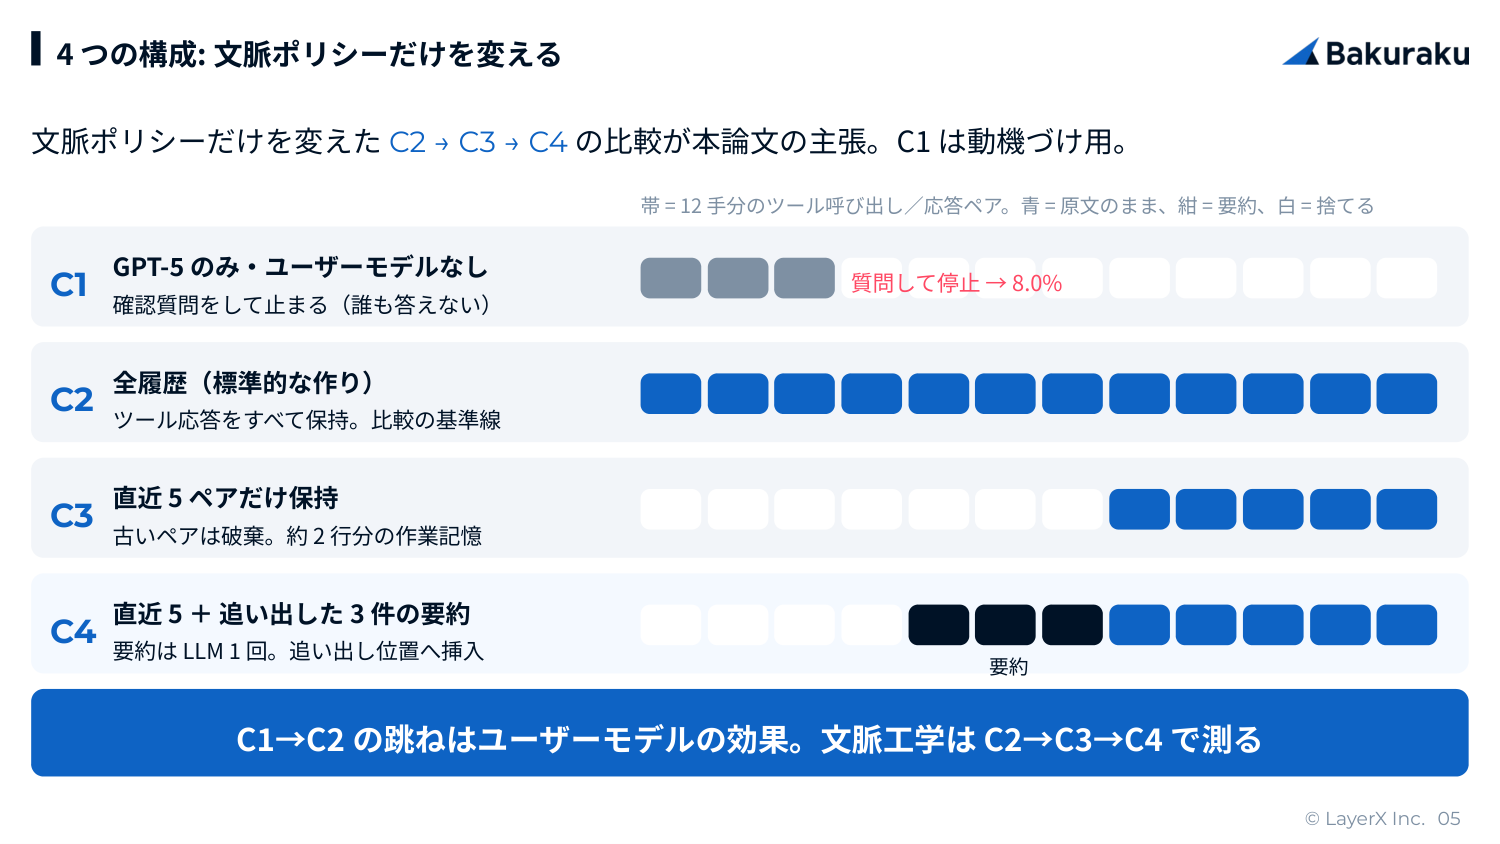
比較するのは次の 4 構成。図の帯は 12 回ツール呼び出しを行った際の状況を表し、青は原文のまま保持、黒は要約して保持、白は捨てることを示します。
- C1: GPT-5 のみで、ユーザーモデルなし
- GPT-5 は途中で確認質問をして止まることがあり、非対話のハーネスでは誰も答えません
- (やたら低いなとは思った。まあハーネスなしならこんなものだったか。)
- そのため C1 は文脈工学の比較には使わず、ユーザーモデルが必要な理由を示す ablation として扱われています
- C2: ユーザーモデルあり、全履歴を保持
- 標準的な作りで、文脈比較のベースラインです
- C3: 直近 N=5 ペアだけを保持し、古いペアは捨てる
- 1 行の登録に 2〜3 回のツール呼び出しが要るので、5 ペアは約 2 行分の作業記憶に相当します
- C4: C3 に加えて、追い出した直近 W=3 件を LLM 1 回で要約し、追い出した位置に挿入する
- 要約は「開いたフォーム、触ったコントロール、押したボタン、入れたデータ」の箇条書きです
3.3 Algorithm 1: ConstructContext
毎回の推論の直前に、元の全履歴 H から今回渡す文脈 K を作り直します。履歴そのものは捨てません。
論文の Algorithm 1(原文)
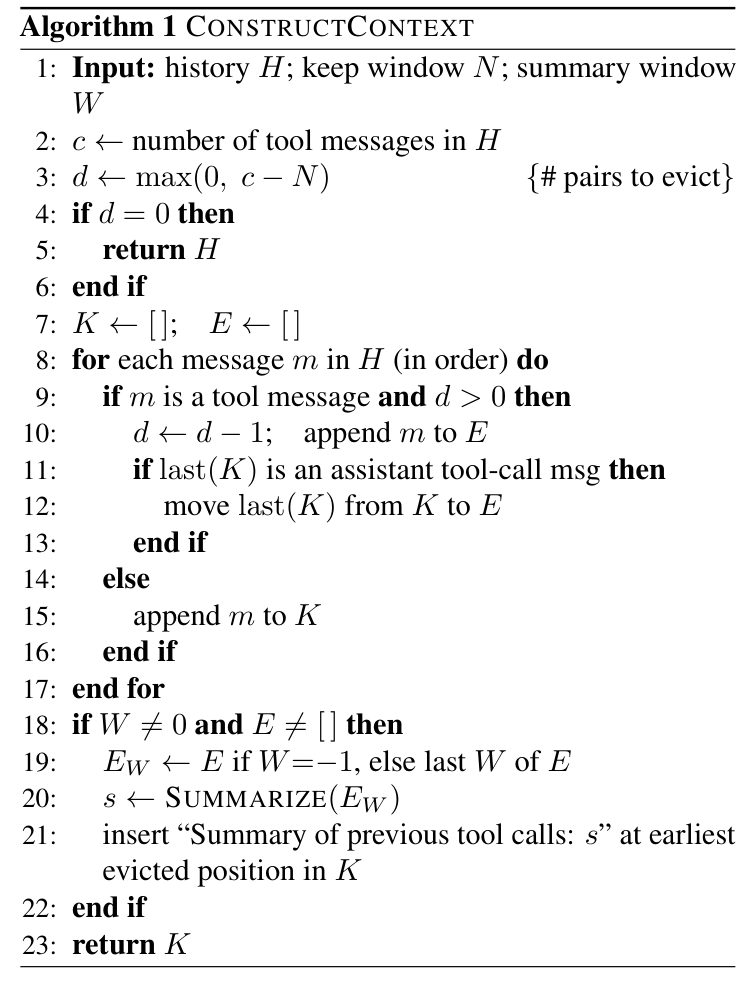
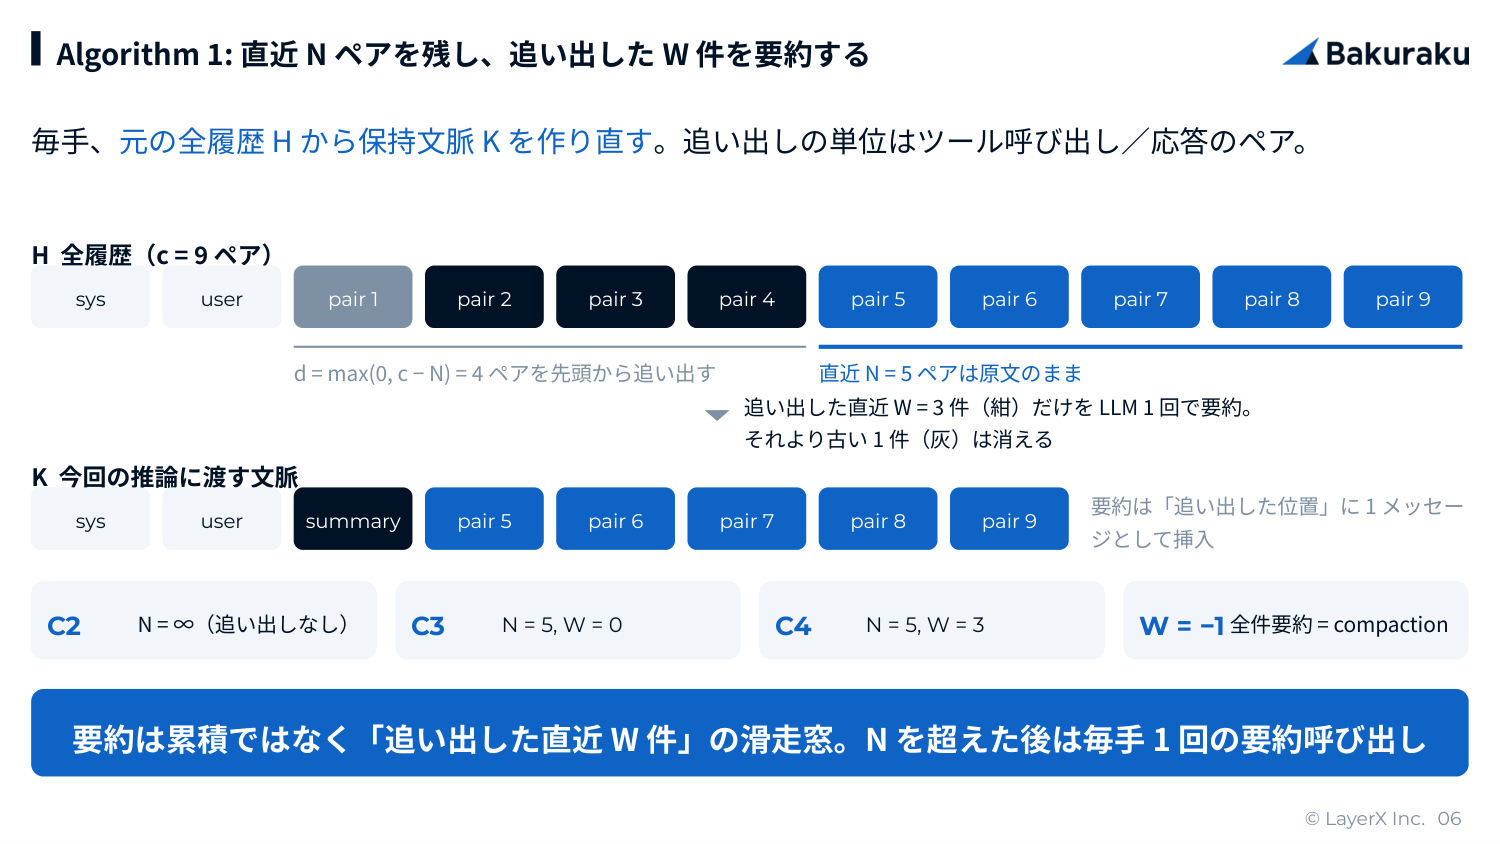
- 各構成はパラメータの違いとして表せます
- C2 は N=∞(追い出しなし)、C3 は N=5 かつ W=0、C4 は N=5 かつ W=3
- W=−1 は追い出した全件を要約する設定で、Anthropic の compaction や ACON に近い比較対象です
- 要約は「追い出したペアのうち直近 W 件」だけを対象にするスライディングウィンドウ(追い出しが進むと対象もずれていく固定幅の範囲)で、累積ではありません
- §3.3 に "the 3 most recent interactions prior to the pruning boundary inform the generated summary" とあります
- それより古い履歴は完全に消える
- 要約の LLM 呼び出しは、N を超えた後は毎ステップ 1 回発生します
- W の単位は論文が曖昧です
- Algorithm 1 は E(追い出したメッセージ列)の末尾 W 件、つまりメッセージ単位(約 1.5 ペア)と読めます
- §3.3 の "3 most recent interactions" はペア単位とも読めます
- 本資料とデモはペア単位と解釈しました
3.4 評価指標
- Completely Itemized(主指標): 残額がちょうど 0.00 になったタスクの割合
- [yu] 内容は見てないように読めた。たとえば内訳・勘定科目的なものの誤分類は見ていなさそう。Appendixでは、「分類間違ったら金額もミスるから」とか書いてたけど、そんなことなくね?
- 補助指標として、残額 10% 未満の割合、1 行以上登録できた割合、金額の充当率
- コストとして、総トークン(エージェントとユーザーモデルの合計)と時間
- 50 タスク × 5 run で、run 単位の平均 ± 標準偏差(t 分布、自由度 4)と、250 試行をプールした Wilson 区間の両方を報告しています
3.5 データセット
- ホテル領収書 50 件。1 件あたり 4〜23 行で中央値は 8 行。同じ 50 件を 4 構成すべてで使います
- 追加検証として Travel(レンタカーと航空券、30 件)と Meals & Gifts(32 件)があります。こちらは語彙が小さく、繰り返しもまれです
4. Experiments
4.1 主結果(ホテル 50 タスク、5 run 平均)
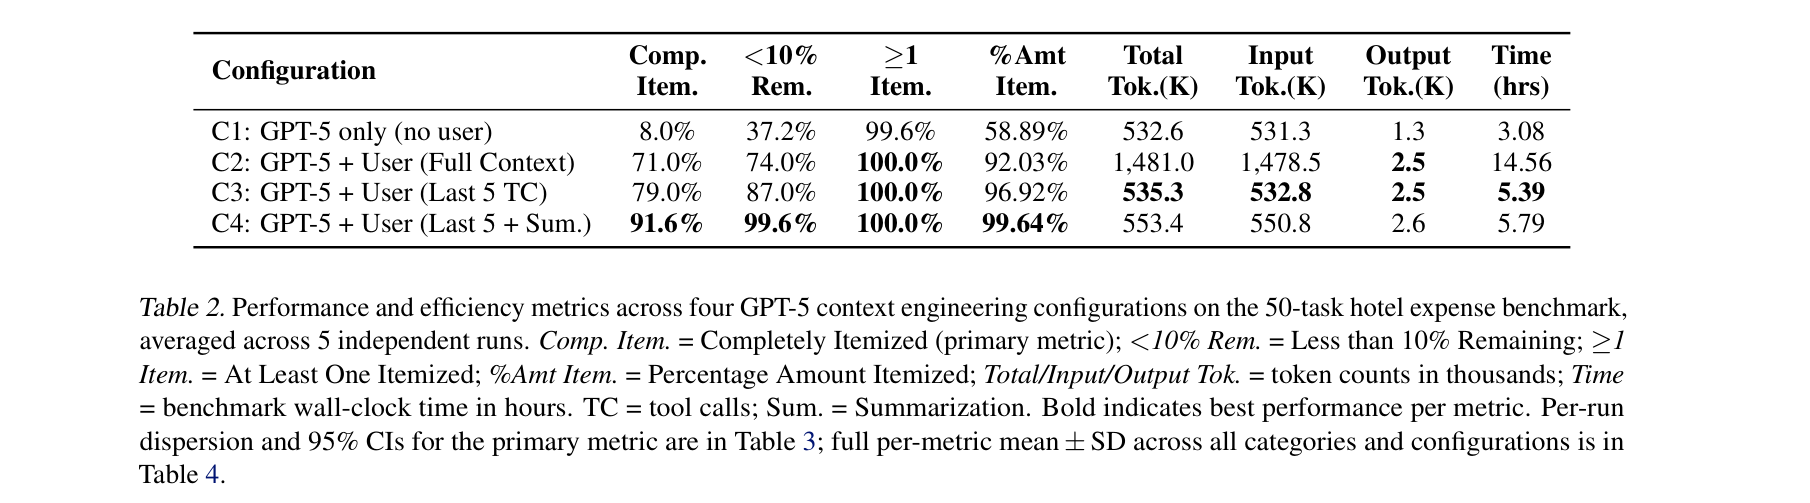
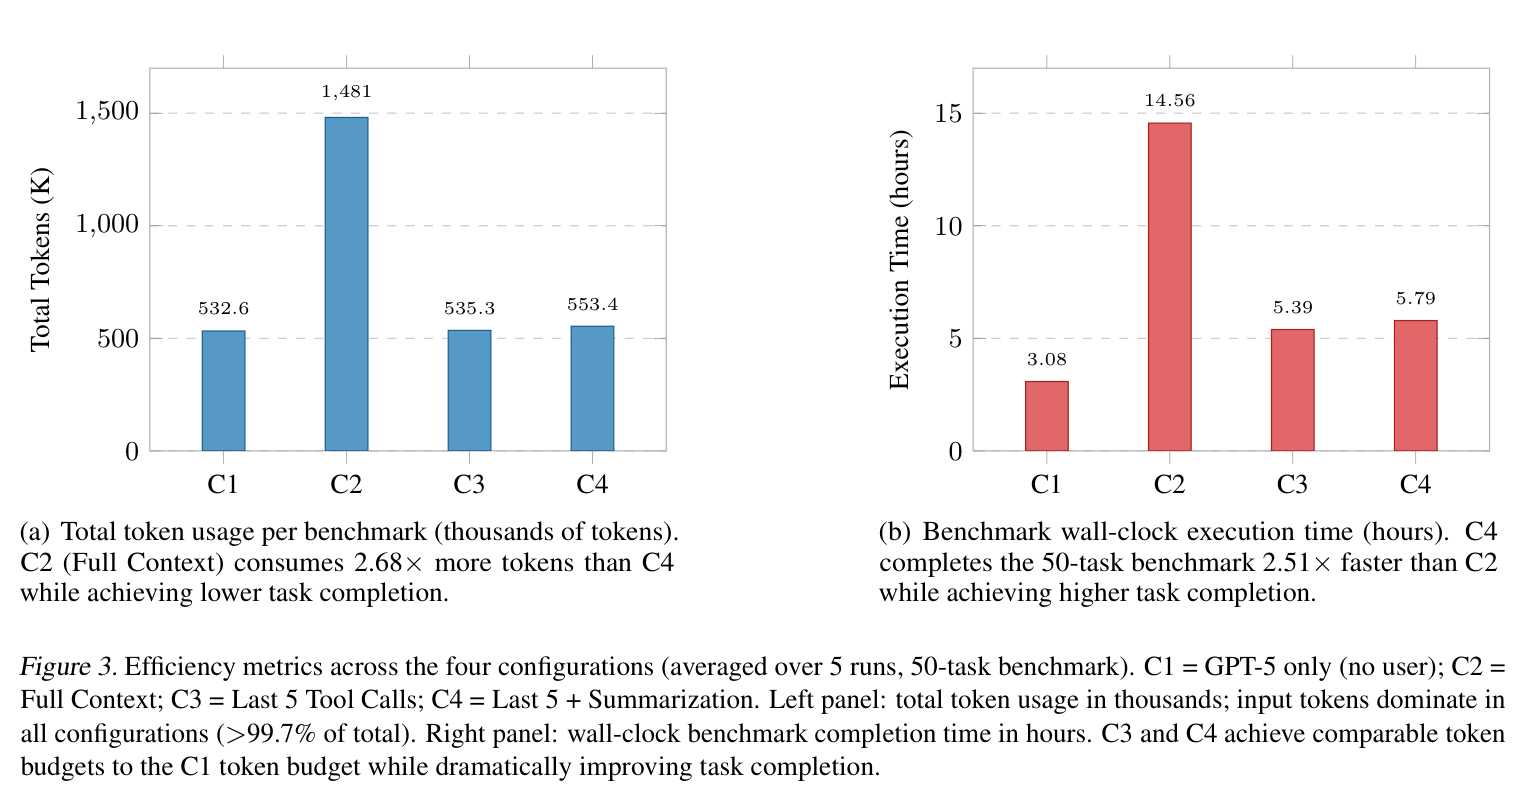
- 完全明細化は C1 8.0% → C2 71.0% → C3 79.0% → C4 91.6% と単調に上がります
- 残額 10% 未満は 37.2 → 74.0 → 87.0 → 99.6%、金額充当率は 58.9 → 92.0 → 96.9 → 99.6%
- C2 → C4 で完了率 +20.6pt、トークン −62.7%、時間 −60.2%
- 全履歴(C2)は直近 5(C3)に精度でも負けます
- 著者の解釈は、古いツール応答は「もう存在しないフォーム状態」を記述しており、それを見て判断するとノイズになる、というものです
- トークンと時間の最小は C1 と C3 で、C4 は C3 よりわずかに多く使います
- 著者は C3 → C4 の追加コストを「トークン +3.4%、時間 +7.4%」としています
- ただしこの差は 50 タスクで 18K トークン(1 タスク 360 トークン)しかなく、毎手の要約呼び出しの入力としては桁が足りません。Appendix C の集計対象はエージェントとユーザーモデルだけで、要約器自身のトークンは未計上の可能性が高いと考えます(§6.4)
- 入力トークンが総トークンの 99.7〜99.9% を占め、出力は構成によらず 2.5K 前後で安定しています(推論の深さは変わっていません)
4.2 統計
| 構成 | 平均 ± SD(5 run) | Wilson 95% 信頼区間(250 試行) |
|---|---|---|
| C2 | 71.0 ± 4.4 | 65.1 〜 76.3 |
| C3 | 79.0 ± 8.2 | 73.5 〜 83.6 |
| C4 | 91.6 ± 1.7 | 87.5 〜 94.4 |
- C4 の区間は C3 と分離していますが、C2 と C3 の区間はわずかに重なります。C2 → C3 の +8pt は統計的にはやや弱い結果です
- run 間の分散は C3 が最大で、C4 が最小です。刈り込みだけだと run ごとにぶれ、要約がその分散を吸収しています
- 同じ 50 タスクを使っているので対応のある比較ですが、著者は検定をせず「効果量が分散に比べて十分大きい」とだけ述べています
4.3 感度分析(Appendix H)
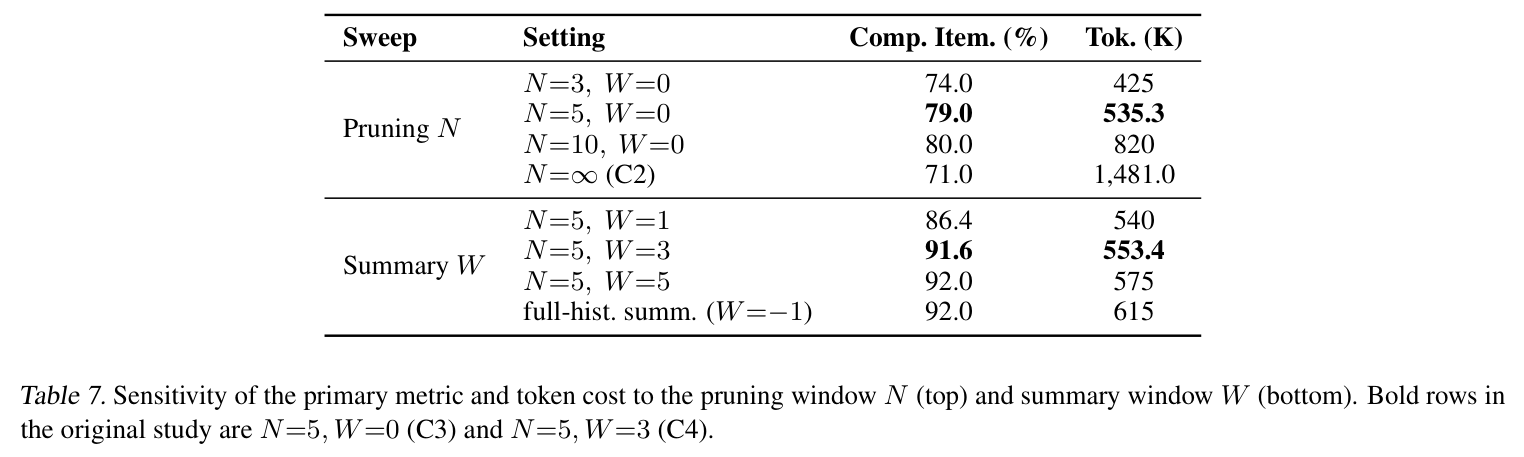
- 保持窓 N は 5 で頭打ちです
- N=10 は +1pt のために 53% 多くトークンを使います
- N=∞(全履歴)は精度でもトークンでも N=5 に負けます
- 要約窓 W は 3 で頭打ちです
- 全履歴要約(W=−1、compaction 相当)でも 92.0% で、スライディングウィンドウの W=3 と差がありません。差はトークン 11% だけです
- 著者が選んだ (N=5, W=3) は両方の曲線の「膝」にあります
4.4 他カテゴリへの一般化(§4.8)
| カテゴリ | n | C1 | C2 | C3 | C4 | 構造 |
|---|---|---|---|---|---|---|
| Hotel | 50 | 8.0 | 71.0 | 79.0 | 91.6 | 23 サブカテゴリ、泊数分の繰り返し |
| Travel | 30 | 20.0 | 76.0 | 86.6 | 95.0 | 語彙 4〜10、繰り返しはまれ |
| Meals & Gifts | 32 | 26.9 | 75.6 | 89.4 | 96.1 | 1〜4 行、最も単純 |
C2 → C4 の改善幅は 3 カテゴリとも +19〜21pt でほぼ一定です。構造が複雑なカテゴリほど C1 が低く、ユーザーモデルなしで止まる機会が多いことを示しています。
4.5 Claude Sonnet 4.5 での再現(Appendix I、ユーザーモデルなし)
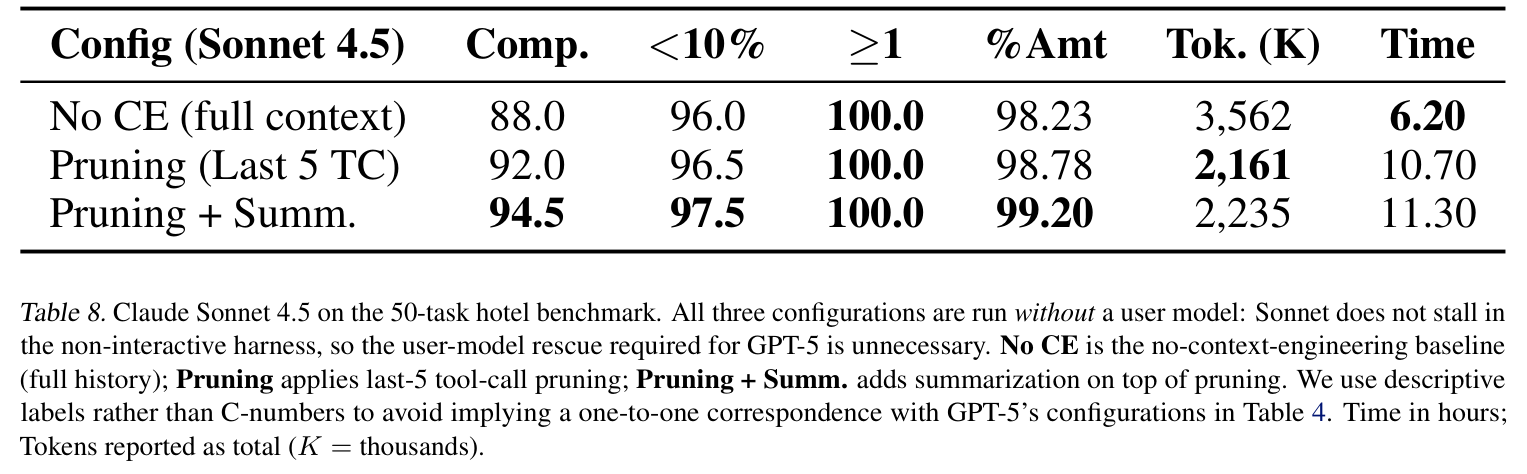
- 順序(全履歴 < 刈り込み < 刈り込み+要約)は再現し、要約の時間プレミアムも両モデルで +6〜7% と一貫しています
- 気になる点が 2 つあります
- Sonnet では刈り込むとトークンが 4 割減るのに、実行時間が 1.7 倍に増えています。論文は説明しておらず、呼び出し回数も報告していません。刈り込みで作業をやり直している可能性があります
- 全履歴の 3,562K トークンは、ユーザーモデルなしなのに GPT-5 の C2 の 2.4 倍です。そもそも手数が多いのかもしれません
5. Failure Analysis(§5、Appendix F)
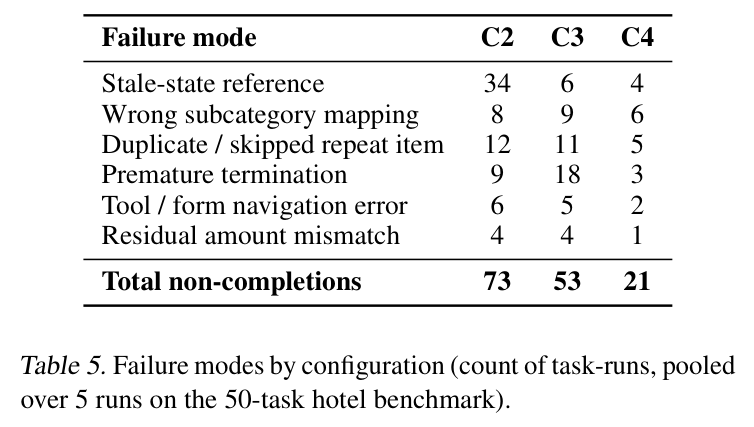
ホテル 5 run の非完了タスクを 6 種類に分類した表です。著者はメカニズムの予測を先に立て、表で検証しています。予測は「C2 は古い状態の参照が多い」「C3 は残額が見えず途中終了が増える」「C4 は両方を抑える」でした。
- 文脈ポリシーで大きく動く失敗は上 2 種類です
- 古い状態の参照(stale-state): 34 → 6 → 4。C2 の失敗の 47% を占めます。何手も前のフォームスナップショットを見て、既にある Room 行をもう一度追加するような失敗です
- 途中終了(premature termination): 9 → 18 → 3。C3 で 2 倍に増えます(論文本文は "triples" と書いているが数字は 2 倍に見える)。直近 5 件の中に残額を返した応答がなくなり、残額が見えないまま保存してしまいます
- C4 は途中終了を 18 → 3 に抑え、stale-state も戻りません。非完了は 73 → 53 → 21 と 71% 減ります
- 残りの 4 種類は「直りにくい」失敗です
- サブカテゴリの誤写像 8 → 9 → 6、繰り返し行の重複や抜け 12 → 11 → 5、ツールやフォームの操作エラー 6 → 5 → 2、残額の計算ずれ 4 → 4 → 1
- 論文は "largely policy-invariant" と書いていますが、数字を見ると C4 で半減はしています。「直らない」ではなく「直りにくい(C4 でも残る)」が正確です
- 4 種類の合計は 14/250 = 5.6% で、これが文脈工学の外側にある下限です(論文の 8.4% は stale-state 4 件と途中終了 3 件を含む非完了全体の割合です)
実例(Appendix F より要約)
(1) 古い状態の参照(C2): 最初のスナップショットを見て Room を二重登録
get_form_state → lines: Room 180、remaining 420
add_line(RoomTax, 40) → ok
get_form_state → lines: Room 180 / RoomTax 40、remaining 380
…(5 手)…
エージェントが最初のスナップショットを参照し add_line(Room, 180) → 重複
submit → 残額 −180(超過)
(4) 途中終了(C3): 残額を返した応答が窓から落ちて保存
get_form_state → total_added 340、remaining 240
add_line(Parking, 45) → ok
(刈り込み窓が「remaining: 240」の応答を落とす)
エージェントは残額を見ていない → submit → 残額 195 のまま保存
C4 の要約器が実際に出した要約
Summary of previous tool calls:
- Opened the Expense report form and navigated to expense report ER-00184 (hotel category, receipt total 612.40)
- Clicked the "Itemize" button and opened the itemization sub-form for the hotel line
- Added a Hotel-Room line with amount 180.00 via the add_line control
- Added a Hotel-Tax line with amount 14.40 via the add_line control
要約器は汎用で、フォーム・コントロール・ボタン・入力データを書くだけで残額は計算しません。それでも途中終了を抑えるには十分でした
6. お気持ち
- このタスク設計において要約は必要か?
- 結局、最新の全行と残額があればいいだけな気がしている。要約増やしたときの性能改善幅も限定的。N(=5)に残額が入ってないときをカバーできているだけでは。
- 論文では「要約はglobal progress の供給路だ」とか言ってるけど、言い過ぎな気がする。
- 要約の前にツール応答の設計を直したいね。
- 途中終了の原因とかも残額がコンテキストから落ちることなので、たとえば更新系ツールの応答に残額と登録済み行を含めれば要約は要らないだろうね。あとはStateを使うとか。
- ただ、論文の前提が、毎回すべての情報を渡されるというものになっている。computer use とかで毎回スクショがコンテキストに入ってくる状態とかならそうなりうるので、意義はあるとは思った。
- コストの計測でプロンプトキャッシュを無視しているっぽい
- 全履歴は末尾追記なので接頭辞キャッシュがほぼ全部効き、刈り込みは毎手接頭辞が変わってキャッシュが効かない。
- 要約をつける場所は考えても良さそうだなぁ。
- 要約のコストが計上されていなさそう
- C3 → C4 の差は 1 タスク 360 トークンしかなく、毎手の要約呼び出しの入力としては桁が足りない。Appendix C の集計対象はエージェントとユーザーモデルだけで、要約器は入っていなさそ。
7. デモ: 疑似 ERP で確かめたこと
論文の環境は再現できないので、同じ構造の小さな環境を作って回してみた。
7.1 環境
- タスクは合成したホテル領収書 12 件(10〜22 行、最大 5 泊)です。難易度が高めのものを揃える意図。完了判定は残額 0.00 ちょうどかどうか。
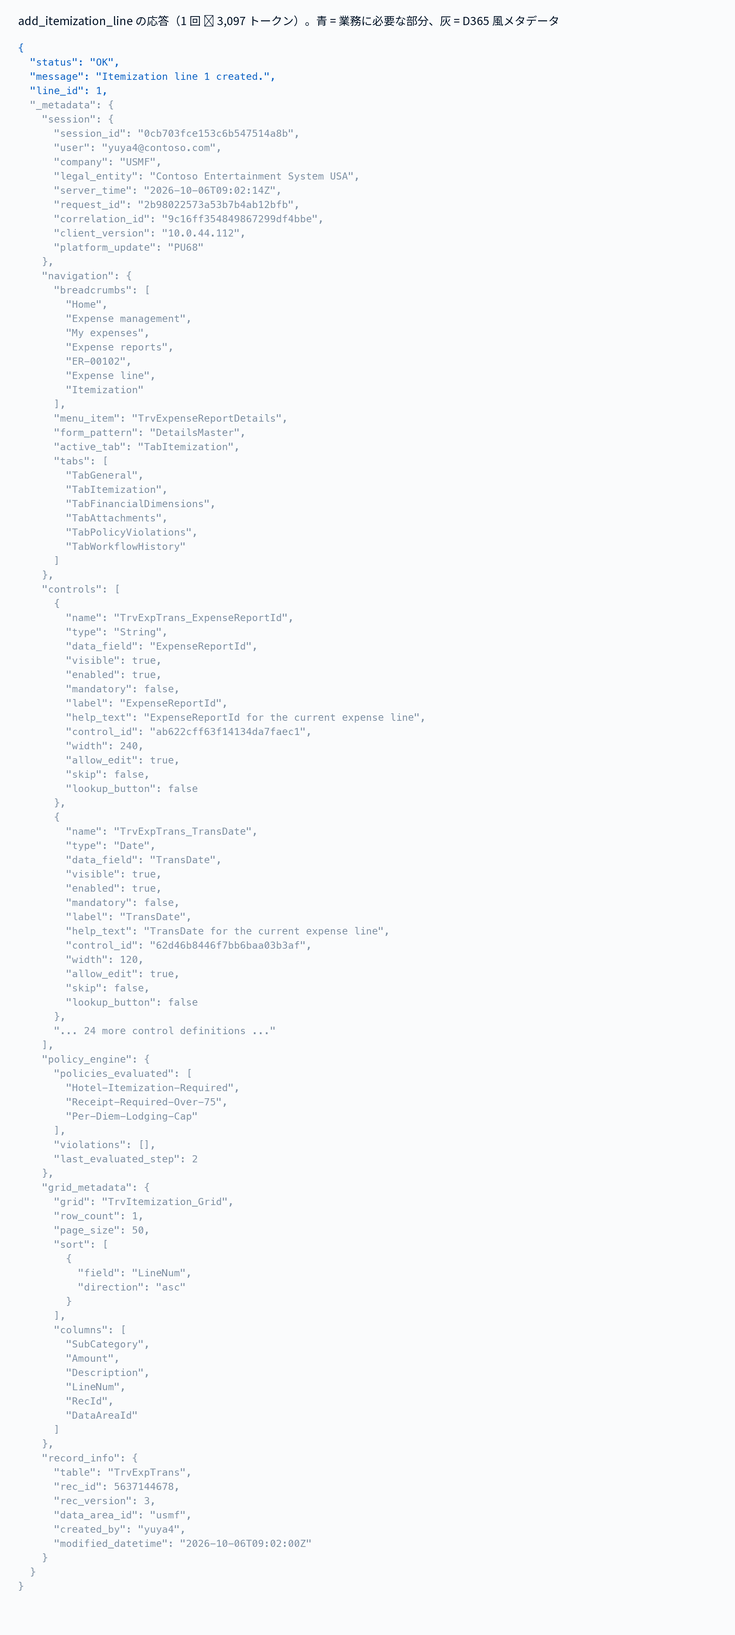
- ツールは 6 つ(open_expense_line、list_subcategories、get_form_state、add_itemization_line、remove_itemization_line、save_and_close)で、応答には D365 風のメタデータを付けて 1 応答 ≒ 3,000 トークンにしています
- ツール群は 2 通
- スリム版(既定): add_itemization_line は ok と line_id しか返さず、状態は get_form_state を呼んだときだけ返ります。 はこの add_itemization_line に残額と行一覧を足した「ツール設計版」です
- 論文準拠版(): 論文 §3.2 の記述に合わせ、どの応答にもフォーム全体のスナップショット(全フィールド値、明細行、残額)を含めます。古い状態が手数分だけ文脈に積み上がります
- 文脈ポリシーは Algorithm 1 をそのまま実装(full / prune5 / prune5sum3)。要約器には業務ペイロードだけを 1,500 文字まで渡します
- モデルは論文に合わせた gpt-5(reasoning low)とgpt-5.5(reasoning なし)です
- 論文と違い、サブカテゴリ一覧はシステムプロンプトに置かず、ツール応答でのみ与えています(行正答率に効きます)
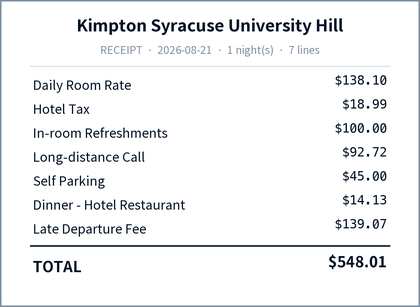
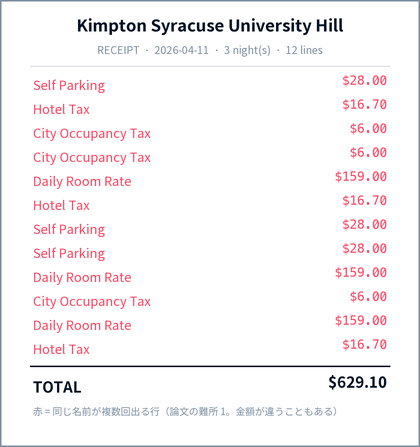
- 領収書は実データではなく、論文 §3.6 と Appendix E の難所(同名・異額の繰り返し、固定語彙への写像)を再現するように合成したものです( の 、seed 固定)
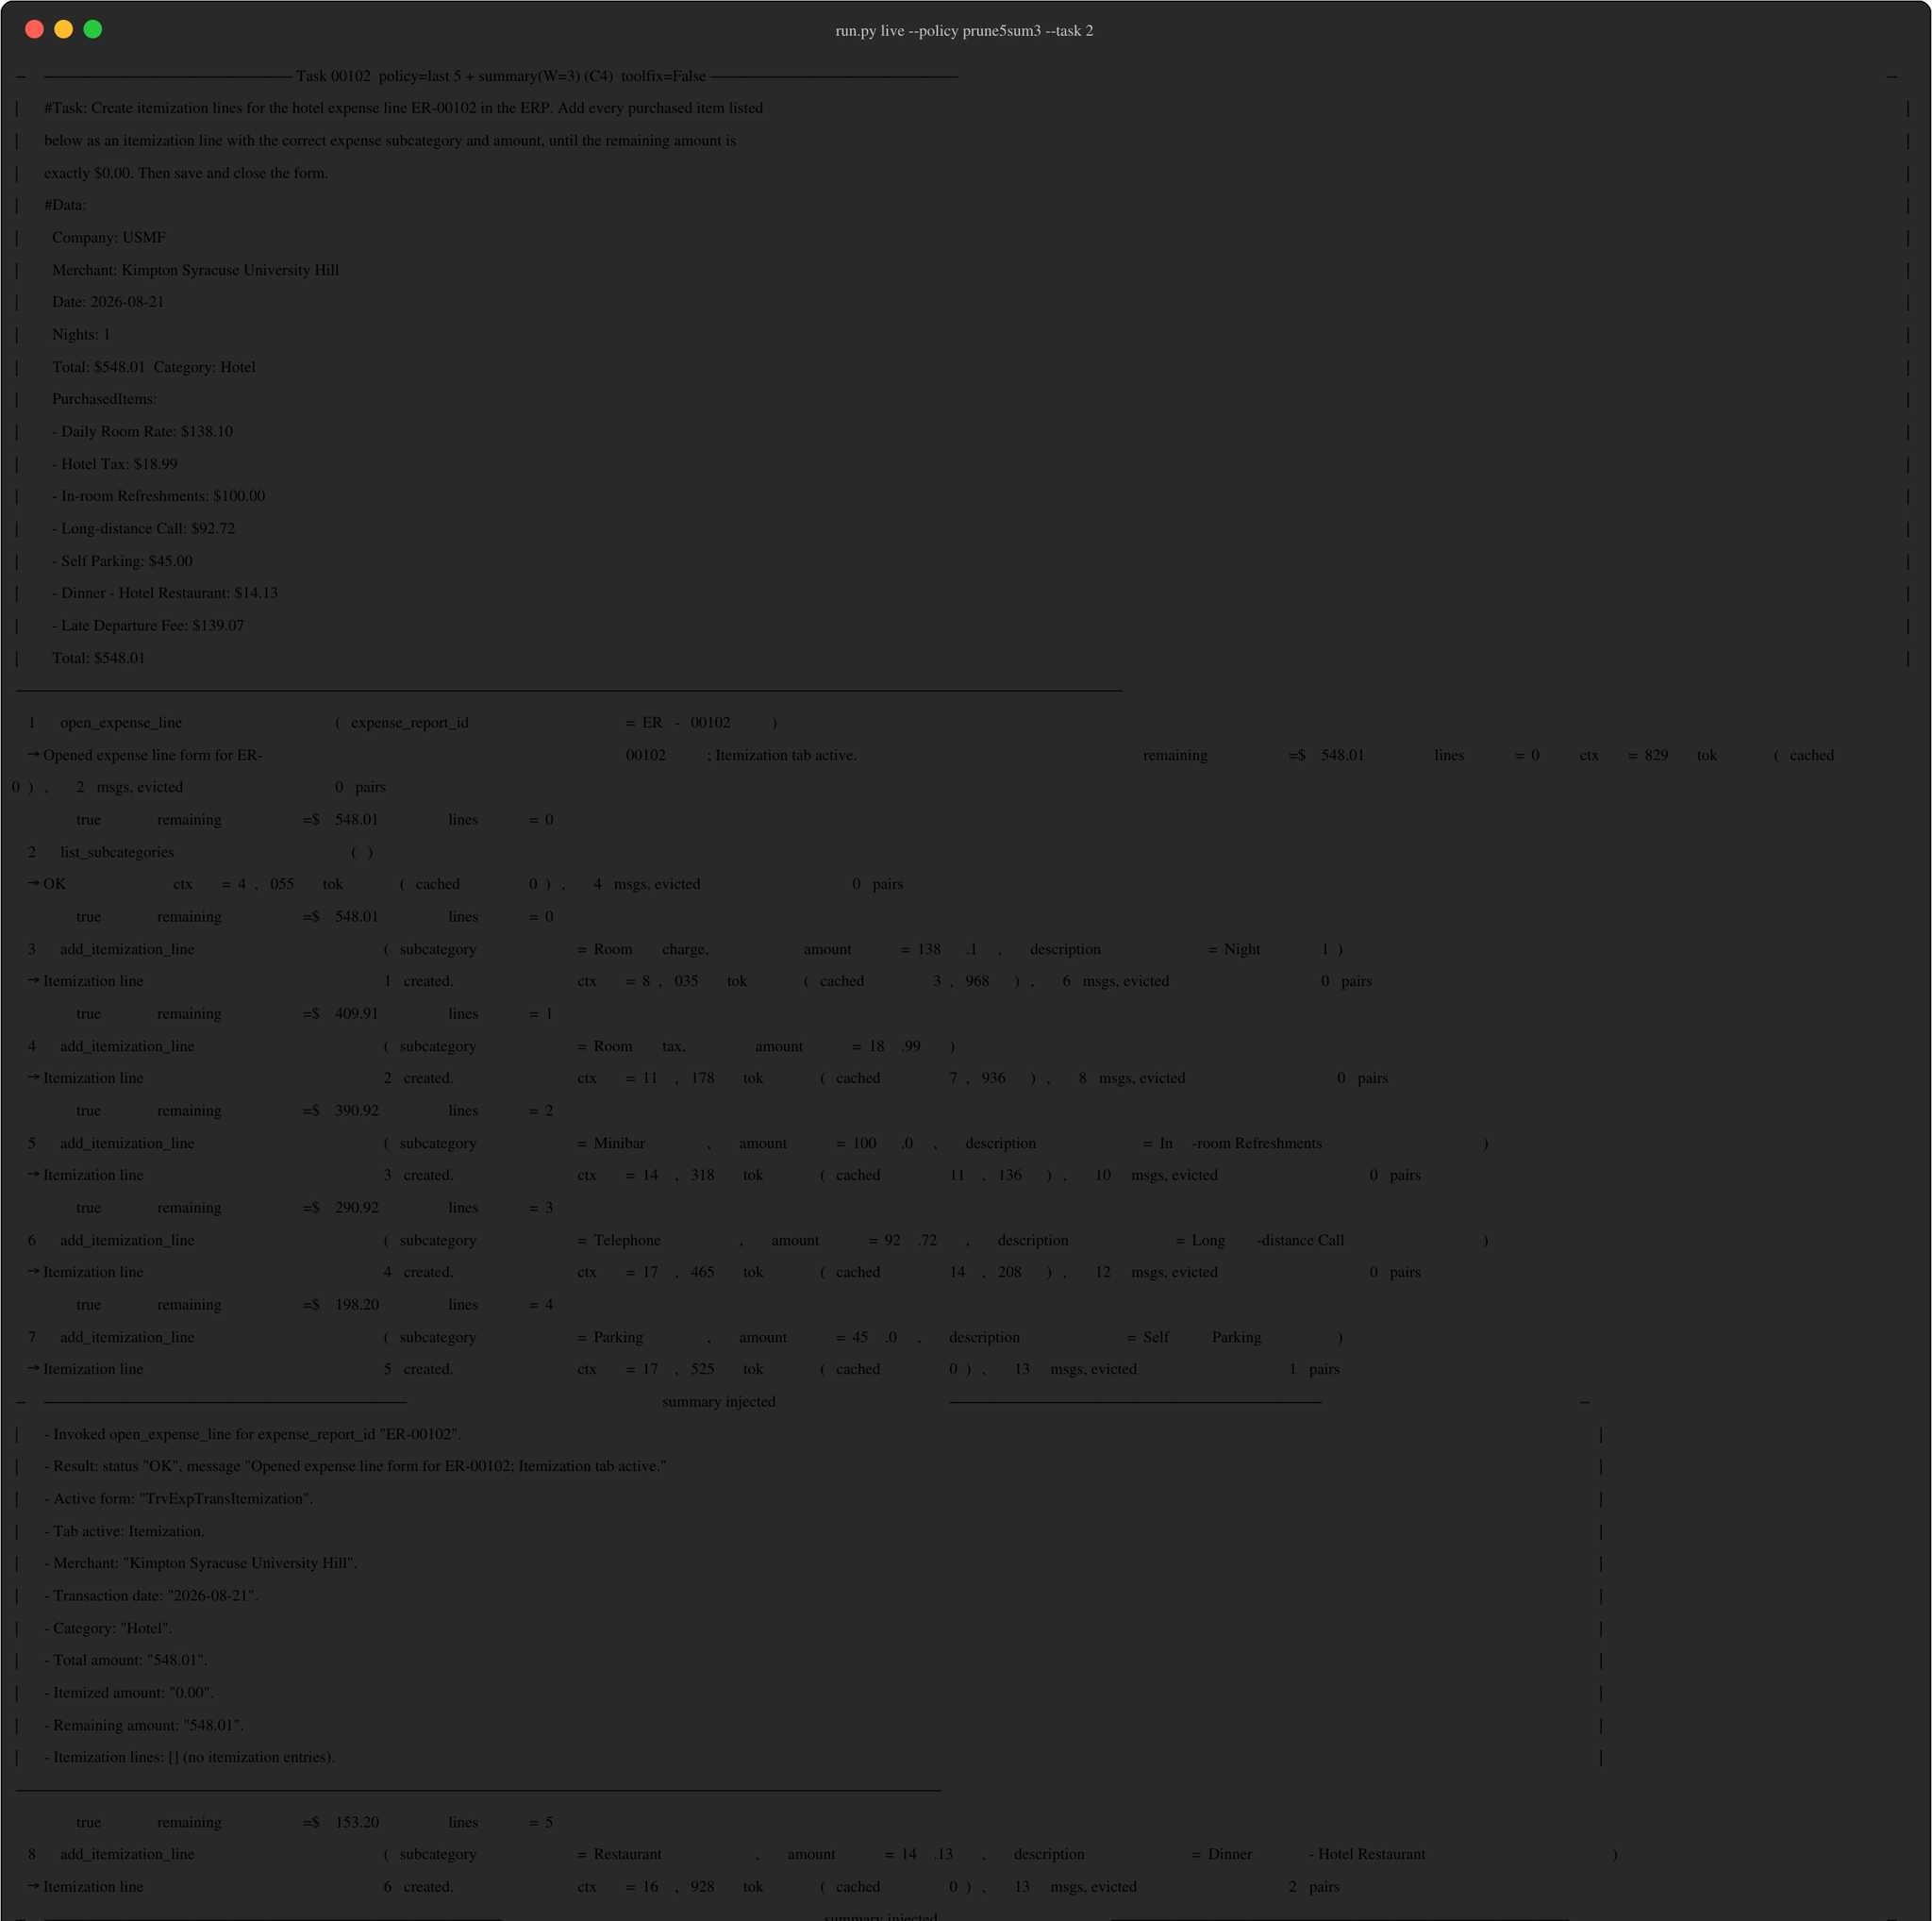
エージェントに渡すプロンプト(タスク 2。論文 Figure 1 と同じ形式)
7.2 結果(難度を上げた 12 タスク: 10〜22 行、最大 5 泊。1 run)
| モデル | ツール群 | ポリシー | 完了 | 行正答 | 入力 tok | cache | キャッシュ換算 | 最大文脈 | 秒 / task | 失敗 |
|---|---|---|---|---|---|---|---|---|---|---|
| gpt-5(reasoning low) | スリム(≒ 3K) | 全履歴(C2) | 12/12 | 100% | 633K | 88% | 129K | 95K | 99 | — |
| gpt-5(reasoning low) | スリム(≒ 3K) | 直近 5(C3) | 3/12 | 69% | 861K | 6% | 815K | 19K | 368 | 手数上限 9 |
| gpt-5(reasoning low) | スリム(≒ 3K) | 直近 5 + 要約(C4) | 12/12 | 100% | 490K | 10% | 490K | 19K | 529 | — |
| gpt-5(reasoning low) | スリム(≒ 3K) | 直近 5 + toolfix | 12/12 | 100% | 337K | 11% | 303K | 20K | 123 | — |
| gpt-5(reasoning low) | 論文準拠(全応答にスナップショット、≒ 3.5K) | 全履歴(C2) | 12/12 | 100% | 674K | 90% | 130K | 94K | 86 | — |
| gpt-5(reasoning low) | 論文準拠(全応答にスナップショット、≒ 3.5K) | 直近 5(C3) | 12/12 | 100% | 355K | 15% | 308K | 22K | 122 | — |
| gpt-5(reasoning low) | 論文準拠(全応答にスナップショット、≒ 3.5K) | 直近 5 + 要約(C4) | 12/12 | 100% | 358K | 13% | 361K | 21K | 399 | — |
| gpt-5.5(reasoning なし) | スリム(≒ 3K) | 全履歴(C2) | 12/12 | 100% | 603K | 89% | 121K | 81K | 29 | — |
| gpt-5.5(reasoning なし) | スリム(≒ 3K) | 直近 5(C3) | 12/12 | 99% | 317K | 16% | 271K | 18K | 31 | — |
| gpt-5.5(reasoning なし) | スリム(≒ 3K) | 直近 5 + 要約(C4) | 12/12 | 99% | 292K | 18% | 250K | 18K | 56 | — |
| gpt-5.5(reasoning なし) | スリム(≒ 3K) | 直近 5 + toolfix | 12/12 | 99% | 312K | 12% | 279K | 20K | 30 | — |
| gpt-5.5(reasoning なし) | 論文準拠(全応答にスナップショット、≒ 3.5K) | 全履歴(C2) | 12/12 | 100% | 674K | 89% | 133K | 95K | 26 | — |
| gpt-5.5(reasoning なし) | 論文準拠(全応答にスナップショット、≒ 3.5K) | 直近 5(C3) | 12/12 | 98% | 331K | 14% | 288K | 21K | 27 | — |
| gpt-5.5(reasoning なし) | 論文準拠(全応答にスナップショット、≒ 3.5K) | 直近 5 + 要約(C4) | 12/12 | 99% | 337K | 15% | 314K | 21K | 67 | — |
| gpt-5.5(reasoning なし) | スリム・4 倍(≒ 11K) | 全履歴(C2) | 12/12 | 100% | 2,069K | 90% | 398K | 283K | 33 | — |
| gpt-5.5(reasoning なし) | スリム・4 倍(≒ 11K) | 直近 5(C3) | 12/12 | 99% | 1,032K | 18% | 862K | 58K | 35 | — |
| gpt-5.5(reasoning なし) | スリム・4 倍(≒ 11K) | 直近 5 + 要約(C4) | 12/12 | 100% | 1,009K | 18% | 856K | 58K | 64 | — |
| gpt-5.5(reasoning なし) | スリム・4 倍(≒ 11K) | 直近 5 + toolfix | 12/12 | 99% | 1,022K | 14% | 891K | 60K | 36 | — |
結果
- だいたいできてしまったので、あまり差を検証できず。
- 論文の「全履歴は有害」は、どちらのツール群でも再現せず
- gpt-5 も gpt-5.5 も、全履歴で全タスクを完了し、行正答は 100% です。論文準拠版で古いスナップショットが 9 万トークン分積み上がっても、gpt-5.5 の 28 万トークンのストレス条件でも落ちません
- キャッシュ換算のコストと実行時間でも全履歴が最良。入力の 9 割がキャッシュヒットするため。
- 刈り込みだけ(C3)が壊れるかは、モデルとツール応答の両方で決まる
- スリム版の gpt-5 では論文と同じく C3 が壊れます。12 タスク中 9 件が、残額を見失って同じ行を入れ直し続け手数上限に達しました(行正答は平均 69%)。要約(C4)と toolfix はどちらも 12/12 で救えます
- 論文準拠版の gpt-5 では C3 でも 12/12 です。全応答に残額が載るので「残額を見失う」条件が消えるためです
- gpt-5.5 はどちらのツール群でも C3 で全完了で、行正答が 98〜99% にわずかに落ちる程度です
- 要約(C4)の代償は時間。gpt-5 では 1 タスク 6〜10 分かかり、要約器だけで 1 タスク 50K トークンを使います。gpt-5.5 でも要約なしの 2 倍の時間がかかる。
- 刈り込むとキャッシュヒット率が 90% から 10% 台に落ちます。名目トークンだけでコストを比べると見誤ります(§6.3)
- 小さいモデル(gpt-5-mini / gpt-4.1-mini、7〜14 行の 6 タスク)では C3 と C4 がさらに壊れやすく、サブカテゴリ一覧をツール応答にしか置かないデモ設計のせいで行正答が 8〜10% 落ちます(論文は語彙をプロンプトに固定しています)
7.3 論文と結果が違う理由
論文は C2(全履歴)71% が C3(直近 5)79% に負け、C4 で 91.6% でした。デモでは全履歴が常に最良です。考えられる理由を、確からしい順に挙げます。
- 「冗長さ」の中身が違うが、それを再現できていない。
- 文の害は、矛盾する古い状態(残額や明細行の古い値)が文脈に積み上がって起きる stale-state 。スリム版にはその条件がほぼ無く、論文準拠版で条件を作っても、実際のUIほどではない。論文の MCP 応答は JSON ではなく UI 寄りの非構造テキストである可能性が高く、構造化された繰り返しメタデータより注意を乱しやすかったと考えられます
- モデルの世代と設定が違う
- それはそう。
- 論文は 2025 年 8 月の GPT-5 を非対話で動かし、確認質問で止まるためユーザーモデルで催促しています。デモの gpt-5 は reasoning low のチャット補完で 1 度も止まりません。同じ名前でも挙動が違い、長文脈耐性は 1 年分進んでいます