2026-10-13 機械学習勉強会
今週のTOPIC[tech report] Xiaomi-OCR-0 Technical Report[paper] Recursive self-improvement of AI research agents[paper] The Scaling Laws of Skills in LLM Agent SystemsメインTOPICGitSwarm: Decentralized Compounding Inference過去の勉強会
今週のTOPIC
※ [paper] [blog] など何に関するTOPICなのかパッと見で分かるようにしましょう。
技術的に学びのあるトピックを解説する時間にできると🙆(AIツール紹介等はslack channelでの共有など別機会にて推奨)
出典を埋め込みURLにしましょう。
@Naoto Shimakoshi
[tech report] Xiaomi-OCR-0 Technical Report
- スライド
- 一言で言うと
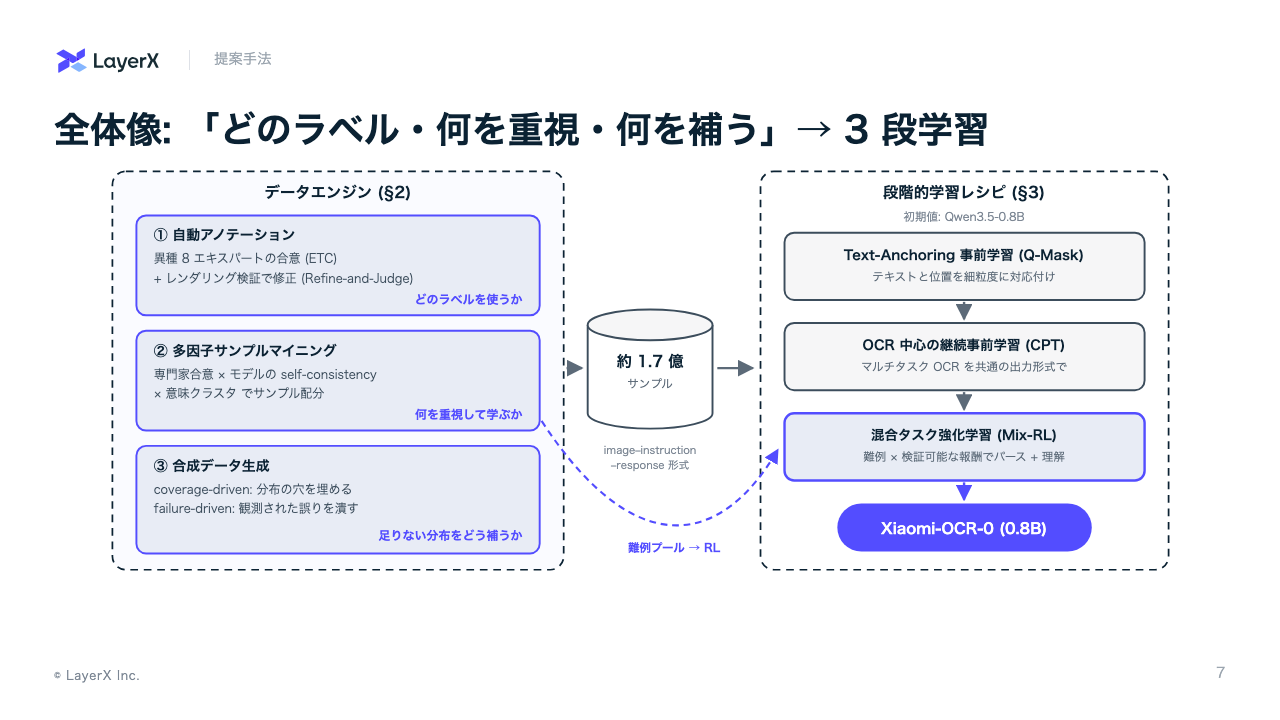
- 文書パース (ページ → Markdown) と OCR 中心理解 (VQA / 項目抽出) を 0.8B の 1 モデルにまとめた Xiaomi の OCR VLM
- 鍵は「既存 OCR モデル 8 体の合議で作る 1.7 億サンプルのデータエンジン」と「パース → 理解の順で鍛えるカリキュラム」
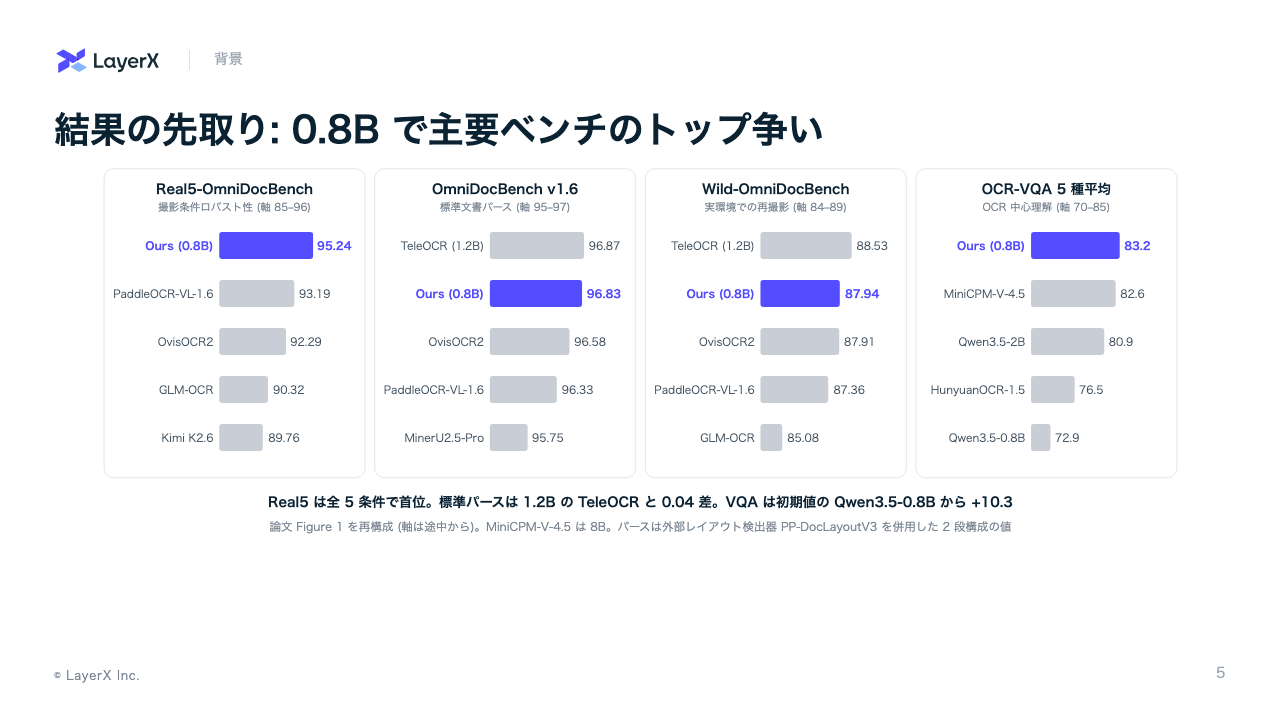
- 結果 (0.8B でトップ争い)
- Real5-OmniDocBench (撮影条件ロバスト性) 95.24 で首位、全 5 条件で 1 位
- OmniDocBench v1.6 96.83 (1.2B の TeleOCR 96.87 とほぼ同点。数式 CDM 98.50 は最高)
- OCR-VQA 5 種平均 83.2 (初期値 Qwen3.5-0.8B から +10.3、Qwen3.5-2B 超え)
- データエンジン
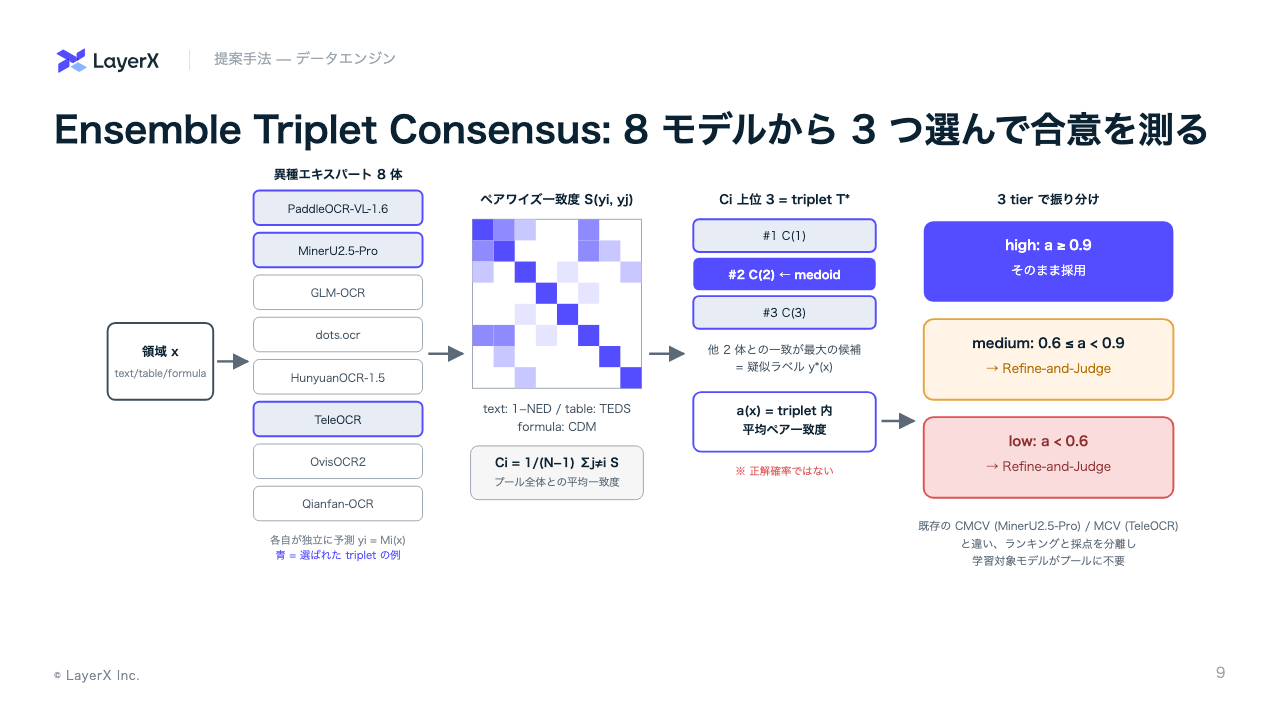
- ETC (Ensemble Triplet Consensus): 異種 8 OCR モデルで予測 → 全体と一致度の高い上位 3 体を選び、その medoid を疑似ラベルに。triplet 内一致度 a で 3 段階に振り分け (≥0.9 は採用)
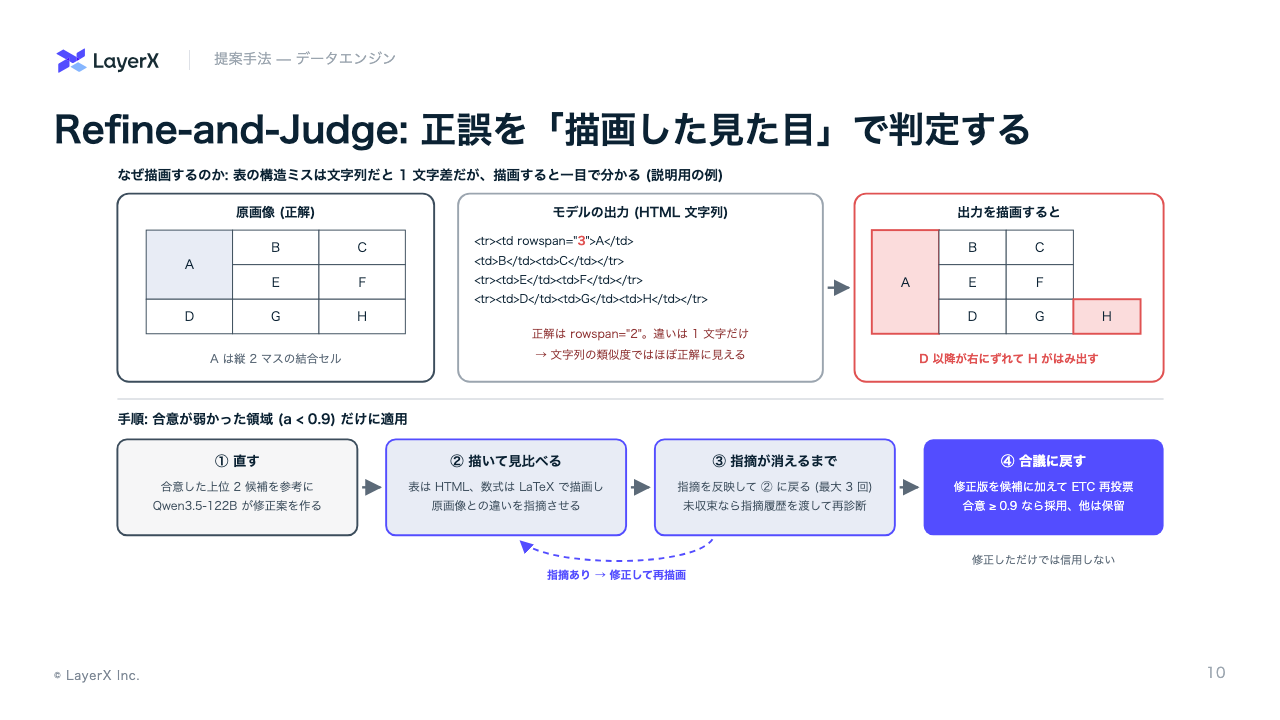
- Render-Guided Refine-and-Judge: 合意が弱かった領域を「描画した見た目」で検証して直す仕組み
- なぜ描画するか: 表の結合セルの誤り (rowspan="2" → "3") は文字列だと 1 文字差でほぼ正解に見えるが、描画すると行がずれてはみ出すので一目で分かる
- 手順: ① 上位 2 候補を参考に Qwen3.5-122B が修正案を作る → ② HTML / LaTeX で描画し、原画像との違いを指摘させる → ③ 指摘が消えるまで繰り返す (最大 3 回) → ④ 修正版を候補に加えて合議をやり直し、合意 ≥ 0.9 なら採用
- 修正しただけでは信用せず、最後は必ず合議に戻すのがポイント
- 多因子マイニング: 「専門家合意が高い × モデルの self-consistency が低い」= ラベルは確かでモデルが揺れるサンプルを難例として RL・合成に回す
- 合成は「分布の穴埋め」と「観測した誤りの変種生成」の 2 系統。反復はエージェントが回し、人間はレビューのみ
- 学習レシピ (3 段)
- Q-Mask (文字と位置の対応付け) → 継続事前学習 (多タスク OCR) → Mix-RL (DAPO 型、TEDS / CDM / ANLS など評価指標をそのまま報酬に)
- Q-Mask は数式 (+0.49)、Mix-RL は表構造 (TEDS +0.71) に効く
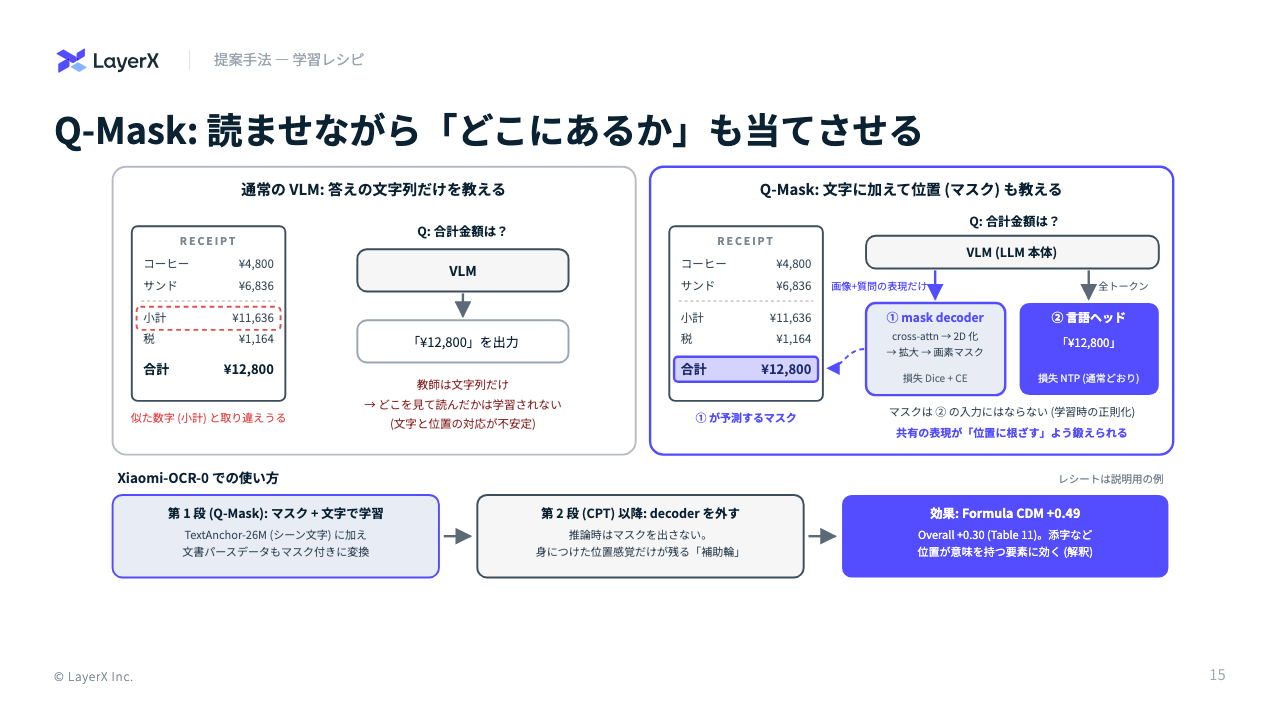
- Q-Mask とは (元論文): 文字列に加えて「その文字が画像のどこにあるか」のマスクも正解として教える学習
- 通常の VLM は答えの文字列だけで学習するので、どこを見て読んだかは問われない (小計と合計の取り違えなど)
- LLM の最終層のうち「画像 + 質問」トークンの表現だけを mask decoder に通し、画素ごとの 0/1 確率マップを予測 (Dice + CE)。文字は従来どおり言語ヘッドから (NTP)
- マスクは文字生成の入力にはならず、共有の表現を「位置に根ざす」よう鍛える学習時の正則化。Xiaomi-OCR-0 では第 2 段 (CPT) 以降 decoder ごと外す
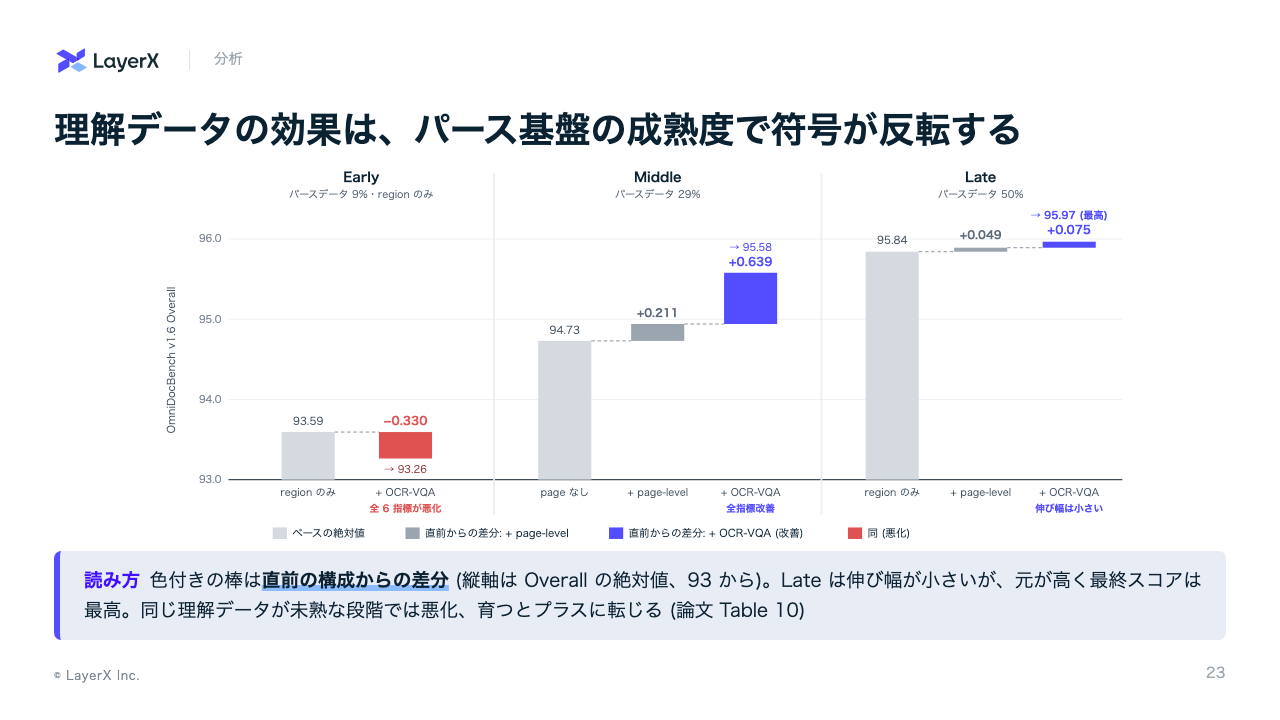
- 一番面白い知見: 理解データの効果は符号が反転する
- 同じ OCR-VQA データを足したとき、パースが未熟 (データ 9%) だと −0.33、成熟 (29%) すると +0.64
- 4B teacher との差はパース 0.15 に対し理解 4.9 → 理解の方が容量を要求する
- → 「パースを先に固めてから理解を厚くする」カリキュラムが良い
- 数字は「直前の構成からの差分」。Late は伸び幅 (+0.075) こそ小さいが、元が高く最終スコアは最高 (95.97)。最適な配合比があるかは未検証
- 注意点・所感
- 「0.8B」は外部レイアウト検出器 (PP-DocLayoutV3) を含まない 2 段パイプラインの数字
- 古文書は HunyuanOCR-1.5 (0.79) が上、KIE の請求書は Qwen3.5-2B に 12pt 負け (社内ベンチで非公開)
- 差が 0.05〜0.6pt と小さくシード分散の記載がないので、「反転」の主張はやや強め
- 「合意は高いのにモデルが揺れる」を難例とする定義は、OCR 以外の能動学習・RL のデータ選択にも使えそう
@Hiromu Nakamura (pon)
[paper] Recursive self-improvement of AI research agents
AI研究エージェントが自身のソースコードを自律的に書き換え、研究効率を向上させる「再帰的自己改善 (Recursive Self-Improvement: RSI)」システム「AIDE2」を提案
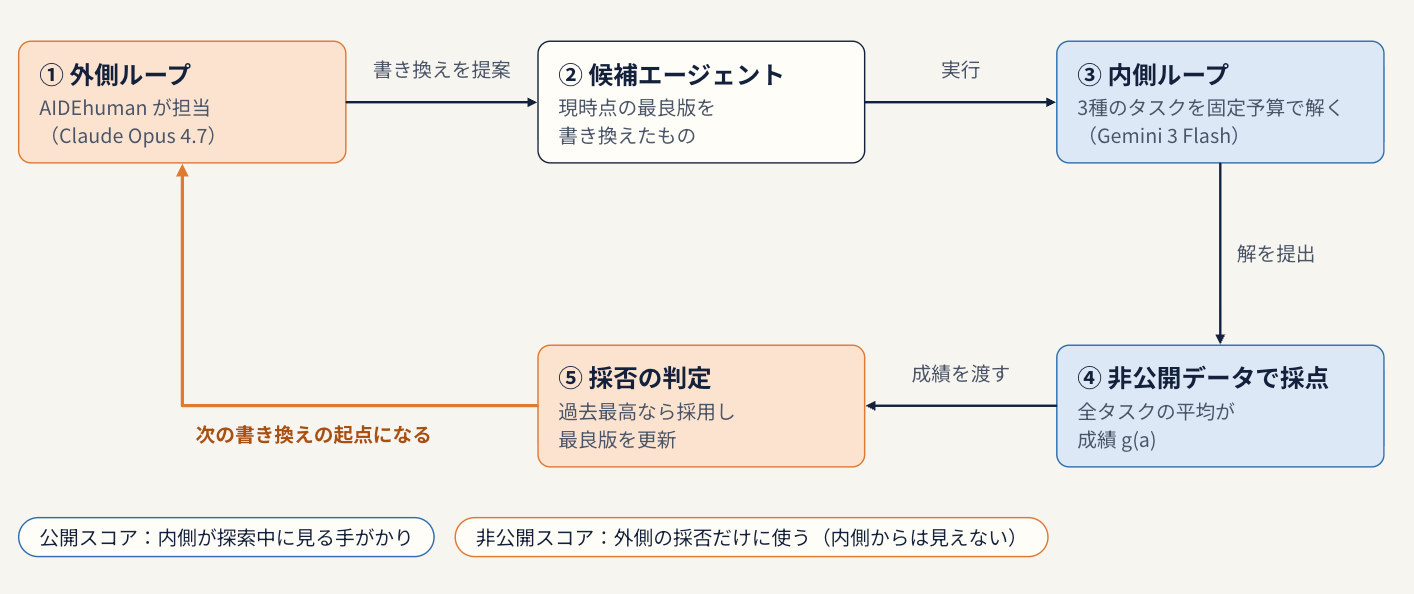
AIDE2は「内部ループ (Inner loop)」と「外部ループ (Outer loop)」からなる二階層の最適化プロセスを採用している。
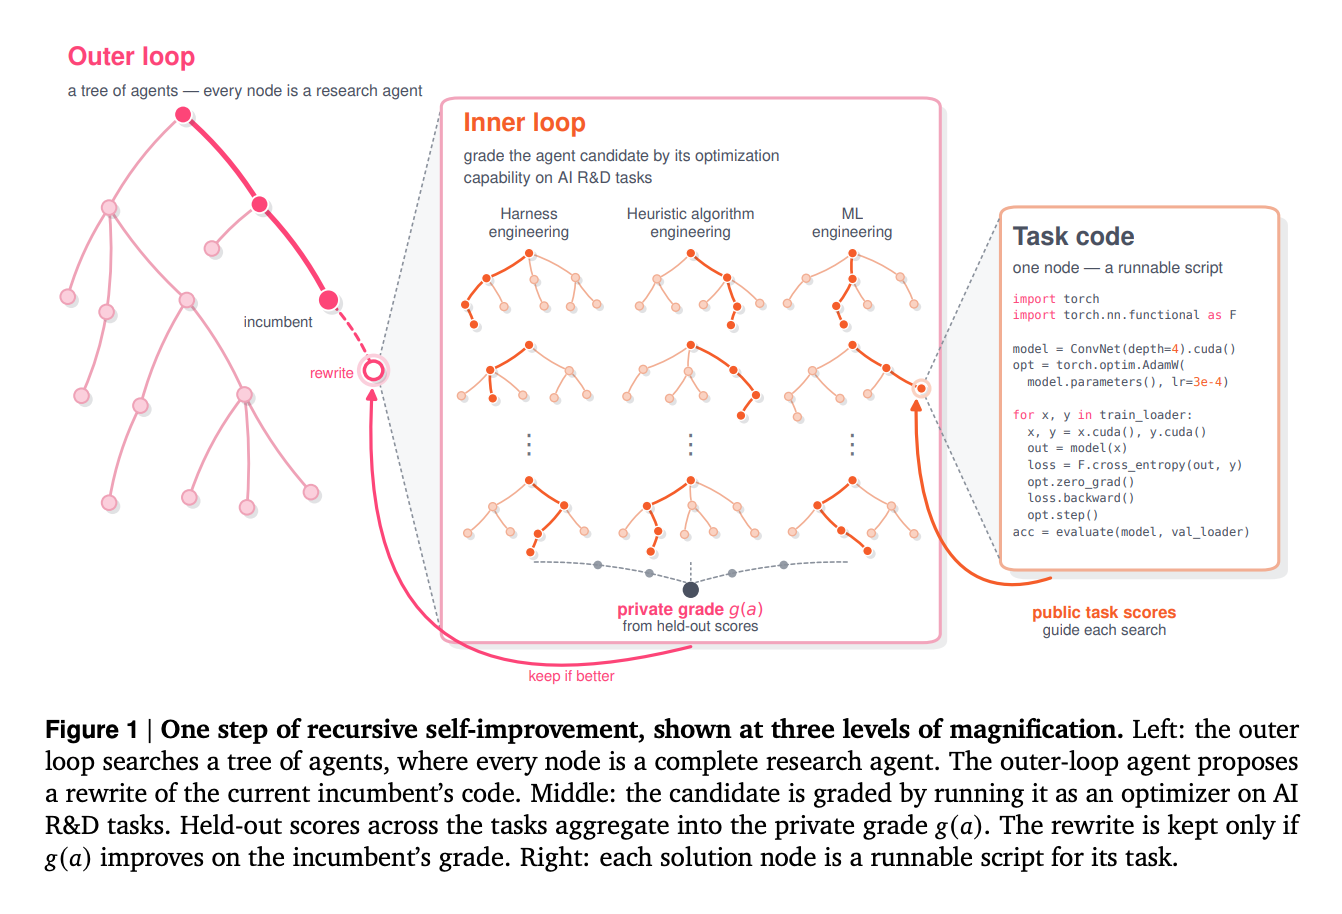
内部ループ:研究エージェントの最適化能力
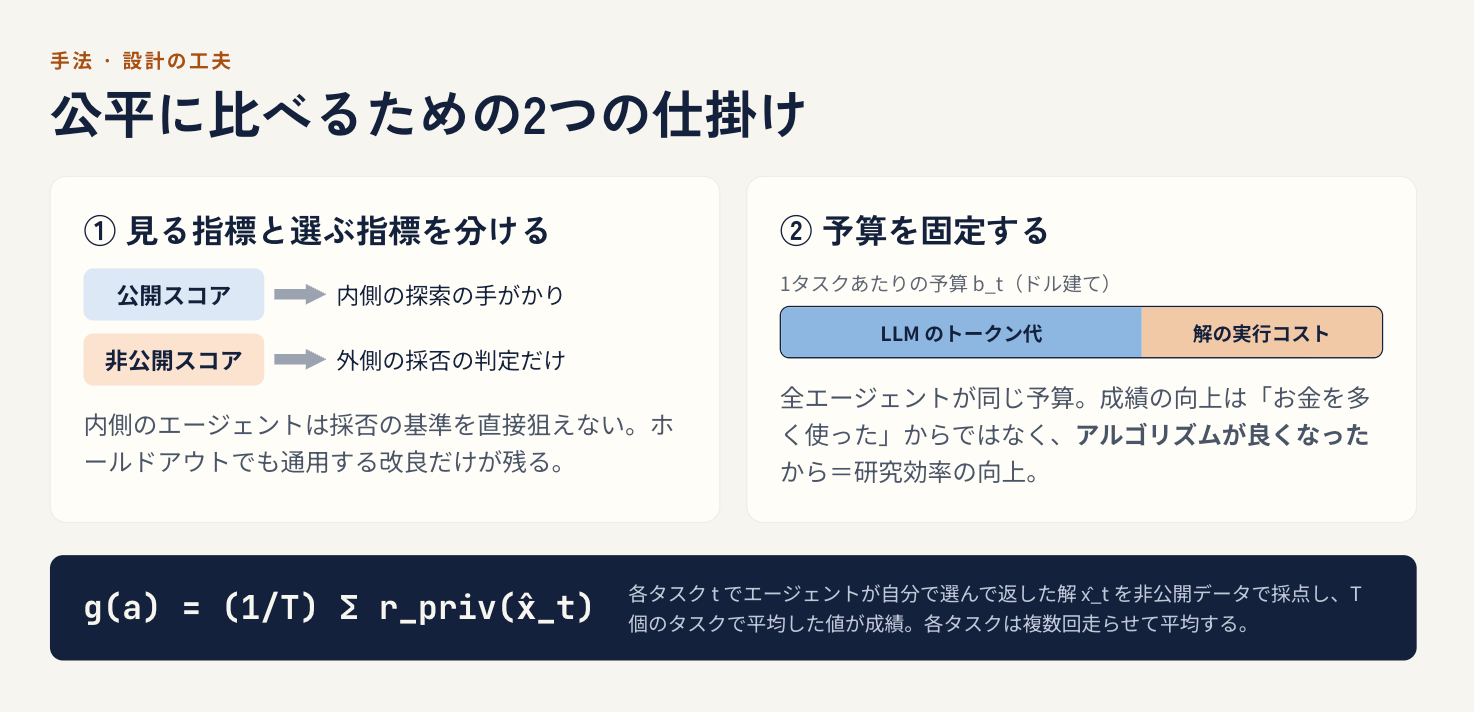
- 内部ループでは、研究エージェント がタスク に対してコードの編集を行い、指標 を最大化する。一定の予算 内で生成されたソリューション は、公開されない評価データ によって評価される。エージェントの能力 は以下の通り算出される。
- ここで はタスク数である。このループにより、特定タスクへの過学習を防ぎつつ、汎用的な研究効率の向上が図られる。
外部ループ:メタレベルの自己改善
- 外部ループは を最大化するようにエージェント のコード自体を書き換える。ステップ におけるエージェント は以下の式で決定される。
- incumbent(現在最良のエージェント)を逐次的に編集することで、アルゴリズムの改善を累積させる。また、外部ループにおける選択基準は となり、統計的に有意な改善のみを採用する仕組みとなっている。
主な成果と知見
- sustained improvement(持続的な改善): 100ノードの軌跡において7回の改善が認められ、インキュベントのグレードが0.703から0.778へと向上した。
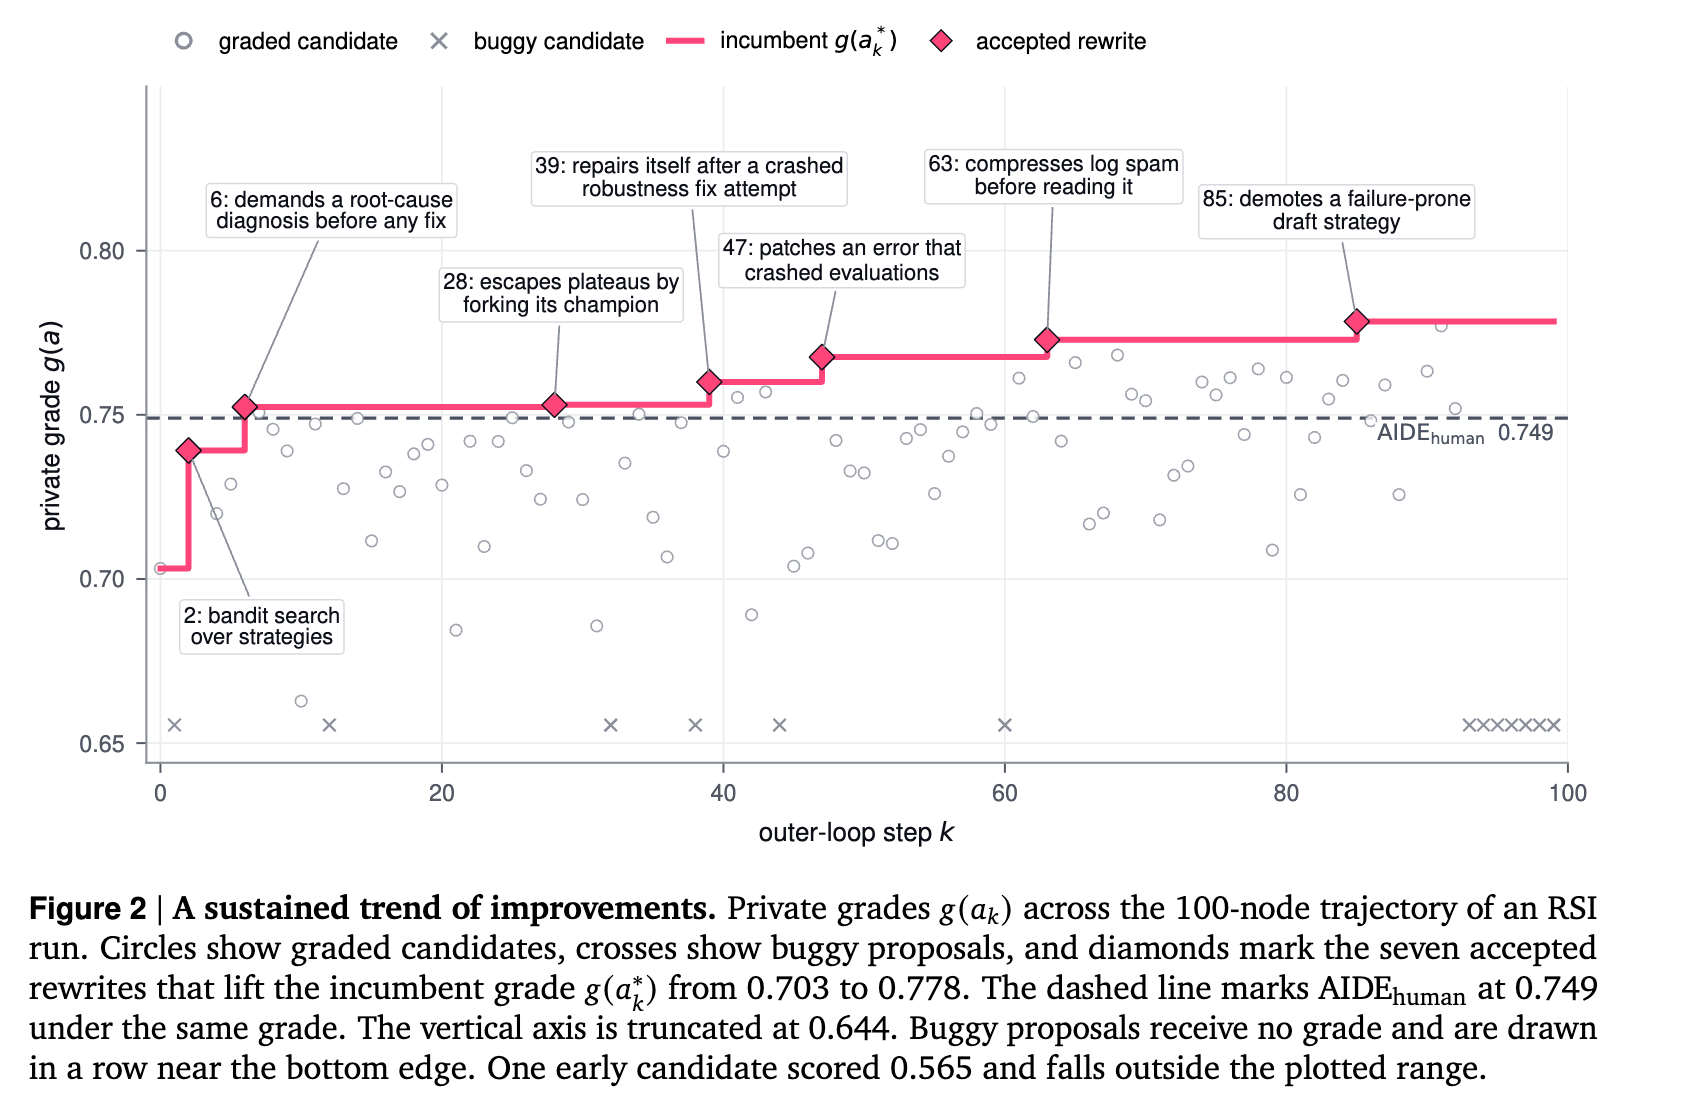
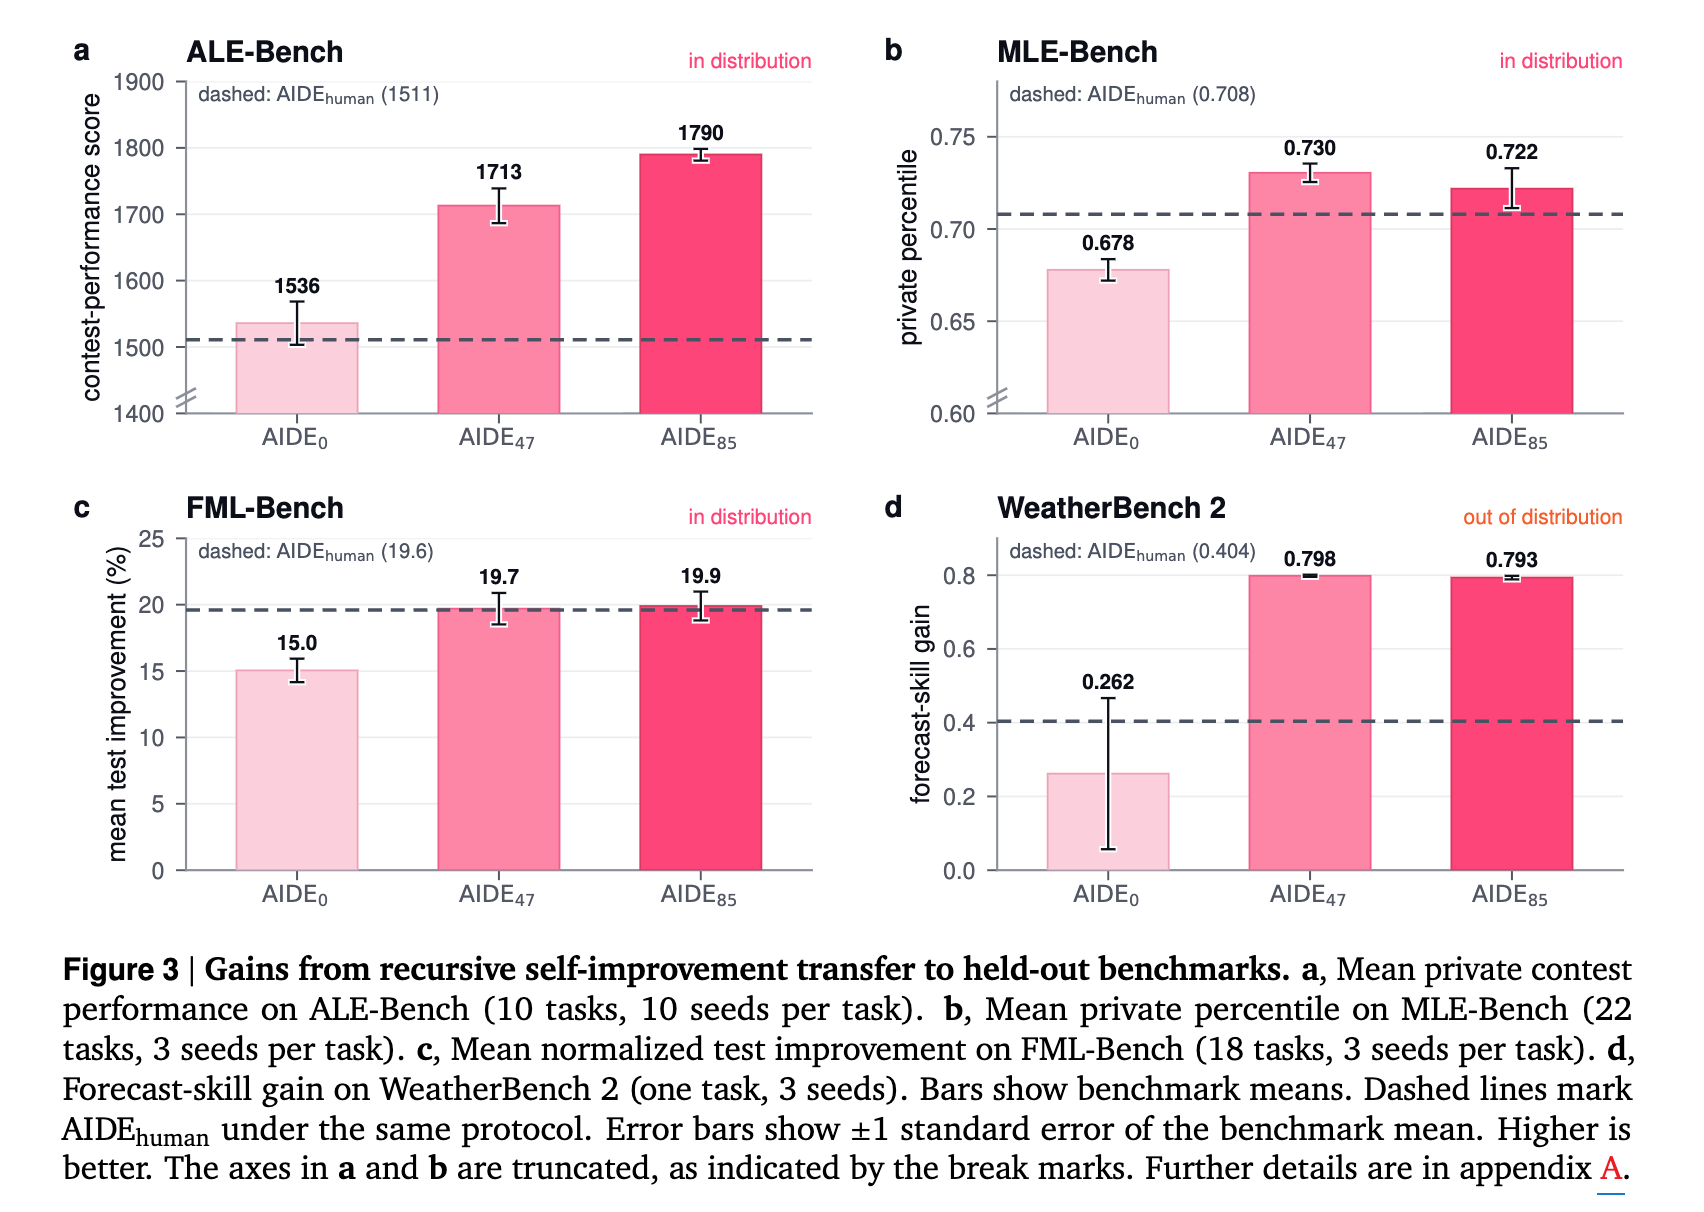
- 汎化性能: 選択ベンチマークに含まれない「ALE-Bench」「MLE-Bench」「FML-Bench」および未知のドメインである「WeatherBench 2」において、ベースラインであるAIDEhumanを凌駕した。特に物理ベースの天気予報という未知の科学技術計算ドメインにおいて、明示的なチューニングなしに精度が向上した点は特筆すべきである。
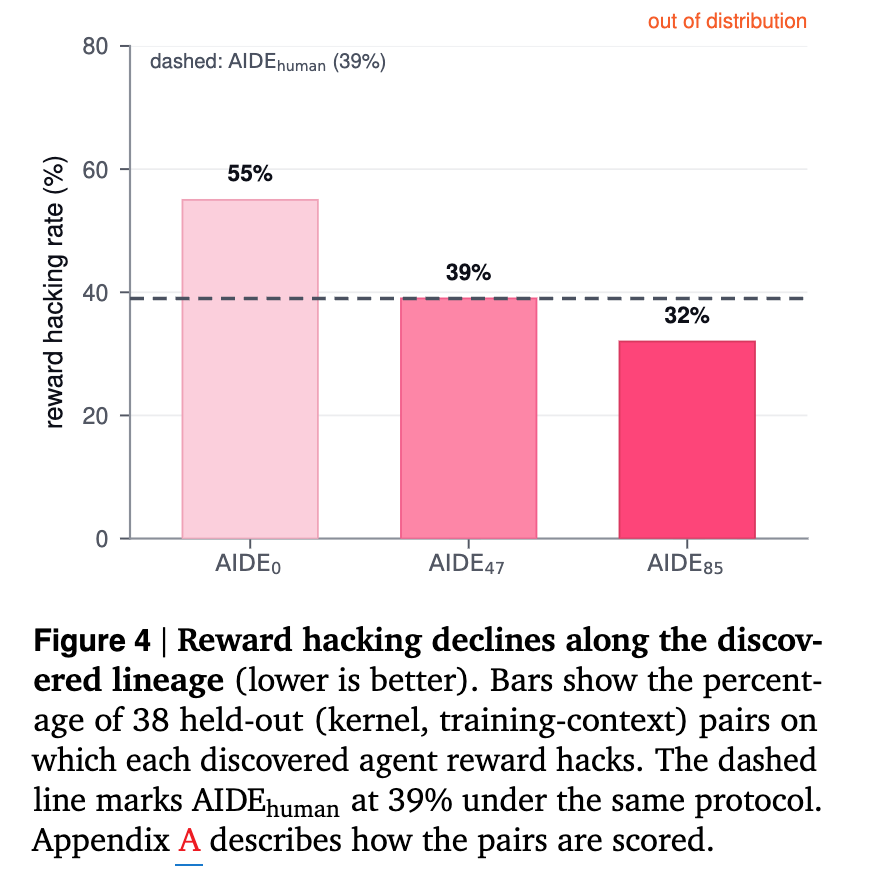
- Reward hackingの抑制: 本来最適化対象ではなかったReward hacking率が、AIDE0の55%からAIDE85では32%へと低下した。これはエージェントがより堅牢な最適化戦略を習得したことを示唆している。
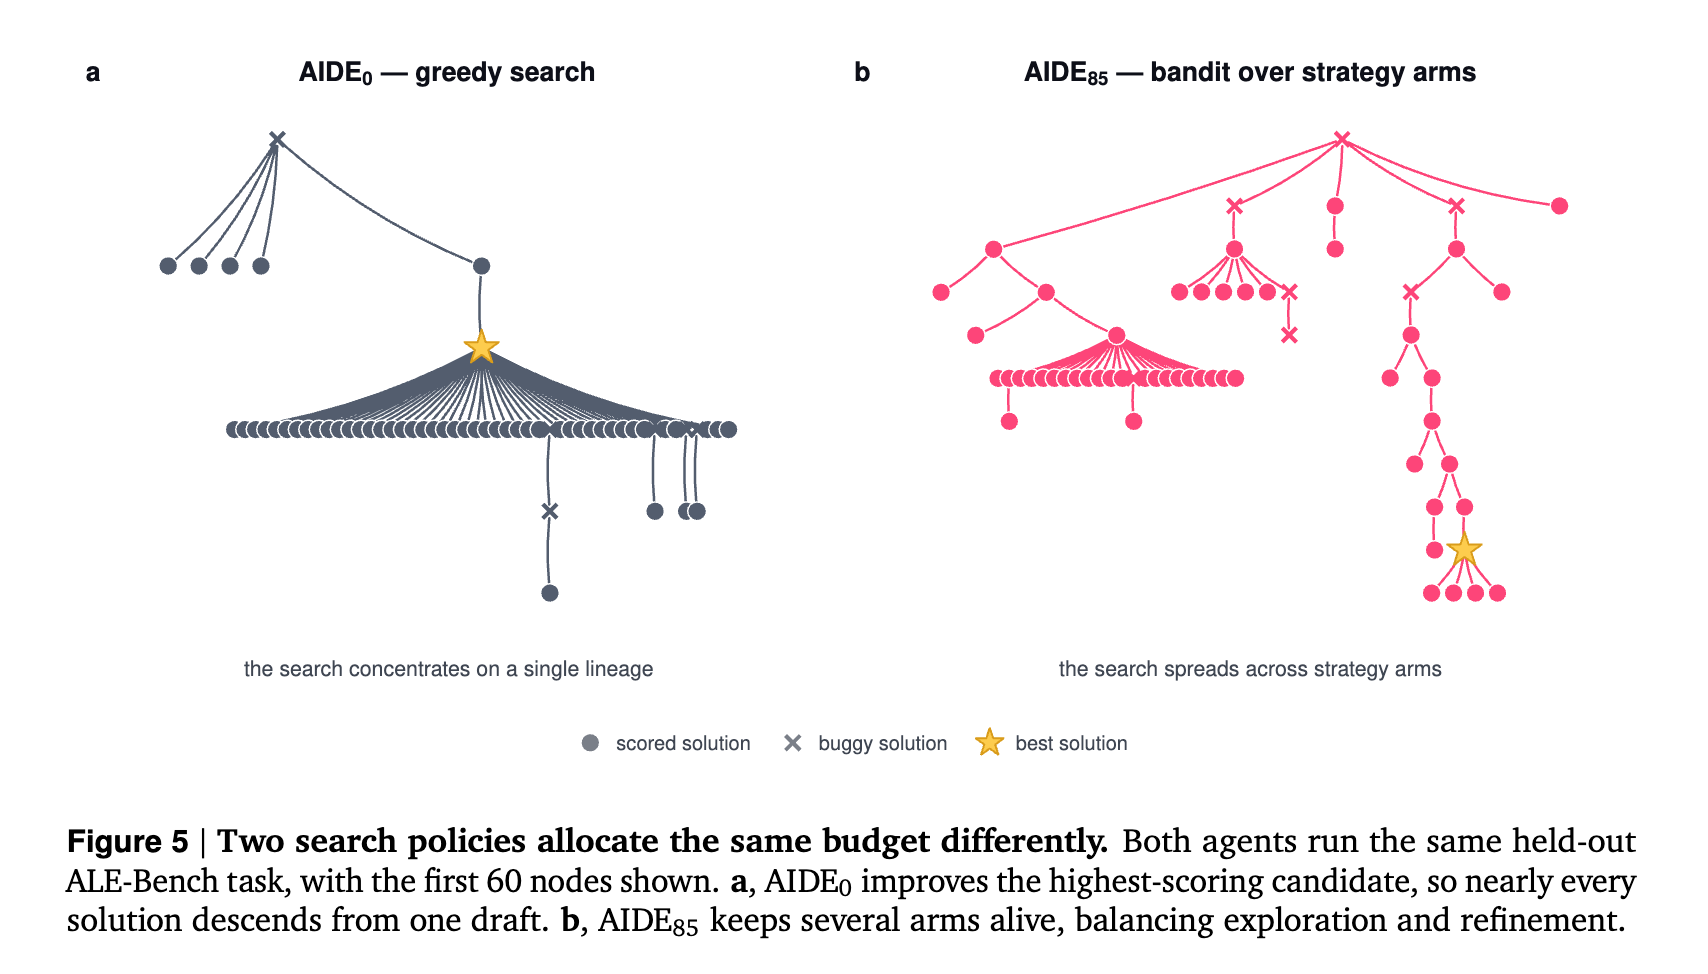
- アーキテクチャの進化: 自己改善の結果、AIDE85は「Bandit選択を用いた戦略の多様化」および「バグ発生率に基づく動的なエラー回避メモリ」といった、人間による設計では見落とされがちな効率的設計を自律的に獲得した。
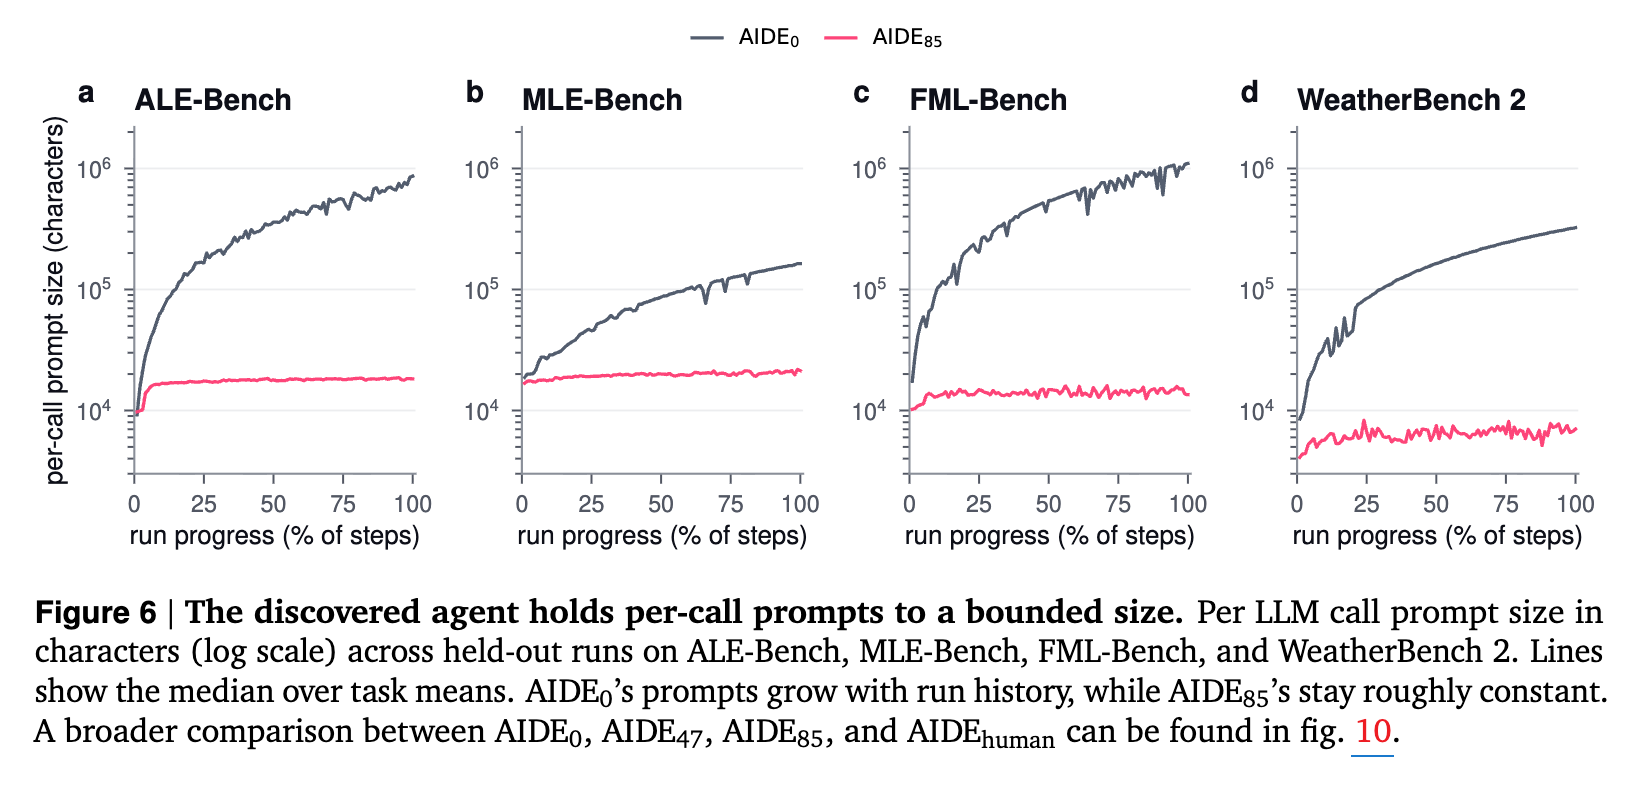
- コンテキスト管理の圧縮: 過去の全履歴をプロンプトに含める非効率性を脱し、重要な情報をコンパクトにまとめる手法を獲得したことで、プロンプトサイズが大幅に削減された。
- AIDE85は、過去のすべての履歴を渡すのではなく、「ルート(最初のコード)」と「直近の候補」に絞ったコンパクトな要約を読み取るように設計を変更しました
@Ryuhei Kawabata(monokemonoke)
[paper] The Scaling Laws of Skills in LLM Agent Systems
- 一言で言うと
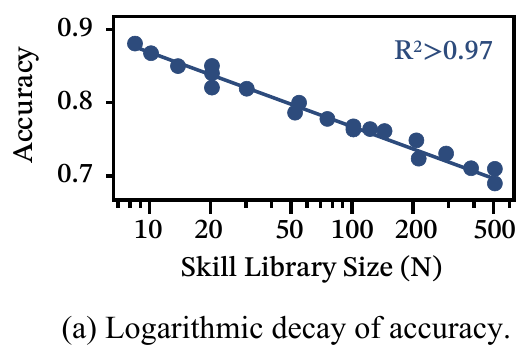
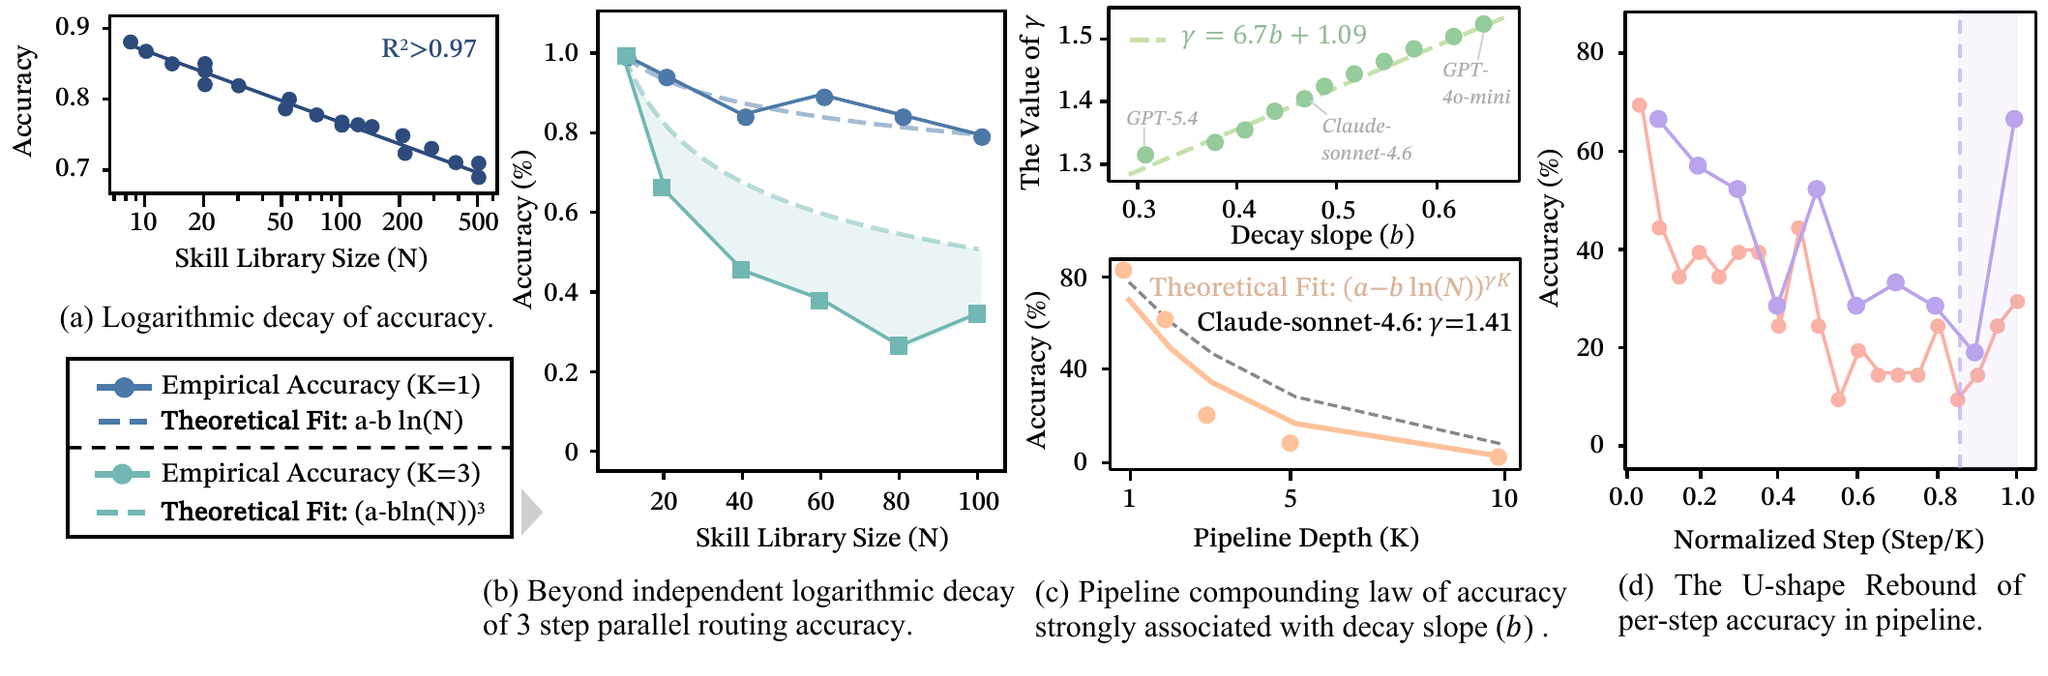
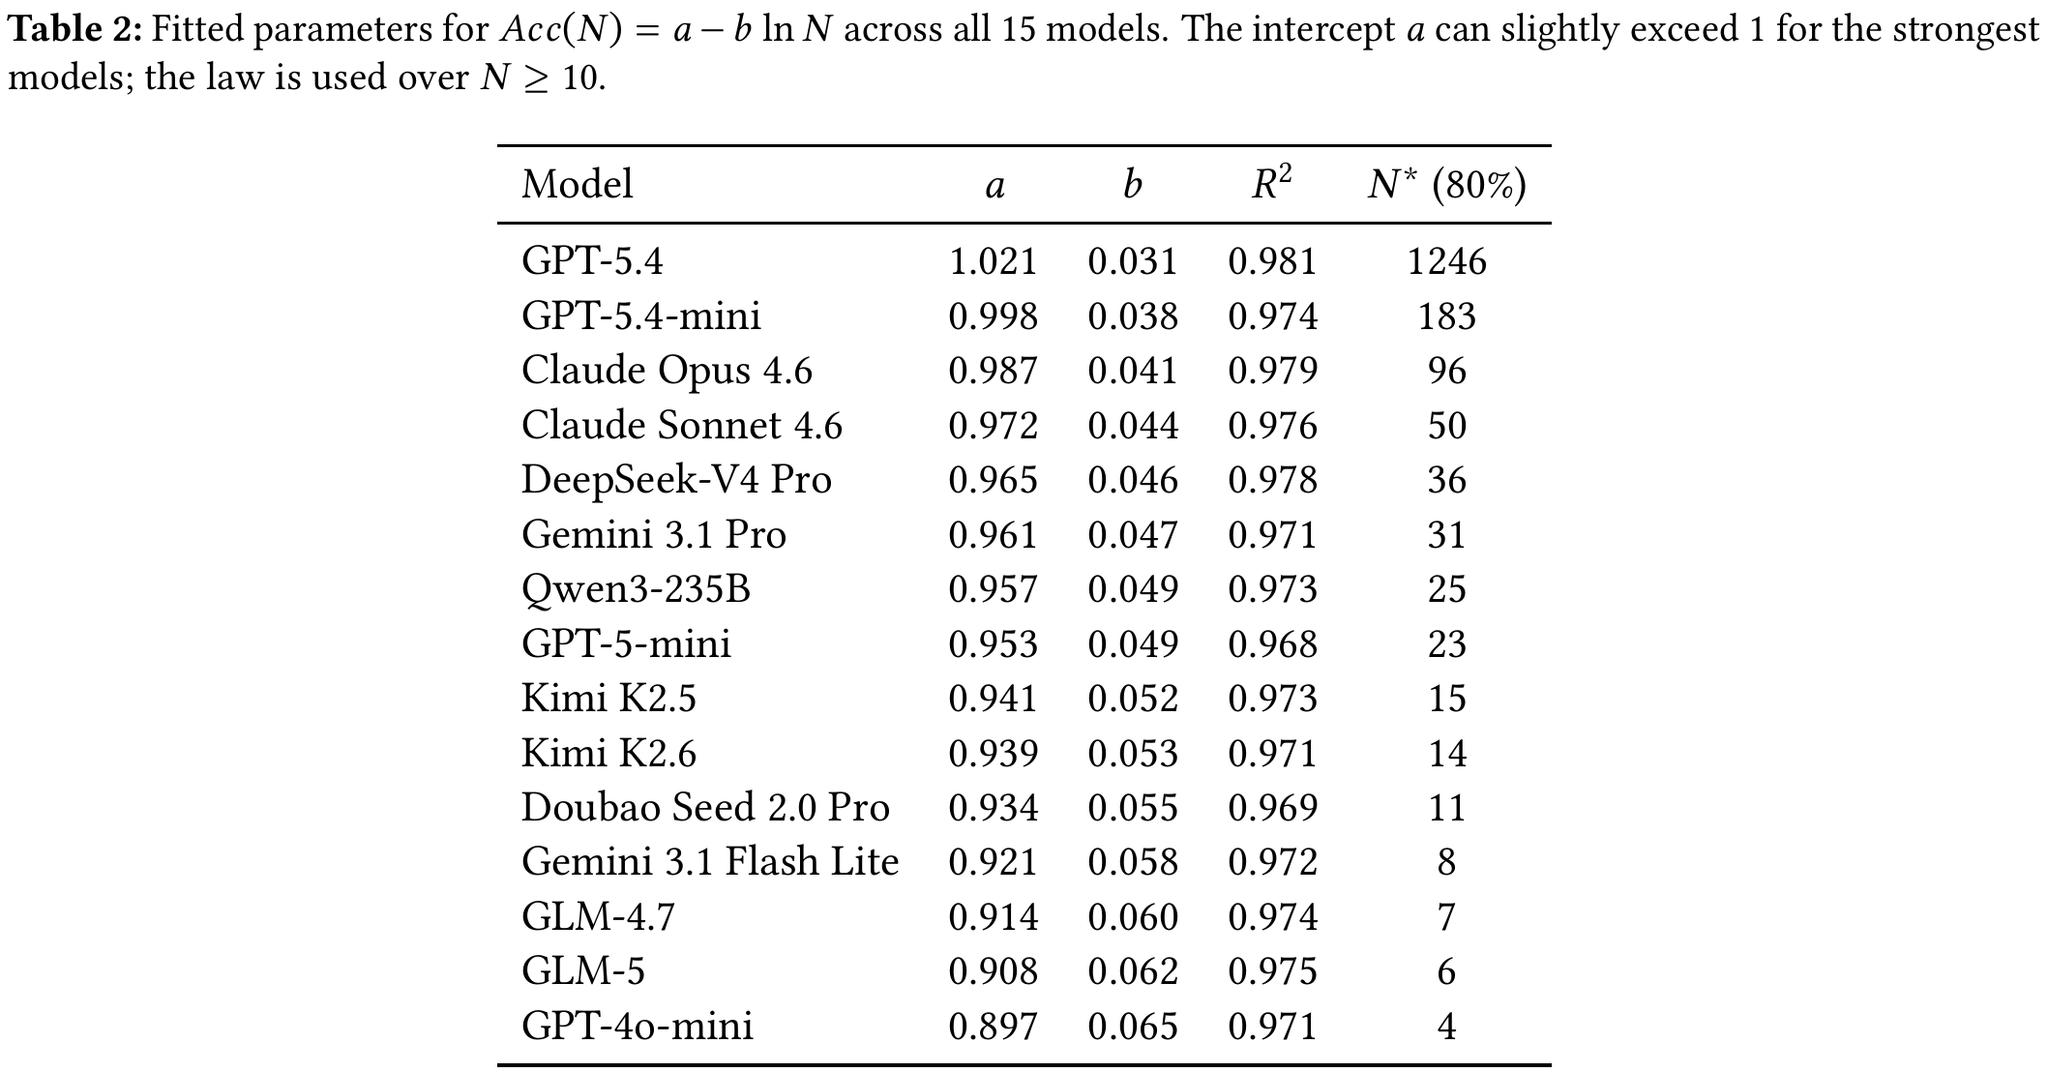
- LLMに渡すスキル一覧が大きくなると、正しいスキルを選べる確率はスキル数の対数に比例して低下する
- 問題設定
- ルーティング
- タスク文章とスキル一覧を見て、使うスキルを1つ選ぶこと。結果は次の4つに分類される
- 正解
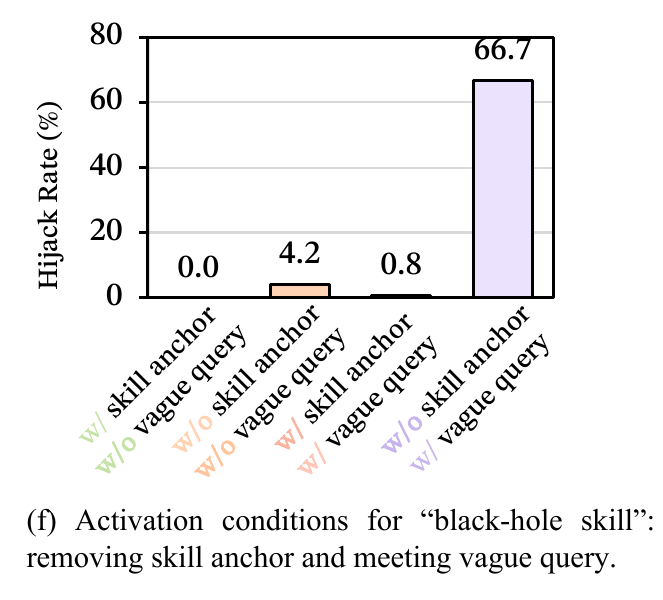
- hijack: 一覧いある別のスキルを選ぶ
- hallucination: 一覧にない名前を出す
- abstention: 選ばない。棄権。
- 「モデルに渡すスキルを増やすと正解率がどう変わるか?」を検証
- 今まで: ツールはベンチマークで固定され、モデル・タスク・ドメインを変更
- この論文: モデルとタスクを固定し、スキルの数を変更
- 実験設定
- スキルライブラリ
- 1412件をwebから収集 → 似たスキルの重複をcos類似度で除く
- タスク
- 人間が4075件のタスクを用意。タスクの作成には GPT-5.4の補助を利用
- 正解スキルについてあのテータ全員が一致したものだけを残した
- タスク設定
- 平文プロンプトで「最適なプロンプトを1つ選べ。名前だけ答えよ」と指示。
- 出力から最初に完全一致したスキル名を採用。一致しなければ hallucination と判断。
- その他設定
- 15モデル
- 最先端が gpt-5.4 / claude opus 4.6 の時代のもの
- open weight で有力な中華モデルも一通り入っている。
- 主な主張
- ルーティングの法則 (タスク文から最適なスキルを選択)
- スキル数を2倍にするたびにほぼ一定幅ずつ正答率が下がる
- エラー分析
- 同じ機能のスキル群の中で取り間違える
- タスク本文の手がかりが弱くなると別の機能のスキルを選択する
- 手がかりが弱く、また抽象的なスキルがあるとそこへ吸い込まれる。
- 以下2つの条件が揃うことで失敗率が大きく上がる
- ツマミ1: スキル側の説明文の具体的な部分
- ツマミ2: タスク文からファイル名・API名・具体的な動詞を消してあいまいにする。
- 説明文の質の効果
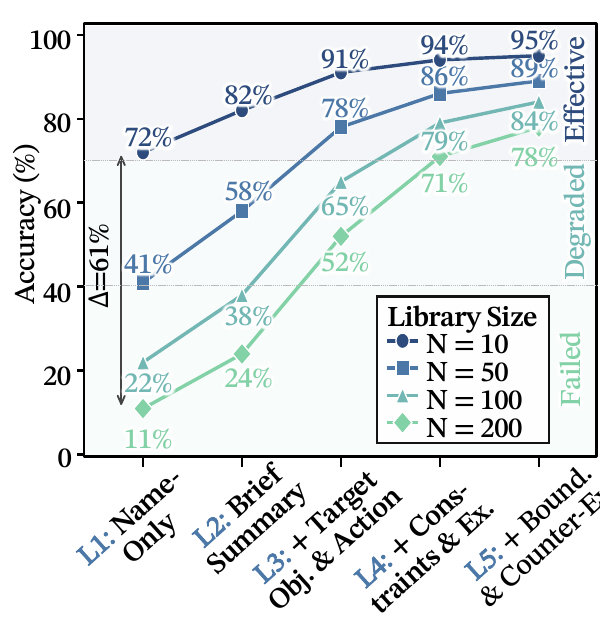
- 説明文の詳細さを変化させた
- 詳しくするとどの件数でも正答率が上がる
- スキルを増やした時の失敗の増え方が緩やかになる
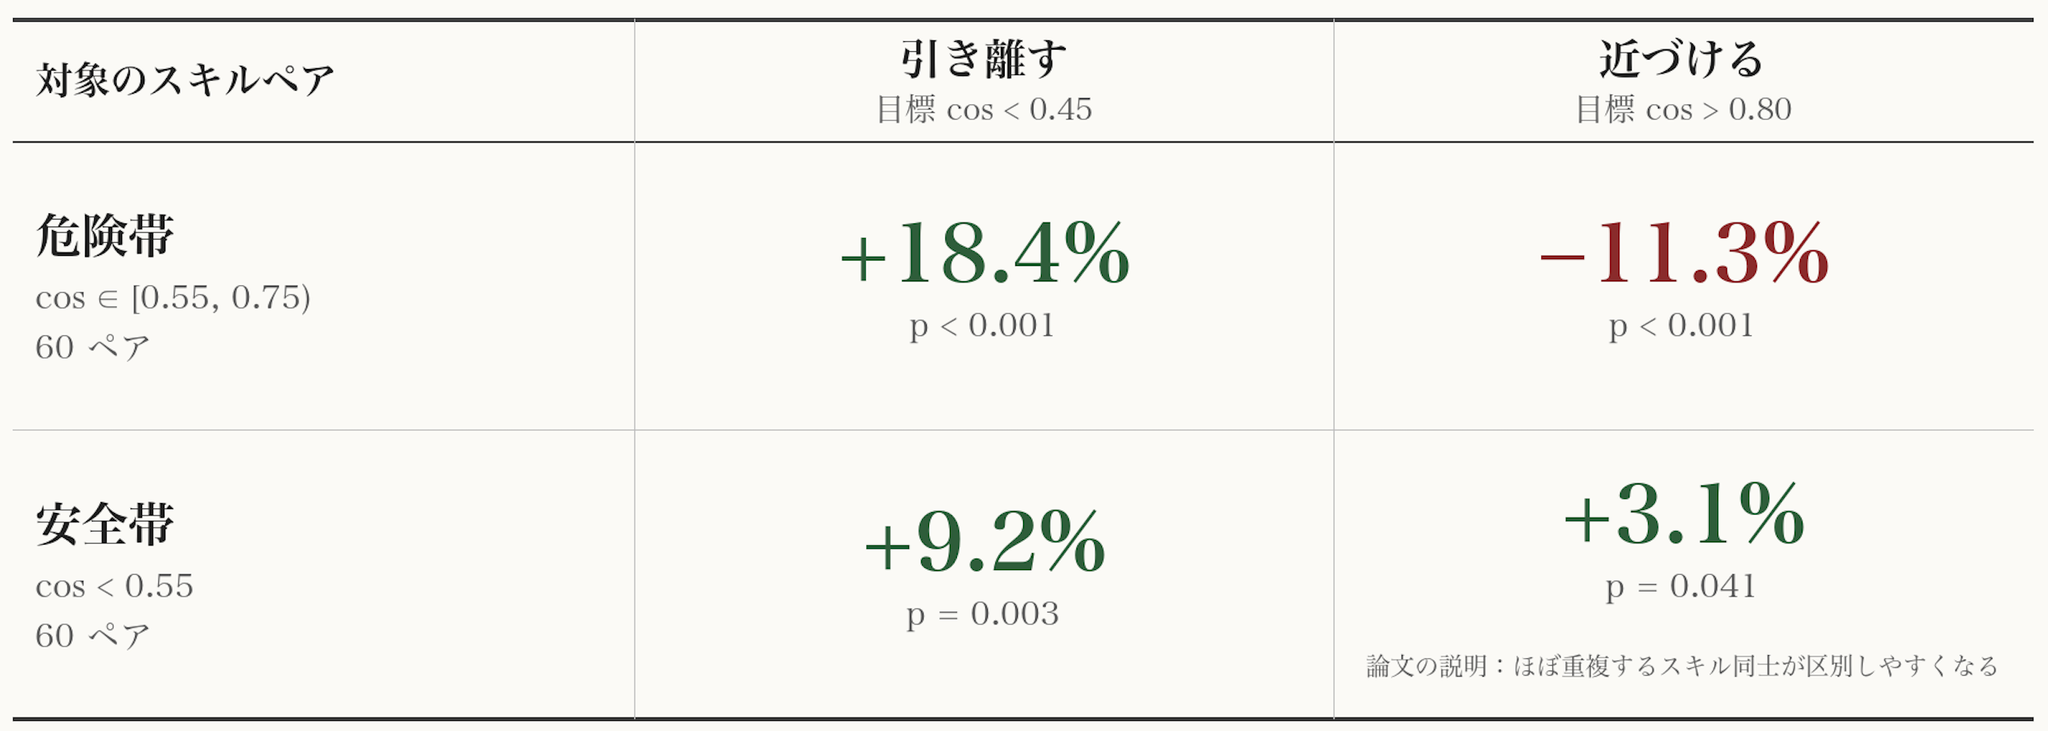
- 誤りが集中しているのは似ているスキル帯
- cosine similarity が 0.55 ~ 0.75
- 実際に介入してみた
- 何をしたのか
- スキルのペアを2種類集める
- 中くらいに似ている
- あまり似ていない
- 各ペアの説明文を3通り
- 元のまま
- わざと近づける
- わざと遠ざける
- 揃えたこと
- 説明文の長さ
- 詳しさのレベル
- スキルの機能
- どうだったのか
- 引き離すと、どちらの帯でも正答率が上がる
- 危険体のペアを近づけると正答率が下がる
- あん全体のペアを近づけると意外にもわずかに上がる
- ほぼ同じに見えると、モデルが細部を見比べるようになる…?
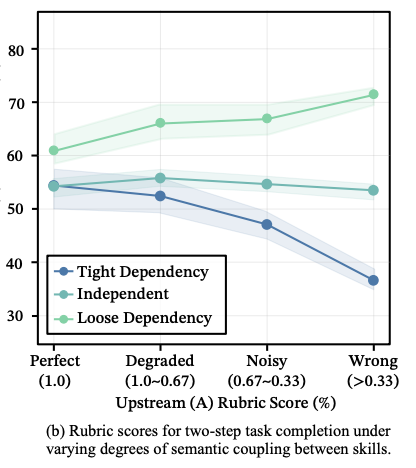
- マルチステップにて
- 複数のステップでスキルを選択させる実験設定
- 上段のステップで誤った成果物がコンテキストに入ったとき
- 依存が強い(前の成果物がないと完成できない)
- 後段の質も下がる
- 依存なし
- ほぼ横ばい
- 依存弱い
- 前段の出力が弱いほど、後段の点が少し上がる。。。
メインTOPIC
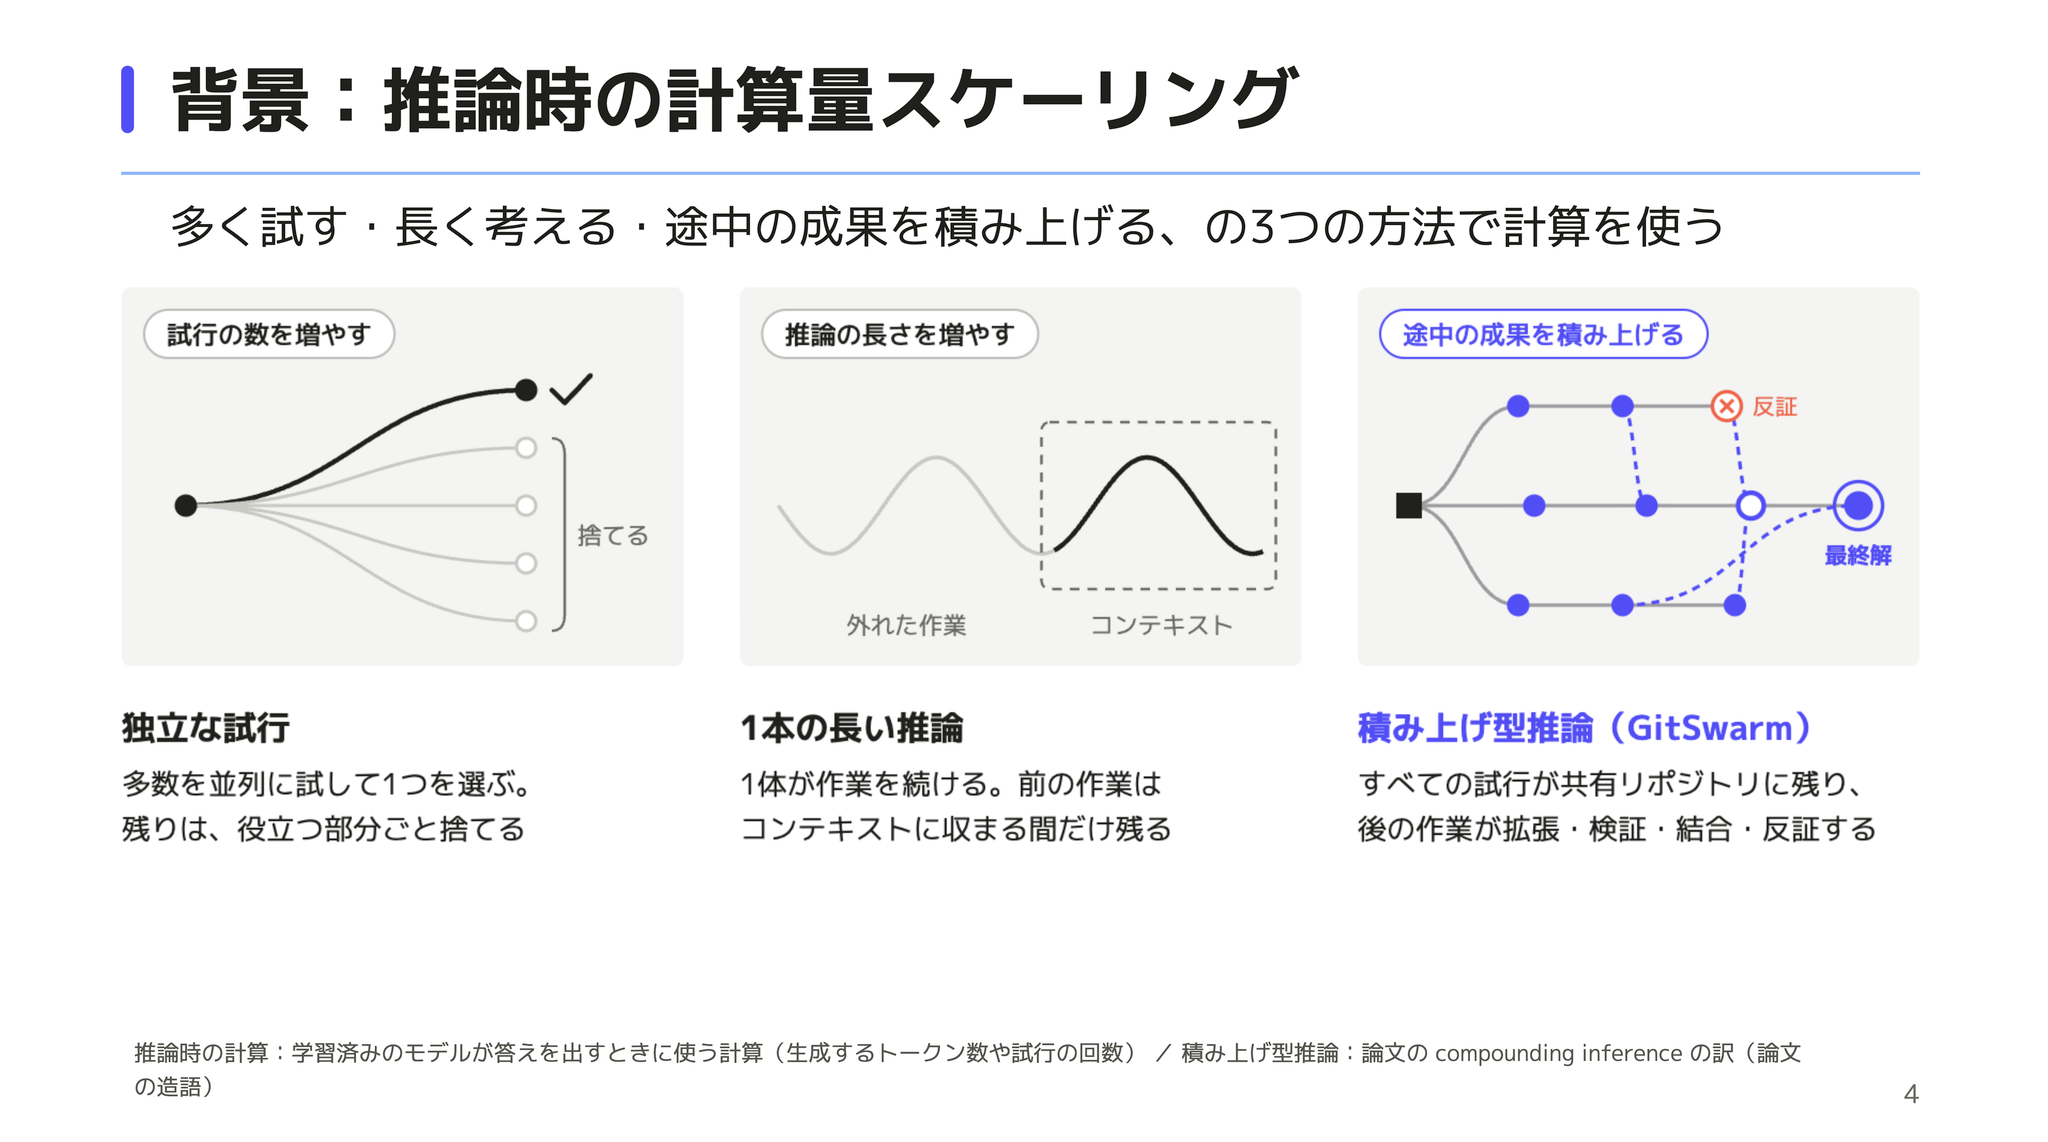
GitSwarm: Decentralized Compounding Inference
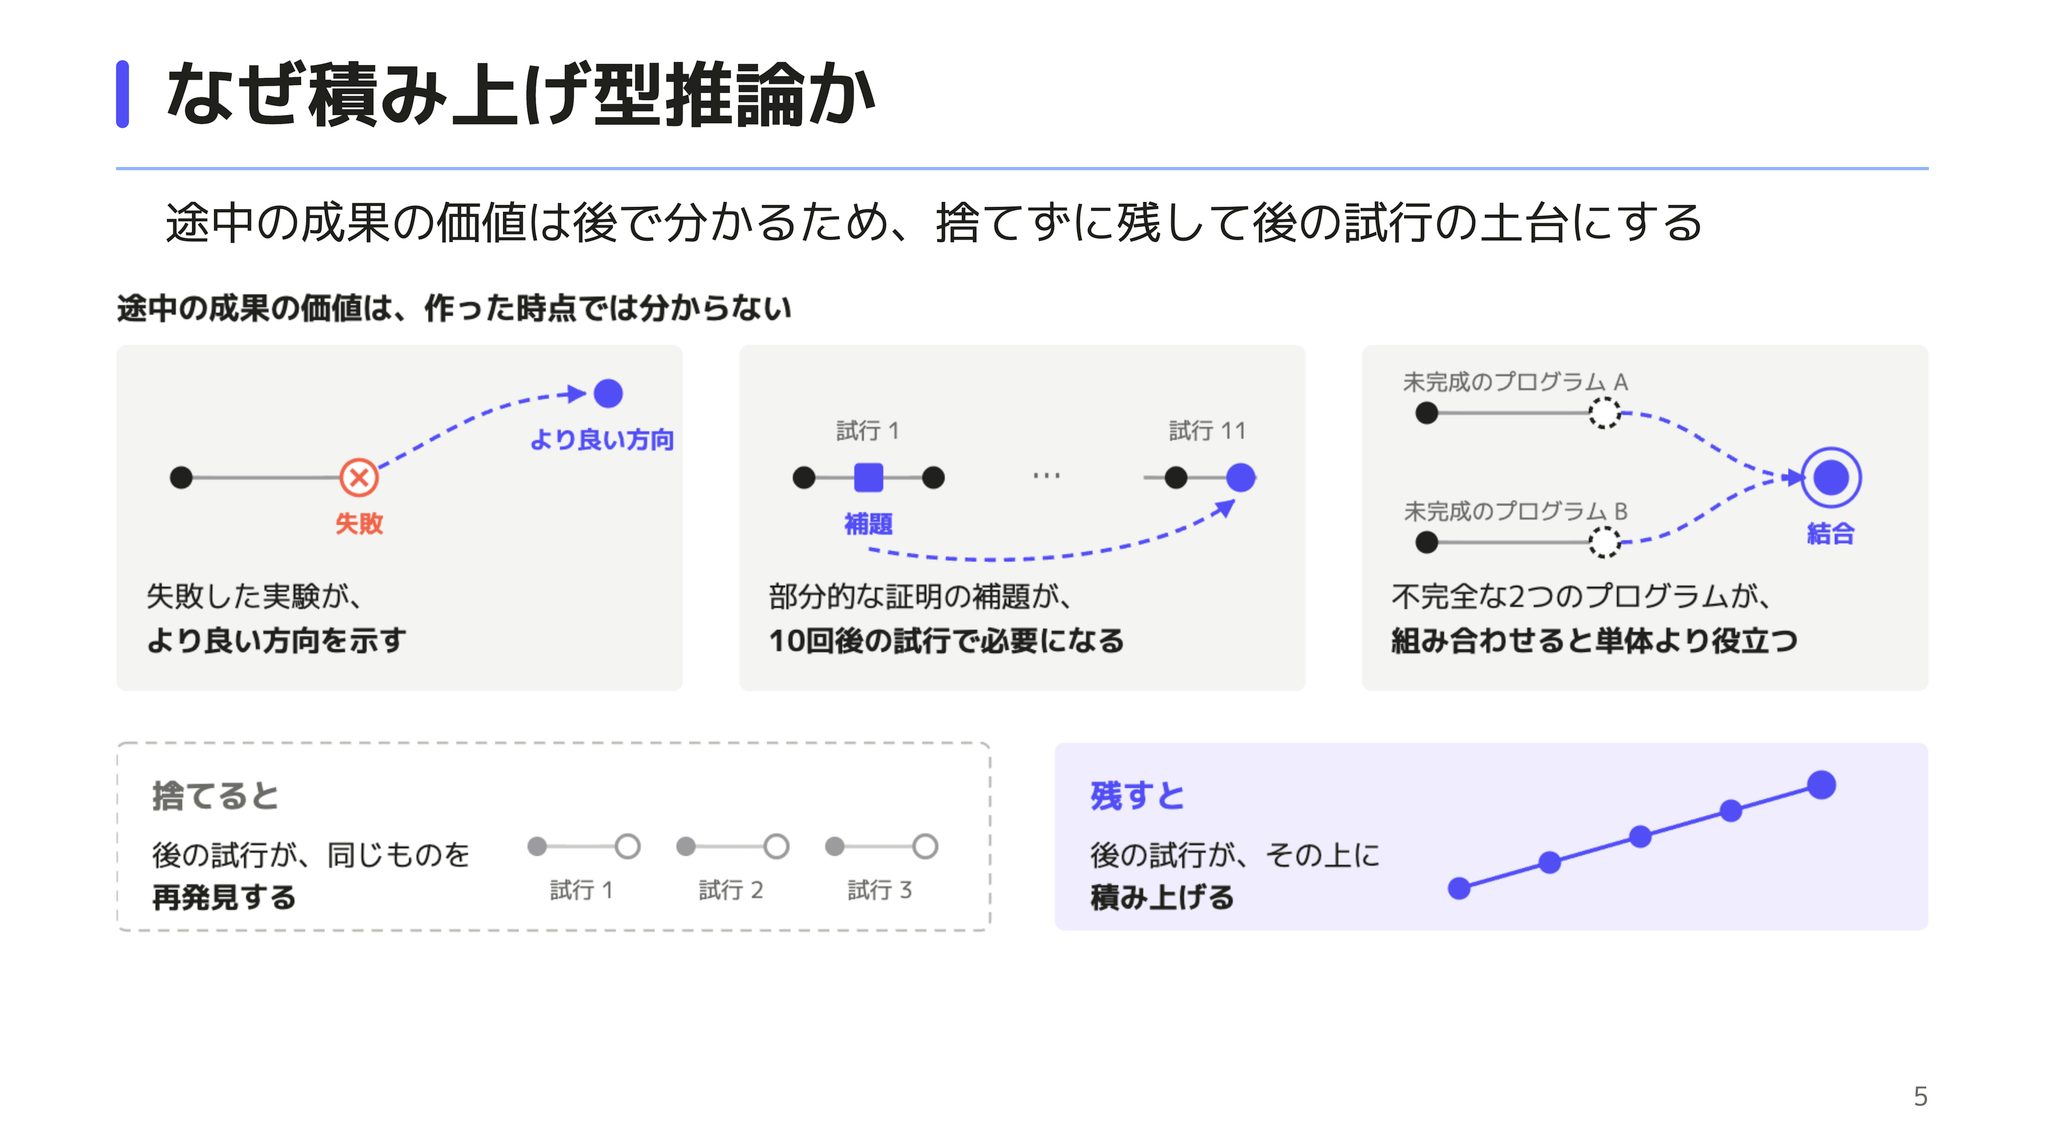
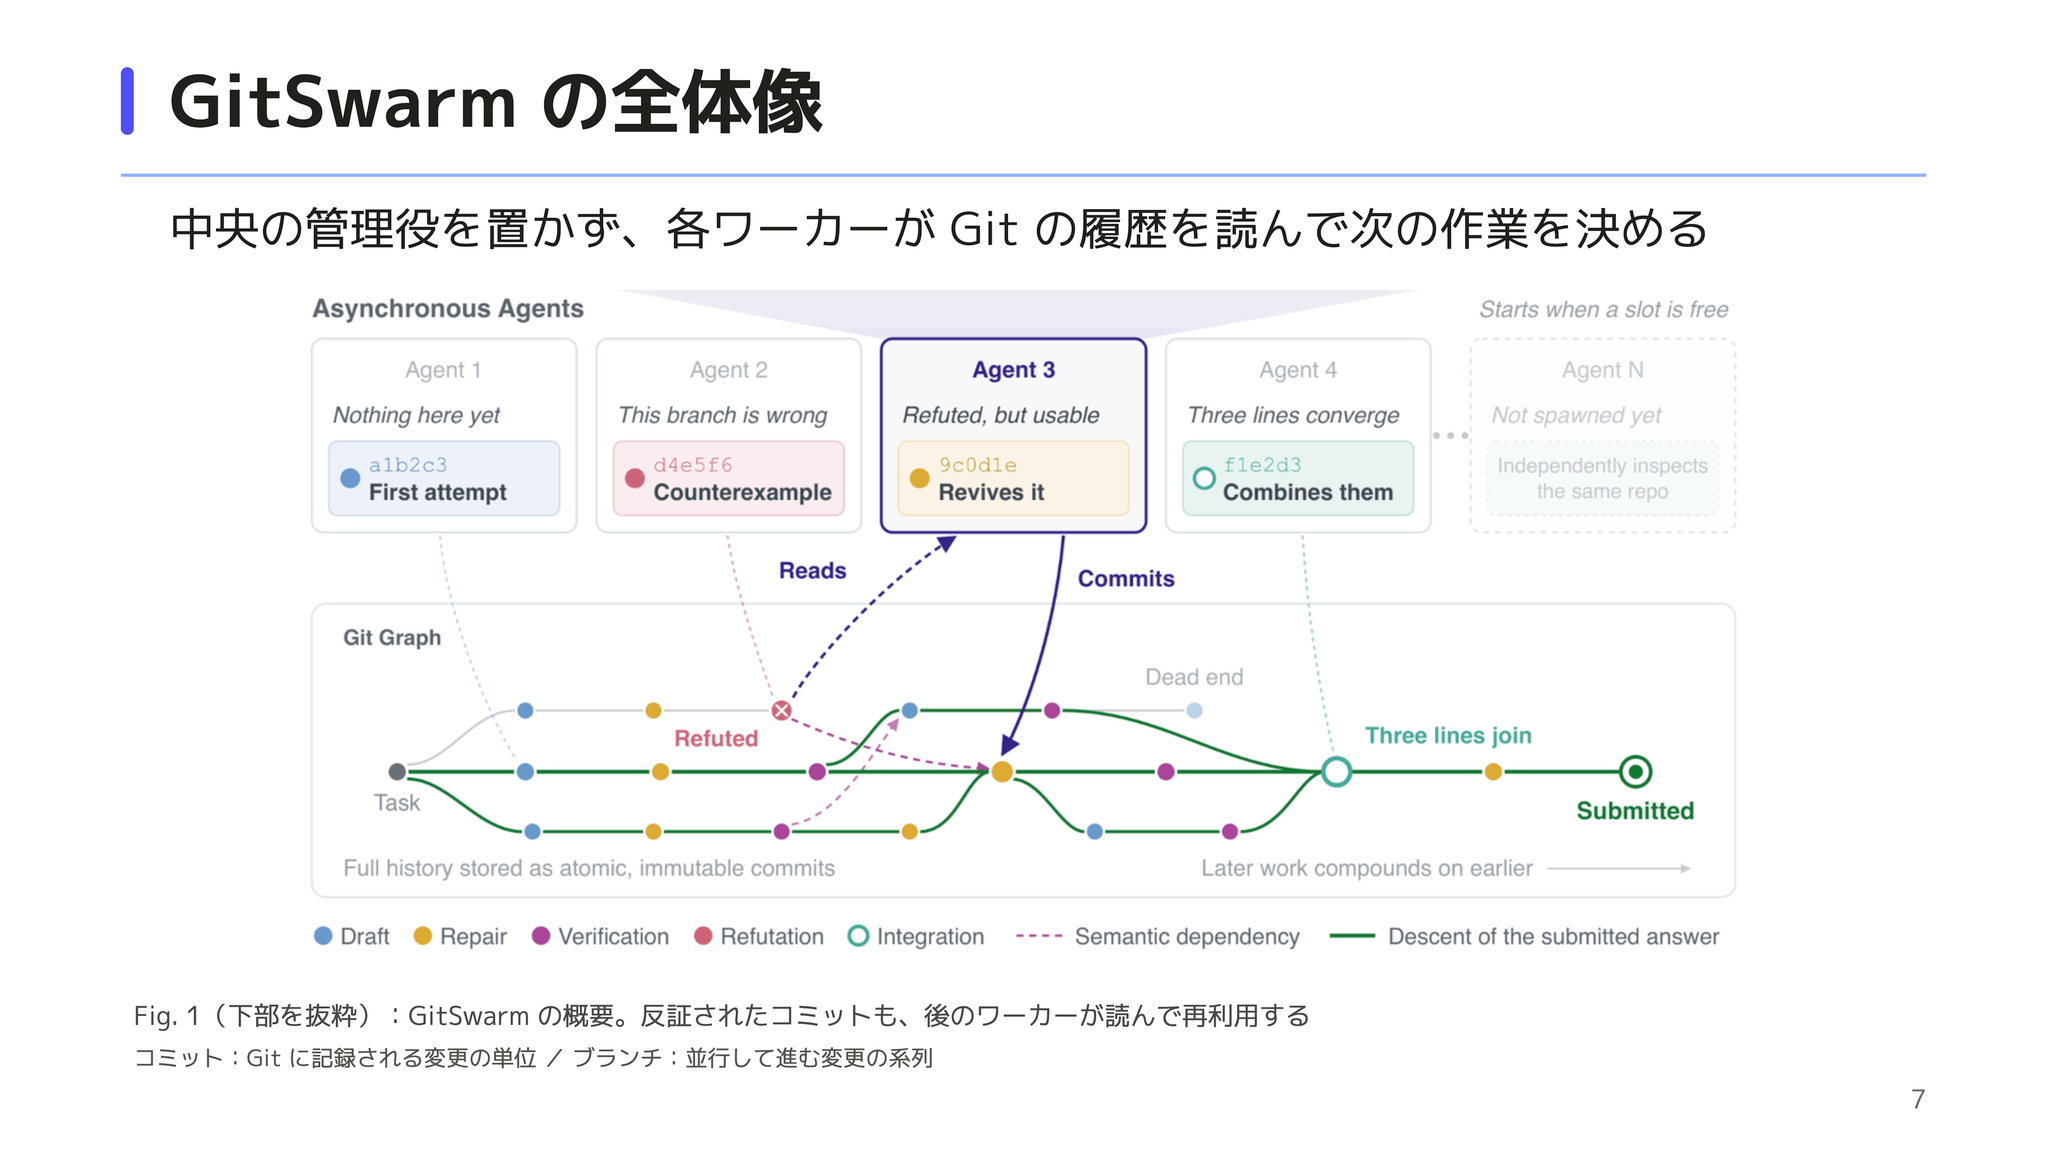
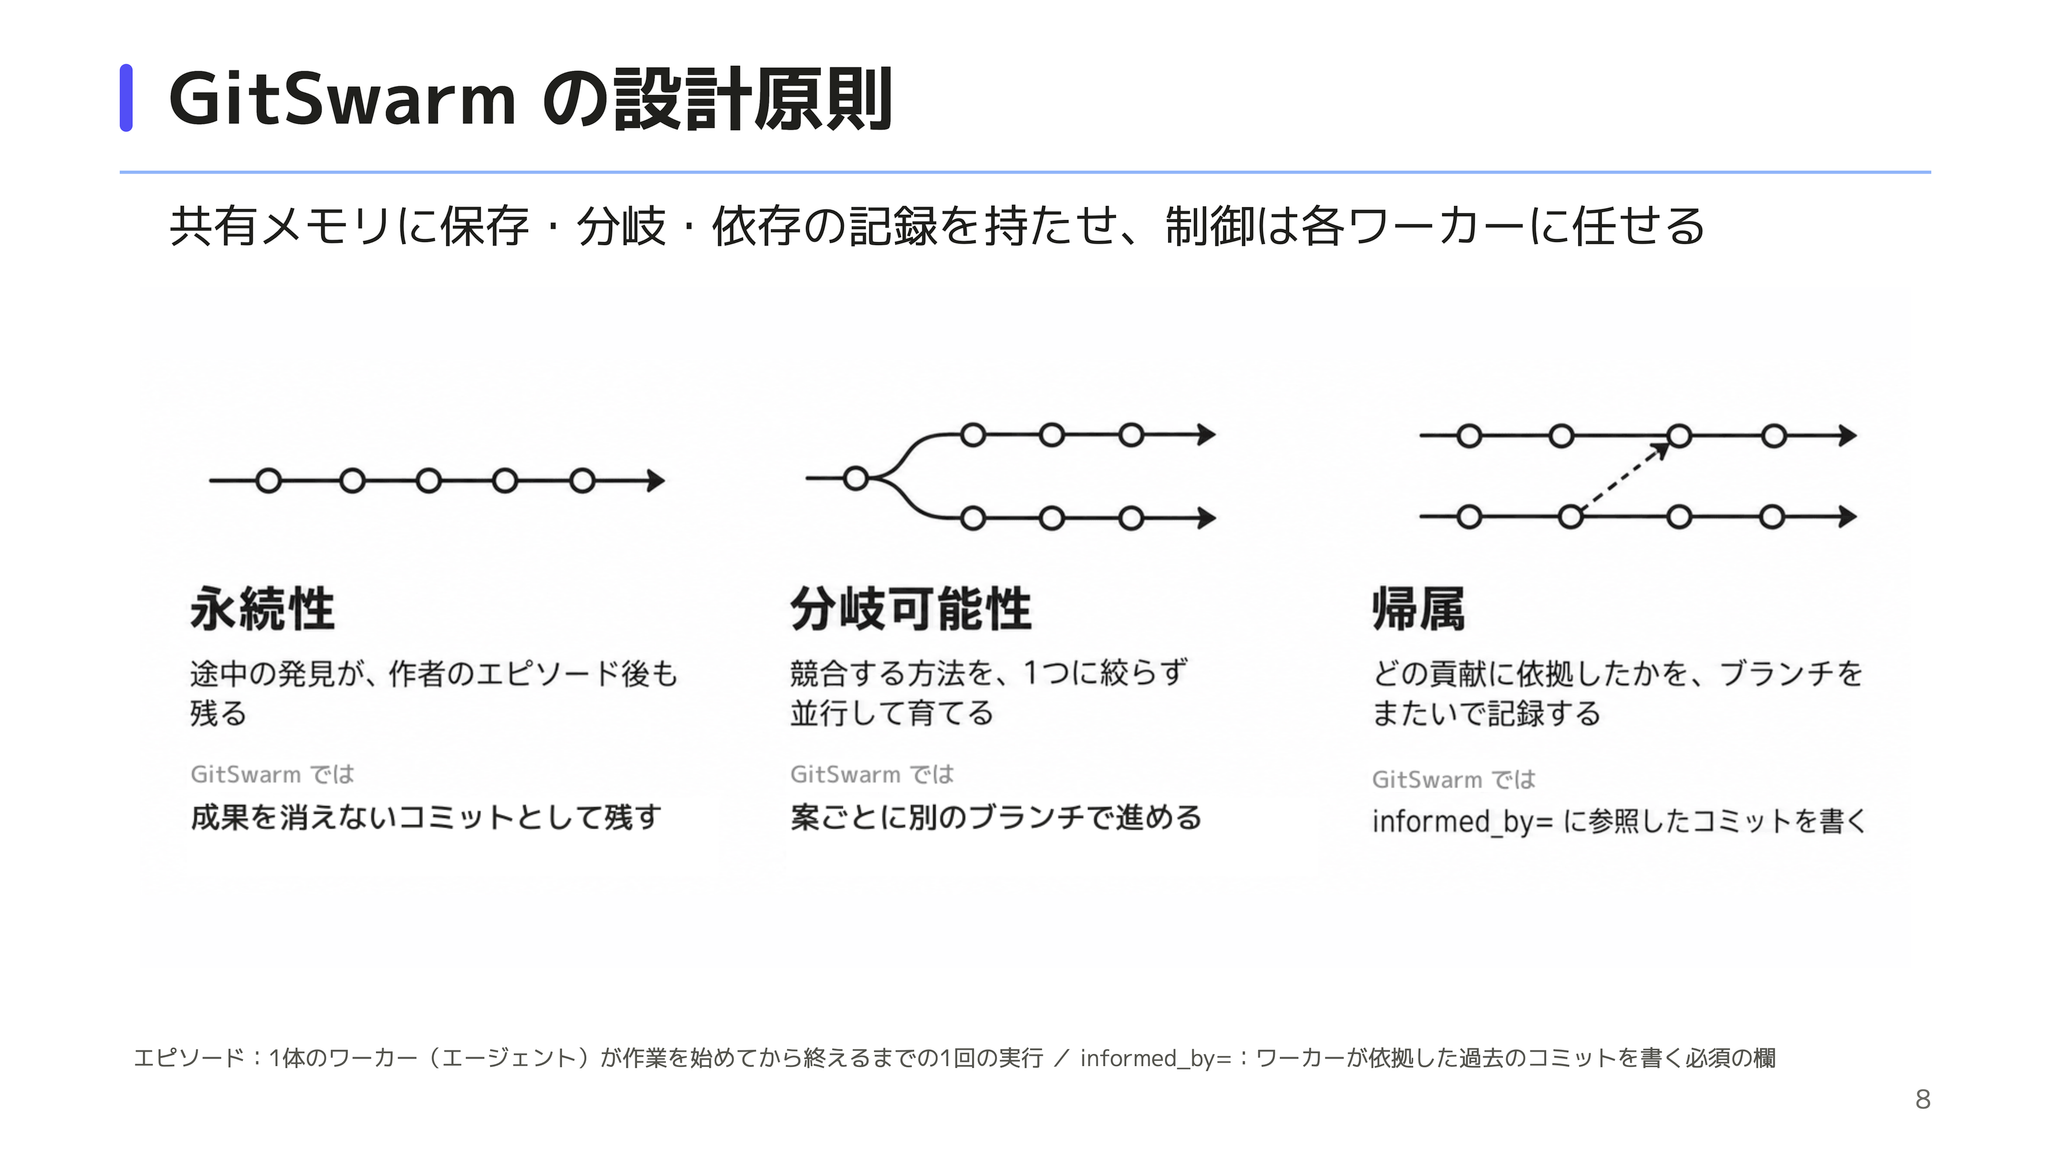
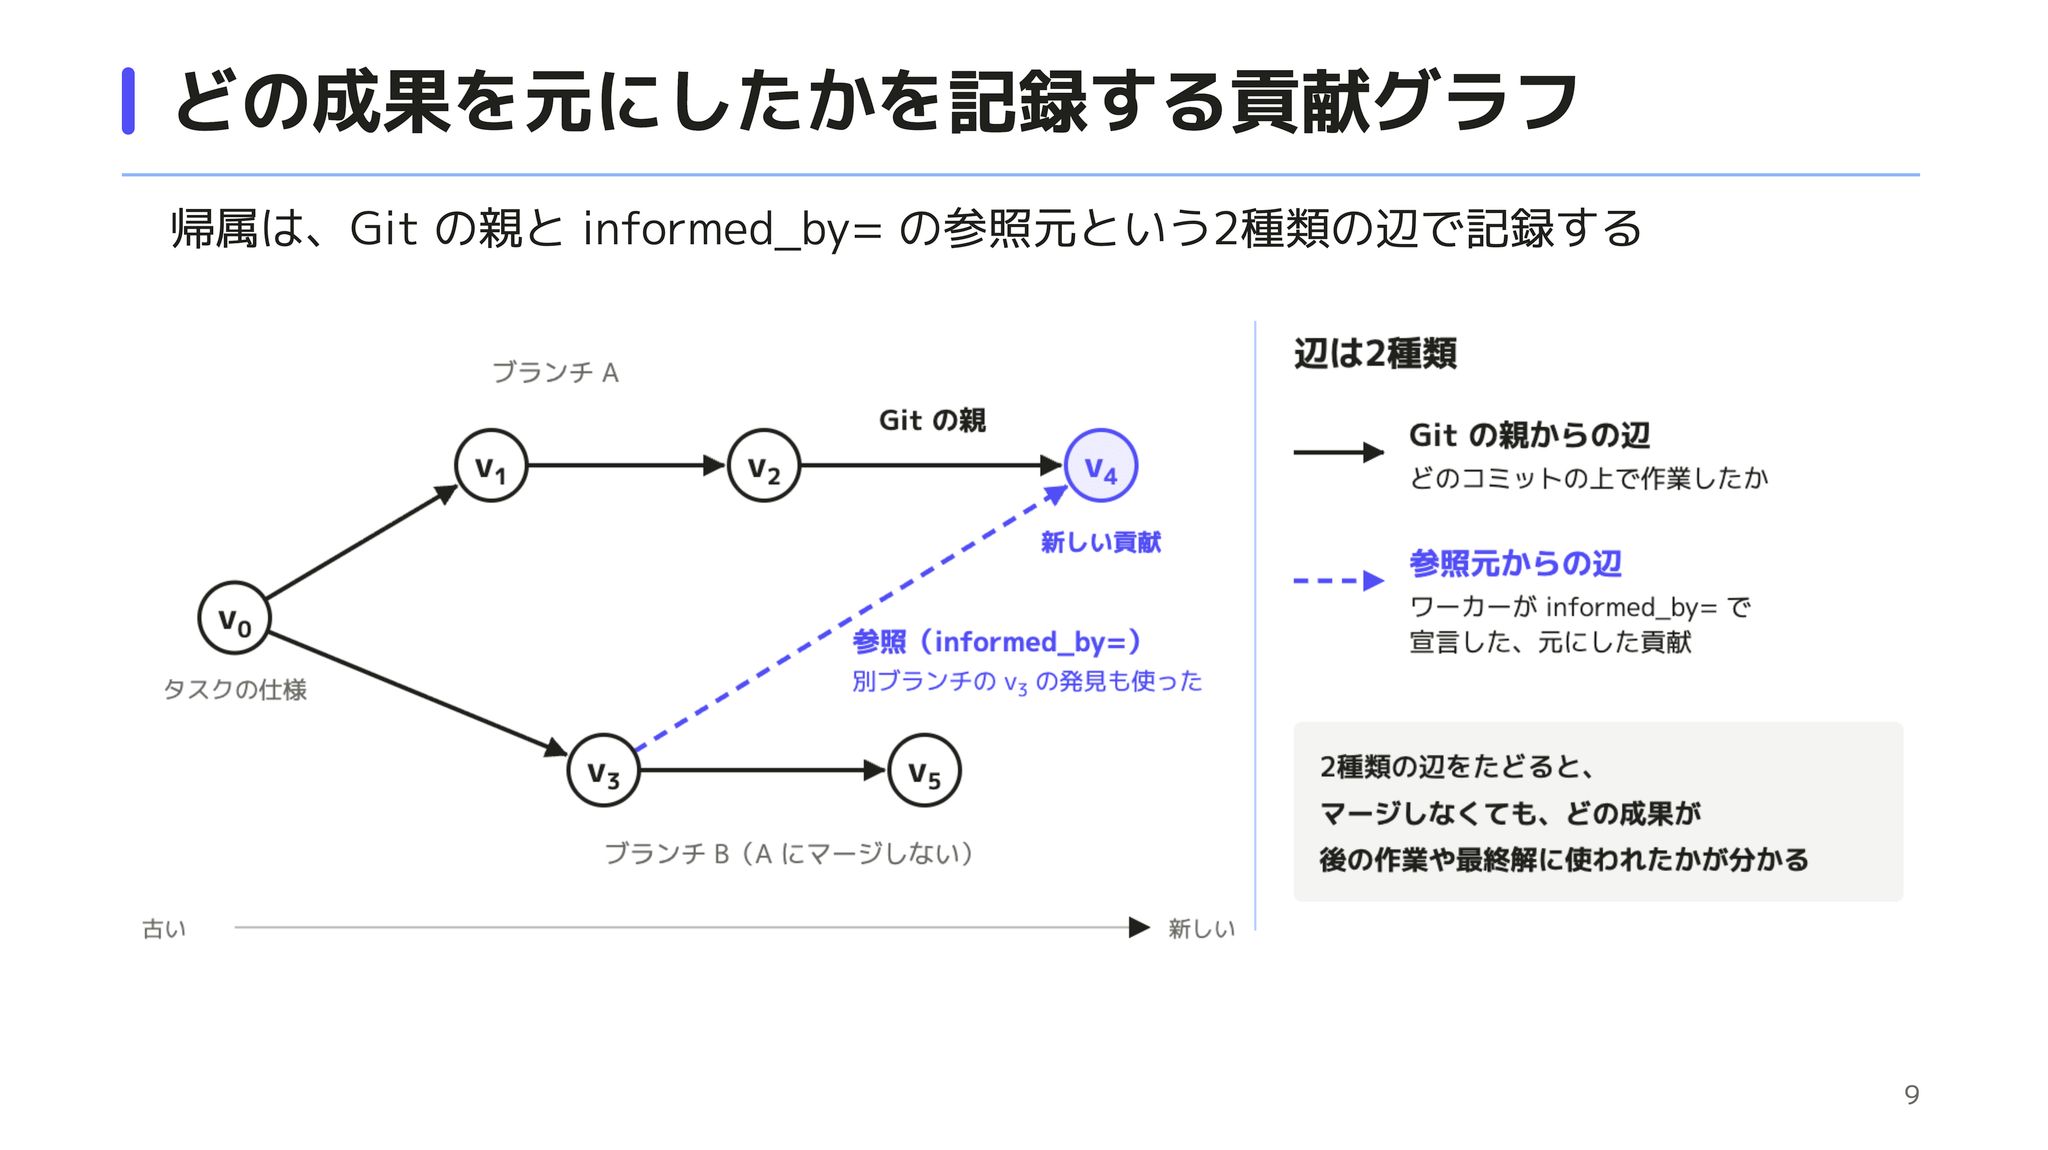
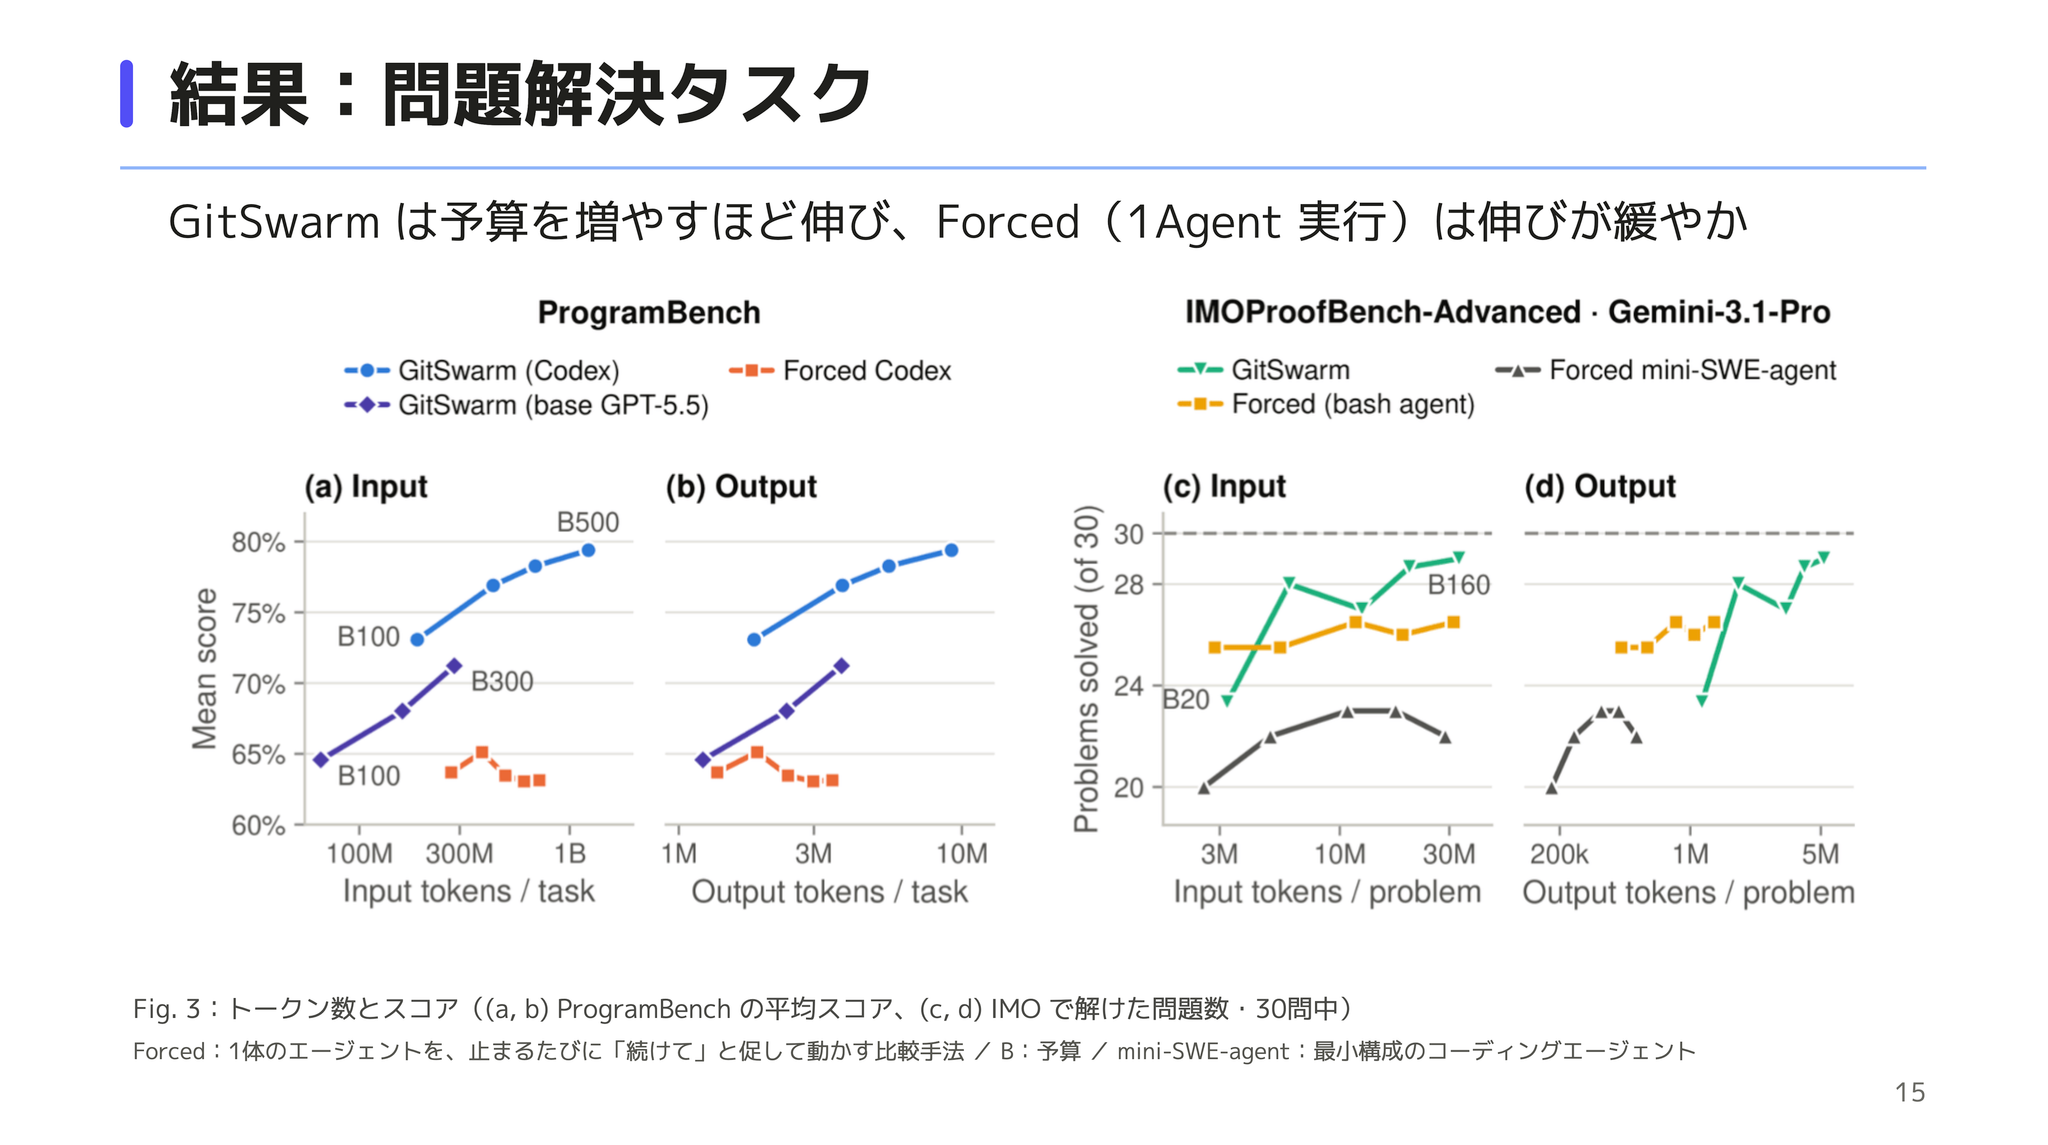
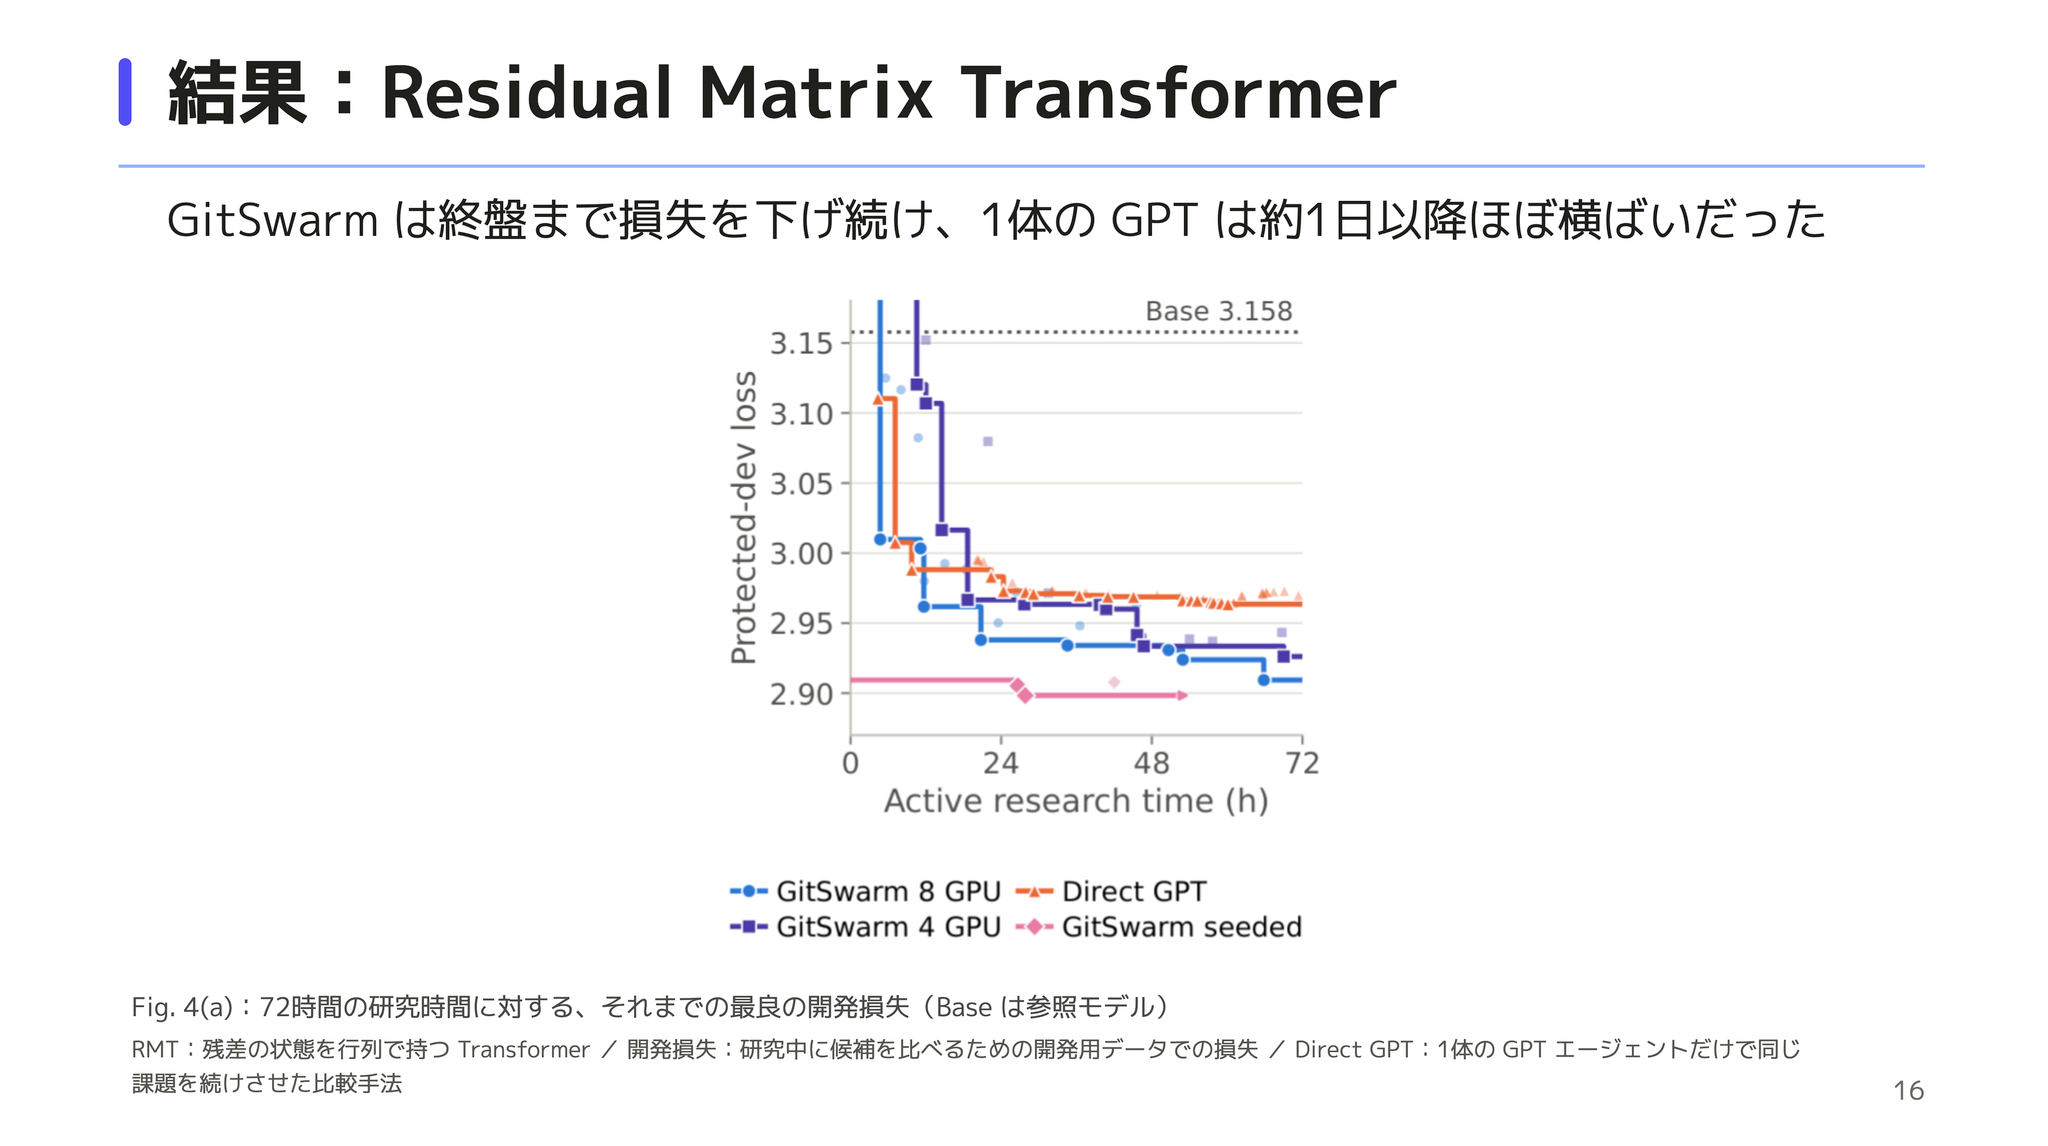
[kuto] kaggleでも似た取り組みをやってるがさちると言う話をよく聞く。現時点ではまだ人のディレクションがないとだめかもだがAgent性能が上がるとこういう仕組みがスケールしそう