2026-10-20 機械学習勉強会
今週のTOPIC[paper] jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation[paper] QD-Rec: Open-Ended Evolution of Recommendations via Quality–Diversity[paper]OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use[blog] Augmenting Human Preference in Complex DomainsメインTOPICStrata - Run a 125-billion-parameter AI model on your own gaming PC要旨1. はじめに2. 対象モデル3. システム設計3.1 三つのメモリ tier3.2 1 層の中の分担3.3 会話に追従する expert cache3.4 低 RAM モード4. デコード: 推測して検証する4.1 MTP 層による投機的デコーディング4.2 1 回の verify window の時間4.3 tail skip: 順位の低いミスを計算しない5. prefill と長いコンテキスト5.1 転送と計算を重ねる5.2 長いコンテキストのコストは VRAM6. 会話状態と同時リクエスト6.1 会話キャッシュ6.2 batch slot7. 複数 GPU と他のハードウェア7.1 layer split8. 評価8.1 測定の条件8.2 速度8.3 品質8.4 他の GPU8.5 正確さ9. 限界と今後過去の勉強会
今週のTOPIC
※ [paper] [blog] など何に関するTOPICなのかパッと見で分かるようにしましょう。
技術的に学びのあるトピックを解説する時間にできると🙆(AIツール紹介等はslack channelでの共有など別機会にて推奨)
出典を埋め込みURLにしましょう。
@Naoto Shimakoshi
[paper] jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
- 一言で言うと
- Jina AI の 0.6B listwise リランカー v3 の後継。
- (1) 28 層のうち 17 層を sliding-window にしたハイブリッド注意
- (2) 法務・医療・金融・多言語・半構造化データを狙い撃ちした学習デー
- (3) 「同サイズで全注意の教師 → 疎注意の生徒」という 3 段階の自己蒸留の 3 点で速さ・ドメイン網羅・構造化データ理解を同時に改善した
- BEIR 63.20 で約 7 倍大きい Qwen3-Reranker-4B を上回り、Struct-IR で v3 比 +9.6pt、長文の再ランクで 1.56 倍高速
- 背景
- 問題設定
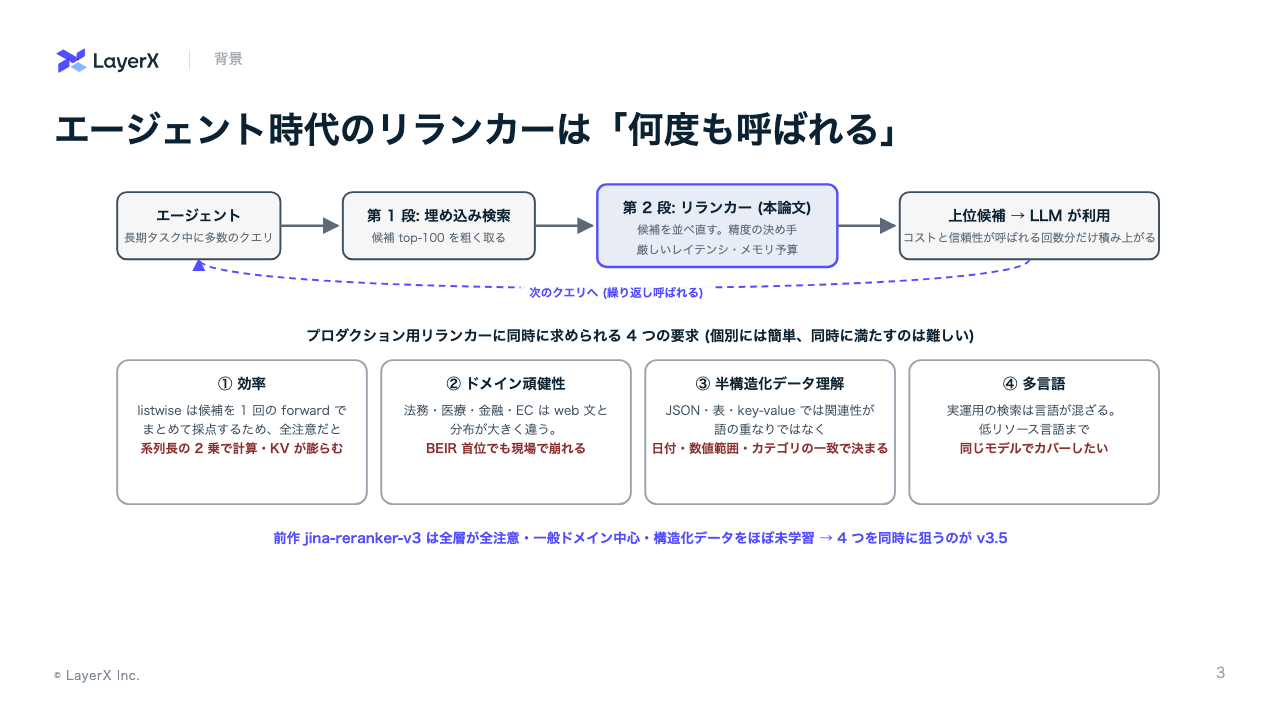
- リランカーは検索パイプラインの最終段で、エージェントが長期タスク中に何度もクエリを投げるので、コストと信頼性が呼ばれる回数分だけ積み上がる
- 本番で同時に求められる 4 つの要求: 効率 / ドメイン頑健性 / 半構造化データ (JSON・表) の理解 / 多言語
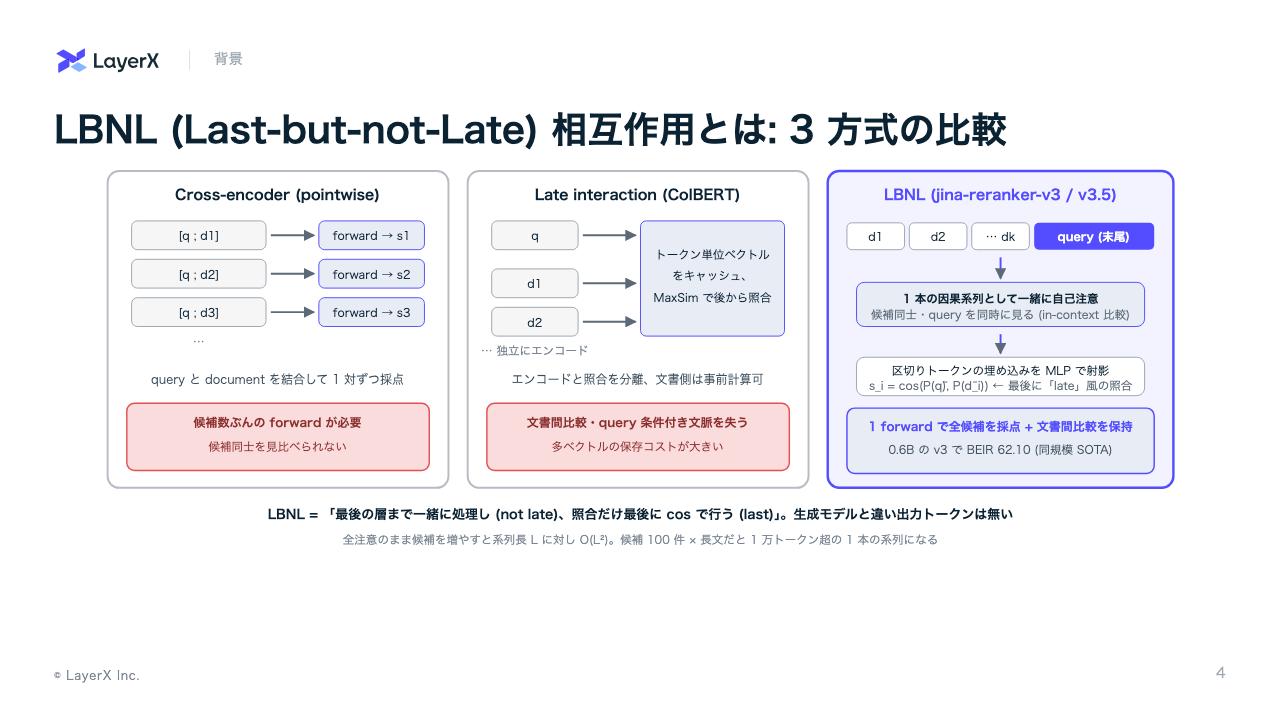
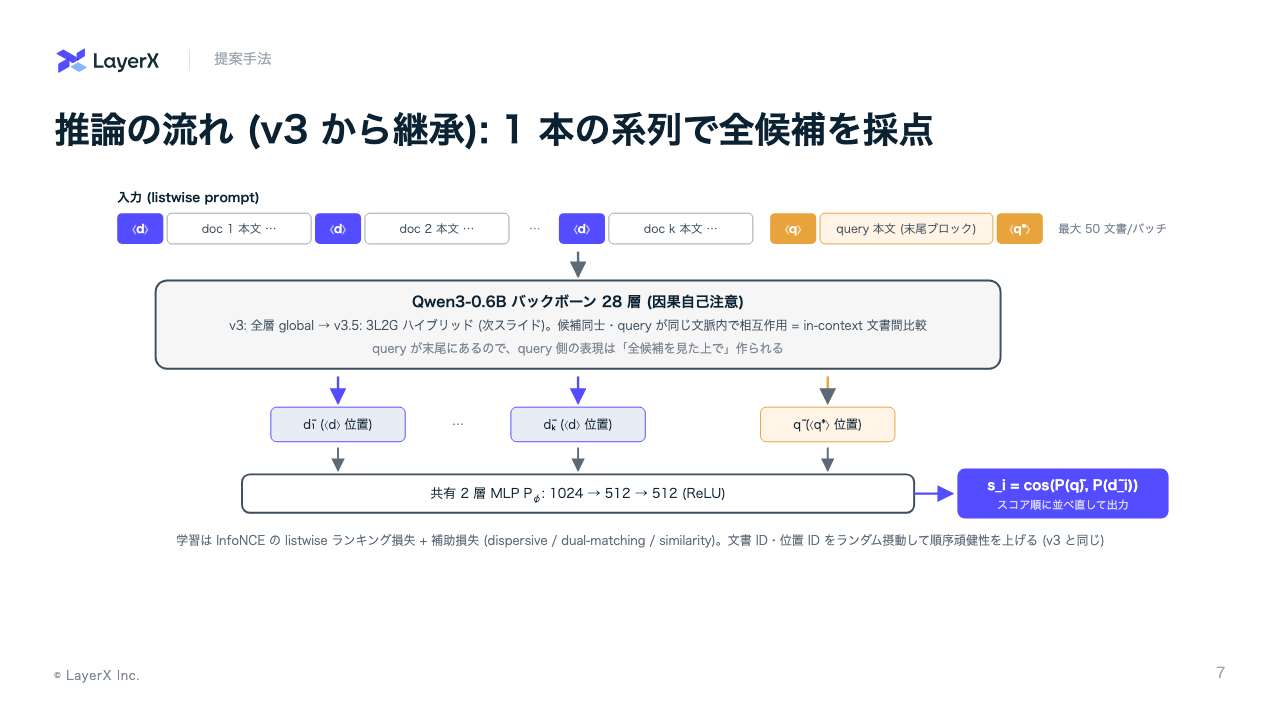
- 前作 v3 は LBNL (Last-but-not-Late) 相互作用が特徴。query と全候補を 1 本の因果系列として一緒に自己注意し、区切りトークンの埋め込みを MLP で射影して cos で採点する。1 回の forward で全候補を採点でき、候補同士を見比べられる (ColBERT 系の late interaction には無い性質)
- ただし v3 は全 28 層が全注意 (候補が長いと O(L²))、学習データが一般ドメイン中心、JSON・表をほぼ見ていない
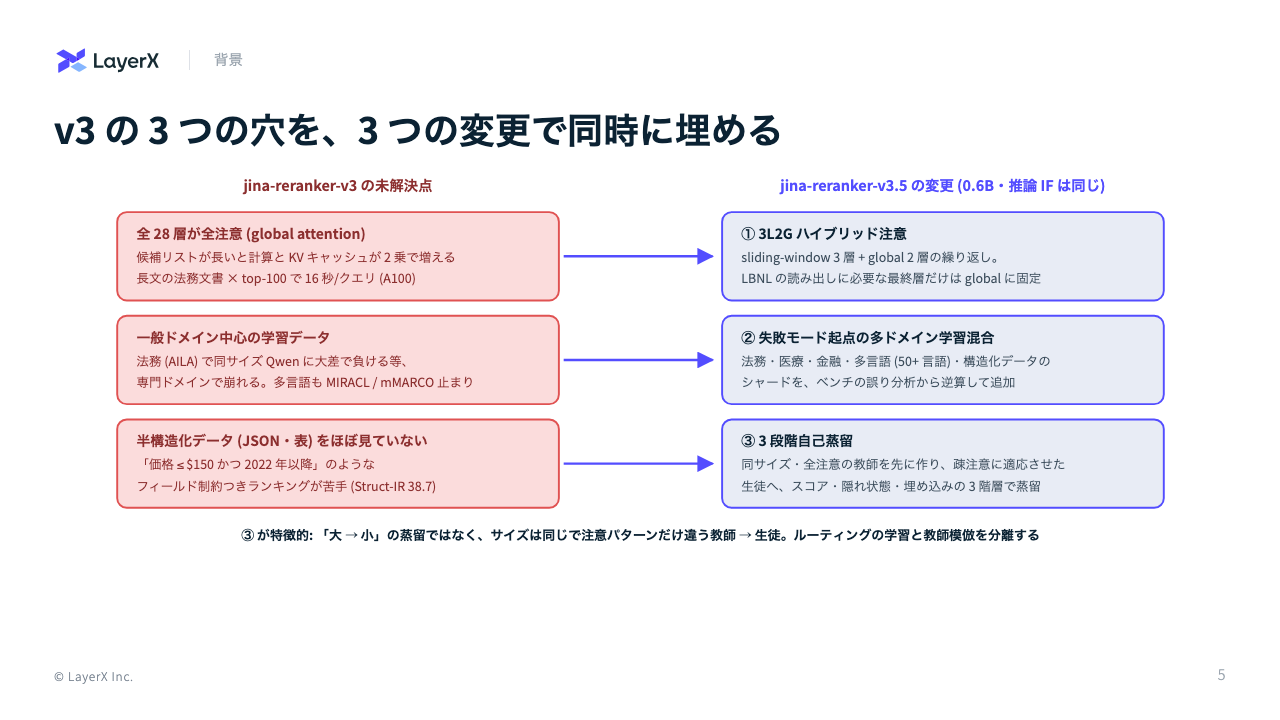
- 手法 1: 3L2G ハイブリッド注意
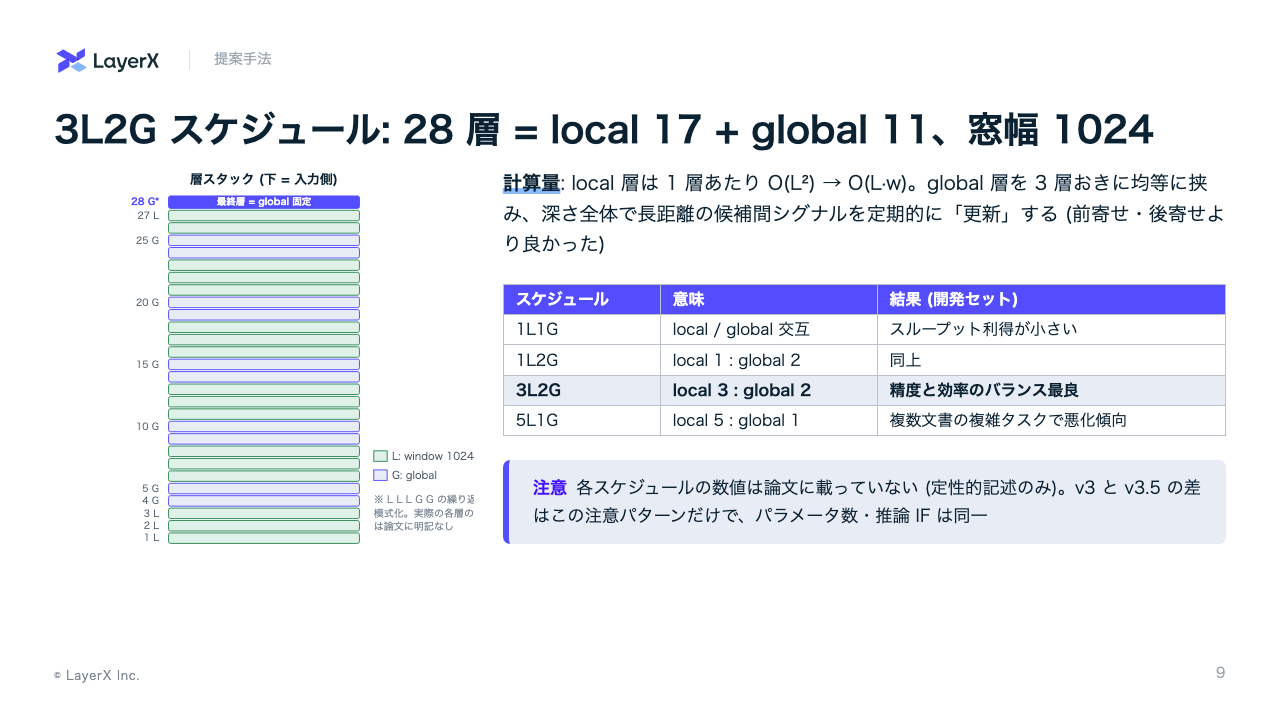
- sliding-window (窓幅 1024) 3 層 + global 2 層の繰り返し。28 層 = local 17 + global 11
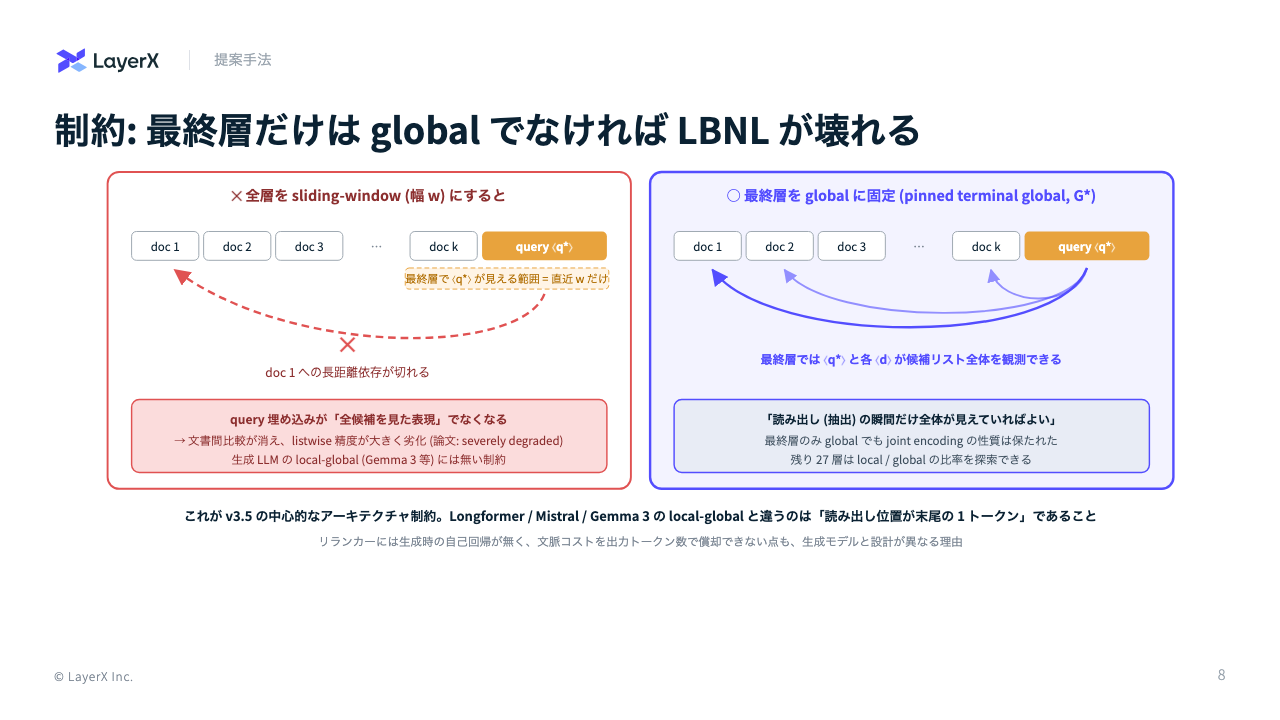
- 鍵は「最終層だけは必ず global」(pinned terminal global)。LBNL では末尾の query トークンが最終層で全候補を見た表現になっている必要があり、ここを window にすると最初の方の候補への依存が切れて精度が大きく劣化する。逆に最終層だけ global なら joint encoding の性質は保てた
- 生成 LLM の local-global (Gemma 3 等) と違い「読み出し位置が末尾の 1 トークン」という制約があるのがリランカー固有
- 1L1G / 1L2G / 5L1G も試し、3L2G が精度と効率のバランス最良 (数値は未掲載)
- 手法 2: 失敗モード起点の学習データ
- 「データ量」ではなく、RTEB / STARK 開発セットの誤り分析で一般モデルが落とすパターンを特定し、それを埋めるシャードを作る
- 法務 (EUR-Lex, AILA, 判例)、医療、金融、多言語 (WebFAQ 50+ 言語, Ruri-v3 日本語)、構造化データ (STARK 属性, Struct-IR, 各種テーブル QA) を追加。構造化が最も遅れていたので最大の重み
- 構造化向けの合成: JSON レコードから型付き制約をサンプルして LLM がクエリ化 → 制約を 1〜2 個だけ変えた near-duplicate を負例に → 密検索で近傍追加 → LLM 判定で昇格・修正・破棄。「表層は同じで制約だけ破る負例」で、語の重なりではなく数値・日付・カテゴリ条件の充足で判断させる
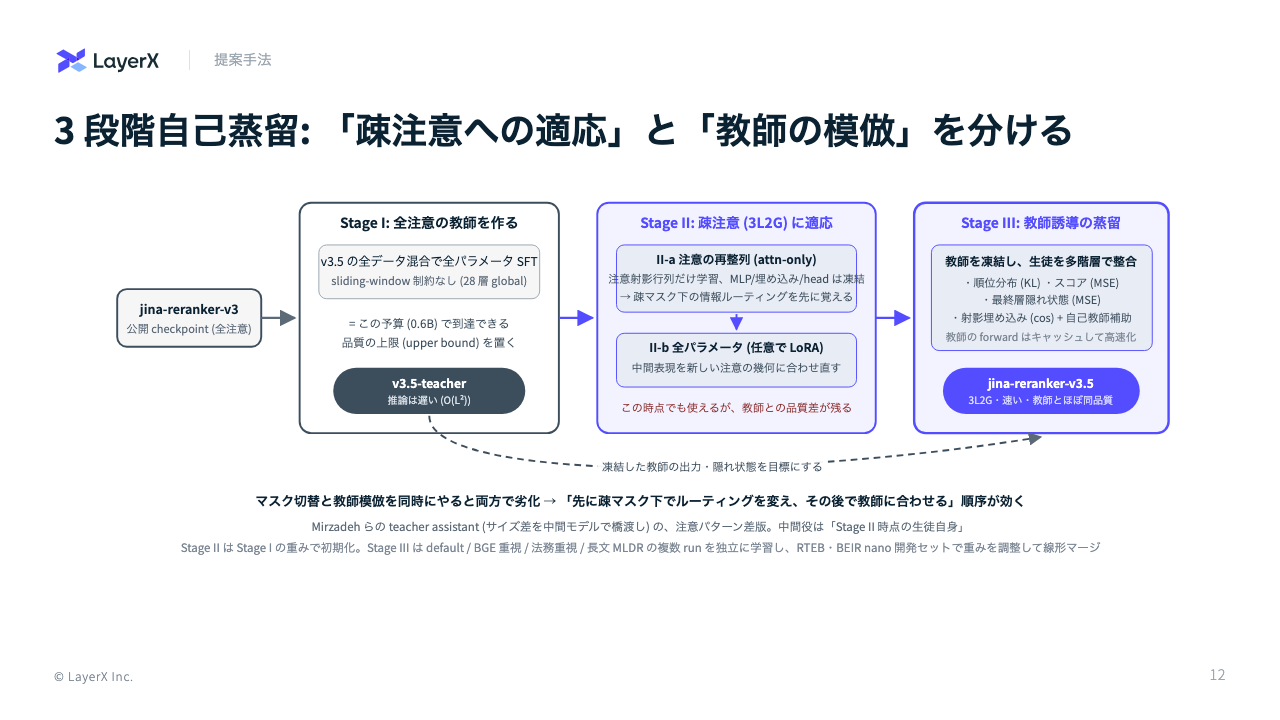
- 手法 3: 3 段階自己蒸留
- 普通の「大 → 小」の蒸留ではなく、教師と生徒はサイズが同じで注意パターンだけが違う
- Stage I: v3 の checkpoint から全注意のまま新データで SFT し、教師 (品質の上限) を作る
- Stage II: 教師の重みで初期化し 3L2G を有効化。まず注意射影行列だけ学習 (MLP・埋め込み・head は凍結) して疎マスク下のルーティングを覚え、次に全パラメータで中間表現を合わせ直す。この時点でも使えるが教師との差が残る
- Stage III: 教師を凍結し、順位分布 (KL) / スコア (MSE) / 最終層隠れ状態 (MSE) / 射影埋め込み (cos) の 4 階層で生徒を整合。差がほぼ埋まる
- マスク切替と教師模倣を同時にやると両方で劣化するので、「先に疎マスク下で適応、その後で教師に合わせる」順序が効く、というのが主張
- 結果
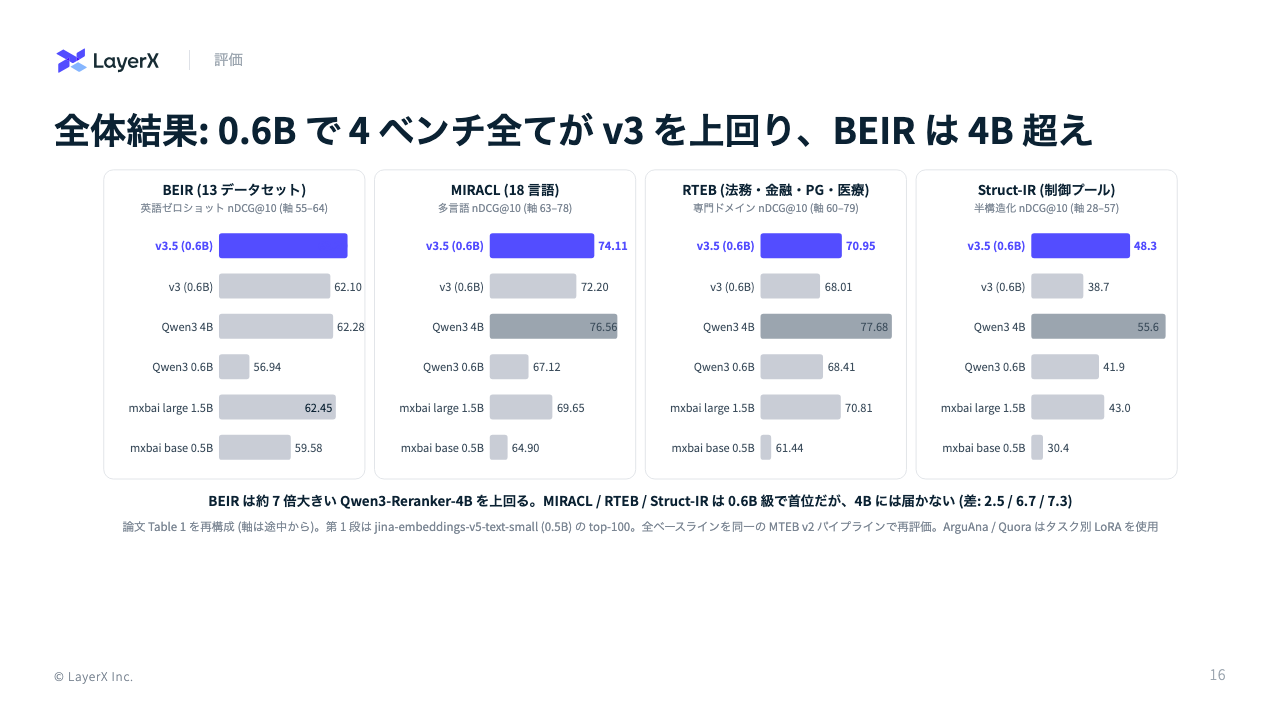
- 4 ベンチ全てで v3 を上回る。BEIR 62.10 → 63.20 (Qwen3-Reranker-4B の 62.28 超)、MIRACL 72.20 → 74.11、RTEB 68.01 → 70.95、Struct-IR 38.7 → 48.3
- 0.6B 級では首位だが、MIRACL / RTEB / Struct-IR は 4B に 2.5 / 6.7 / 7.3 届かない
- RTEB は法務 AILA で +14.0 / +11.7 と最大の伸び。ただし AILA-Statute は同サイズ Qwen3-0.6B の 88.90 に対し 46.16 で、絶対値はまだ低い。医療はほぼ変化なし
- MIRACL は全 18 言語で改善。ヨルバ語 +4.4、日本語は Ruri-v3 追加で 77.95 → 79.70
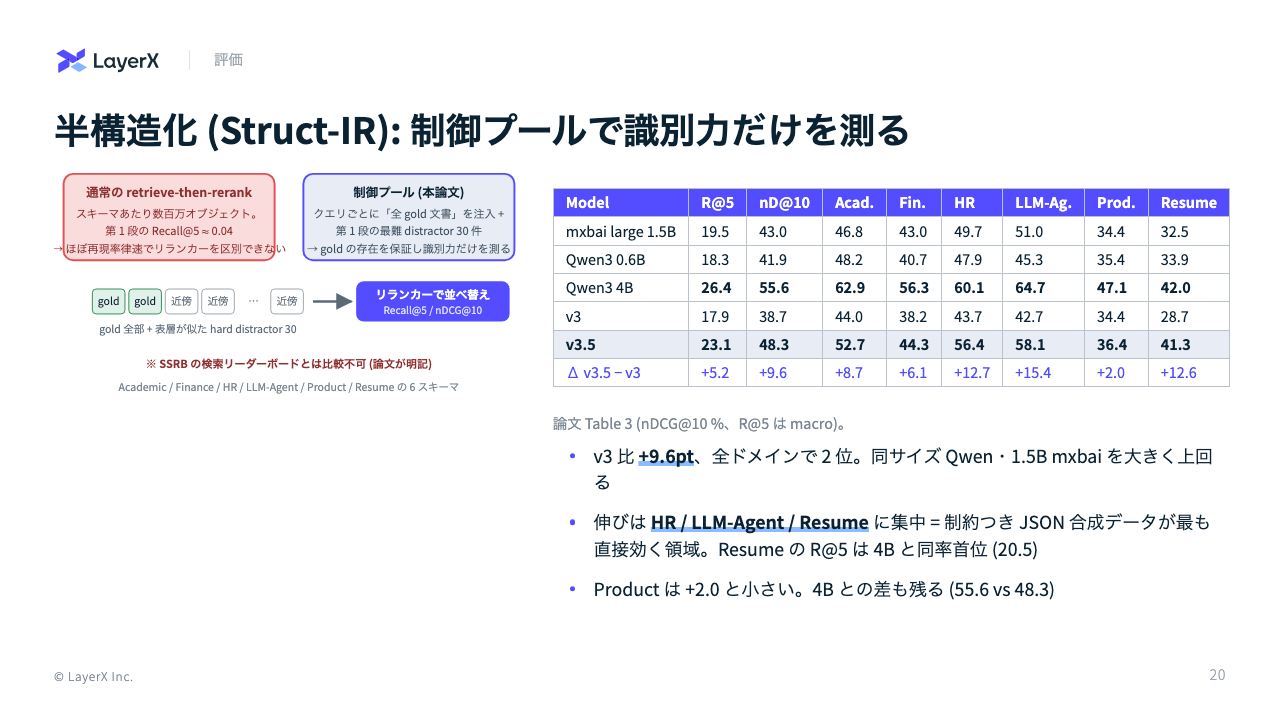
- Struct-IR は第 1 段の Recall@5 が 0.04 程度と低すぎるので、gold 文書を全部注入 + 最難 distractor 30 件の「制御プール」で識別力だけを測っている 。伸びは HR / LLM-Agent / Resume に集中していて、制約つき合成データが効いた領域と一致。
- HardExampleがある中で正確に条件を満たすものを選べるかを測定
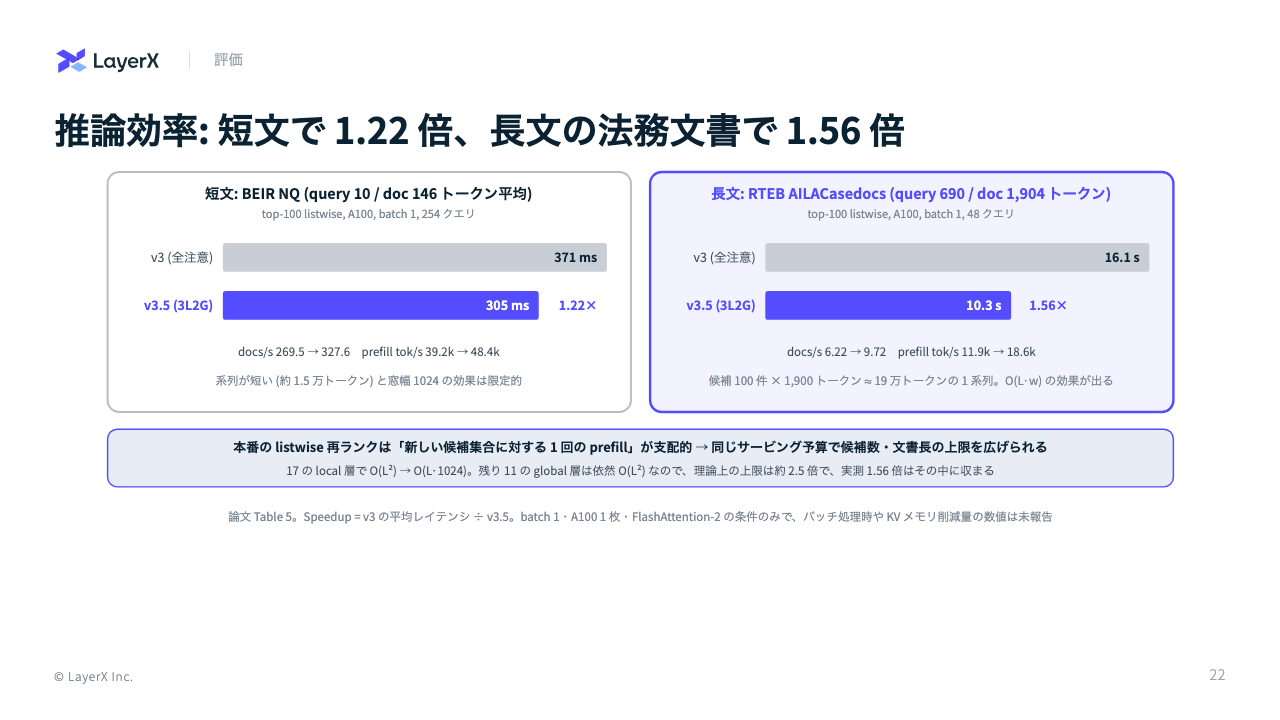
- 効率: A100・batch 1・top-100 で、短文 (NQ) は 371 → 305 ms (1.22×)、長文の法務文書 (AILACasedocs, 文書平均 1,904 トークン) は 16.1 → 10.3 s (1.56×)。候補が長いほど効く
- Limitations
- listwise 固有の制約として候補数・総トークン数に上限がある (論文自身が挙げる)
- 「3L2G が最良」「Stage III が差を埋める」「最終層を window にすると劣化」はいずれも数値なしの定性的記述で、アブレーション表が無い。データ量・シャード比率も非公開
- 効率測定は A100 1 枚・batch 1 のみ。global 層が 11 残るので O(L²) 項は消えない
- 全ベースラインを自前パイプラインで再評価しており公表値と異なる。非商用ライセンス
- 所感
- 「同サイズで注意パターンだけ違う教師」からの蒸留は、既存モデルを効率化するときの汎用レシピとして使いやすい。大きい教師を用意しなくてよく、注意射影だけ先に動かしてから全体を合わせる設計は SWA 化・線形注意化の他の研究にも転用できそう。
- ベンチマークを評価対象ではなく「診断ツール」として使い、失敗パターンから逆算してデータを作る姿勢が一貫している。特に「表層が同じで制約だけ破る負例」は、帳票・求人・商品のような業務データでそのまま効く設計。
- 長文 × 多候補の再ランクで 1.5 倍のレイテンシ削減は大きいが、非商用ライセンスなのでレシピを参考に自前で作る方向になる
- スライド (26 枚)
@Yuya Matsumura
[paper] QD-Rec: Open-Ended Evolution of Recommendations via Quality–Diversity
背景: オープンエンドな推薦
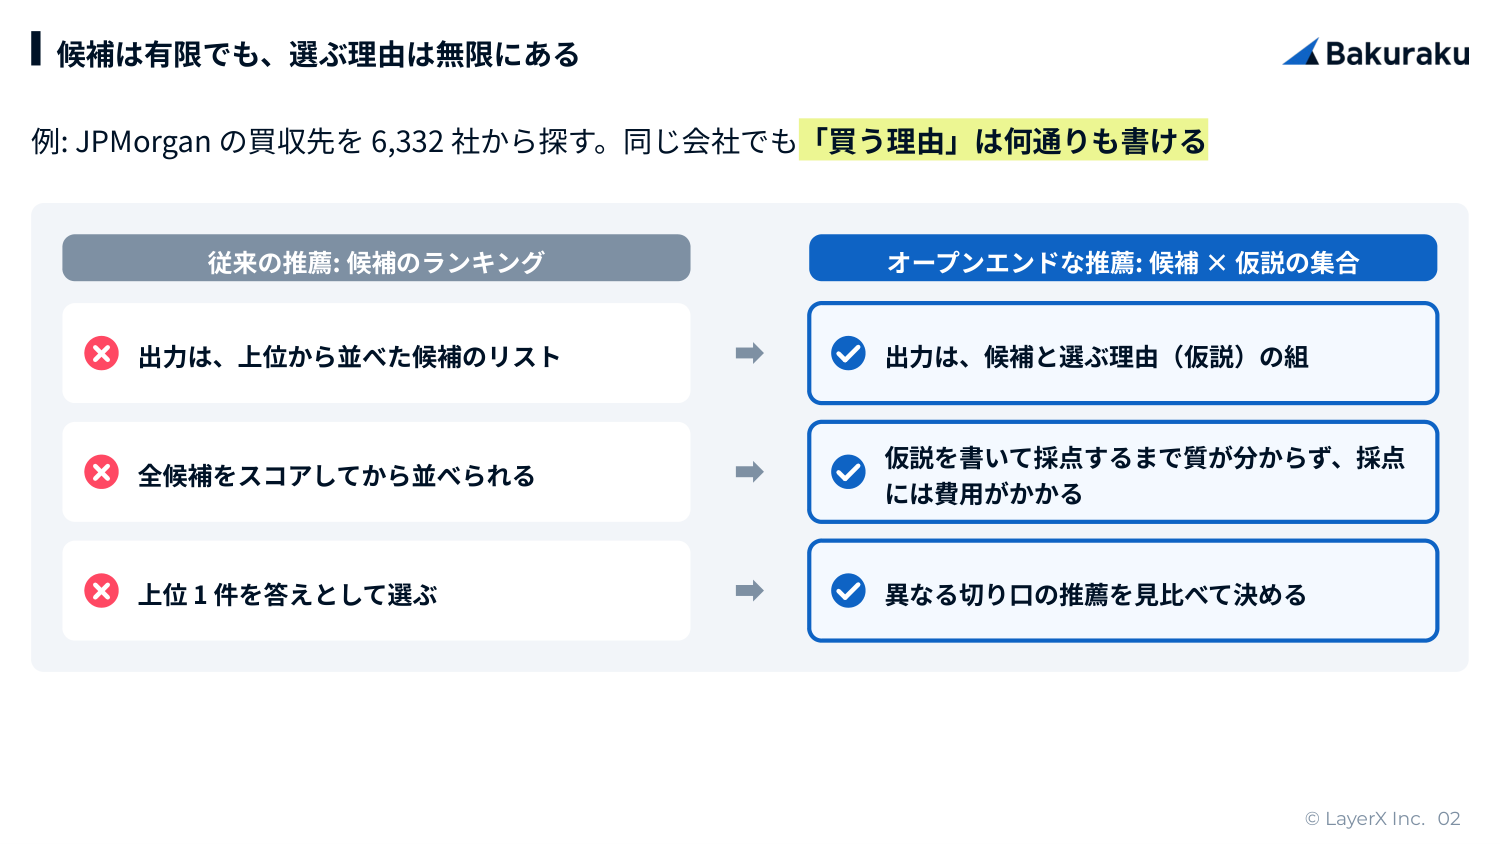
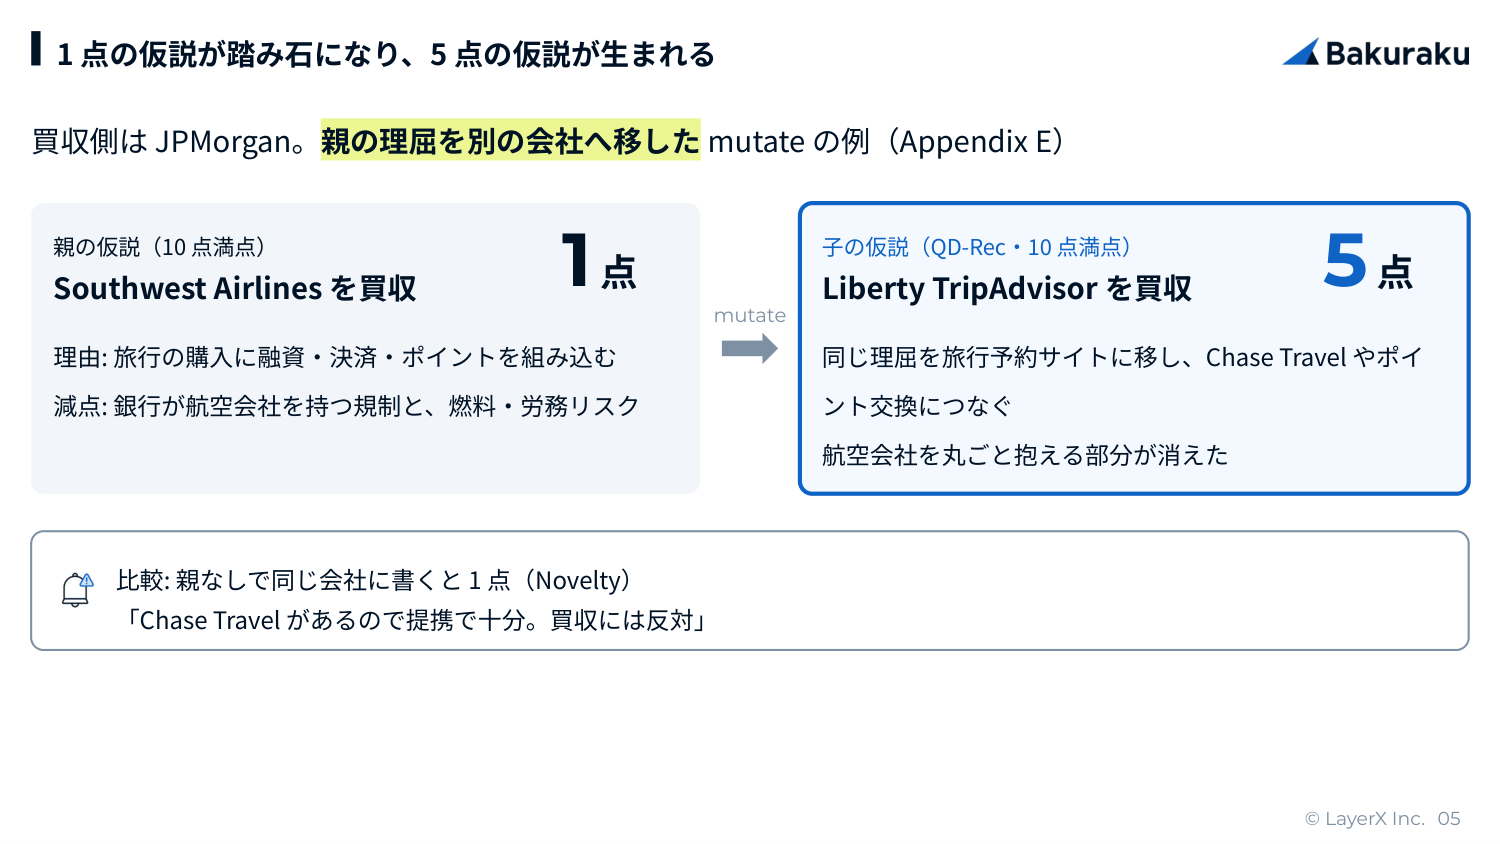
AlphaEvolve などの「LLM で生成 → 評価 → 良いものを踏み石にして次を生成する」オープンエンド探索を、決まった候補から選ぶ意思決定に持ち込む論文。
- 意思決定者のプロフィール π に対して、(候補 c, 仮説 h) の組の集合を返す問題として定式化
- 仮説 h は「なぜ c が π に合うか」を述べた自然言語で、質 q(c, h) は仮説を書いて採点するまで分からない
手法: QD-Rec
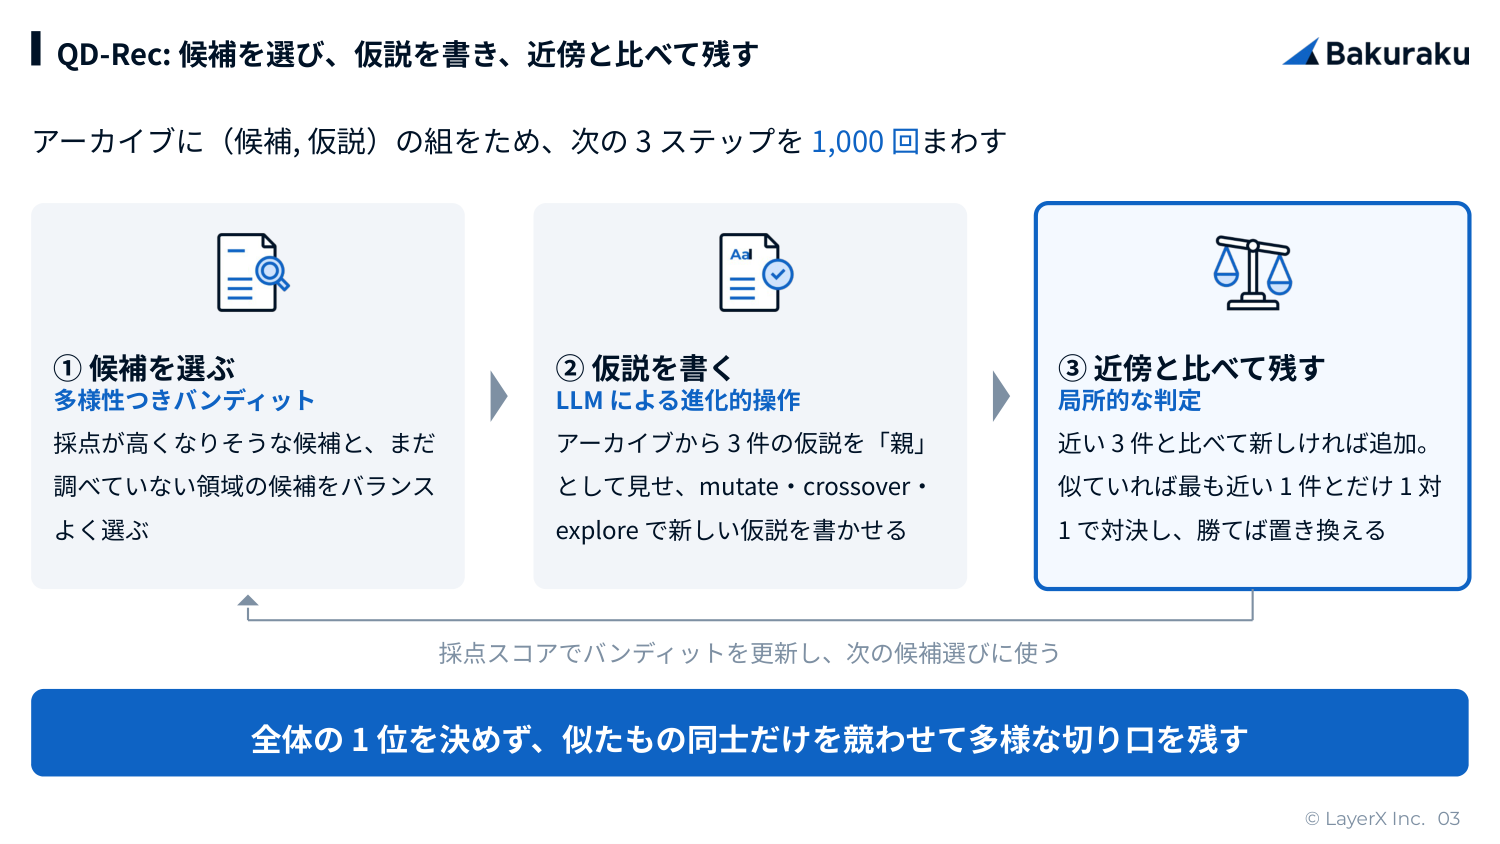
比較対象は、機能を 1 つずつ外したアブレーションです。結果の表はこの 3 手法の比較。
| 手法 | 局所的な新規性判定 | 親を見せる進化的操作 | バンディットによる候補選択 |
|---|---|---|---|
| Novelty | ✓ | ×(毎回ゼロから書く) | ×(ランダム) |
| Novelty+Evo | ✓ | ✓ | ×(ランダム) |
| QD-Rec | ✓ | ✓ | ✓ |
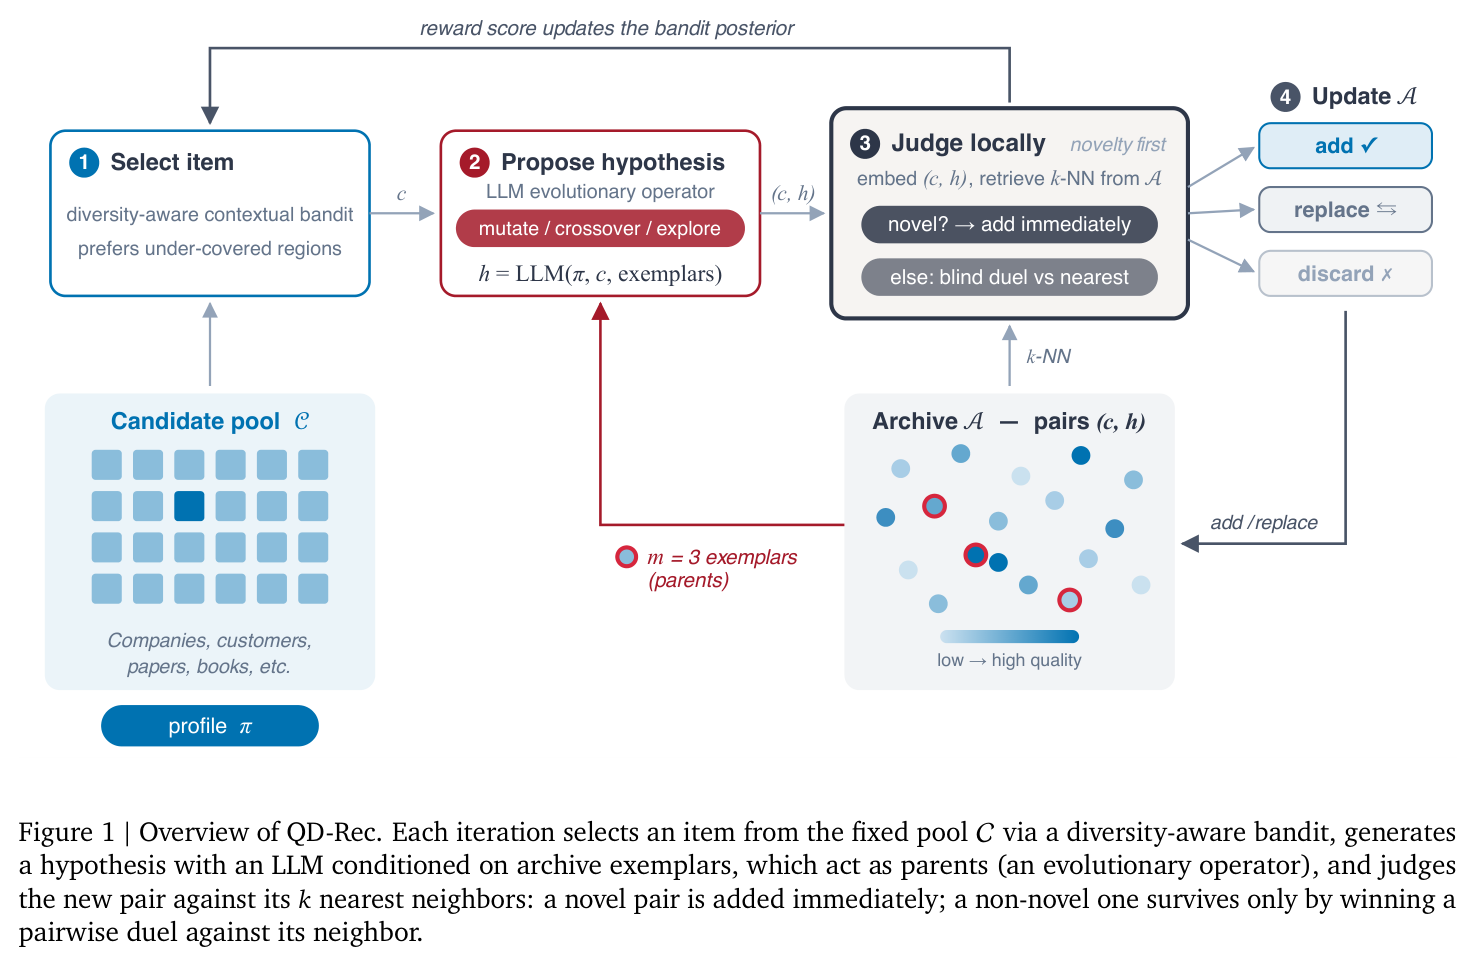
詳細: バンディットの式・使ったモデル・論文の Figure 1
- 候補の選択: 候補の埋め込み ψ(c) から報酬(採点スコアを 0〜1 に正規化)をベイズ線形回帰で予測し、Thompson sampling で引きます。スコアは s(c) = ψ(c)・θ̃ + β・d(c, R) で、d はアーカイブ内で最も近い既出候補とのコサイン距離です(β = 1)
- 仮説の生成: 提案役は claude-sonnet-5。アーカイブから無作為に 3 件を親として見せます
- 判定: 採点役は gpt-5.6-terra(提案役と別系統にして自己贔屓を避ける)。近傍は 3 件で、新規でなければ最も近い 1 件とブラインドで対決します
実験
4 ドメイン × 各 2 プロフィールで、1 run あたり 1,000 回の生成・評価、5 seed (Section 5.1)。
- M&A: 米国企業 6,332 社(LSEG のデータ)。買収側は Walt Disney / JPMorgan Chase
- マーケティング: 合成の顧客プロフィール 10,000 件(NVIDIA Nemotron-Personas、カリフォルニア州)。商品は 3D プリンタ / オンライン学習サービス
- 論文推薦: ICLR 2026・ICML 2026・NeurIPS 2025 の採択論文 17,511 本。研究者プロフィールは 2 種
- Goodreads(児童書): 読者本人の 1〜5 の星評価を LLM 採点の代わりに使う「人間評価による検算」用ドメイン
指標は、最終アーカイブの平均スコア(Quality)、埋め込みの平均コサイン非類似度(Diversity)、PCA 2 次元を 25×25 に区切った占有率(Coverage)、アーカイブ件数 n の 4 つ。
結果
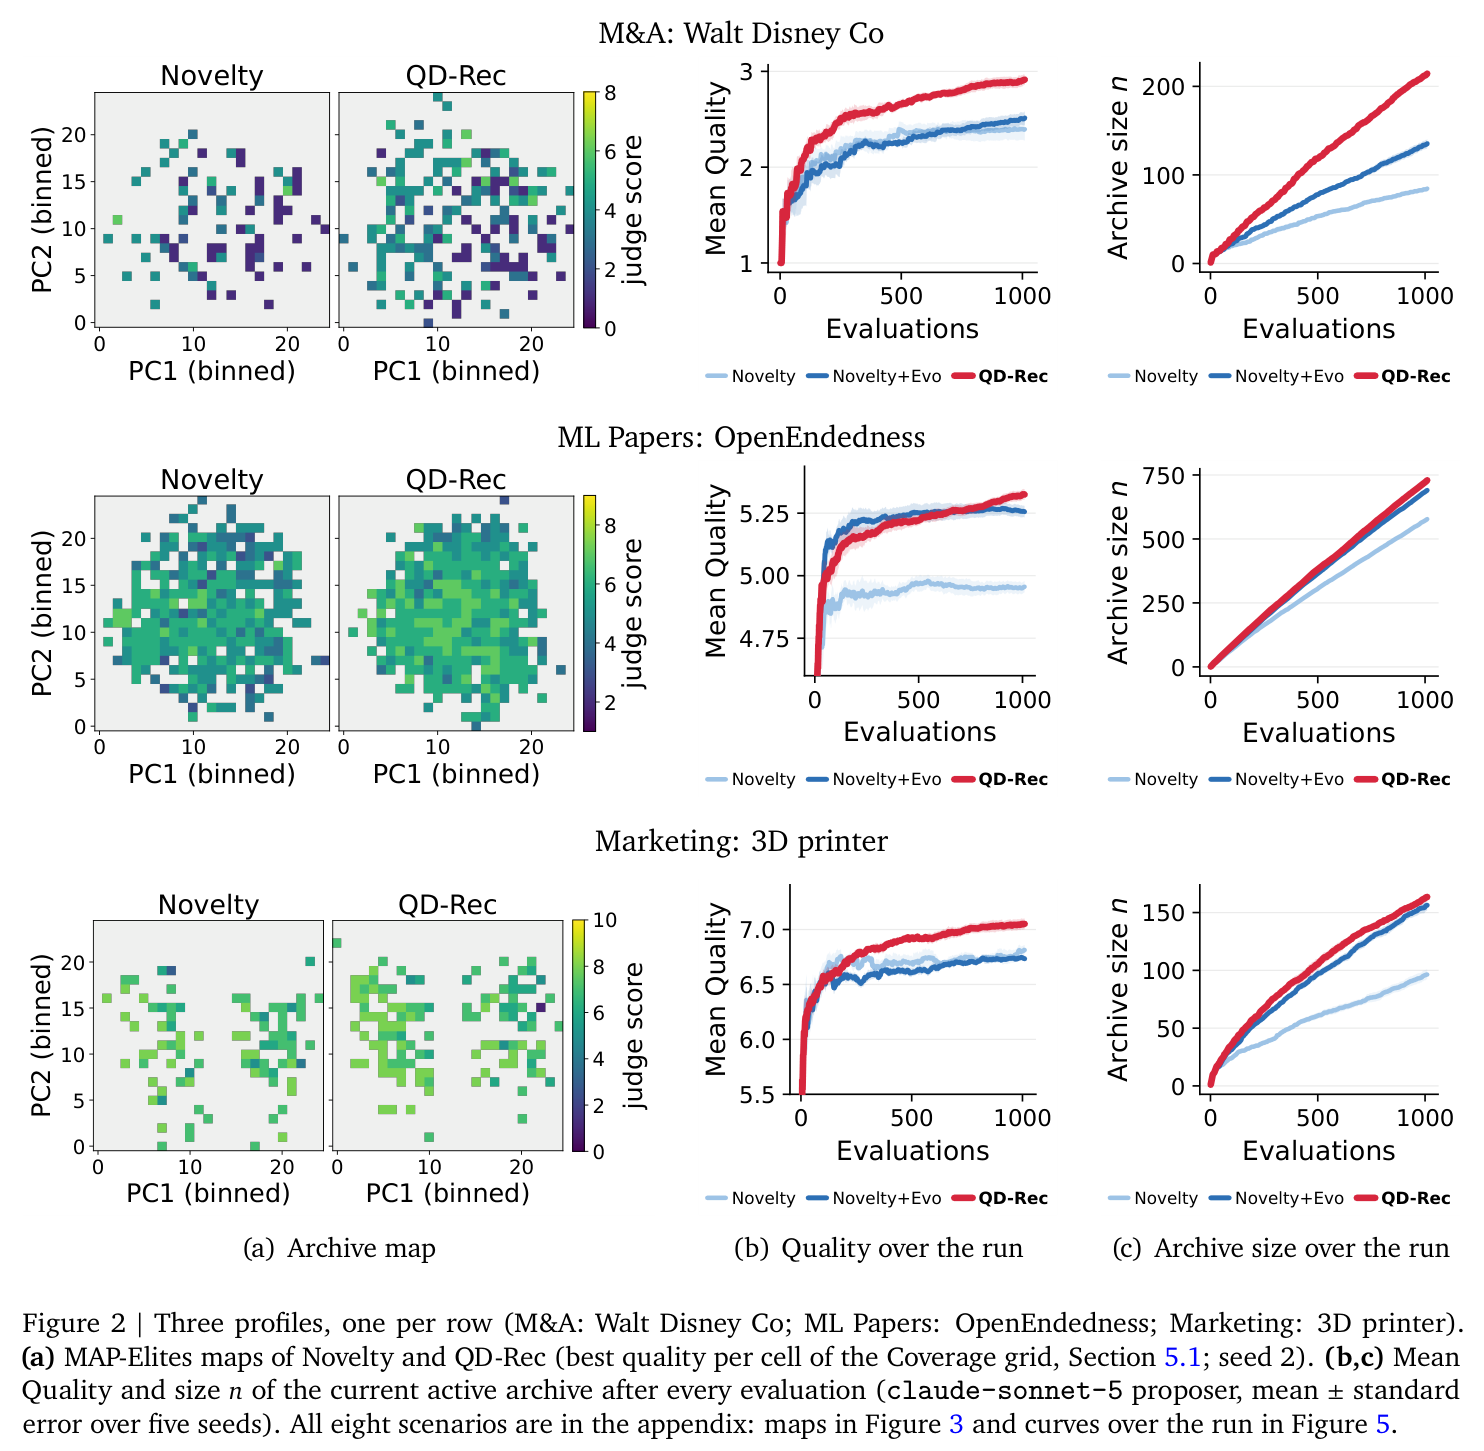
- 品質は探索の後半まで伸び続け、最後に最も高くなる(Figure 2b)
- 学習しないリランカー(MMR、品質重み付き DPP)は、どの設定でも Goodreads の評価で QD 系に届きません(Table 4)。ただしリランカーは評価を一切見ないので、統制された比較ではないと著者自身が注記している。
- コストは 1 run あたり約 13〜62 ドルで、QD-Rec は Novelty の約 1.3 倍となる。差の 9 割以上は、親 3 件ぶん増えた提案役の入力。
- 埋め込みモデルを Qwen3-Embedding に替えても、Quality と件数の順位は変わらない(Table 3、1 run のみ)
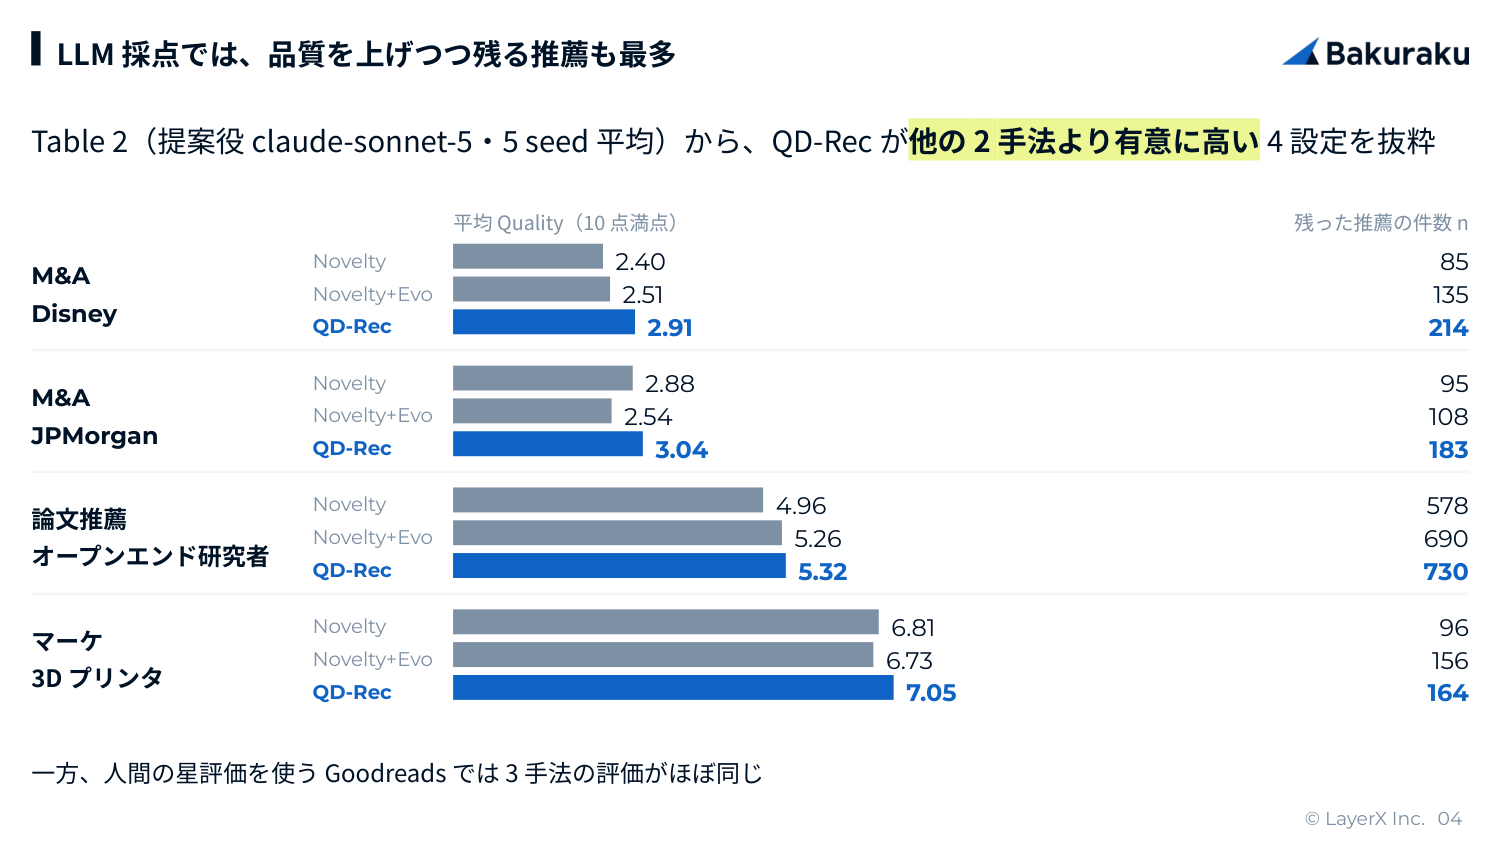
全 8 設定の数値(Table 2 から提案役 claude-sonnet-5 の行を抜粋。太字は他の 2 手法より有意に高いもの)
| ドメイン / プロフィール | Novelty | Novelty+Evo | QD-Rec |
|---|---|---|---|
| M&A / Disney | 2.40(n=85) | 2.51(n=135) | 2.91(n=214) |
| M&A / JPMorgan | 2.88(n=95) | 2.54(n=108) | 3.04(n=183) |
| 論文 / OpenEndedness 研究者 | 4.96(n=578) | 5.26(n=690) | 5.32(n=730) |
| 論文 / AI スタートアップ研究者 | 6.21(n=658) | 6.24(n=737) | 6.24(n=789) |
| マーケ / 3D プリンタ | 6.81(n=96) | 6.73(n=156) | 7.05(n=164) |
| マーケ / オンライン学習 | 6.47(n=61) | 6.70(n=72) | 6.89(n=82) |
| Goodreads / シリーズ・YA 読者(人間評価、5 点満点) | 4.17(n=222) | 4.15(n=226) | 4.15(n=244) |
| Goodreads / 絵本読者(人間評価、5 点満点) | 4.19(n=297) | 4.17(n=318) | 4.12(n=336) |
実例: 1 点の仮説が踏み石になっている
@Kyohei Uto(kuto)
[paper]OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
概要
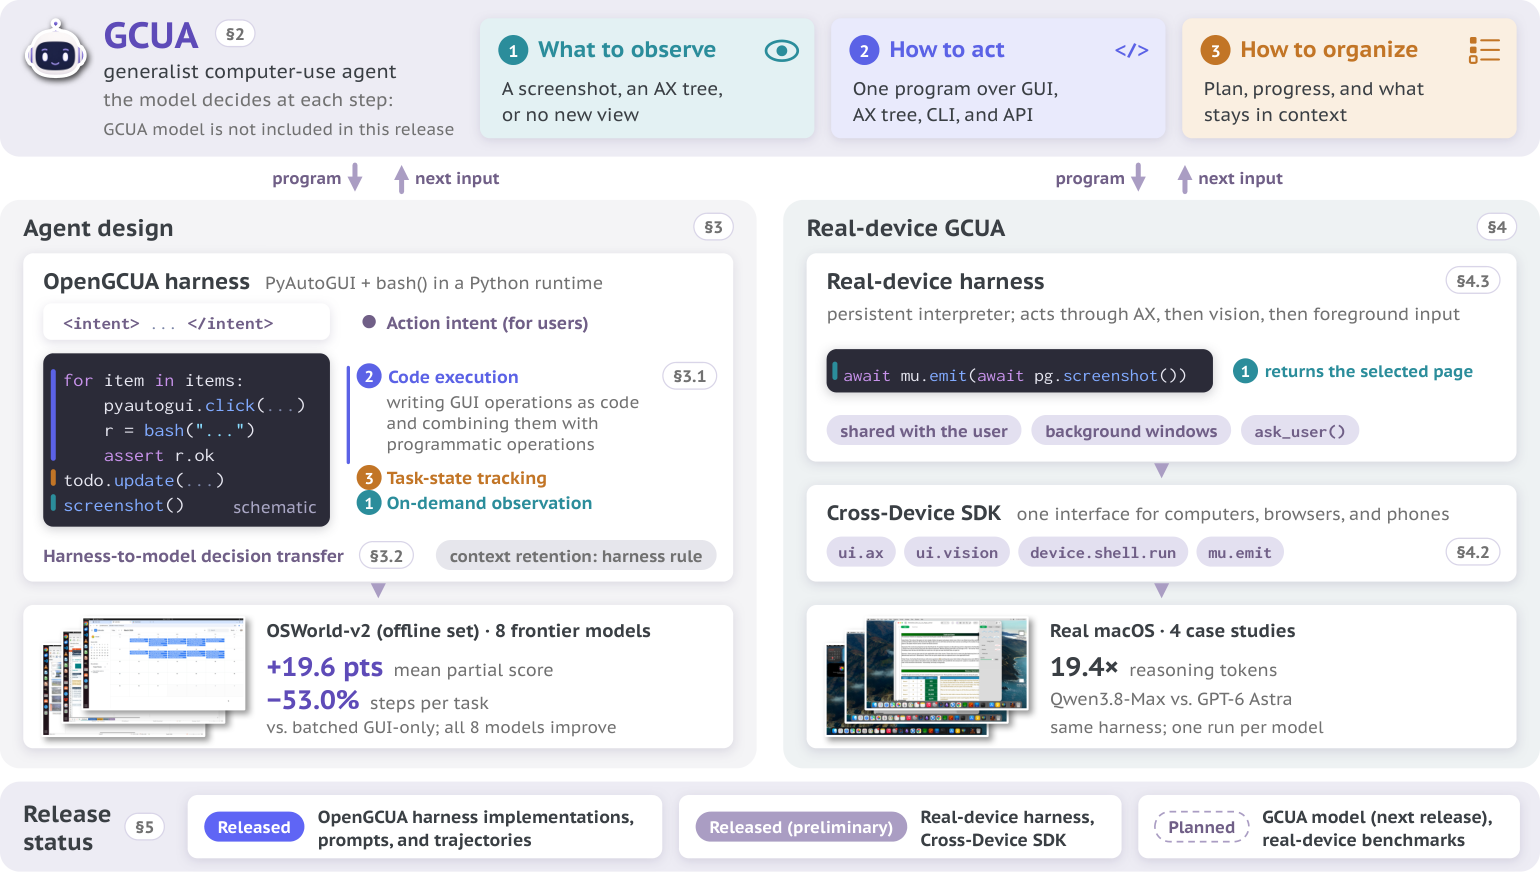
- Alibabaが公開した汎用的なcompute use AgentであるOpenGCUA
- compute use用のモデル、実行システム、実機での検証環境を進展させていく取り組みの初回リリースという位置付け(専用モデル学習は未実施)
エージェント設計
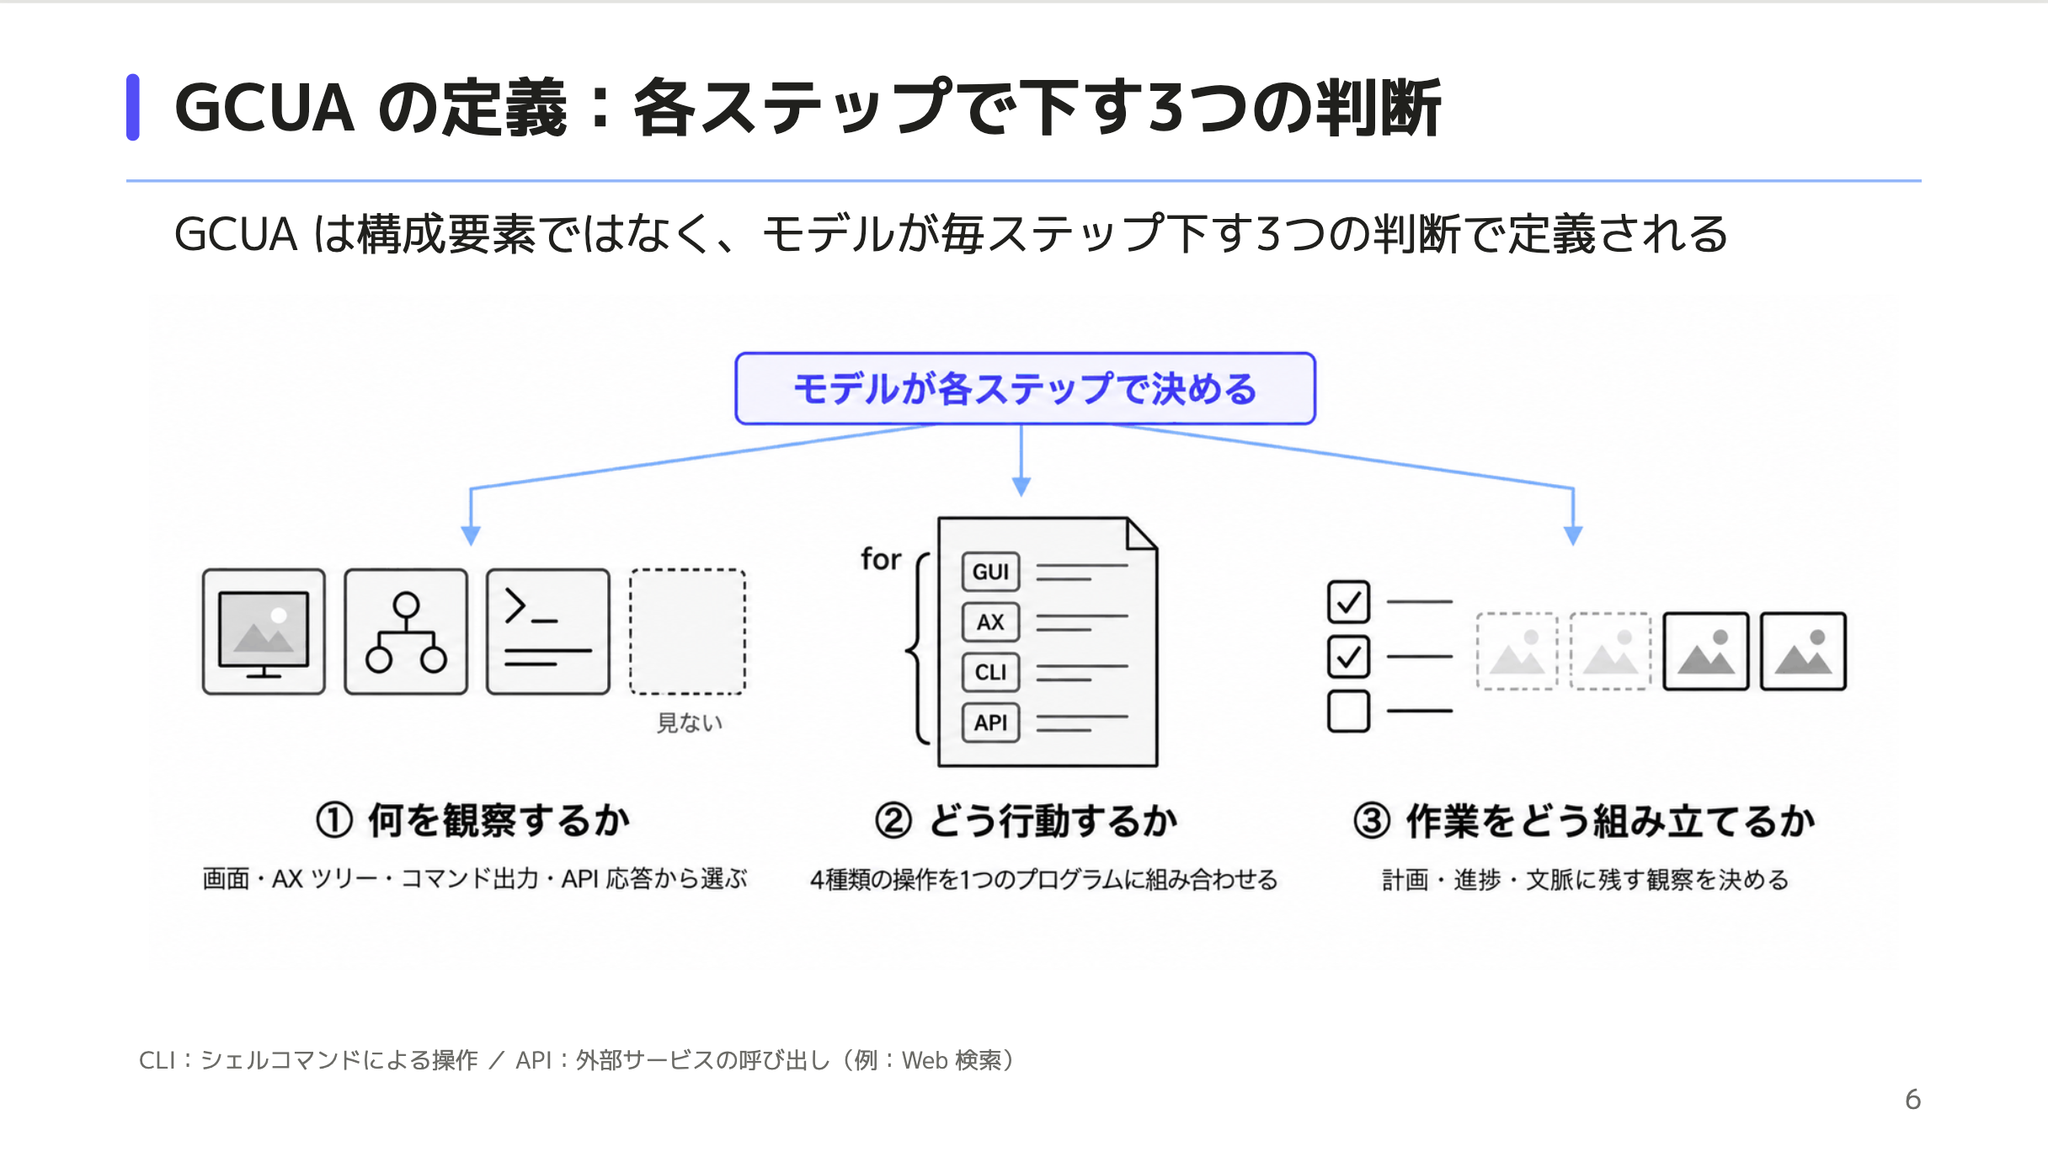
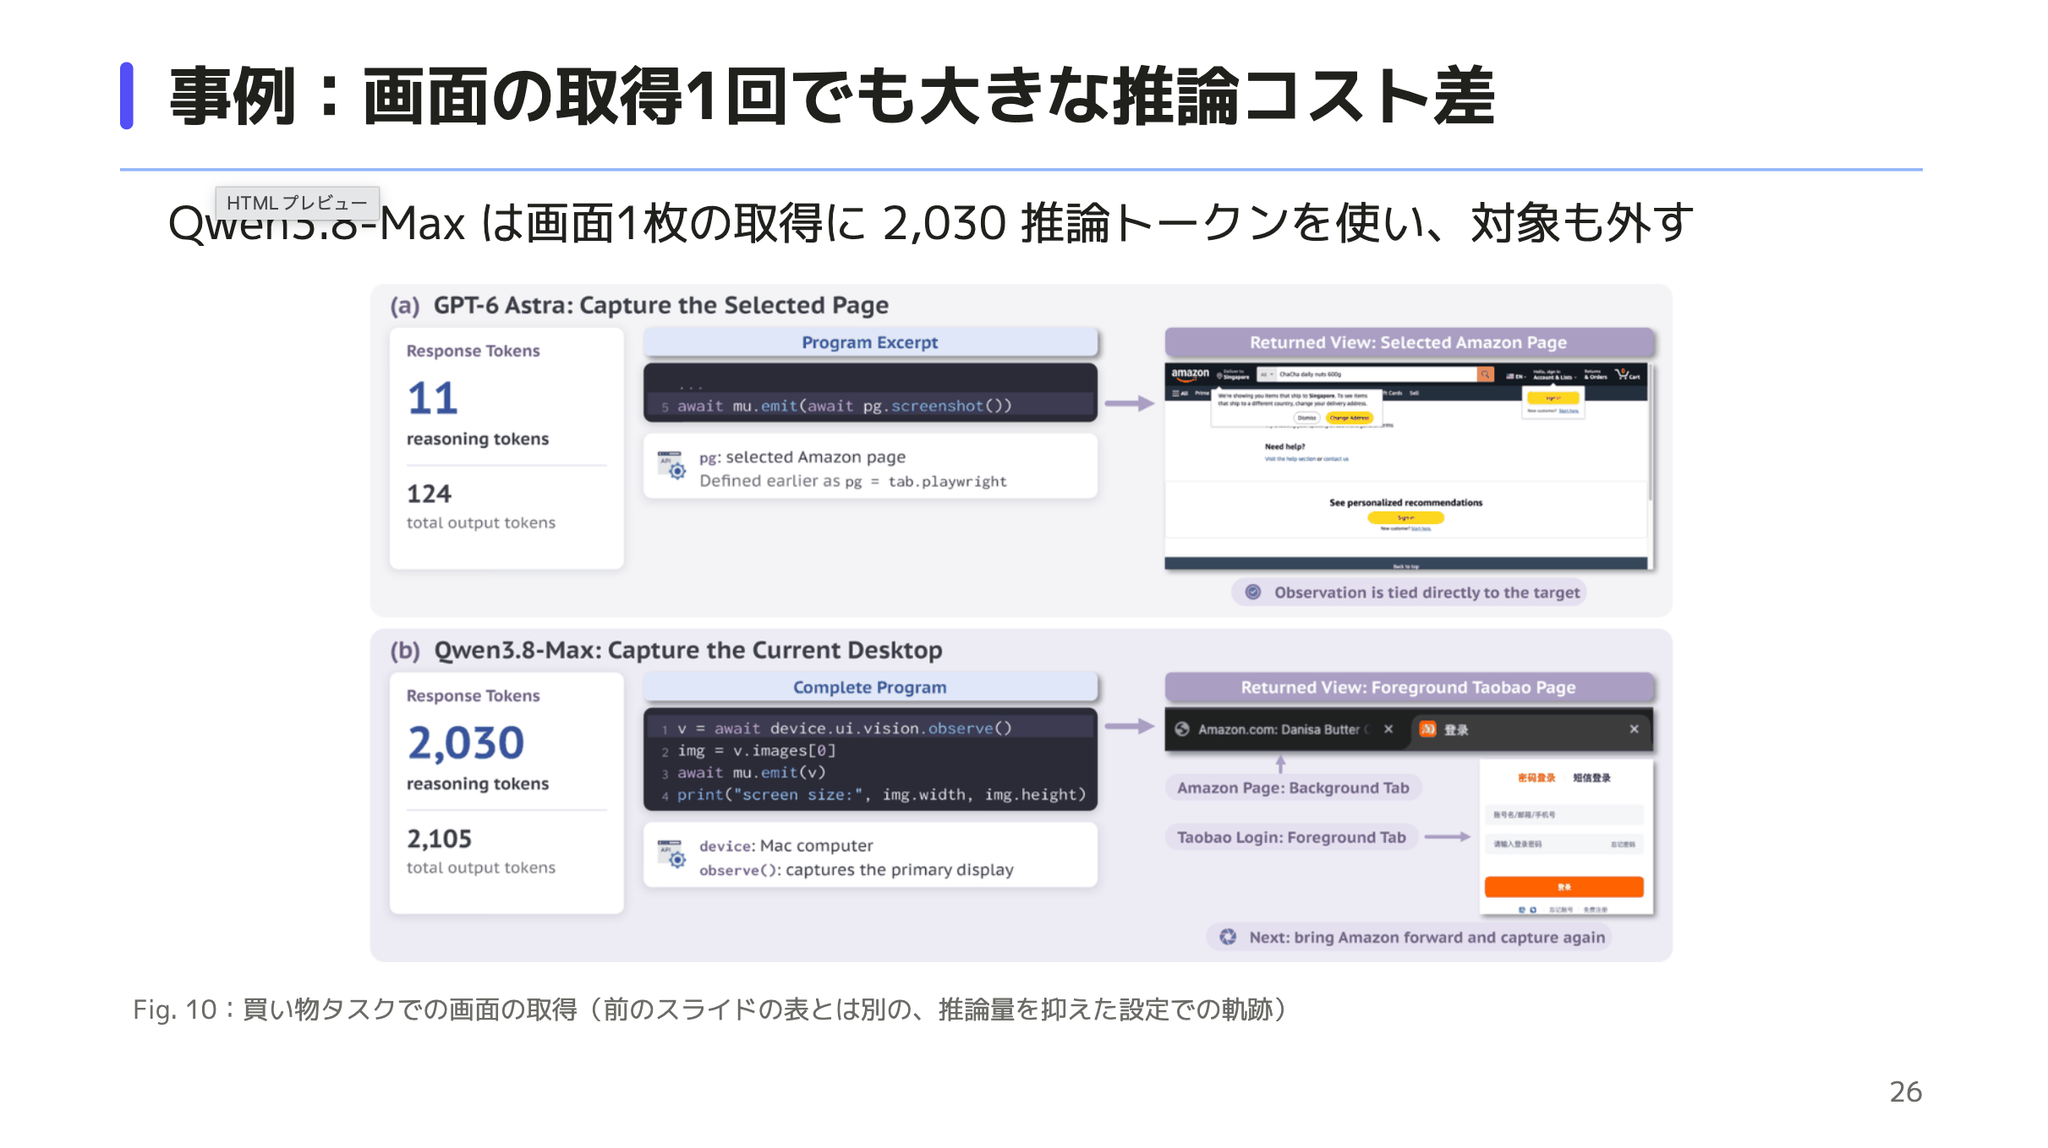
1回の推論で3つの判断を1つのコードで生成し実行する
例)
- 何を観察するか:登録結果を確認するためスクショを要求する
- どう行動するか:登録ボタンをクリックする
- 作業をどう組み立てるか:スクショと登録結果をタスク状態に記録する
コード生成パターンは色々あるので事例を紹介
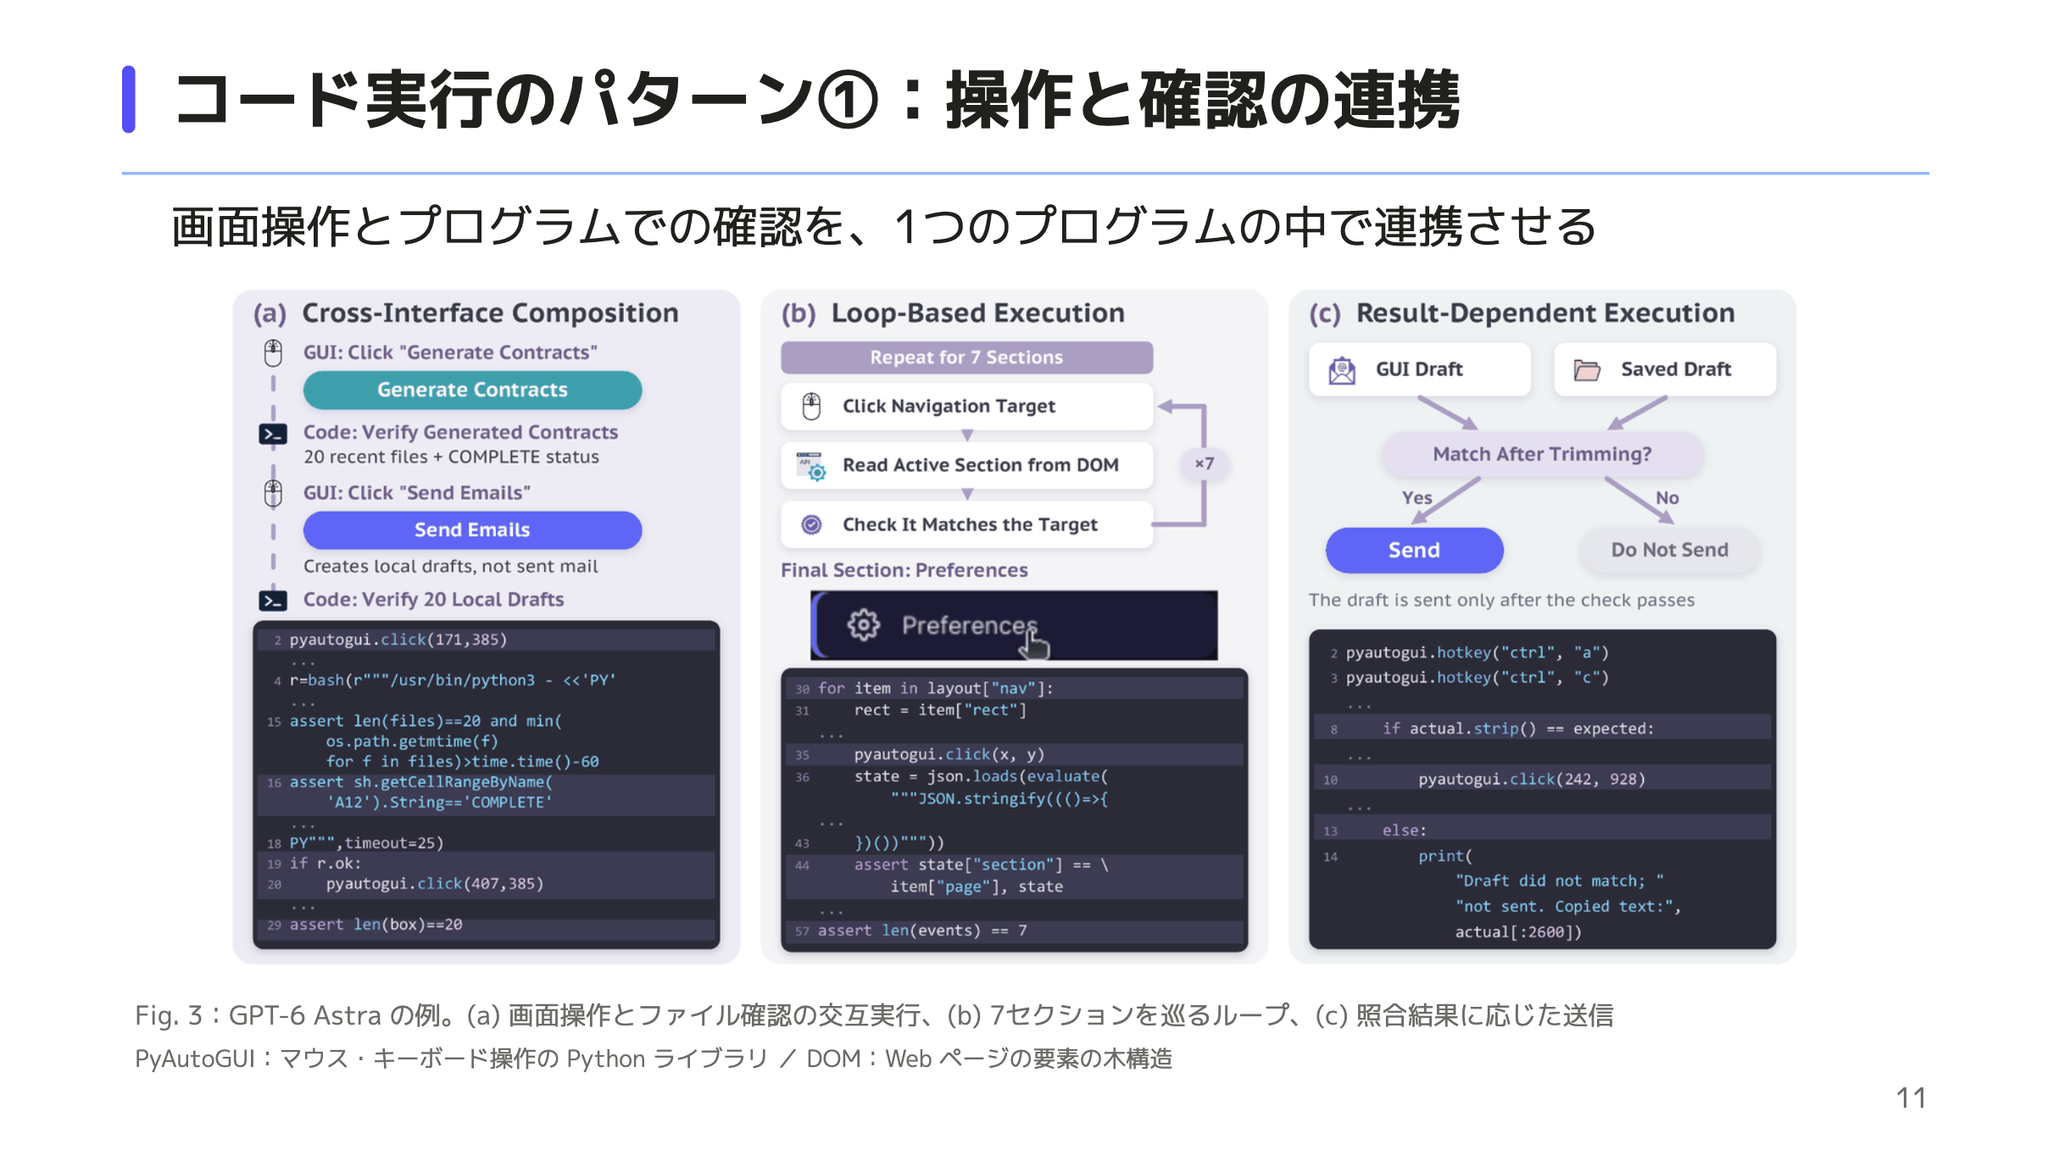
全てLLMの1推論で1つのプログラムを生成し一連の処理を実行する
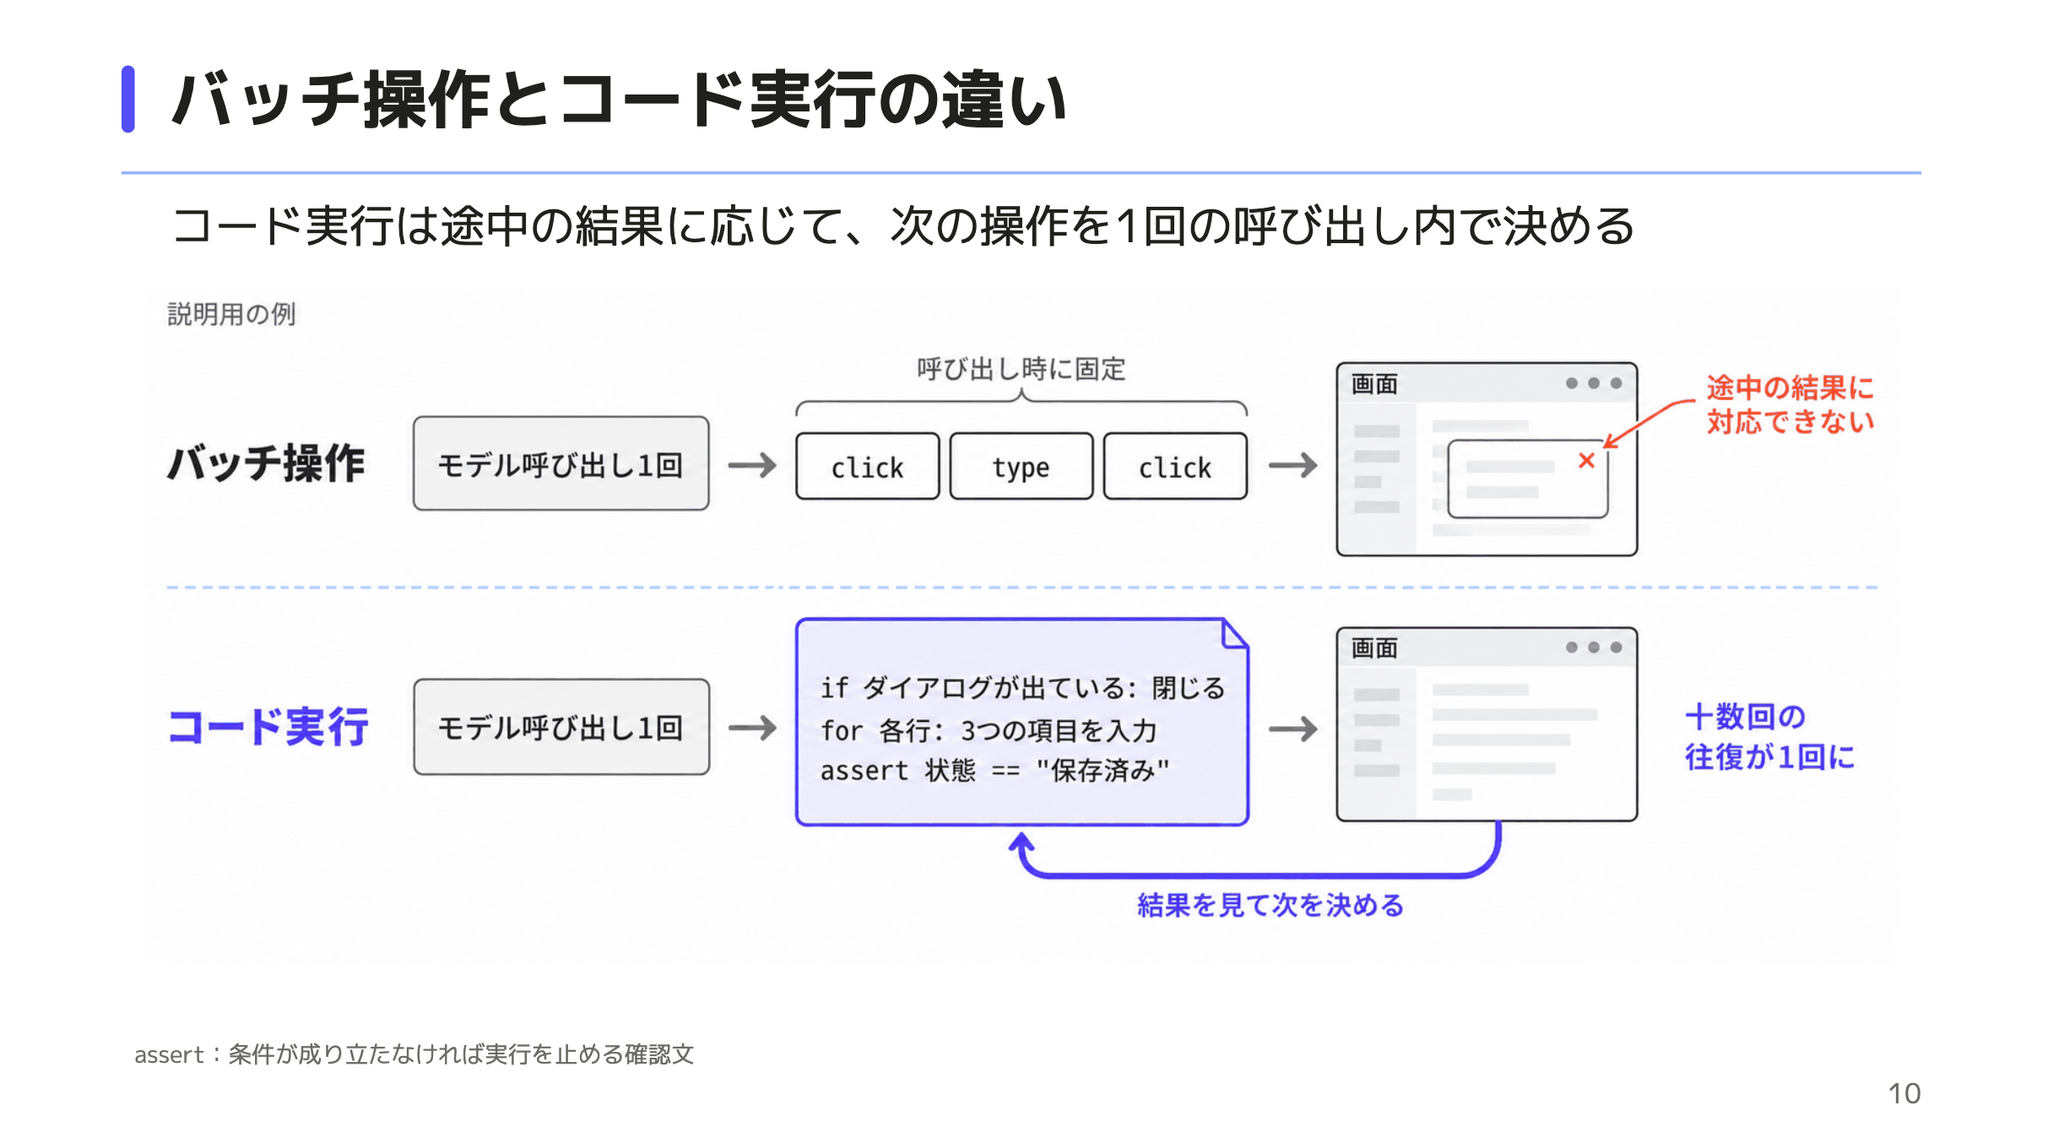
- バッチ操作と言っているのは、1度に行うアクション(GUI操作ツール)をLLMが決めてそれ通りに実行する方法。
- コード実行はプログラムとして中間結果に基づく判断やループ処理、検証処理などが柔軟に入れられるのが利点としてある。
- 余談: Astraでのcomputer useでもツールではなくコード実行が推奨されている
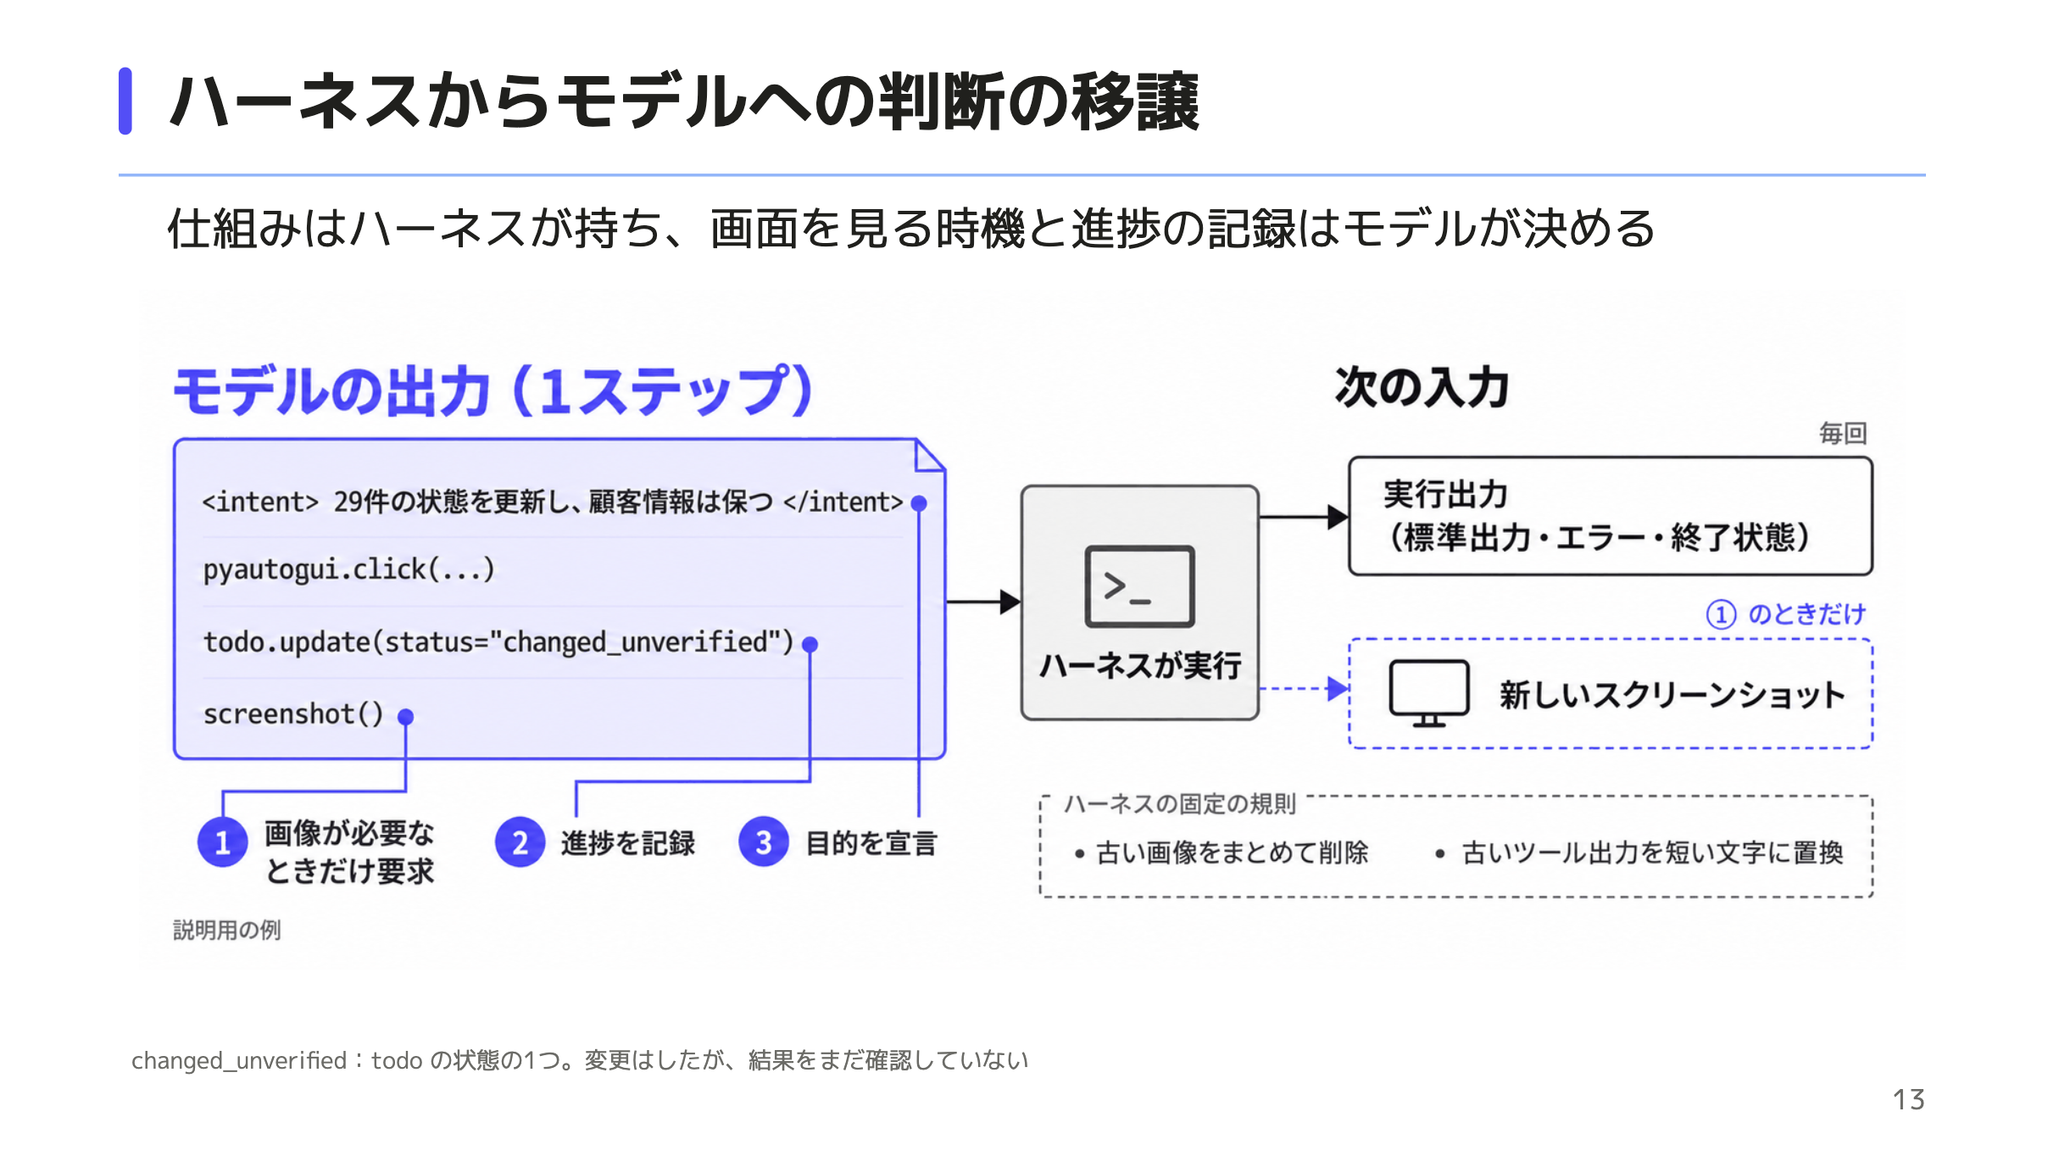
- 設計思想として、「モデルの能力が高まるにつれ、固定のハーネスルールからモデル側へと段階的に移行させていくべき」という前提としてある
- ハーネスを固定せずモデルの判断によってハーネス内の機能を使い分けるイメージ
実験
ベンチマーク実験と実機での実験の2つを実施している。
ベンチマーク評価
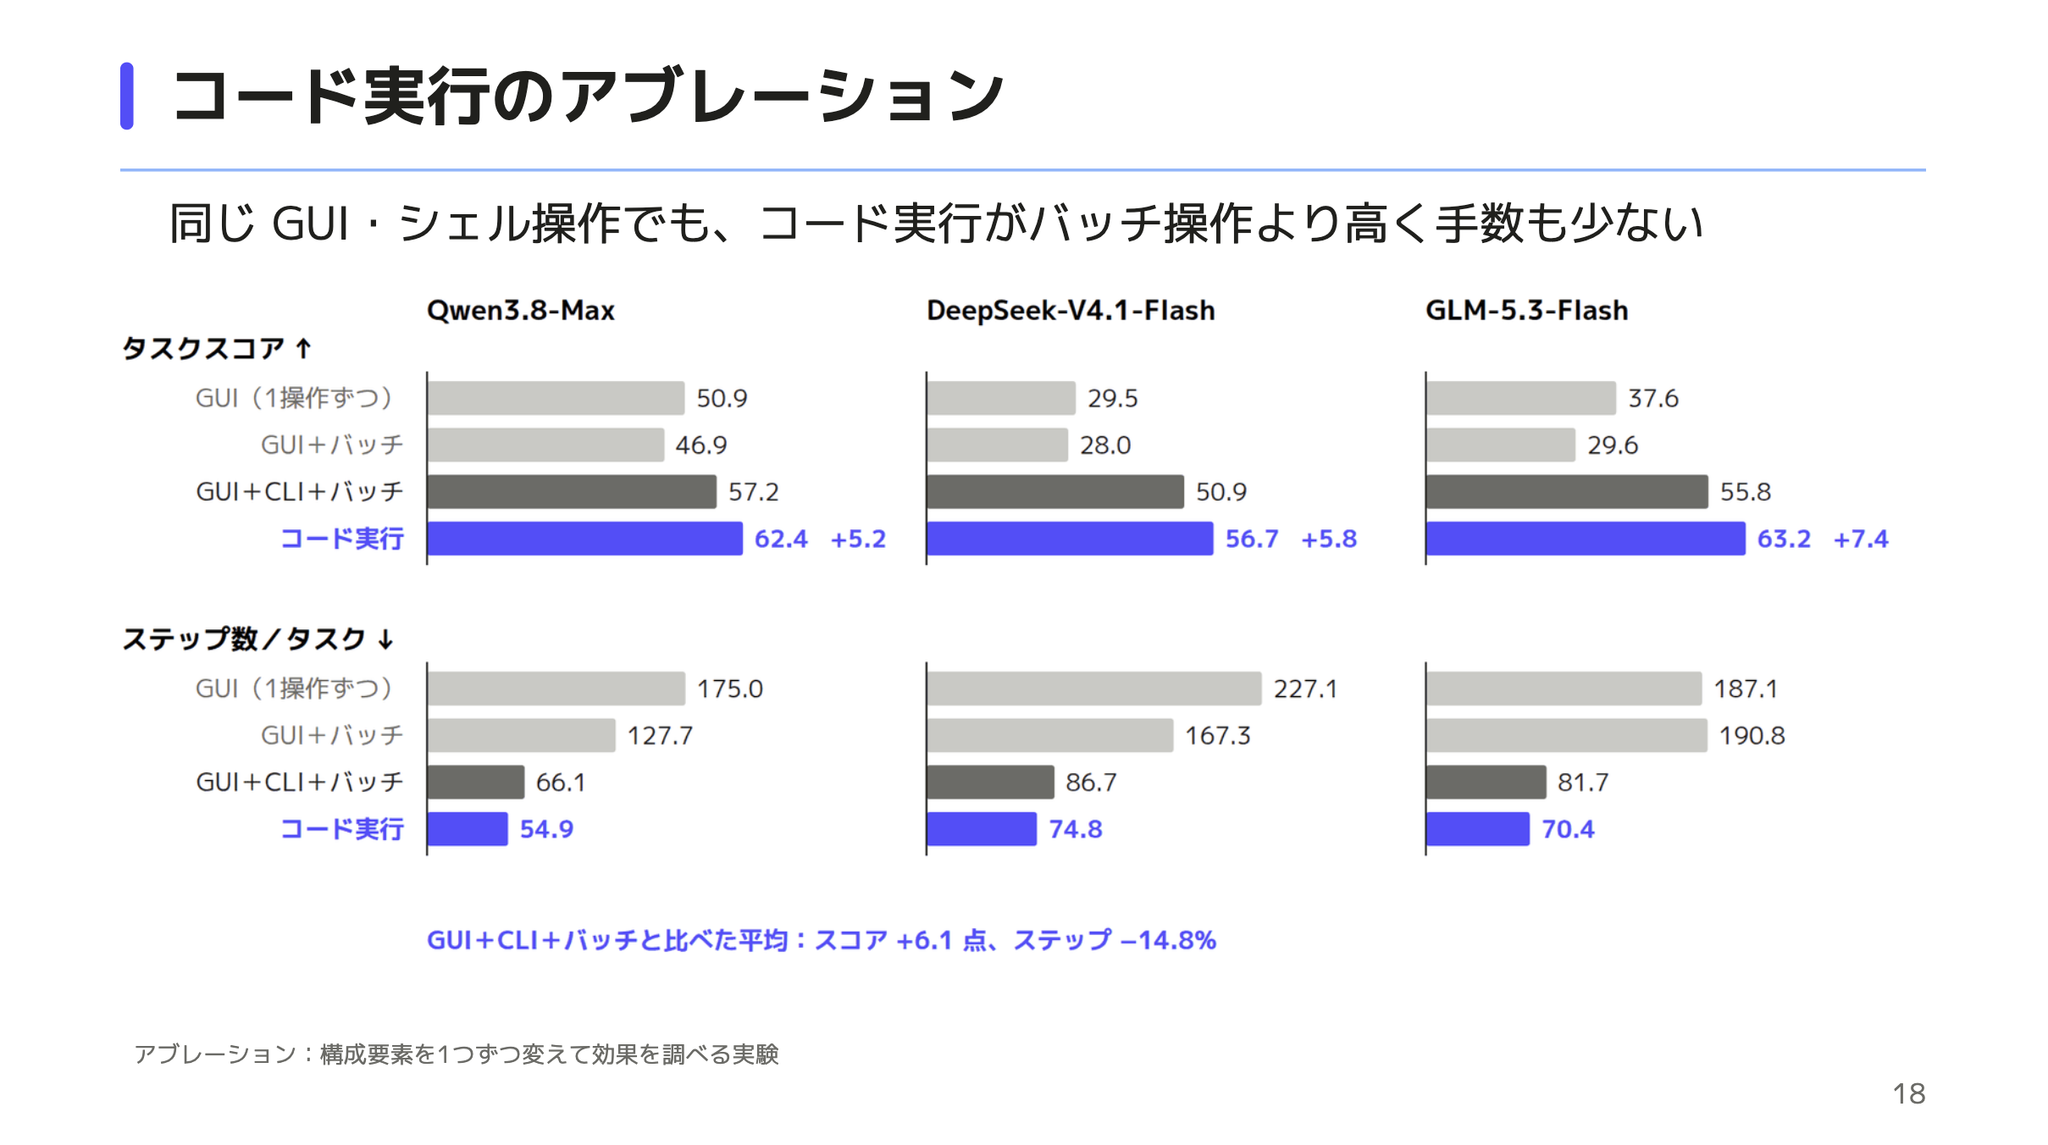
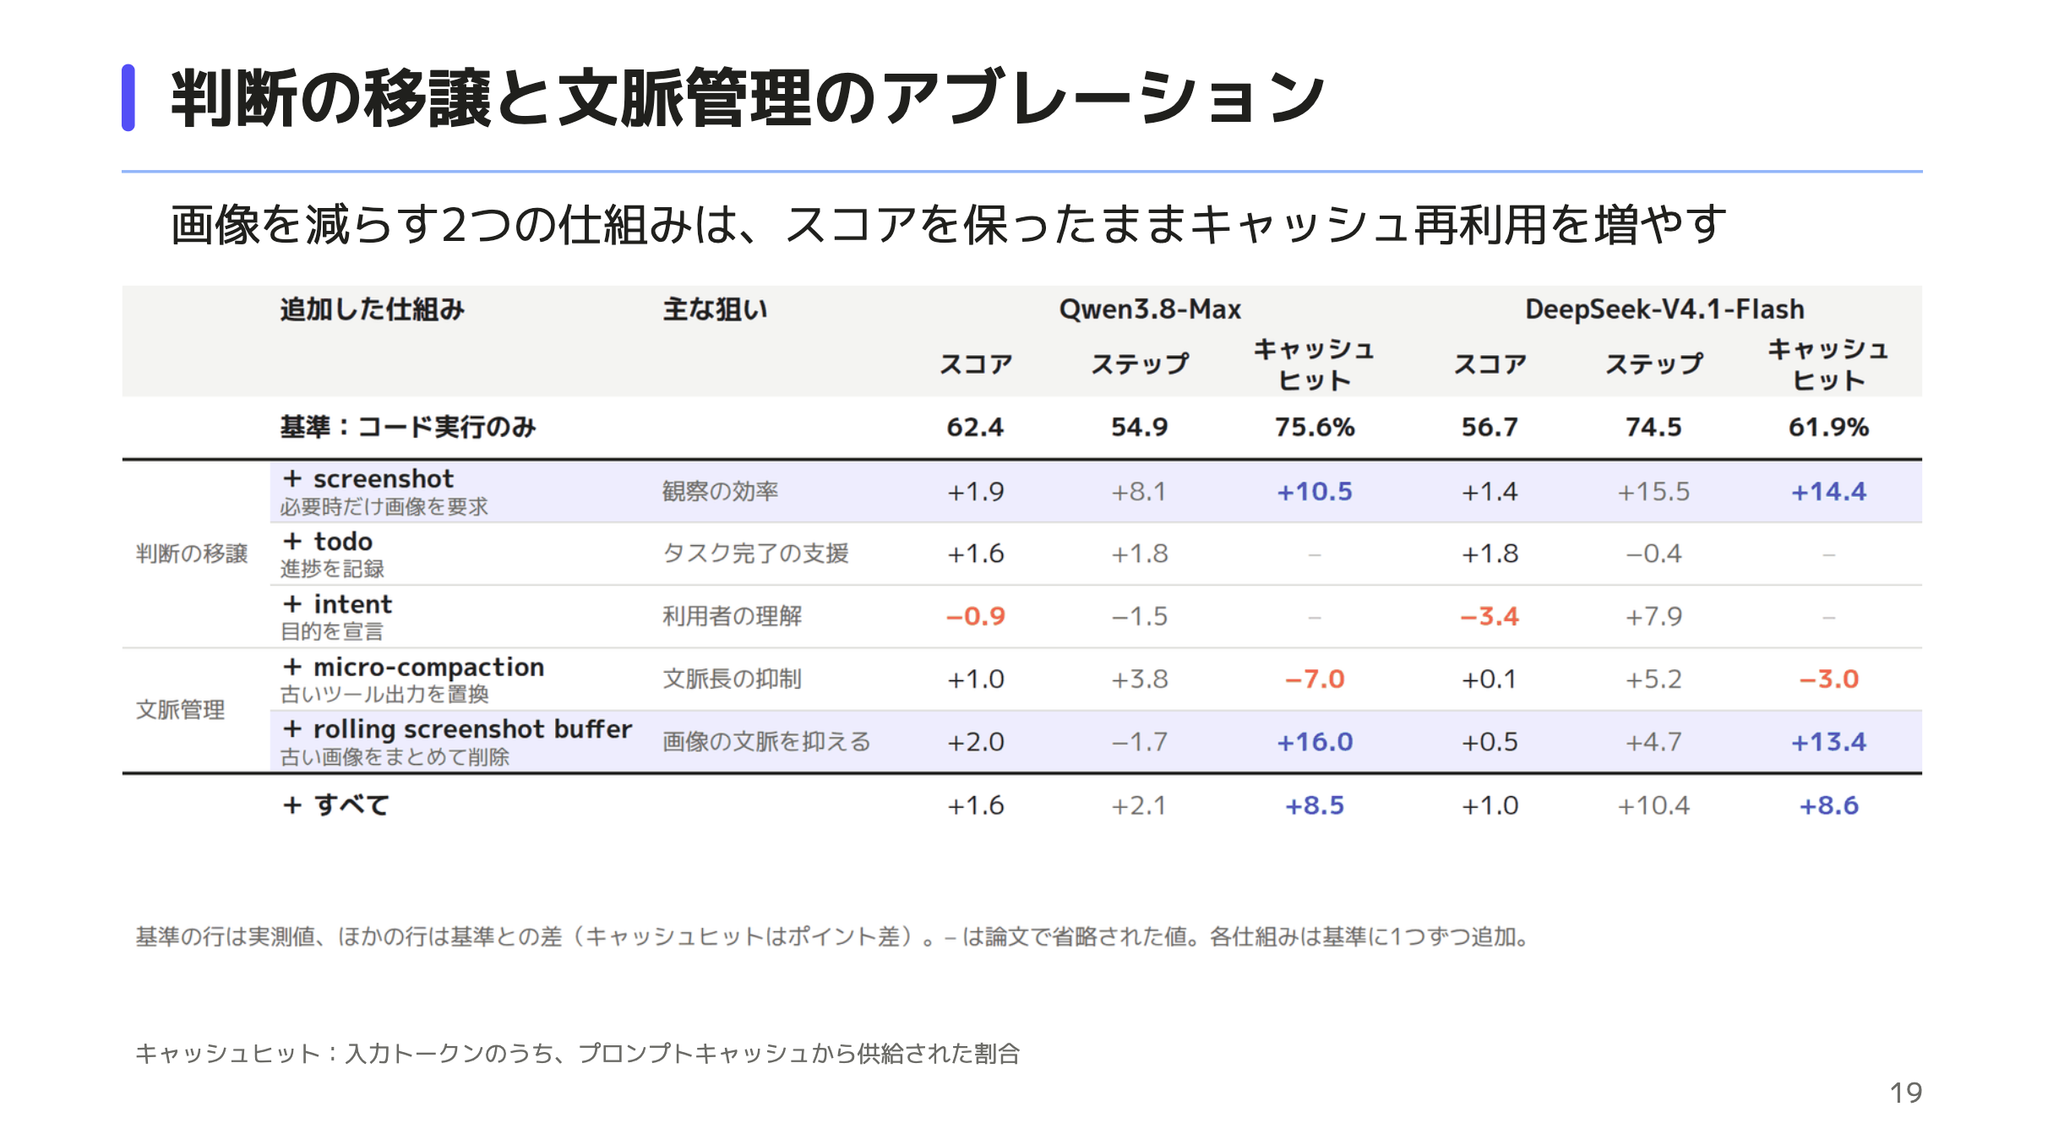
スクショの削除頻度が減ることでキャッシュヒット率が改善している
実機での評価
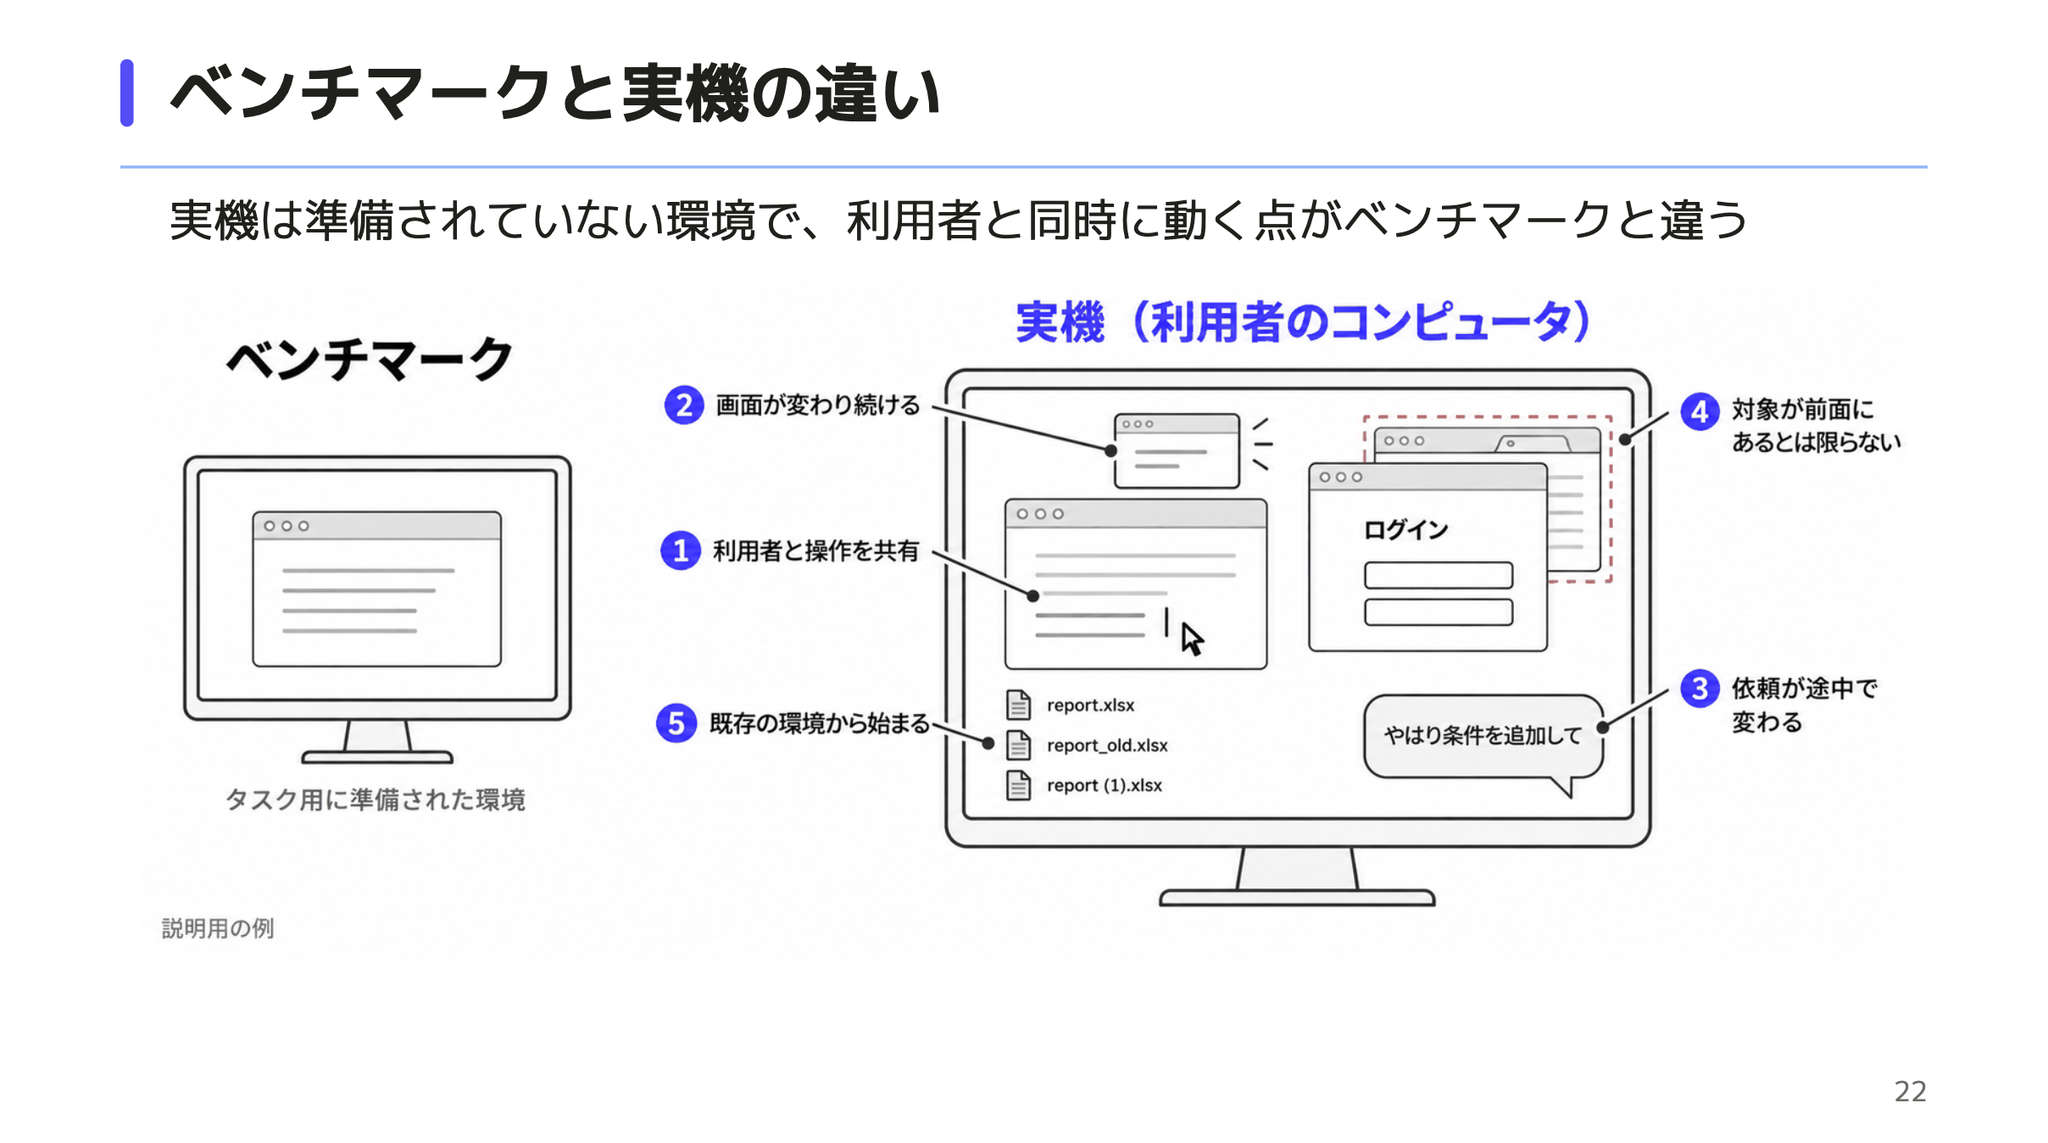
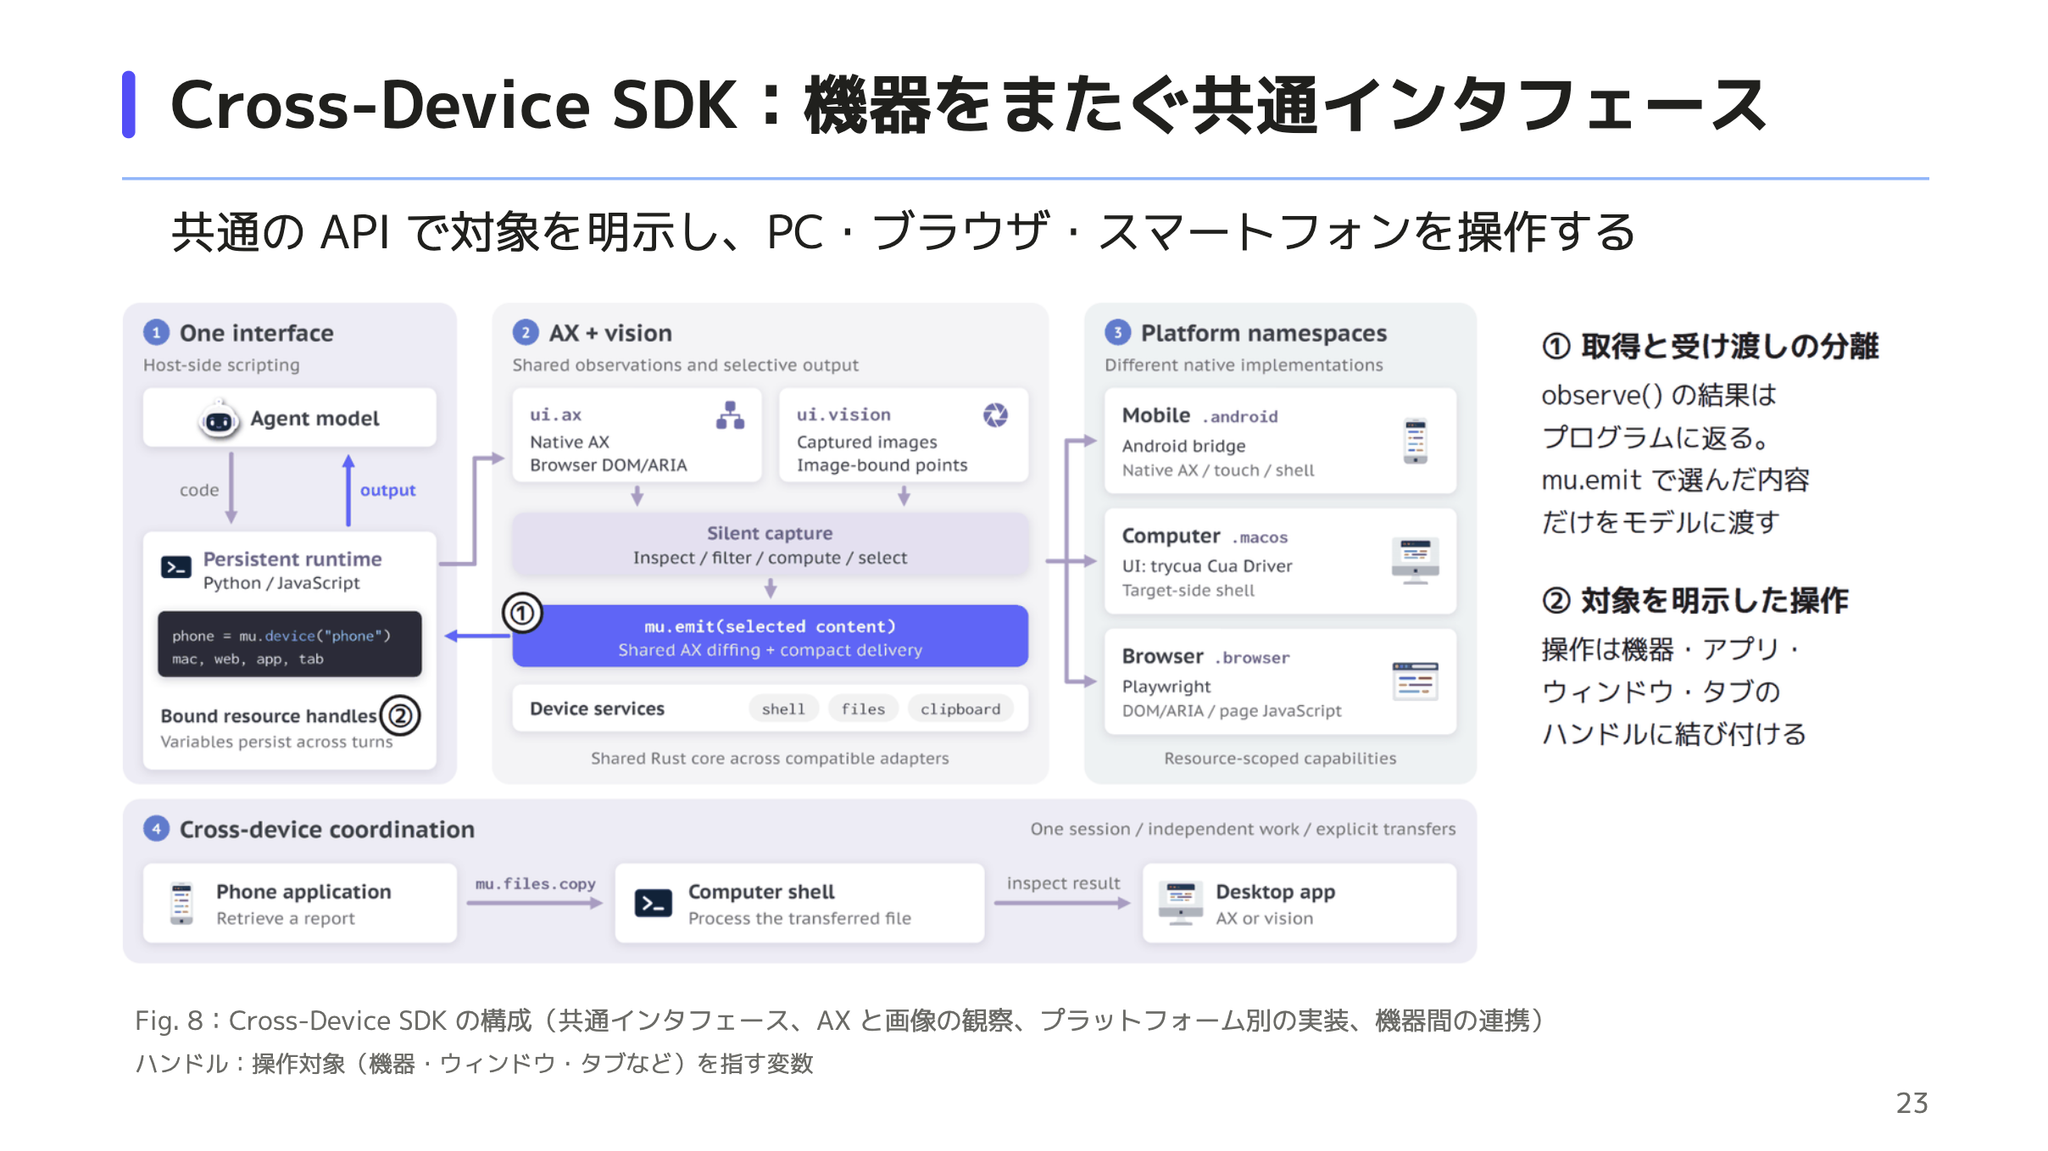
今回の実機検証のために作成しOSSで公開している(現時点ではプレビュー段階)
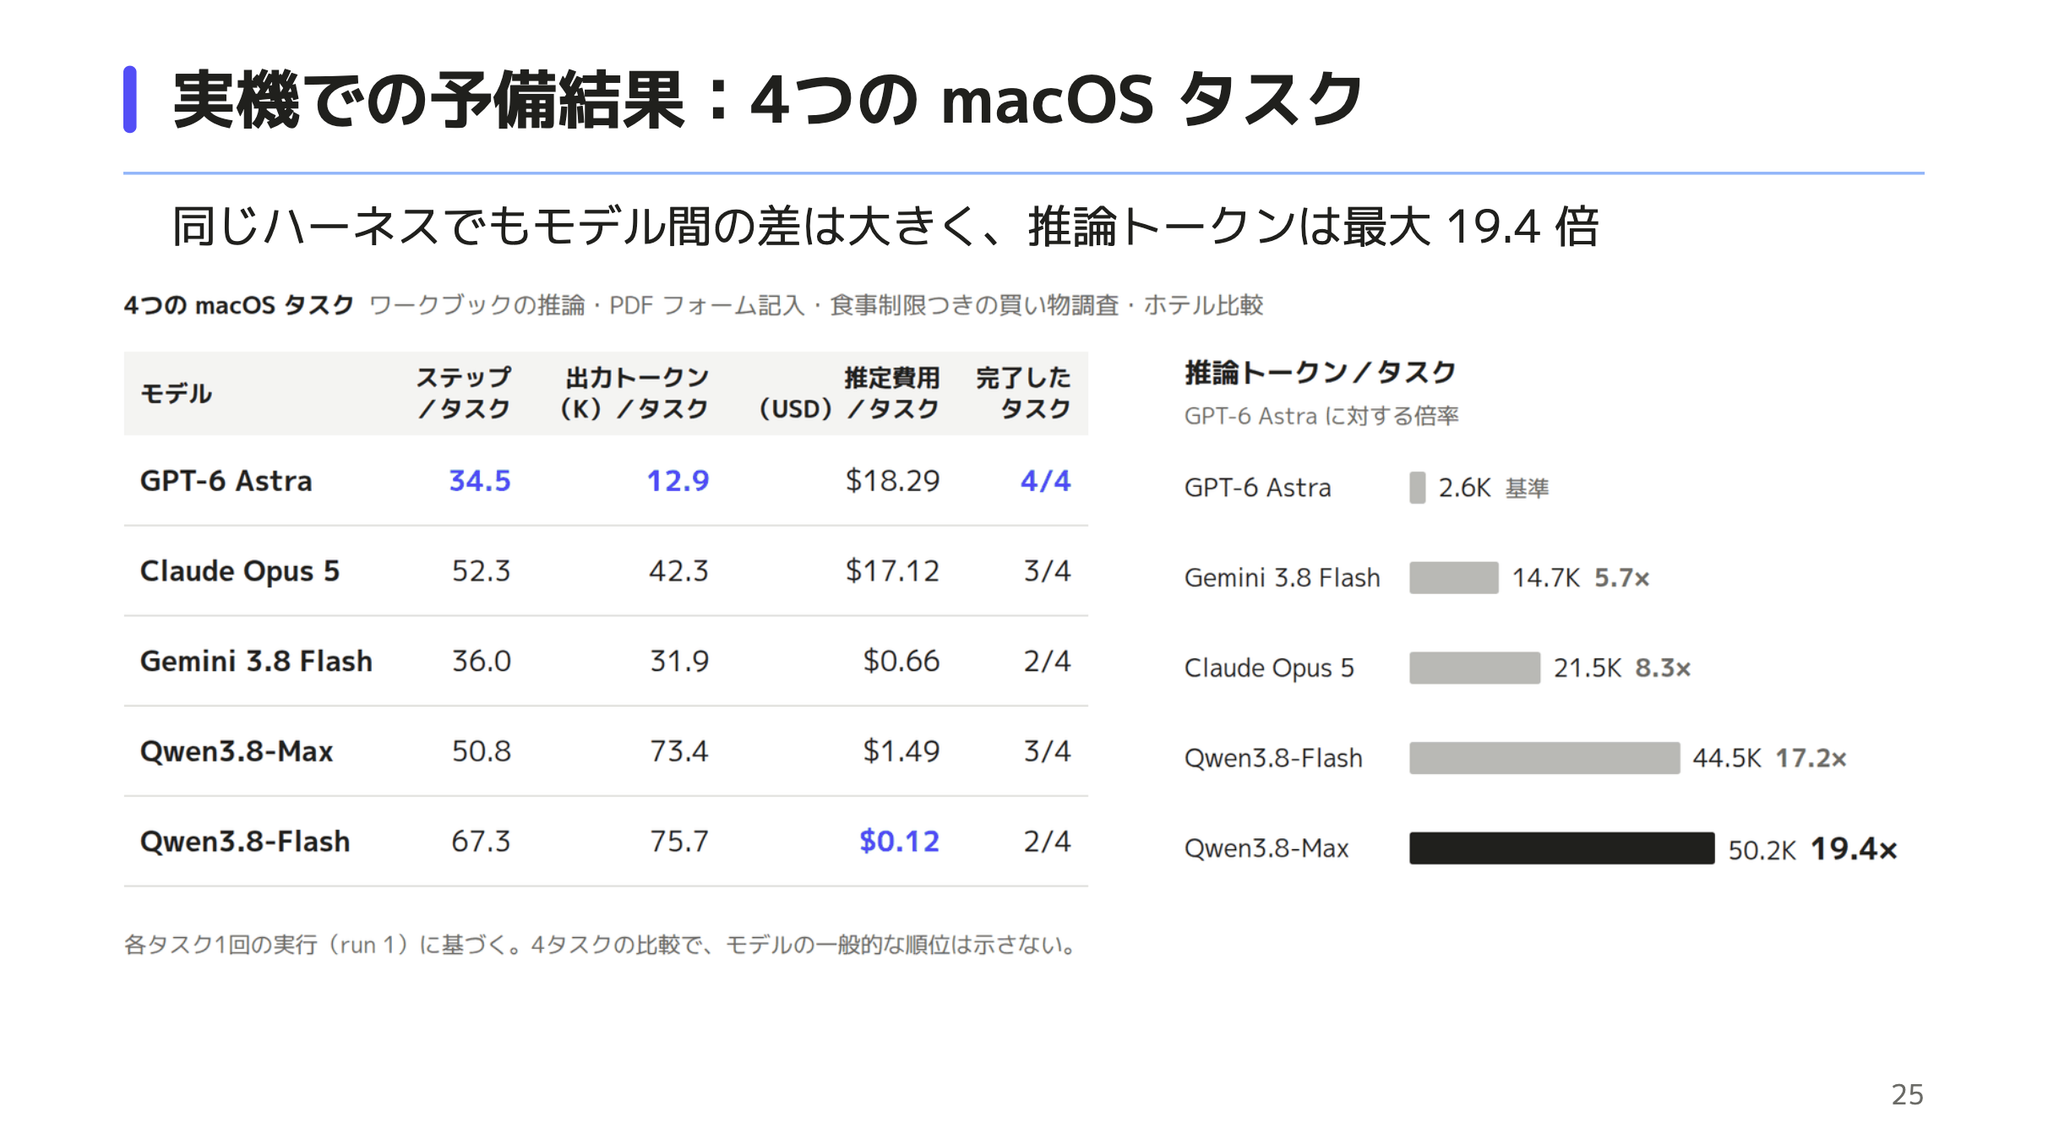
ここの評価はベンチマークのようなハーネスの評価ではなく、実機での検証方法を整え、その環境でモデルごとの挙動の差を比較する評価ができていることを主張している
@Ryuhei Kawabata(monokemonoke)
[blog] Augmenting Human Preference in Complex Domains
- 一言で言うと
- 弁護士同士でも「どちらの回答が良いか」はあまり一致しない。そこで、弁護士の判断を真似て採点する Generative Reward Models (GRM) と呼ぶ LLM を作り、人間の判断を補助・スケールさせる、という Harvey の報告
- GRM は人間の選好ランキングをおおむね再現し、パネルに加えると一致度も上がる。ただし「なぜ良いか」の理由づけでは人間と食い違う
- 問題設定
- 背景
- Harvey は「2つの成果物のどちらが良いか」を弁護士に選んでもらう評価(サイド・バイ・サイド評価)を、AI の改善度を測る基準にしている
- RLHF では、この判断から報酬モデルを学習する。そのためには、明確で均質な人間の選好が必要
- 課題
- 複雑な法務タスクでは、選好が明確でも均質でもない
- 現実でも、第一審の裁判官の判断は控訴審の裁判官から 10〜15% の確率で覆される
- 評価ではトーン・スタイル・推論など主観的な要素も混ざる
- 狙い
- 弁護士に「より十分な情報で判断する」ためのテコを与える
- GRM で、その判断を大規模にエンコードする
- 人間の判断はどれくらい揃わないか
- 調査設定
- Kimi K3 が Harvey Tenet のベースとして妥当か判断するために人間選好調査を実施
- 当時 LAB(Harvey の法務ベンチマーク)で首位だった他の4モデルと、24タスクで比較
- 各タスクを該当分野の弁護士3名が評価
- 結果
- 大規模に見るとモデルの性能ランクがはっきりと分かれる
- 個々の投票は不明瞭
- 3人全員が一致したのは対戦の 25%
- Fleiss' κ(偶然を除いた一致度。0 で偶然並み)は 0.129
- ELO(対戦結果から作る強さの指標)上位3モデルに絞ると、全員一致は 11%、κ は負
- 強いモデル同士では、弁護士の評価が一貫して食い違う
- 不一致の原因
- 記述フィードバックを「すれ違い」と「意見の相違」に分類
- すれ違い: 投票の根拠にまったく別の証拠を挙げている
- 意見の相違: 同じ証拠を挙げて、違う結論に至っている
- すれ違いは 24.3% にとどまった
- 同じ長所と短所を見つけたうえで、どれを重く見るかが人によって違う(例:見栄えと事実の誤りのどちらを優先するか)
- GRM とは
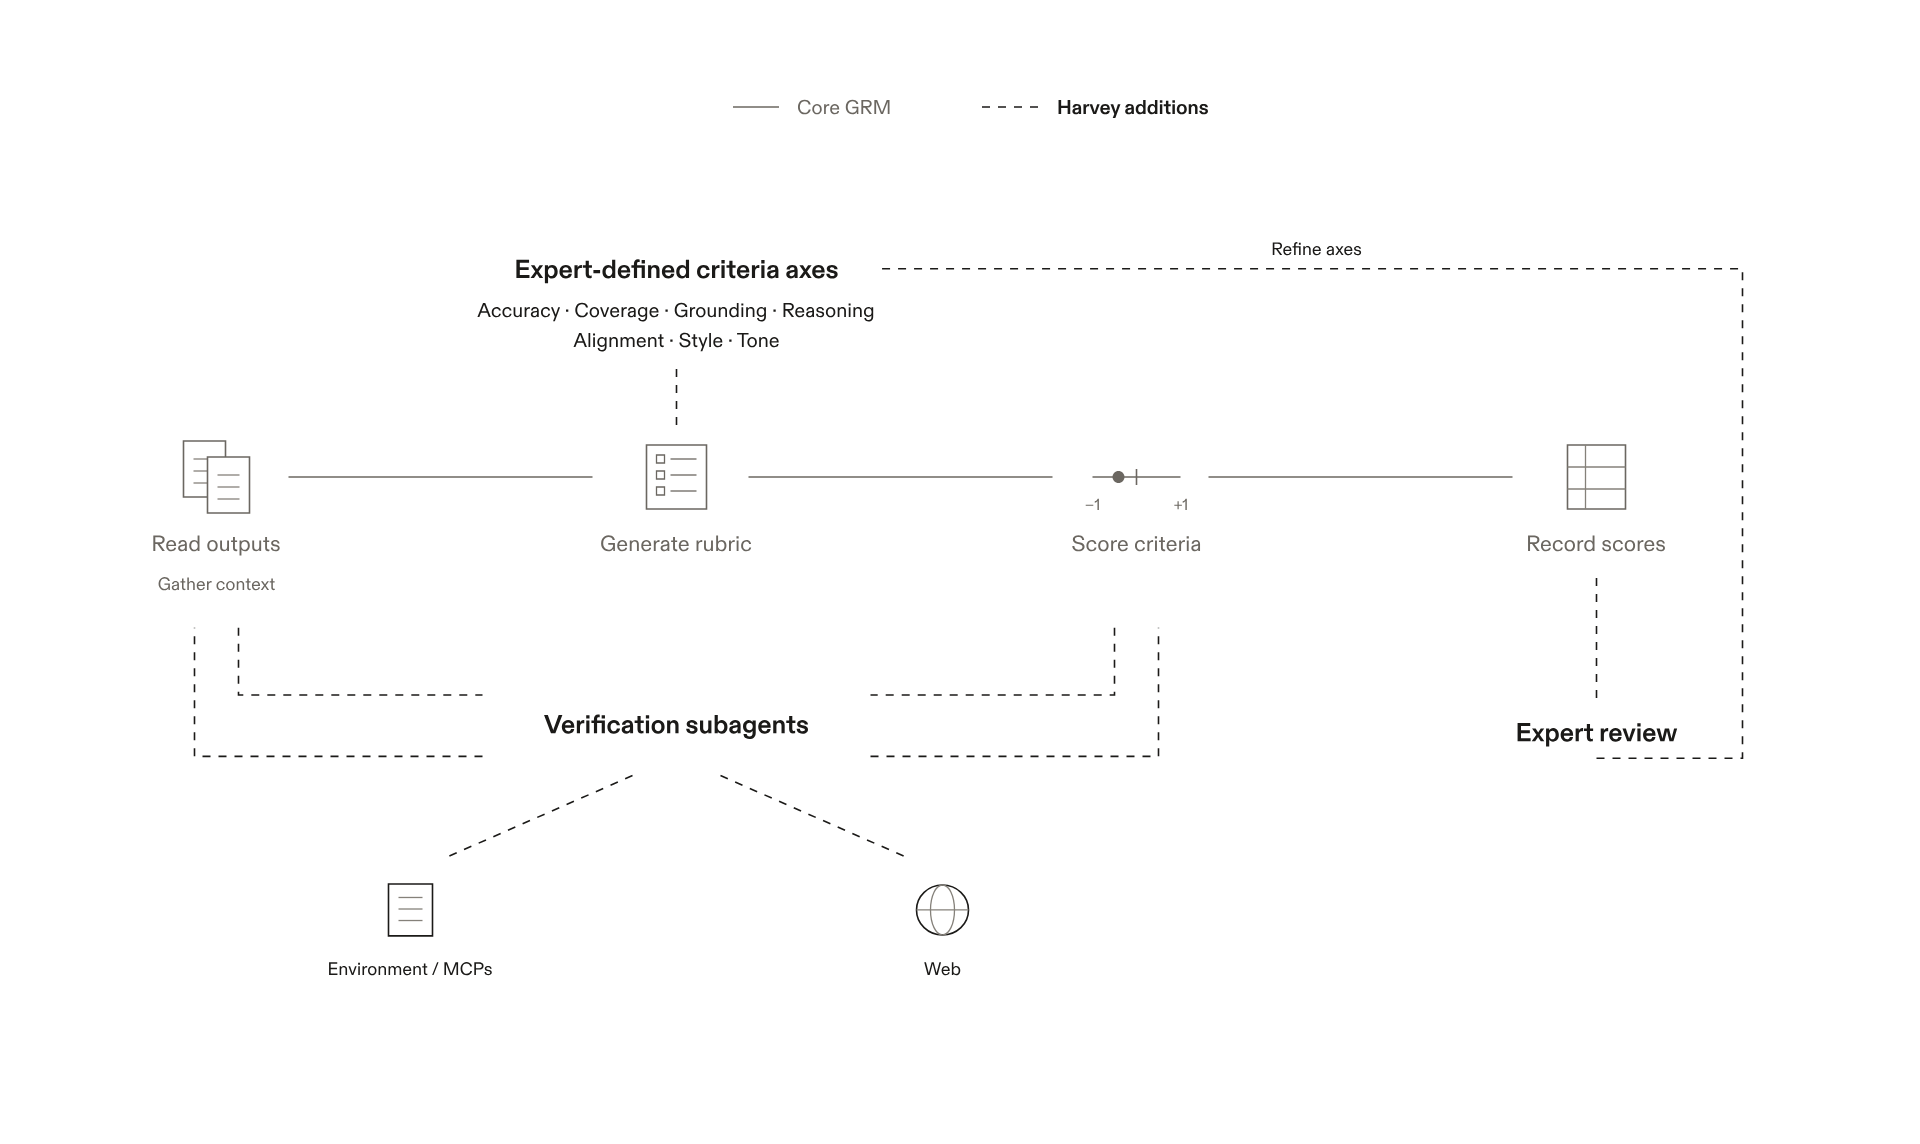
- 人間のレビュアーと同じように、2つの出力に対してペアワイズのフィードバックを返す、エージェント型の LLM ジャッジ
- 着想は Moonshot の K3 技術レポート(13ページ)
- K3 の基本手順
- 出力を読む
- 比較の観点をまとめたルーブリック(採点基準)を作る
- ルーブリックで各候補を採点する
- スコアをスクラッチパッドに記録する
- Harvey の拡張(2点)
- サブエージェントで事実を検証する
- 元の環境(入力文書、MCP など)またはウェブと照合する
- ハルシネーションや事実の誤表現を、品質の一部として重みづけできる
- ルーブリックの軸を固定し、基準ごとに軸をタグ付けする
- 以下の7軸
- 正確性
- 網羅性
- 根拠づけ
- 推論
- 整合性
- スタイル
- トーン
- 各基準を -1(A を最大限支持)〜 1(B を最大限支持)で採点
- 「Bのほうがスタイルは良いが、Aはハルシネーションが少ない」のように、人間に近い理由づけを引き出せる
- GRM は人間をどこまで再現するか
- 設定: Applied Legal Research チームが、7軸について弁護士が重視する点をおおまかに記述する形で GRM をチューニング
- 結果
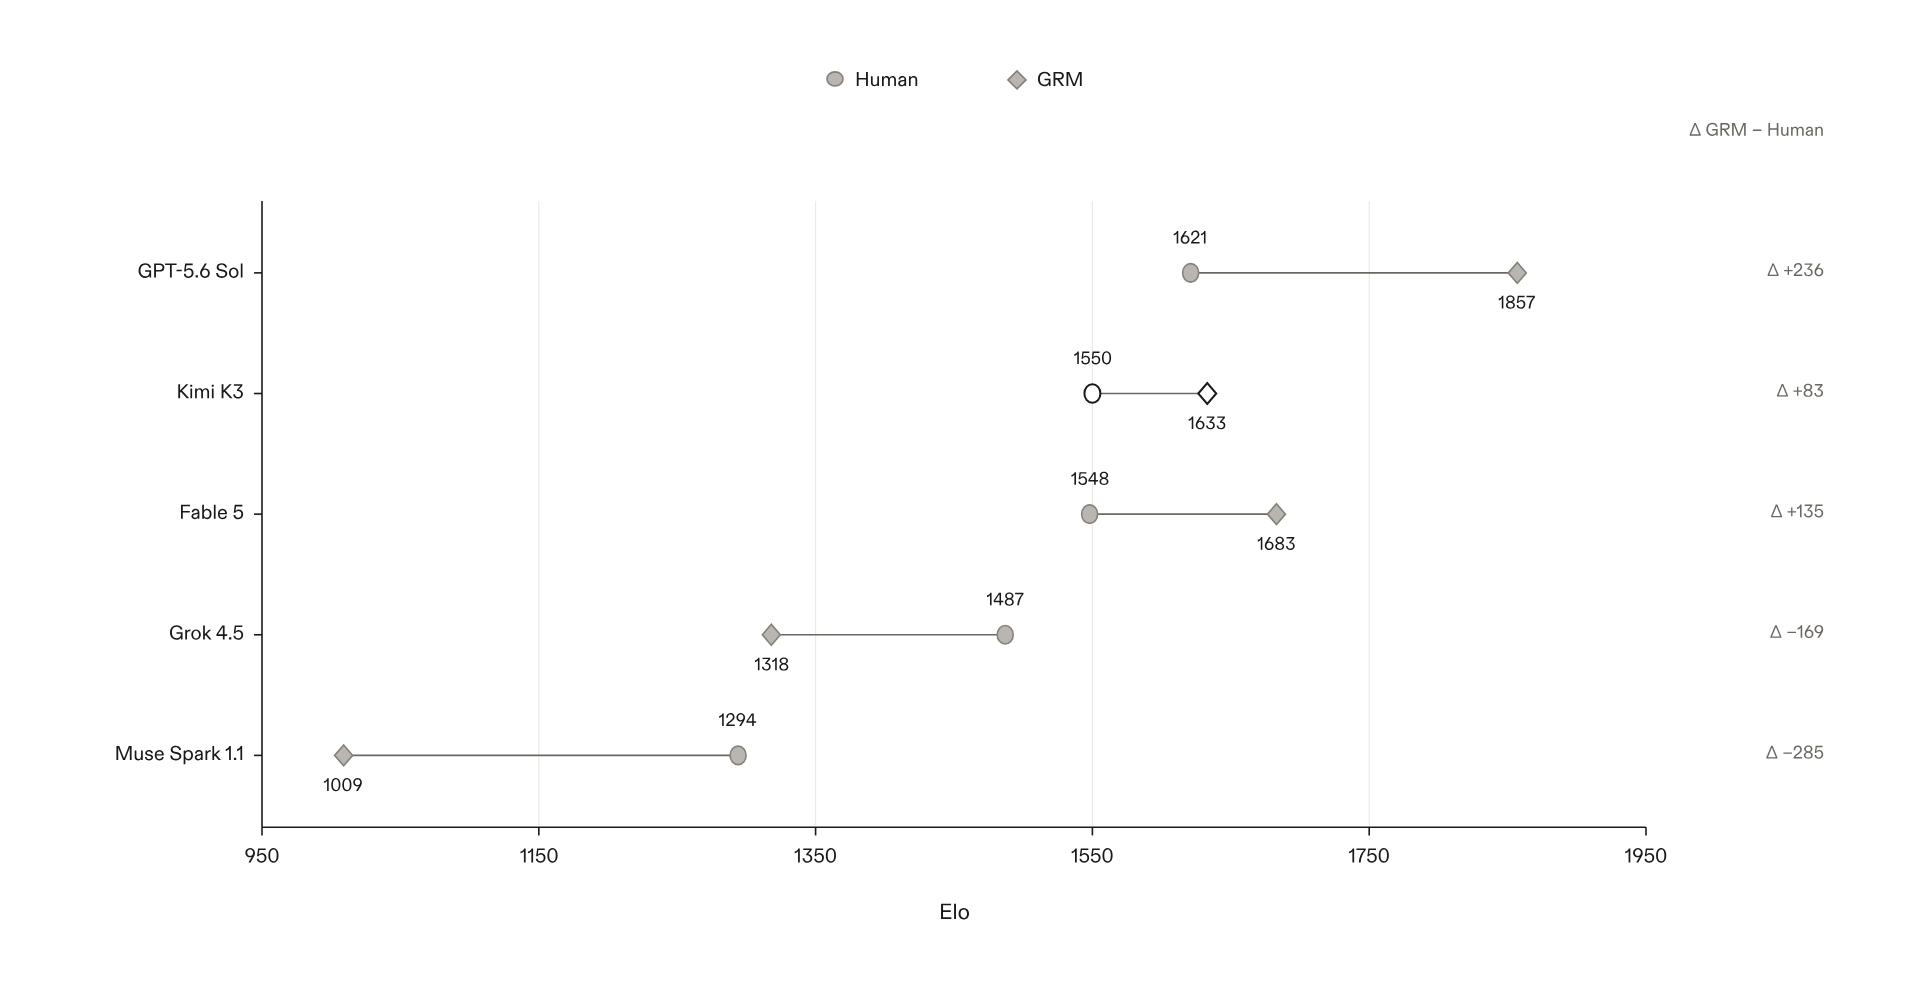
- 上の調査での人間のモデル順位を、GRM はおおむね再現
- 全体の選好では、GRM は人間よりはっきり差をつける
- 人間と同じ方向にモデル間の差を広げる
- ただしルーブリックスコアの平均を使えば、勝ちの大きさも人間の差の大きさと揃う
- タスク単位では「平均より優れたレビュアー」
- 人間3人に GRM を足した4人パネルで κ が 0.128 → 0.216
- 人間1人を GRM に置き換えると、パネルの一致率が 44.7% → 59.2%
- GRM で人間を補助する
- 設定:
- 弁護士が2つの回答を比べるとき、GRM の採点と説明を見られるようにした
- 弁護士が GRM の判断にどれだけ同意するかを3点で測定
- ルーブリックの項目(何を基準に比べるか)
- 全体の選択(どちらが良いか)
- 細かい理由づけ(なぜそちらが良いか)
- 結果
- 主要な事実(どの基準が関連するか、どちらが良いか)はおおむね一致
- 「なぜ良いか」の推論への同意は約 64%
- 人間と GRM の判断が分かれた点
- どの失敗を重く見るか:
- 重大な誤りがあっても他の長所があればGRMは目をつぶる
- 弁護士は重大な誤り・ハルシネーションを許容できない。
- 両方が悪い場合: 人間は引き分けにするが、GRM は無理に勝者を決める
- 役割分担
- GRM: 地道な作業を担う
- 回答のレビュー、主要な比較点の特定、何を考慮すべきかについての最初の推奨
- 人間: GRM の出力を参考にしたうえで、自分で判断する
- 考慮事項をどう重みづけるか、どの結果が本当に最良かを決める
- 将来: 最終段階の人間の判断に合わせて GRM をチューニング・学習し、その判断を数千件の例に広げる
- GRM で見た Harvey Tenet
- ジャッジの同系列バイアス
- Anthropic と OpenAI ののジャッジは僅差の対戦で自社のモデルに投票しがち
- どちらをジャッジに選ぶかで、モデルの ELO が大きく変わった
- 例外: Opus は Fable に対してバイアスなし
- 利害関係のない対戦では、2つのジャッジはよく一致
- 勝者一致が 78%。ルーブリック差が 0.05 超なら 89%
- 対策: 自社のモデルが関わらないジャッジを使う
- Anthropic vs. OpenAI の対戦は、Google の Gemini-3.8 Flash が判定する
- 2つのジャッジがどちらも対戦に関わらない場合は、ランダムに選ぶ
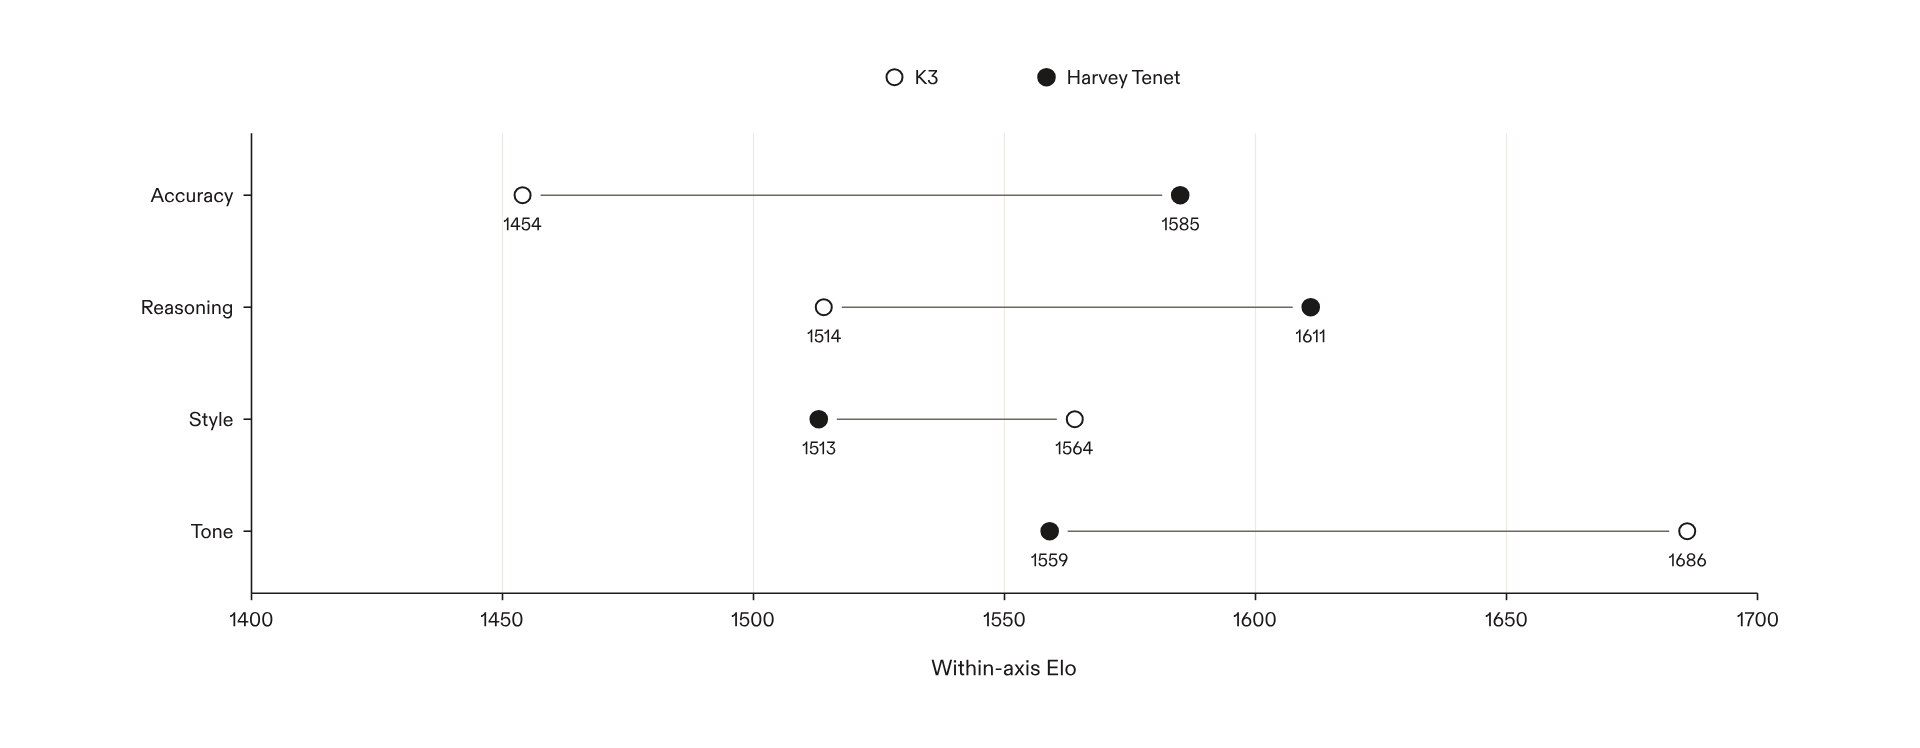
- Kimi K3 ベースとの比較(学習に使用していない LAB タスクでの直接対決)
- 約 130 ELO 向上、3回に2回超の割合で好まれた
- 軸別に見ると、正確性と推論は大きく向上し、トーンとスタイルは後退した
- 理由:
- 専門家があらかじめ書いたルーブリックを、追加学習の主な報酬に使ったため
- LAB のルーブリックは、元の文書から事実を正確に拾うことと、正しい結論に至ることを評価する
- 代償: 素の K3 より情報が詰まっていて、読みにくい文書になることがある
- フロンティアの他モデルも同じ傾向
- Astra と Fable 5.1 は最上位の法的推論モデルだが、前世代よりスタイルとトーンで後退
- スタイル・トーンでは前世代が今も首位
- どのモデルが最良かは、ユースケースによって変わる
- まとめ
- 弁護士の判断が最終基準であることは変わらない
- GRM は、判断を速く正確にし、学習に取り込んでスケールさせる補助になる
- GRM が最も不確かな「使いやすさ・全体の品質」こそ、人間が最も強い領域なので、役割分担が成り立つ
- 目標は Harvey Tenet を、法務向けで最も賢いだけでなく最も役に立つモデルにすること
- monoke 感想
- より明確で一貫性のある評価を最近考えている
- 法務のように、ロジックによる評価だけで測定しきれない領域での GRM を用いた評価は参考になる。
- 内容面での評価(e.g, 正確性・整合性)は GRM で一貫した評価をしやすそうだ
- 一方で、表現面は好みに左右されそうで一貫して評価できるようになるか気になった。
メインTOPIC
Strata - Run a 125-billion-parameter AI model on your own gaming PC
- Qwen3.8-Flash-Next 絶対動かすマンとして知られるStrata!!!
- 制約がある中で何かモデルを動かしたい時のノウハウとして読んだ
- GitHubにあるPaperと大量にあるMDファイルをClaudeにまとめさせたもの↓
- 社内GPUでも活躍中
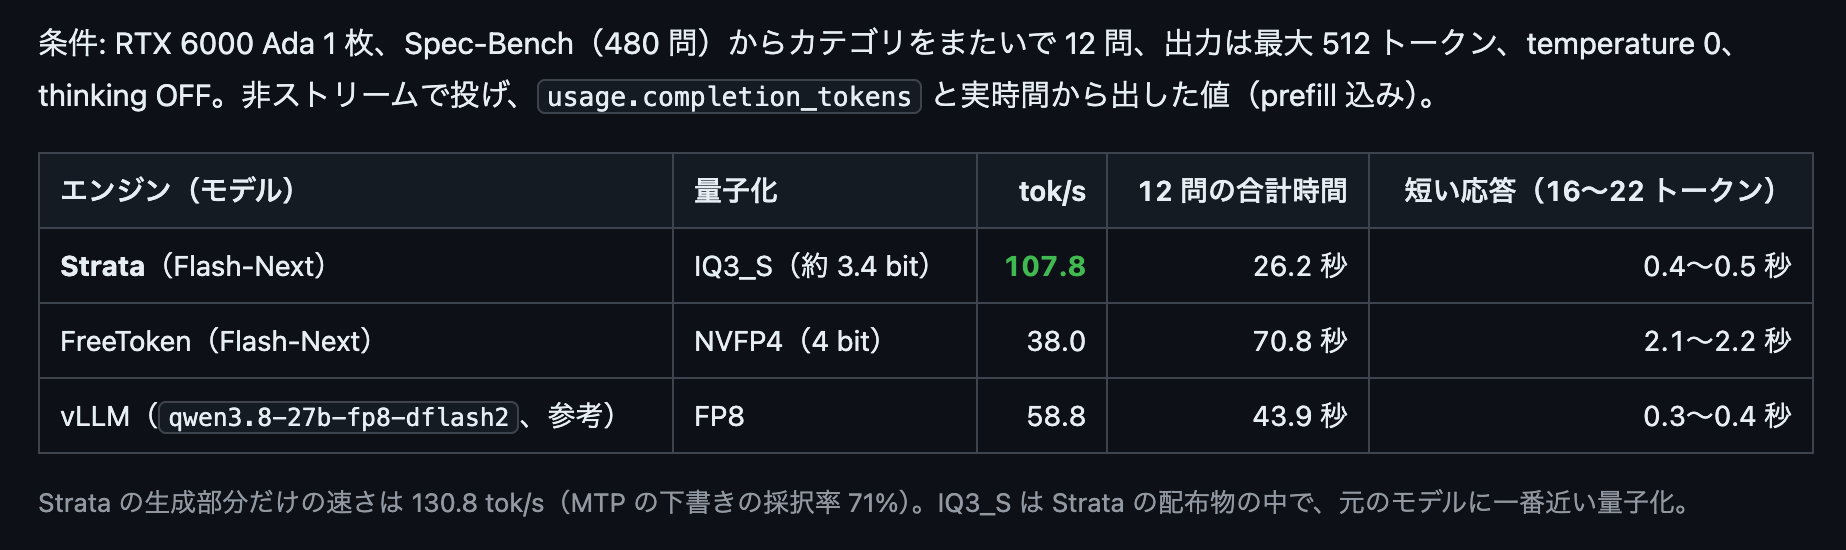
要旨
- Strata は総パラメータ 1,250 億の MoE モデル Qwen3.8-Flash-Next を普通の PC で動かす推論エンジン
- 今回想定する PC は 12 GB 程度のグラフィックカード 1 枚と 64 GB 前後の RAM
- 最小の量子化ファイル(Q2_0)でも 66 GB あり、VRAM に収まらない
- このモデル一つの形に合わせてエンジンを書いている
- VRAM: 毎トークン必ず読む小さな部分と、よく使う expert
- RAM: すべての expert
- SSD: 巨大な n-gram embedding table
- 結果: RTX 5070・Q2_0・エンジン 0.1.36 で、4K コンテキストの生成 94 tokens/s、32K プロンプトの読み込み 2,650 tokens/s
1. はじめに
- LLM は 1 トークンを作るたびに、そのトークンが使う重みをメモリから読み出す
- 一般的な PC のメモリの速さは VRAM(数百 GB/s)、システム RAM(数十 GB/s)、SSD の順
- 生成速度は計算能力より先に「1 トークンあたり何バイトを、どのメモリから読むか」でほぼ決まる
- 対象の Qwen3.8-Flash-Next
- 総パラメータ 1,250 億、1 トークンあたりに使うパラメータは 60 億
- 品質を保てる最小の量子化ファイルは 66 GB で、12 GB のカードの 5.5 倍
- 通常の解決策は llama.cpp のような汎用エンジンで、収まらない部分を CPU とシステム RAM で動かすこと
- 動きはするが、マシンの大部分がほとんどの時間遊んでいる
- Strata の答えはmodel特化
- この一つのモデルの正確な形と、この種の PC の構成に合わせてエンジンを書く
- GPU・CPU・RAM・PCIe リンクのそれぞれに得意な仕事を同時にさせる]
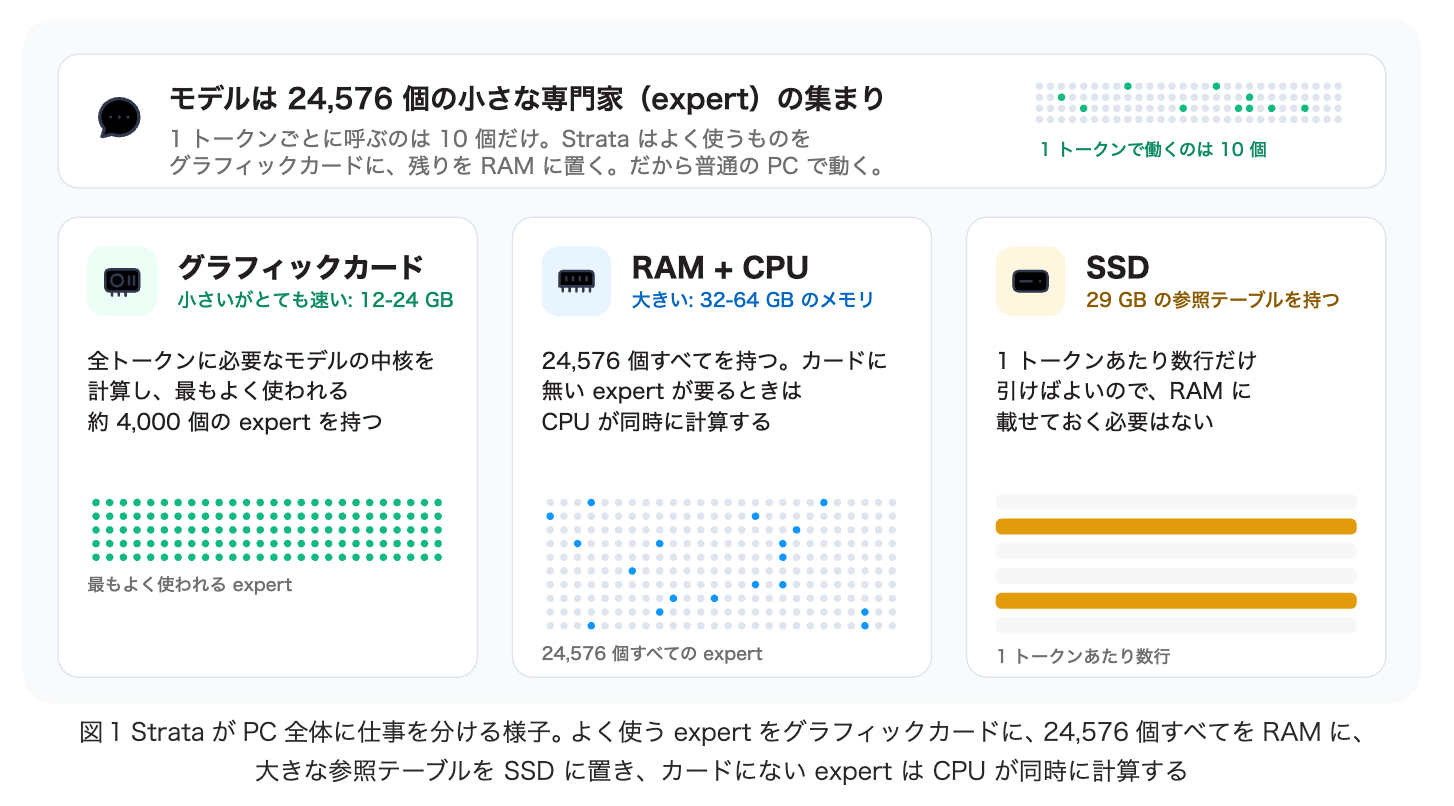
- 図1の分担
- グラフィックカード: 毎トークン必ず使う中核と、よく使われる expert
- RAM: 24,576 個の expert すべて
- SSD: 29 GB の参照テーブル
- カードにない expert が要るときは、CPU が RAM 上で同時に計算する
- これに次の 2 つが加わる
- MTP 層(multi-token prediction)による推測
- VRAM に置く expert を会話に合わせて入れ替える仕組み
- 部品は互いを待たずに同時に働く
- GPU: 全トークン共通の重みと、VRAM 内の expert を処理する
- CPU: RAM 内の expert を処理する
- PCIe リンク: その合間に expert の一部を GPU へ運ぶ
- SSD: テーブルの行を、それを使う層より一歩先に読む
- 主な結果
- RTX 5070(12 GB)・Ryzen 5 7600・64 GB DDR5、2 ビットの Q2_0、エンジン 0.1.36
- 4K コンテキストの生成 94 tokens/s、32K トークンのプロンプトの読み込み 2,650 tokens/s
- 投機的デコーディングで生成が 1.6〜1.8 倍速くなり、出力は通常の greedy decoding とトークン単位で一致する(i-quant のファイルには例外がある。4 節)
2. 対象モデル
復習
- Qwen3.8-Flash-Next の設計者は、アーキテクチャ上の選択の一つひとつを「1 トークンあたりに動くバイト数」で見積もって決めた
- それがモデルの形に表れている
- Strata の設計はこの形をそのまま前提にしている
| 項目 | 値 |
|---|---|
| 総パラメータ / 1 トークンあたりに使うパラメータ | 1,250 億 / 60 億 |
| 層 | 48 層(mixer は GDN 36 層 + QSA 12 層) |
| QSA | KV ヘッド 2 本、参照する位置は高々約 2,048 |
| routed expert | 各層 512 個(計 24,576 個)。router が上位 10 個(約 2%)を選ぶ。ほかに shared expert |
| n-gram embedding table | 510 億パラメータ、IQ4_NL で 28.8 GB。直前 3 トークンの id で 1 トークン 16 行を引く |
| MTP 層 | 1 層。GGUF には含まれず、BF16 チェックポイントから取得(5 GB)。VRAM 上で 0.8 GB |
| 学習したコンテキスト長 | 262,144 トークン |
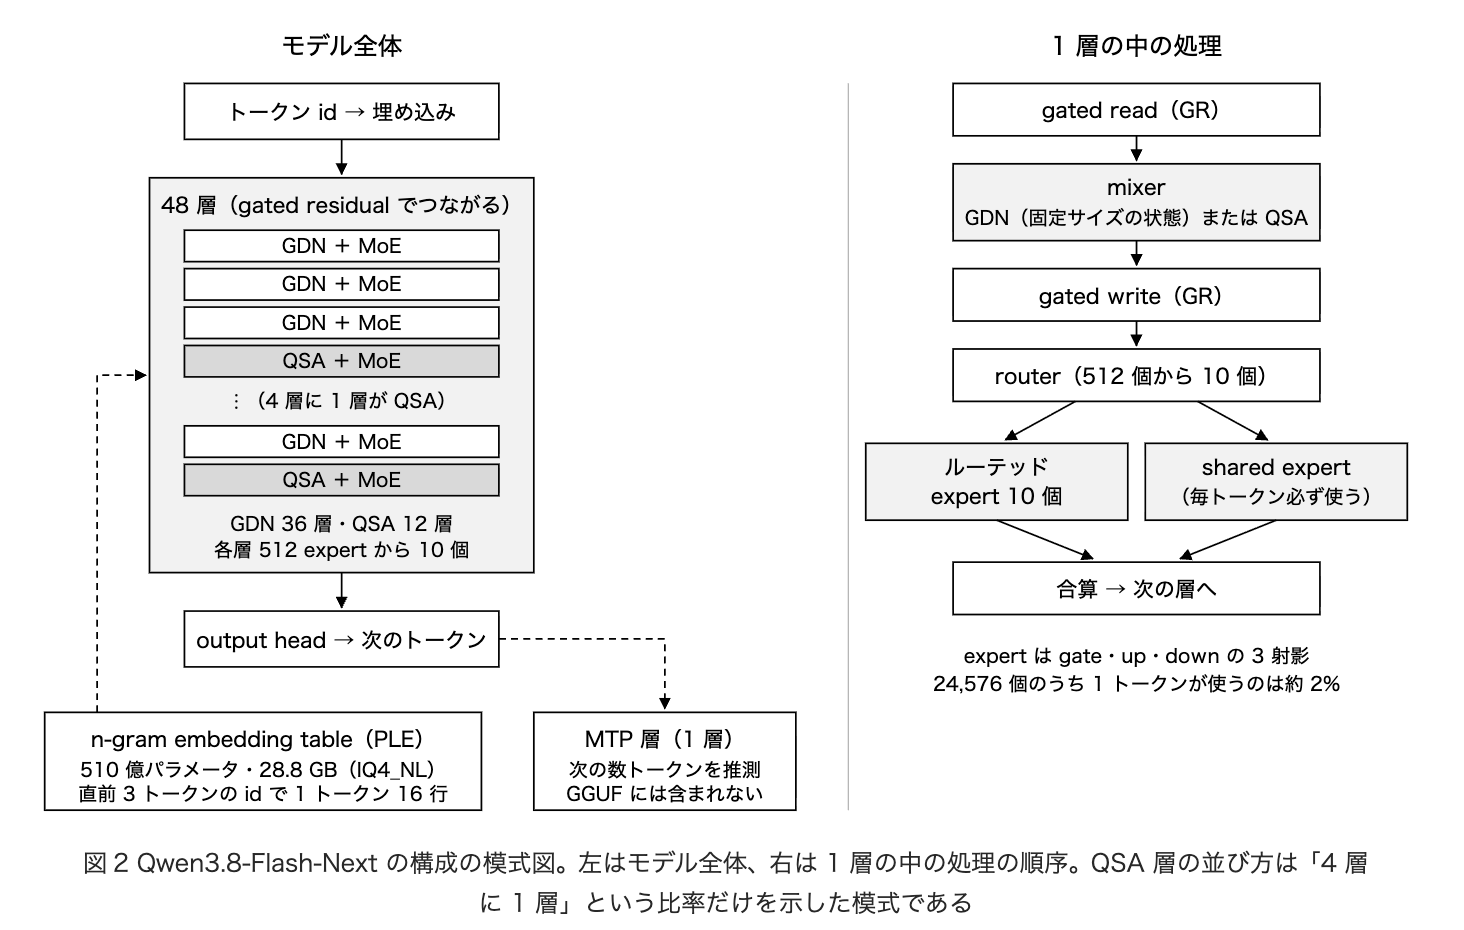
- 1 層はトークン間で情報を混ぜる mixer と、トークンごとに独立に働く MoE の二段
- 処理の順: gated read → mixer → gated write → router → shared expert と選ばれた expert の計算 → 合算
- 層と層の間の残差の経路は複数のストリームを持つ hyper-connections で、Strata の資料では gated residual(GR)と呼ぶ
- mixer
- 36 層(4 分の 3)は Gated DeltaNet(GDN)
- 再帰型の mixer。過去の全トークンのキーと値を蓄える代わりに、固定サイズの状態を 1 トークンごとに更新する
- 状態の大きさがコンテキスト長に依存しないので、デコードの仕事は 1 トークンあたり一定
- 残る 12 層は Qwen Sparse Attention(QSA)
- KV ヘッドは 2 本だけ。コンテキストがどれほど長くても、選び出した高々約 2,048 か所だけに attention を向ける
- attention の計算量はコンテキスト長に比例して増えず、KV キャッシュも小さい
- それでも 262K トークンでは、KV キャッシュ、インデクサのキー、大きくなったプロンプト用バッファが合わせて約 4 GB を占める
- MoE
- 各層 512 個の routed expert から router が 10 個を選ぶ。1 トークンが触れるのは 24,576 個の約 2%
- これとは別に、毎トークン必ず使う shared expert がある
- router の選択は偏っていて、一部の expert はほかよりはるかに頻繁に選ばれる
- よく使うものを VRAM に置けば、限られた VRAM でも多くの選択を GPU で処理できる。この偏りが Strata にとって決定的に重要
- 層の外側の 2 つの大きな部品
- n-gram embedding table(510 億パラメータ): 直前 3 トークンの id で引くので、どの行が要るかはその行を使う層に到達する前に分かる
- MTP 層: 次の数トークンを安価に推測する 1 層。Strata は投機的デコーディングの draft に使う
- GGUF には含まれないので、BF16 チェックポイントからこの層のテンソルだけを取得する
- expert を 2 ビットにし、output head を部分集合の語彙に絞って VRAM に置く
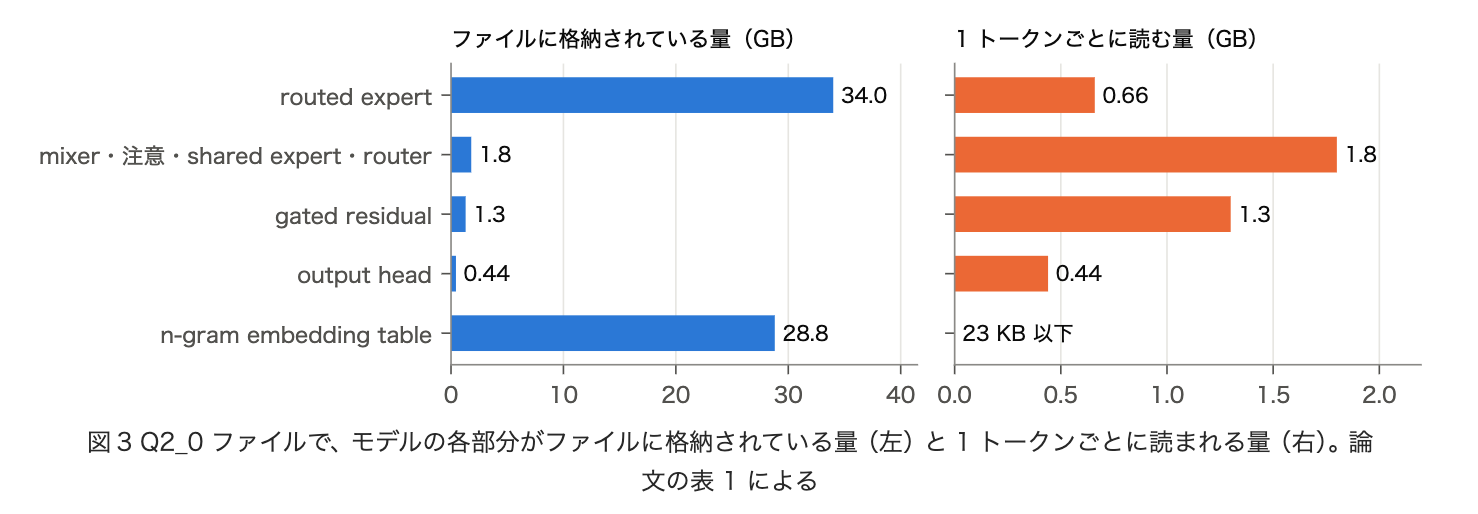
- 図3で見てほしい点は 3 つ
- mixer・attention・shared expert・router(1.8 GB)、gated residual(1.3 GB)、output head(0.44 GB)は合わせて約 3.5 GB と小さいが、毎トークン全部が読まれる
- 最も帯域の広い VRAM に置くのが合理的で、12 GB のカードにも収まる
- routed expert は格納量 34.0 GB と大きいが、1 トークンが読むのはその 2% の 0.66 GB だけ
- 論文はこの 0.66 GB を設計の中心に置いた量だとしている
- n-gram テーブルはファイルの 4 割を占めるが、1 トークンあたり 23 KB 以下しか読まれないので SSD に置いたままでよい
- 0.66 GB が中心になるのは、どこで計算するかで読み出し速度が一桁変わるから
- テストマシンの帯域: VRAM 672 GB/s、RAM 約 41〜52 GB/s、PCIe 4.0 x16 約 26 GB/s
- VRAM の外の expert は、RAM の帯域で CPU が読むか、PCIe 越しに GPU へ運ぶしかない
- VRAM に置ける expert が 1 個増えるごとに、CPU が計算するものが 1 個減る
- ドキュメントが「GPU の速さより VRAM の容量が効く」「VRAM が 1 GB 増えるごとに expert が約 700 個多く入る」と繰り返すのはこのため
- 残る問題は VRAM に入りきらない expert の読み出しを毎トークンどう処理するか。その答えが 3 節のシステム設計
3. システム設計
3.1 三つのメモリ tier
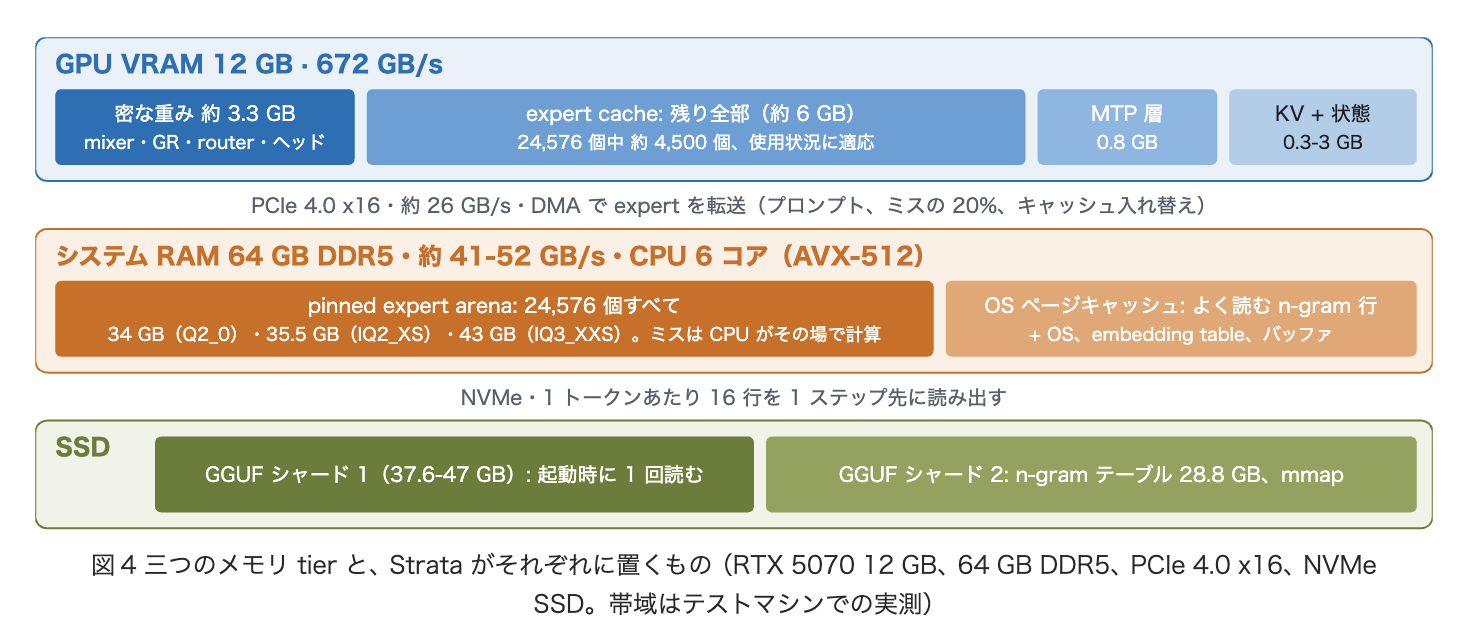
- PC のメモリを VRAM、システム RAM、SSD の三つの tier として扱い、2 節のバイト勘定に従って中身を割り振る
- VRAM: 毎トークン必要なものをすべて置く
- mixer、gated residual、router、shared expert、output head、MTP 層、KV キャッシュと再帰状態
- 12 GB のカードでは、密な重み約 3.3 GB、MTP 層 0.8 GB、KV と状態 0.3〜3 GB
- 残りの約 6 GB はすべて expert cache で、24,576 個のうち約 4,500 個が入る
- VRAM の expert が 1 個増えるごとに CPU の仕事が 1 個減るので、空いた VRAM はすべてキャッシュに回すのが得
- システム RAM: 24,576 個の expert を、VRAM にあるものも含めてすべて、一つの pinned memory(page-locked)の arena に置く
- 大きさは Q2_0 で 34 GB、IQ2_XS で 35.5 GB、IQ3_XXS で 43 GB
- pinned にする理由は 2 つ
- CPU がどの expert でもその場で計算できる
- GPU がどの expert でも PCIe 越しに DMA で取り込める
- 全部を pinned しておけば、VRAM にない expert を GPU に運ぶか CPU で計算するかを層ごとに自由に選べる
- Windows では 34〜43 GB を一つの範囲としてページロックしようとすると失敗するので、層ごとの範囲に分けて pinned する
- SSD: 28.8 GB の n-gram テーブルを置いたままにする
- 各トークンが必要とする 16 行を、それを使う層より一歩先に読み出す
- このテーブルを RAM にも VRAM にも置かずに済むことが、66 GB 以上のモデルを 64 GB の PC で動かす前提になっている
3.2 1 層の中の分担
- デコードは 48 層を順に通る。性能を決めるのは、1 層の中で GPU・CPU・PCIe の三つの資源をいかに重ねて動かすか
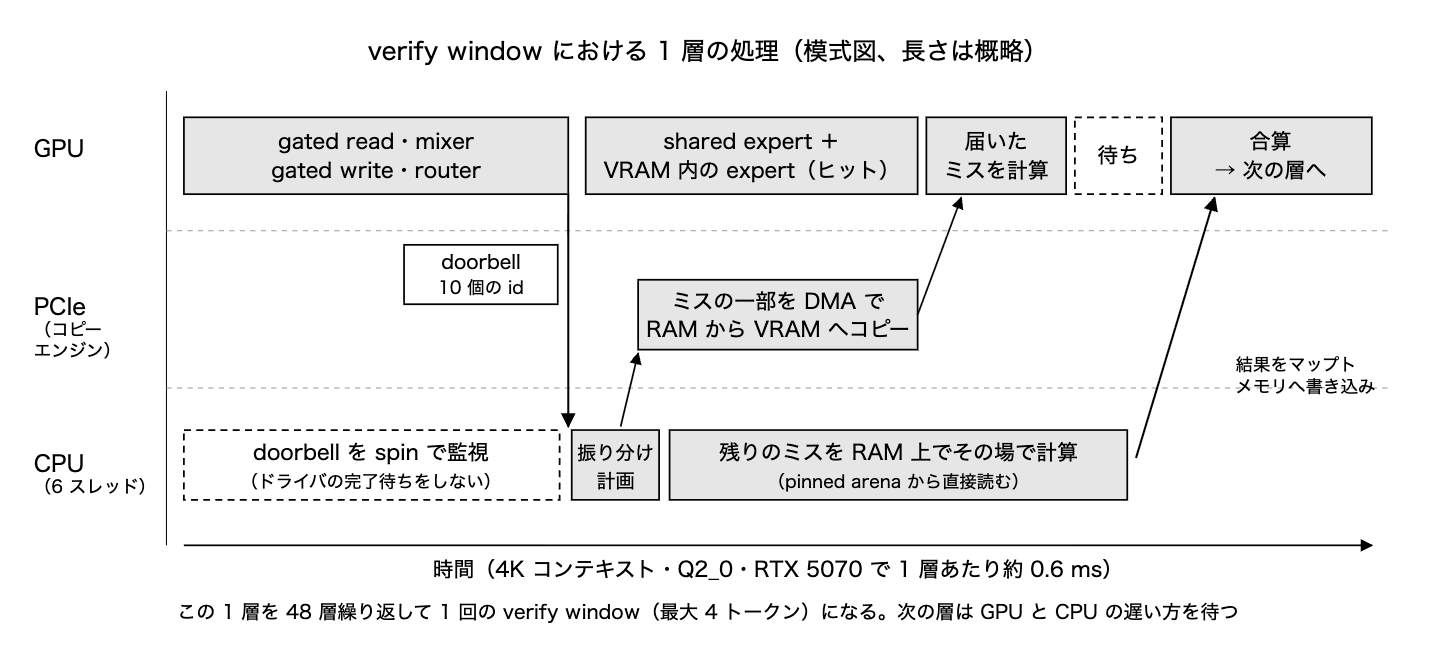
- 1 層の流れ
- GPU がまず gated read、mixer、gated write、router を実行する
- router が選んだ 10 個の expert の id を、pinned のホストメモリ上の小さなブロックに書き込む。これを doorbell と呼ぶ
- CPU はドライバの完了待ちではなく doorbell を spin で監視し、id が書かれるとすぐに expert を三つに振り分ける
- VRAM のキャッシュにあるもの(ヒット)は GPU に任せる
- キャッシュにないもの(ミス)のうち一定の割合は、GPU のコピーエンジンが PCIe 越しに運ぶ
- 残りのミスは、RAM のすぐそばにある CPU のコアが計算する
- CPU は結果を GPU からも見える pinned memory に書き戻し、GPU がすべてを足し合わせて次の層に進む
- GPU のキャッシュ済み expert の計算と CPU のミスの計算は同時に走り、次の層はその遅い方を待つ
- 4K コンテキストでは 1 層がおよそ 0.6 ms。verify window(4 節)ごとにこれを 48 層繰り返す
- doorbell を使う理由
- 1 層 0.6 ms 程度の処理を毎ウィンドウ 48 回繰り返すので、同期的なドライバ呼び出しで待つたびに入る遅れが無視できない
- 逆方向も同じで、48 層のパス全体はウィンドウの大きさごとに記録した CUDA グラフとして実行し、ホストが同期的なドライバ呼び出しで待つことはない
- この構造が速いのは、expert の計算を置き場所の近くで行うから
- VRAM の expert は GPU が 672 GB/s で読み、RAM の expert は CPU が RAM の帯域で読む
- RAM の expert を毎回約 26 GB/s の PCIe で GPU に運ぶより、CPU がその場で計算した方が多くの場合に速い
- ただし CPU の計算能力にも RAM の帯域にも限りがあるので、コピーエンジンという三つ目の資源でミスの一部を GPU に回し、両者の負荷を釣り合わせる
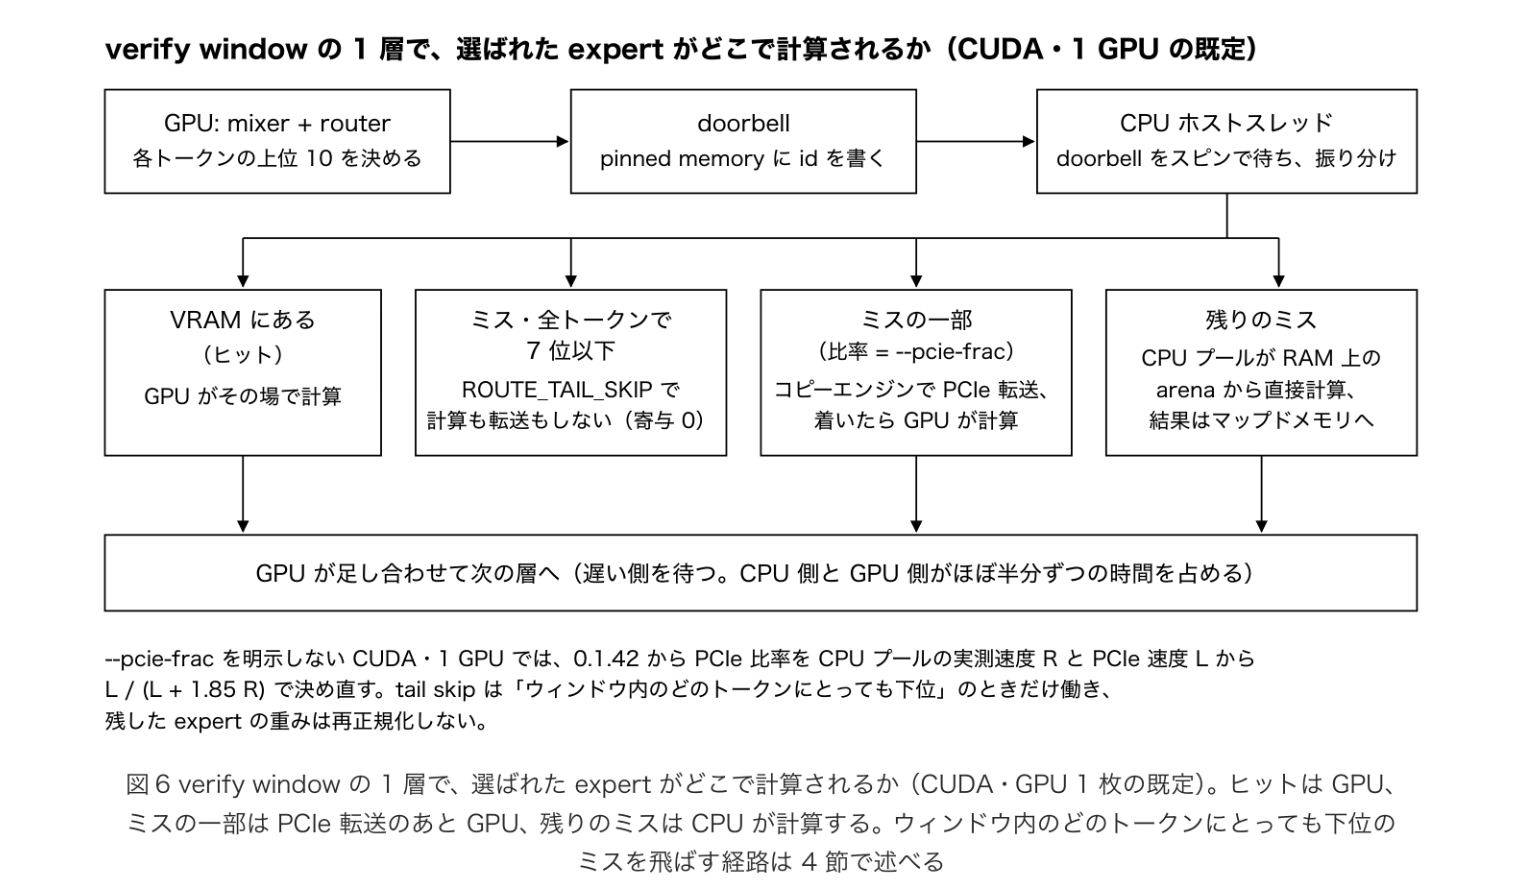
- どれだけを PCIe に回すべきかは、CPU が何に律速されているかで変わる
- 論文の時点の i-quant(IQ2_XS、IQ3_XXS): ミスの 55% を PCIe に回していた
- CPU がコードブックの復号という演算に律速されて、RAM の帯域が余るため
- DMA コピーにしたことで、4K の IQ2_XS は 70 → 78 tokens/s、IQ3_XXS は 56 → 65 tokens/s
- Q2_0: 20% にとどめていた
- CPU のカーネルがすでに RAM の帯域を使い切っており、DMA は CPU から帯域を奪うだけになるため
- 論文はこのコピーエンジンの利用を「重ね合わせのうち報われたもの」と呼ぶ
- 最初の実装では GPU 上のコピーカーネルが RAM から直接読んでおり、この読み出しが GPU のクリティカルパスに乗るので、ミスの 20% を超えて取り込むと遅くなった
- 後の版での変化
- 0.1.14: IQ のパックで DMA コピー中にホストがドライバの中で待ち続ける停止が見つかり、expert は GPU のカーネルでコピーするようになった
- 0.1.42 以降: CUDA・GPU 1 枚で割合を指定しない場合は、割合を L/(L + 1.85R) で決め直す
- R は CPU プールがミス 1 個にかける実時間から求めた速度、L は PCIe の速度
- CPU が速いほど PCIe の割合を下げ、リンクが速いほど上げる
- 係数 1.85 は 3 台のマシンへの当てはめで、最適値そのものではない
- 報われなかった重ね方
- 各ウィンドウを二つのトークングループに分け、一方の CPU expert を計算している間に GPU がもう一方を処理する方式
- 4K で 91.8 → 85.8 tokens/s と約 7% 遅くなった
- 密な重みを 2 回読むことになり、グループごとにトークン間で共有される expert が減るため
- 重ねる価値があるのは別々の資源を同時に使う場合で、同じ資源を二度使う場合ではない
3.3 会話に追従する expert cache
- 起動時に、ほかのプロンプトで記録したプロファイルに従って、最もよく使われる expert で VRAM のキャッシュを埋める
- 4 ラウンドごとに、現在の会話が繰り返し求める expert を最大 96 個、最も使われていないスロットに入れ替える
- 入れ替えは GPU が draft している間に行う
- ヒット率(VRAM から供給された選択の割合)
- プロファイルで埋めた約 4,500 個のキャッシュ: 学習に使っていないプロンプトで約 0.50
- 会話に合わせた入れ替えを加えると、12 GB のカード・4K で 0.72
- 入れ替えのために誰かを待たせることもない
- 古い expert はすぐに追い出し、新しい expert はコピーが届いてから受け入れるように変えたところ、4K の Q2_0 は 91.7 → 94.4 tokens/s
- キャッシュの大きさはスロット数ではなくバイト数で決める
- IQ3_XXS の expert は層によって 1.3〜2.3 MB と大きさが違う
- 各スロットを最大の expert に合わせるのをやめて層ごとの大きさに合わせたところ、入る expert は 2,673 個 → 3,556 個に増え、1K のデコードが 13% 速くなった
3.4 低 RAM モード
- ここまでは全 expert を RAM に置けることを前提にしていた
- エンジン 0.1.26 から、RAM が expert とシステム(expert +約 10 GB)を同時に保持できない PC のための低 RAM モードがあり、setup が選ぶ
- expert をファイルからマップし、GPU が持たない expert は OS のファイルキャッシュに任せる方式
- GPU が持たない分だけを起動時に RAM にコピーする方式(0.1.30)
- 大きな GPU ではほぼ通常の速度で動くが、小さな GPU ではほとんどの expert が SSD から来るので大幅に遅くなる
4. デコード: 推測して検証する
4.1 MTP 層による投機的デコーディング
- 1 トークンごとに約 3.5 GB の密な重みを読むことが GPU の主なコスト
- このコストは 4 トークンをまとめて処理してもほとんど増えない。重みを 1 回読めば、その間に複数トークンの行列ベクトル積をまとめて計算できる
- そこで、MTP 層でトークンを安価に推測し、全 48 層を 1 回通すだけで複数のトークンを検証する。これがデコードの基本単位
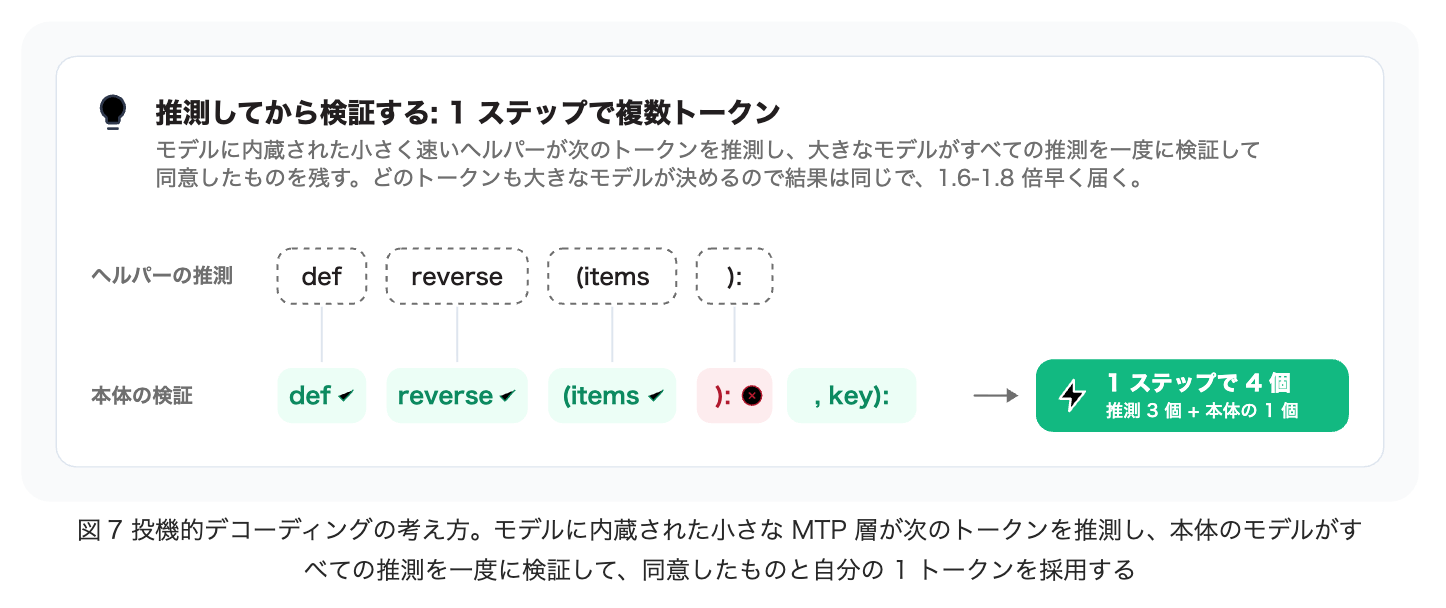
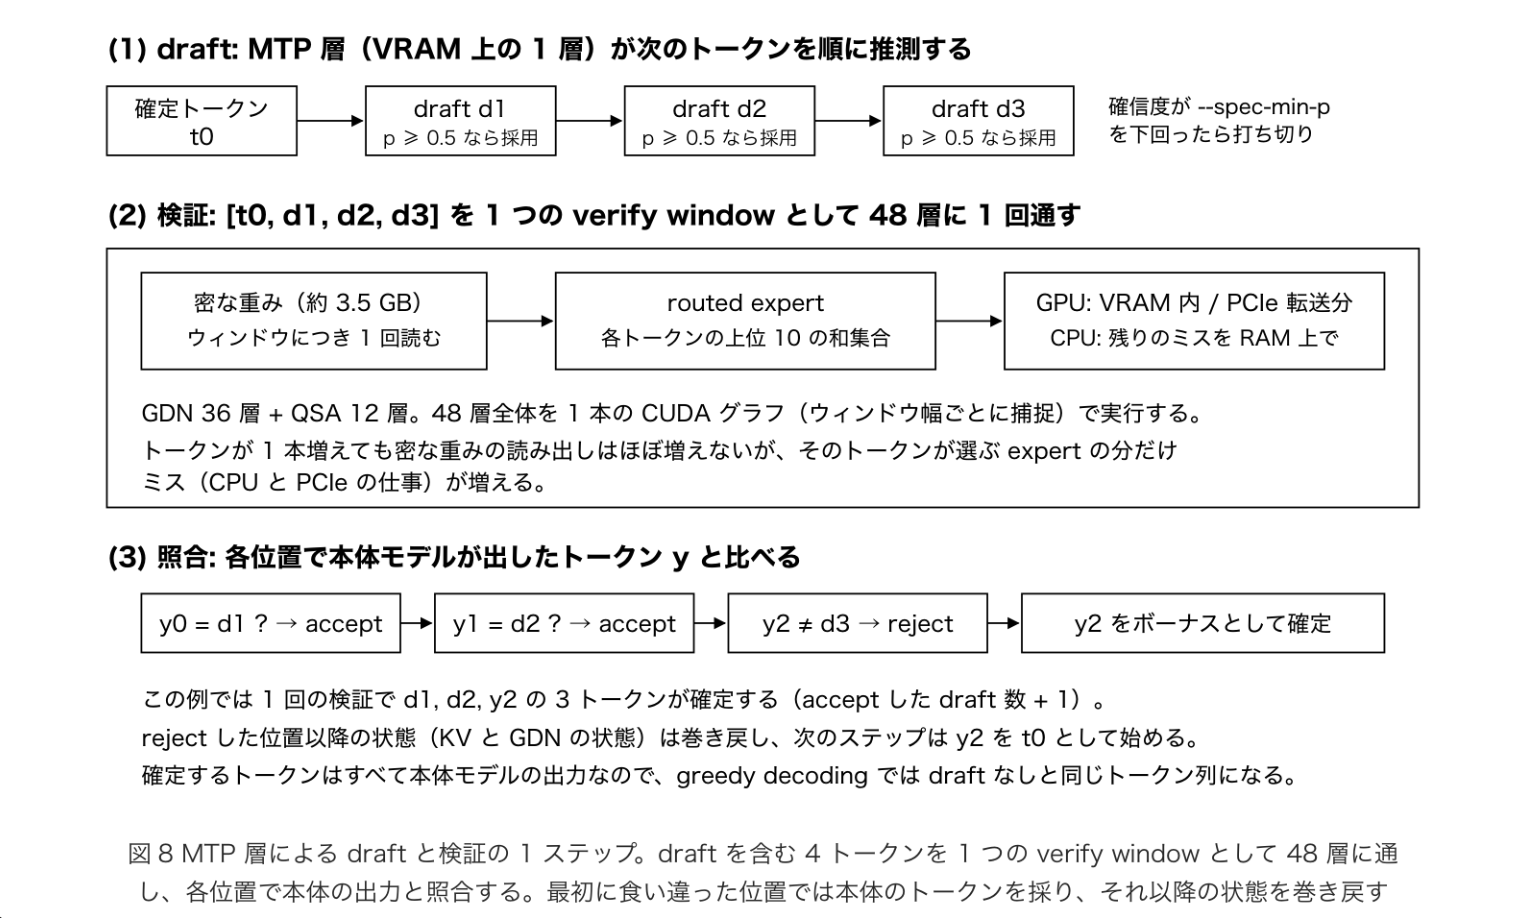
- 1 ステップの中身
- 最後に確定したトークンと最大 3 個の draft を、一つの verify window として全 48 層に通す
- draft がウィンドウに入るのは、MTP 層の確信度が 50% 以上の間だけ
- 本体が同意した draft をすべて accept し、さらに本体自身の 1 トークンを加える
- 1 回の検証で平均 2.4〜3.2 トークンが確定し、draft なしより 1.6〜1.8 倍速い
- 論文の測定では、4K で draft なしが 47〜57 tokens/s、verify window を使うと 82〜92 tokens/s
- 出力が greedy decoding と一致する理由
- 確定するトークンはすべて本体自身の出力で、draft は「本体がそのトークンを出すか」を一度に確かめるための候補にすぎない
- 各位置で本体が選んだトークンと draft を比べ、一致した位置までを accept し、最初に食い違った位置では本体のトークンを採る
- reject した位置以降の KV と GDN の状態は巻き戻す
- 論文はわざと誤った draft を与える試験と巻き戻しの試験でこの一致を確かめている
- 例外: i-quant のモデルでは、CPU が expert を 1 トークンだけで使うときと複数トークンで共有するときで、丸めがわずかに異なるカーネルを使う。draft やキャッシュ状態が違えば、温度 0 でも別の(同程度に良い)答えになりうる
- 効果が、全体を VRAM に載せるエンジンが報告する 2.5〜3 倍に届かない理由
- ウィンドウに入るトークンが 1 個増えるごとに、そのトークンが自分の expert を選ぶので、CPU が計算するミスも増える
- 密な重みの読み出しはトークン数に対してほぼ一定だが、CPU の expert の仕事はトークン数とともに増える
- 利得は密な重みを 1 回読むだけで複数のトークンを処理できる分と、ミスの増加分との差し引きで決まる
- prompt lookup(エンジン 0.1.7)
- 回答が文脈を繰り返す場合(コードの編集や引用)に、文脈中の以前の出現から最大 5 トークンを draft する
- 測定した acceptance rate とコストから得になる場合にだけ使う。コードの編集で 6〜11% 速くなり、ほかの文章では変わらない
- draft は MTP のものと同じく検証されるので、出力は変わらない
- 得になる場合に限るのは、外れる draft でウィンドウを長くすると、確定トークンは増えないのにミスの仕事だけが増えるから
4.2 1 回の verify window の時間
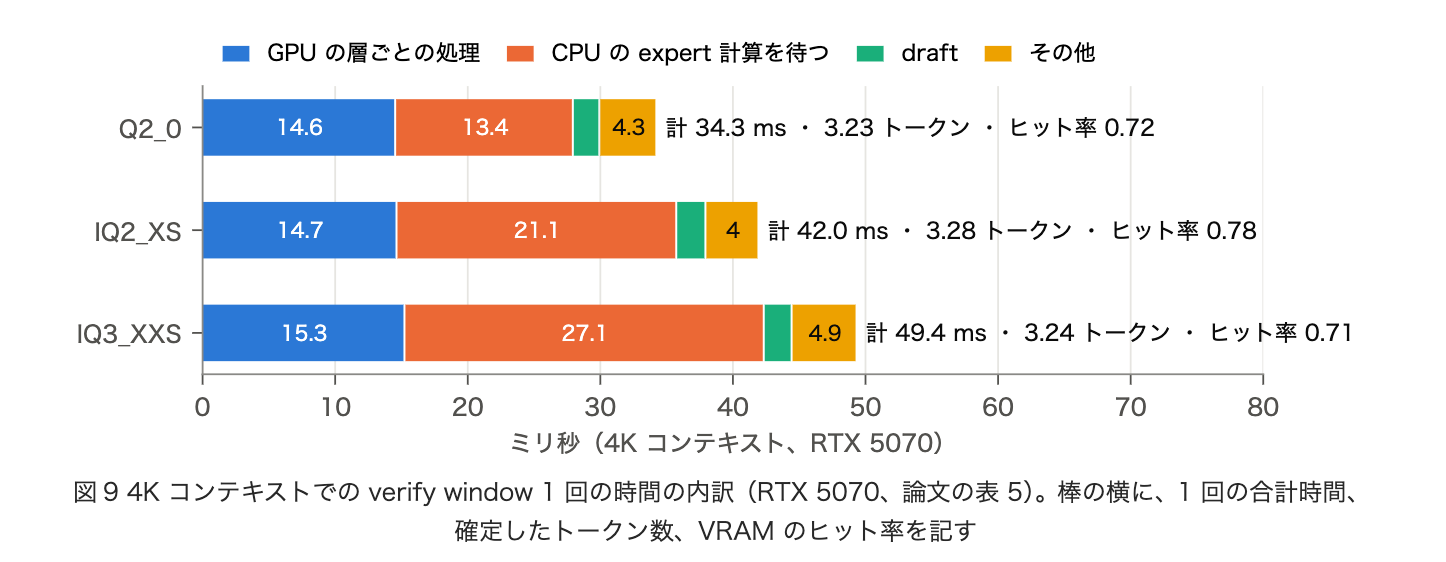
- 図9の見方
- 「GPU の層ごとの処理」: CPU が GPU の仕事(ウィンドウにつき 1 回の重みの読み出し、attention、キャッシュ済み expert)を待った時間
- 「CPU の expert 計算を待つ」: GPU が CPU のミスの計算を待った時間
- Q2_0 では 3.23 トークンを 34.3 ms で確定するので、約 94 tokens/s
- 三つのファイルでウィンドウあたりのトークン数はほぼ同じなので、速度の差はほぼ CPU 側の時間の差から来ている
- GPU 側は 14.6〜15.3 ms とほとんど変わらない。GPU の仕事は主に約 3.5 GB の密な重みの読み出しだから
- 論文によるボトルネックのまとめ
- Q2_0: 限界は CPU ではなくその背後の RAM
- expert のカーネルはすでに約 42 GB/s で重みを流している。これは GPU も RAM から読んでいる状態で RAM が出せる帯域(同時で 41 GB/s)に近い
- i-quant: CPU 自体が限界
- コードブックの重みの復号にはテーブル参照と符号の処理が要り、6 コアで約 25 GB/s しか出ない
- IQ3_XXS が 25% 大きいだけなのに遅いのはこのため
- RAM は帯域と容量の両方が効く。64 GB はぎりぎり足りる量
- GPU は速さより大きさが効く。GPU 自身の仕事(ウィンドウあたり約 14 ms)は二番目の限界で、メモリ帯域で決まる
- このマシンでは GPU と CPU がそれぞれウィンドウの約半分を必要とし、毎層で互いを待っている
- エンジンは釣り合っているが、どれか一つの部品だけを強化しても速度は 2 倍にならない
- 片方だけを速くしても、改善は高々 3 分の 1 程度
4.3 tail skip: 順位の低いミスを計算しない
- 後の版では、この釣り合いの CPU 側を直接削る既定が入った
- 対象: ウィンドウのすべてのトークンが上位 10 の 7 位以下(重みの最も小さい側)に置いた、VRAM 外の expert
- どのトークンにもわずかしか寄与しない
- 0.1.42 から CUDA ビルドでは、そのようなミスをコピーも計算もせず、寄与を 0 にする(図6)
- ほかの expert の重みは再正規化しない
- 0.1.43 からは RDNA4 の HIP でも既定オン。無効にすると、この変更のないビルドの答えがバイト単位で戻る
- 計算を省くので、出力は厳密には変わる
- teacher forcing の KL は 0.003〜0.006
- Teacher Forcing: モデルに正解のテキストを 1 トークンずつ与えながら、「次のトークンを予測する確率分布」を出させる検証手法。
- 同じエンジンを 2 回動かしたときの揺れ(約 0.0007)より明確に大きく、Q2_0 と IQ3_XXS の差(0.1006)より 1 桁以上小さい
- 量子化による劣化との比較
- 形式と 形式という「量子化ファイルの違い」が生むズレは 。つまり、「量子化の種類を変えることによる劣化」よりも、この計算省略による影響の方が 10 倍以上小さいということになる。
- 速度
- 1 枚構成のカード 3 台で 1.13〜1.16 倍
- ほぼ全 expert を VRAM に持つ 2 GPU 構成では得られなかった
- batch slot がある場合や、全 expert の 90% 以上が GPU にある場合は適用されない
5. prefill と長いコンテキスト
5.1 転送と計算を重ねる
- [pon]この辺はFreeTokenでも使われる鉄板か
- プロンプトの読み込み(prefill)では、デコードとは逆の結論になる
- デコードでは、ほとんどの expert が 1 トークンにしか使われないので、重みを PCIe で運ぶより置き場所の RAM で CPU が計算した方が速かった
- prefill では数千トークンを一度に流すので、1 個の expert を数千トークンが共有する
- 重みを一度 GPU に運べば GPU の演算能力で多数のトークンを処理でき、1 トークンあたりの運ぶコストは小さい
- 計算すべき場所は GPU になり、問題は「VRAM にない expert を PCIe で運ぶ時間をどう計算と重ねるか」に移る
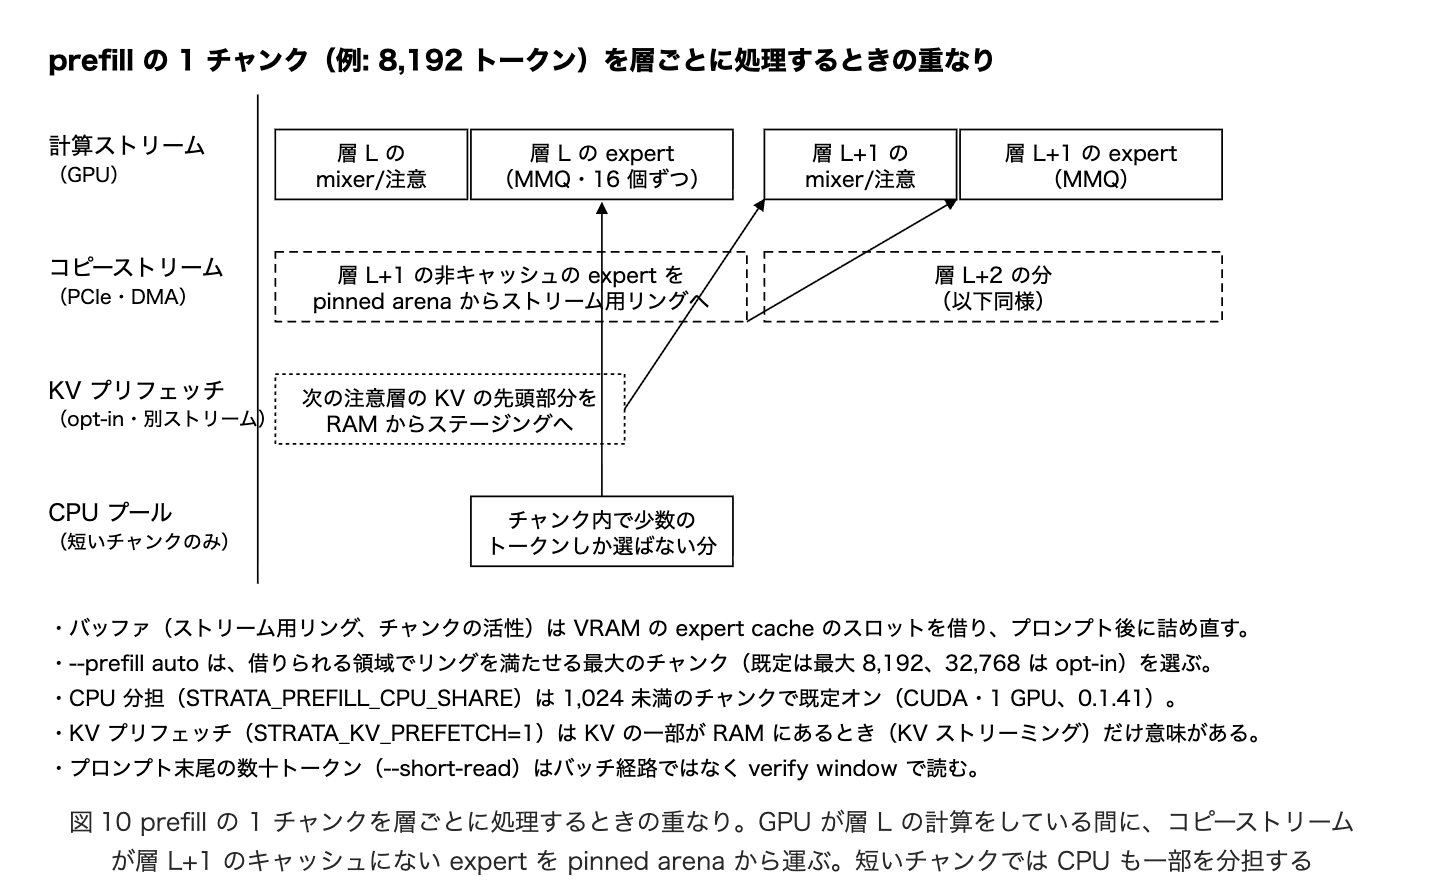
- 論文の時点の経路
- プロンプトを 2,048 トークンのチャンクで処理し、各層でキャッシュにない expert を PCIe でコピーしながら、半精度に展開して cuBLAS で掛けていた
- expert ごとのカーネル起動と半精度への展開に律速され、26 GB/s の PCIe のうち約 7 GB/s しか使っていなかった
- エンジン 0.1.13 での変更
- チャンクを最大 8,192 トークンにした
- expert を展開せずに、llama.cpp の量子化カーネルで掛けるようにした
- 次の層の expert を、現在の層の attention の計算中に PCIe で運ぶようにした(図10)
- RTX 5070・32K で、Q2_0 は 572 → 1,290 tokens/s、IQ3_S は 383 → 1,208 tokens/s
- エンジン 0.1.36: Q2_0 のプロンプトの expert を融合した int8 テンソルコアのカーネル(RTX 30 以降)で計算するようになり、同じ PC の 32K は 2,170 → 2,653 tokens/s
- チャンク用のバッファは専用の VRAM を持たず、expert cache のスロットを借りてプロンプトのあとに戻す
- チャンクが大きいほど速いが、借りるスロットが増える
- 短いチャンクでは、少数のトークンしか選ばない expert を CPU に計算させた方が速い場合がある
- 0.1.41 以降、CUDA・GPU 1 枚では、1,024 トークン未満のチャンクで CPU が expert の一部を分担する
- QSA が参照する位置の数に上限があるので、プロンプトの速度はコンテキスト長に対してほぼ平ら
- 論文の Q2_0 は 4K で 539、262K で 496 tokens/s
5.2 長いコンテキストのコストは VRAM
- 長いコンテキストのコストは主に計算ではなく VRAM
- 262K では、12 の attention 層の KV キャッシュ、インデクサのキー、大きくなったプロンプト用バッファが約 4 GB を占める
- 自動で大きさを決めると、GPU に置ける expert は約 4,500 個ではなく約 1,600 個になる
- draft の acceptance rate の低下も重なって、論文の Q2_0 のデコードは約 95 → 約 56 tokens/s に下がった
- エンジン 0.1.5 の KV ストリーミングで、この VRAM を取り返す
- 64K 以上のコンテキストで、setup が KV キャッシュを RAM に置き、attention が読む部分だけを VRAM に置く
- attention が読む値はまったく同じで、変わるのは KV の置き場所だけなので、出力は変わらない
- その代わり、コンテキスト 1 トークンあたり約 13.7 KB の RAM を使う(128K で 1.7 GB)
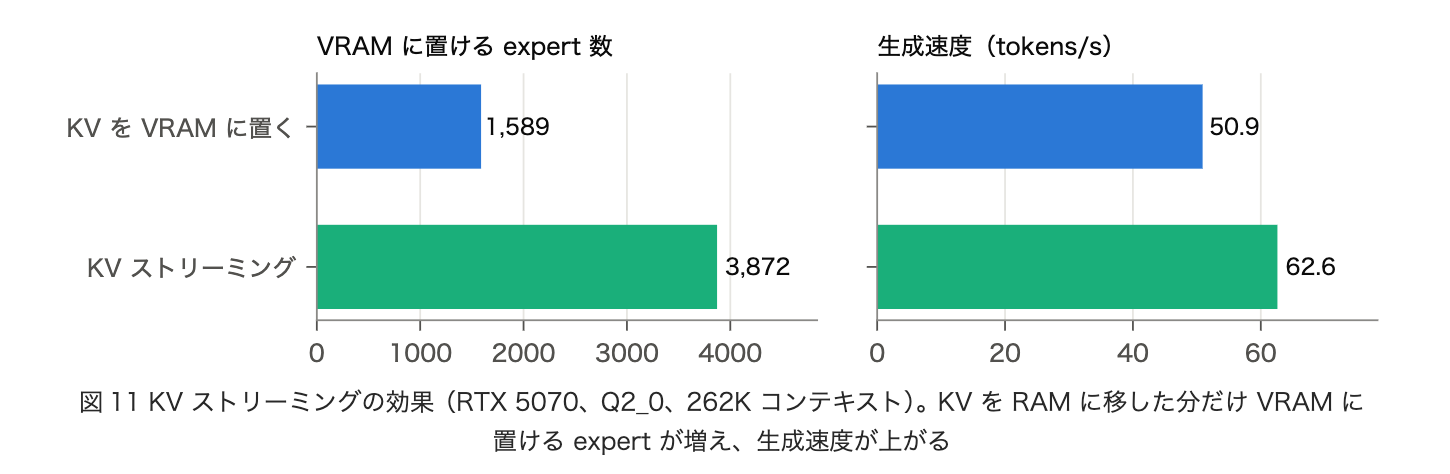
- 図11の効果(Q2_0・262K)
- VRAM に置ける expert は 1,589 個 → 3,872 個
- 生成は 50.9 → 62.6 tokens/s
- 128K では約 6% の改善
- 逆に、KV を VRAM に多く置いてもほとんど得がない
- Tesla P100・IQ2_XS で VRAM に置く KV を 4 倍以上に変えてもデコードはほぼ変わらず、expert のスロットを増やすとデコードが伸びた
- KV の形式には精度と VRAM のトレードオフがあり、setup は 4K を超えるコンテキストで 8 ビットの KV を使う(エンジン 0.1.26 の測定条件。論文の時点の本文では 8K 超)
6. 会話状態と同時リクエスト
6.1 会話キャッシュ
- 長いプロンプトの読み込みには数十秒から数分かかる
- チャットやエージェントでは、各リクエストは直前までの会話をほぼそのまま含み、末尾に少しだけ新しい内容が付く
- 毎回全体を読み直せば、この時間が毎ターンかかる
- 論文の執筆時点では「どのリクエストもプロンプト全体を処理し直す」状態だった
- 各ターンの終わりの状態を保存すれば、長いチャットの 30 秒の読み直しが 1 秒未満になり、エージェントにとって最大の改善になると予想していた
- 後の版はこれを実装しており、2 通目以降は新しい部分だけを読んで数秒で応答が始まる
- 保存の単位はモデルの構造が決める
- 36 層の GDN はコンテキスト全体を固定サイズの状態に畳み込むので、ある位置までの状態は「その位置で写した状態」としてしか取り出せない
- KV キャッシュのように、後ろを切り詰めて任意の位置に戻すことはできない
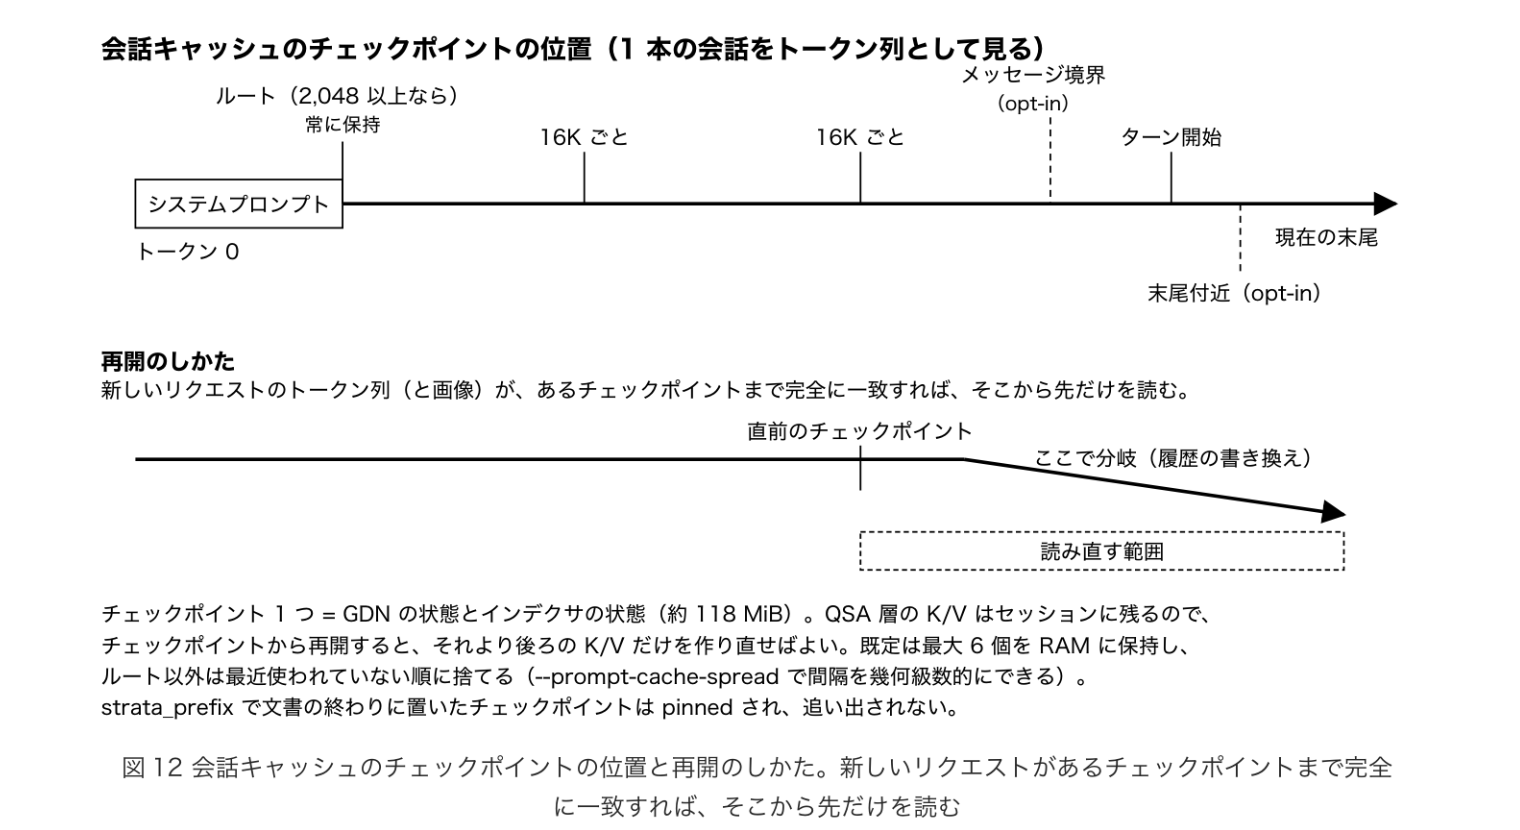
- そこで、ところどころの位置で GDN とインデクサの状態の写し(チェックポイント、1 個約 118 MiB)を取っておく
- QSA の K/V はセッションに残るので、チェックポイントから再開した質問はそれより後ろだけを読めばよい
- チェックポイントの取り方
- 既定では RAM に最大 6 個を持つ
- 新しいアシスタントのターンの開始時と、プロンプトの 16K トークンごとに取る
- プロンプトがそのトークン列と画像でちょうど始まるときにだけ使う
- ルート
- 最も古いチェックポイント、実際には同じクライアントのすべてのチャットが共有するシステムプロンプトの終わり
- ルートは常に保持し、残りは最近使われていない順に入れ替わる
- このため、同じ prefix を共有する新しいチャットは、トークン 0 からではなくその後ろから読み始められる
- システムプロンプトが 2,048 トークン以上なら、その終わりに必ずルートを作る(エンジン 0.1.20)。長いシステムプロンプトとツール一覧を持つエージェントのクライアント向け
- 出力への影響
- 再開は完全一致の prefix に限るので、原理的には読み直した場合と同じ状態になる
- ただし、再開したリクエストは末尾だけをデコードの経路で読み、prefill のバッチ経路と verify window は丸めが違う。これがリクエストをまたいで出力が変わる要因の一つ
- バイト単位で同じ繰り返しが必要な測定では、会話キャッシュを切る
6.2 batch slot
- サーバは既定では一度に 1 つのリクエストしか処理しない
- opt-in の batch slot を使うと、複数の会話を開いたまま保持し、同じ verify window に載せて一緒にデコードする
- 各ウィンドウには会話ごとに 1 トークンずつ載る
- 密な重み、shared expert、output head、複数の会話が共通して選んだ routed expert は、ウィンドウにつき 1 回読めば全会話の分に使える
- 出力が単独実行と一致する理由
- バッチの各行の演算が 1 トークンのウィンドウの演算と同じ
- 行ごとに自分のスロットの状態(GDN の状態、QSA の K/V、インデクサ)を読み、同じカーネルで同じ重みを掛ける
- greedy decoding では、バッチ内の各会話は単独で実行したときと同じトークンを生成する。8 本の同時会話でトークンごとに確かめている
- ただし、CPU カーネルの選び方、PCIe の取り分、expert cache の入れ替えという、丸めを左右する三つの要因を固定したときの話。既定の設定では、いくらかのトークンの後で単独実行から分かれていく
- 効果は expert がどこにあるかで正反対になる
- RTX 5070 12 GB・Q2_0・32K で 4 つのリクエストを同時に送った場合
- 4 スロットでは、4 つ目の最初のトークンが 11.2 秒ではなく 1.8 秒で出た
- 合計の速度は一度に 1 つずつ処理するより 11% 遅かった
- スロットのセッション(それぞれ 0.56 GiB)が expert cache から取られ、expert の大半が CPU で動くため
- このため setup は 12 GB のカードを一度に 1 つのままにする
- expert の大半を VRAM に保持する構成や layer split(7 節)では合計の速度が伸びる
- 16 GB のカード 4 枚(PCIe Gen3)の layer split・IQ3_S: 1 リクエストで 120 tokens/s、8 同時で合計 360 tokens/s
- サーバは OpenAI 互換と Anthropic 互換の API と Web アプリを提供しており、アプリやコーディングエージェントからこれらの仕組みを使える
7. 複数 GPU と他のハードウェア
7.1 layer split
- 1 台の PC に挿した複数の GPU で、1 つのモデルを動かせる
- 主な方法は layer split: モデルの層を連続した範囲に分けて、GPU ごとに 1 範囲ずつ受け持たせる
- 最初のカードが層 0 から K−1 を、次のカードが K 以降を受け持つ
- 最後のカードは output head と draft 層も持つ
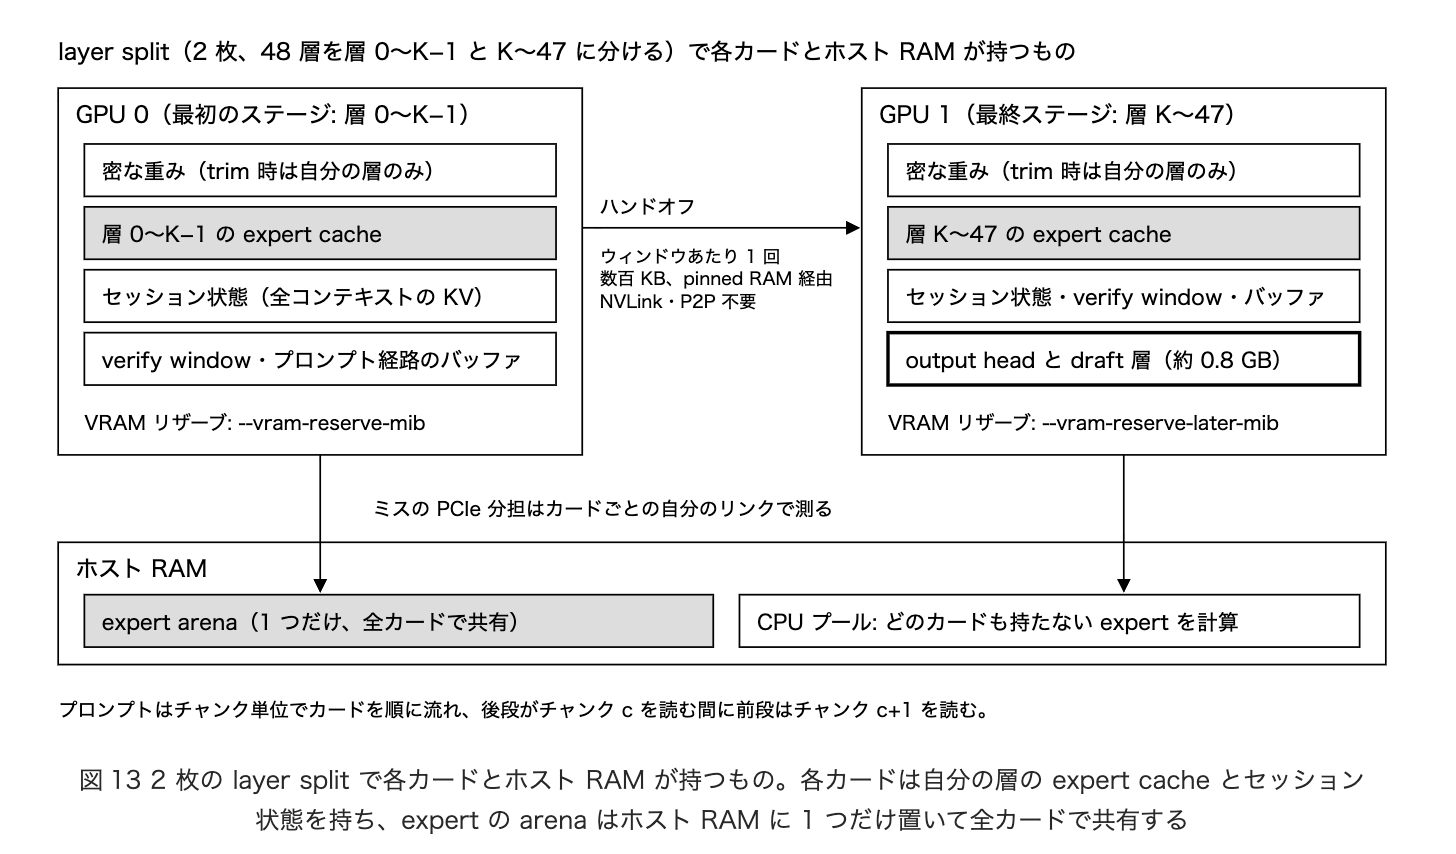
- 各カードは自分の層についてだけ expert cache を持つので、2 枚のカードは 1 枚のおよそ 2 倍の expert を保持できる。速さの源はここ
- ホスト RAM の arena は 1 つだけで、どのカードも持たない expert は CPU が計算する
- パイプライン(レイヤー)並列であって、テンソル並列ではない
- トークンがあるカードから次へ渡るのは verify window あたり 1 回(pinned RAM を経由する数百 KB)
- 層ごとに通信が要るテンソル並列とは違い、NVLink や P2P は要らない。x4 や x1 のスロットのカードでも動く
- 効果はプロンプトで最も大きい
- 各カードがチャンクの自分の層を読む間に、もう一方が次のチャンクを読むため
- RTX 5080 と RTX 3090 で Coder を動かした測定では、プロンプトが 18〜20% 速くなった
- デコードは速いカード単体と同等で、コードでは上回った
- 分割の代償は、ステージを順に通るためにカードが交代で遊ぶこと
- これを埋めるため、最後のカードがまだ検証している間に、最初のカードに次のウィンドウを推測で始めさせる仕組みがある
- 推測が外れれば最初のカードの状態を戻して捨てるので、最後のカードは検証済みのウィンドウしか実行しない
- AMD RDNA4 の 2 ステージ以上では既定オン、NVIDIA では opt-in
8. 評価
8.1 測定の条件
- 公開されている主要な数値は、1 台の基準機で測っている
- GPU: RTX 5070(12 GB、PCIe 4.0 x16、ディスプレイ出力を兼ねる)
- CPU: Ryzen 5 7600(6 コア、AVX-512)
- RAM: 64 GB の DDR5-5200(EXPO 無効)
- ストレージ: NVMe SSD、OS: Windows
- RAM を定格の速度で動かしていないことと、モニタを GPU につないでいることは、どちらも数値を控えめにする条件
- ワークロード
- 長さごとに 1 本のコードエージェント用プロンプト(長いソースファイルに対するコードレビュー課題)
- それぞれ 256 トークンを生成し、MTP による投機的デコーディングを有効にする
- 各数値はプロンプトを冷えた状態から読むエンジンの 1 回の完走
- プロンプト長の 1K〜262K は名目で、実際は 1,017〜259,943 トークン
- プロンプト速度は読み込んだトークン数 ÷ 読み込み時間、生成速度は生成したトークン数 ÷ 生成時間(投機的デコーディングを含む)
8.2 速度
- README が「普通のゲーミング PC」2 台の値として掲げる要約
- 生成は 4K の短いチャット、プロンプトは 32K トークンの読み込み
- NVIDIA の Q2_0 はエンジン 0.1.36、それ以外は 0.1.26 の値
- NVIDIA: RTX 5070 12 GB・Ryzen 5 7600・64 GB、AMD: RX 9070 XT 16 GB・Ryzen 9 3900X・47 GB
| サイズ | RTX 5070 生成 | RTX 5070 プロンプト | RX 9070 XT 生成 | RX 9070 XT プロンプト |
|---|---|---|---|---|
| Q2_0 | 94 | 2,650 | 60 | 1,160 |
| IQ2_XS | 79 | 2,090 | 52 | 1,110 |
| IQ3_XXS | 62 | 1,750 | - | - |
| IQ3_S | 53 | 1,620 | - | - |
| Coder | 55 | 2,180 | 44 | 1,420 |
(単位は tokens/s)
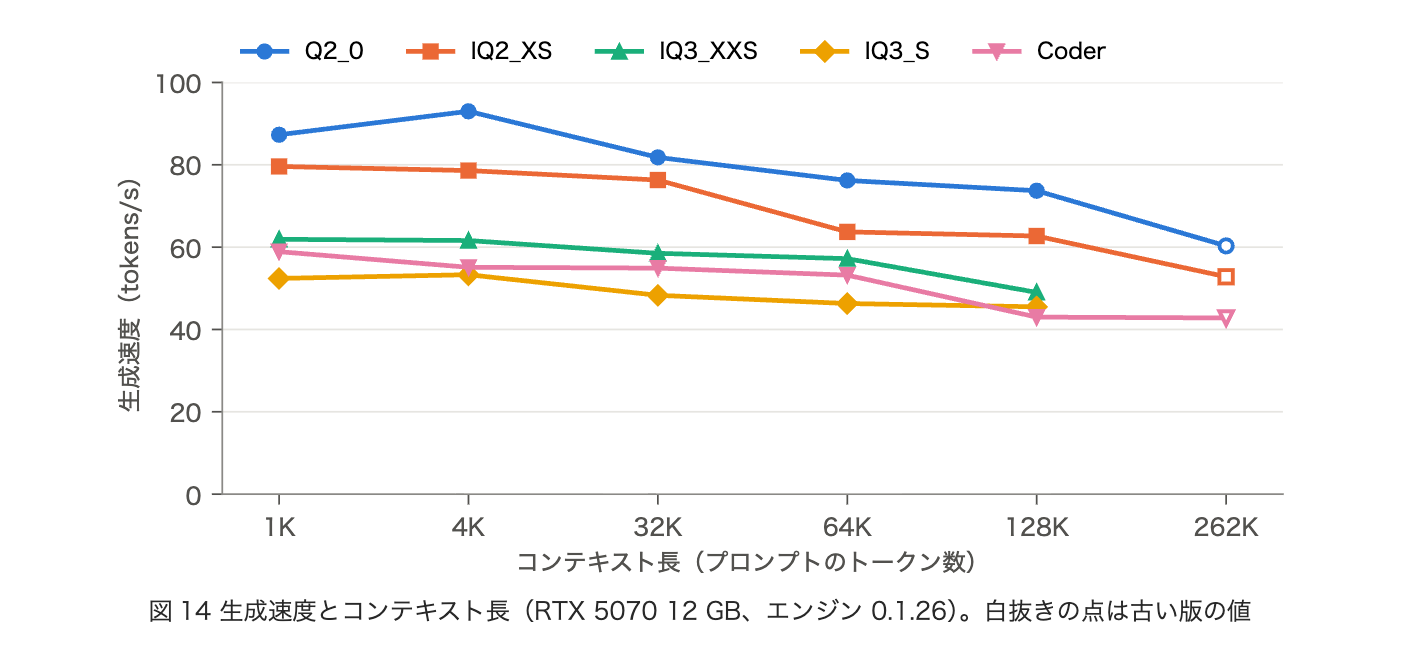
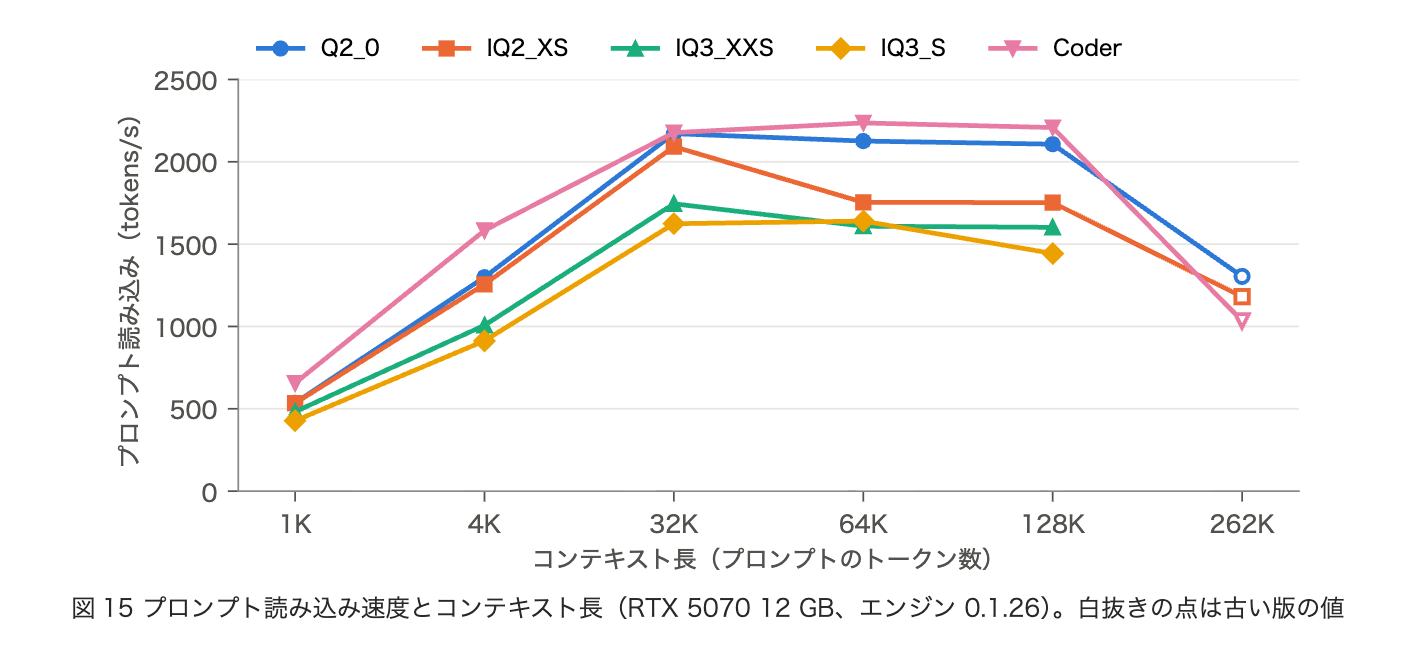
- 図14・図15 は基準機での速度をコンテキスト長に対して描いたもの(エンジン 0.1.26)
- 262K の白抜きの点は再測定していない古い版の値(生成は 0.1.14、プロンプトは 0.1.22 または 0.1.14)なので、ほかの点と同じ線の上で比べてはならない
- 生成速度は、コンテキスト長に対してゆるやかにしか下がらない
- Q2_0 は 4K の 93.0 tokens/s から、128K でも 73.7 tokens/s を保つ
- 下がる理由として論文が挙げるのは 2 つ
- 長いコンテキストの KV キャッシュが VRAM を取って、expert cache が縮む(0.1.26 では 64K 以上で KV ストリーミングがこれを和らげている)
- draft の acceptance rate が下がる
- IQ2_XS と IQ3_XXS が Q2_0 より遅いのは、4 節で見たとおり CPU 側の expert 計算が長くなるから
- プロンプト速度は 32K 前後で頭打ちになる
- 128K まで、Q2_0 と Coder はほぼ平ら。ほかのファイルも 32K からの低下は 2 割以内
- 長い側が平らなのは、QSA の参照する位置の数に上限があるから
- 0.1.26 の Q2_0 の 32K は 2,171 tokens/s。表の 2,650 tokens/s との差は 0.1.36 の融合 int8 カーネルによる
8.3 品質
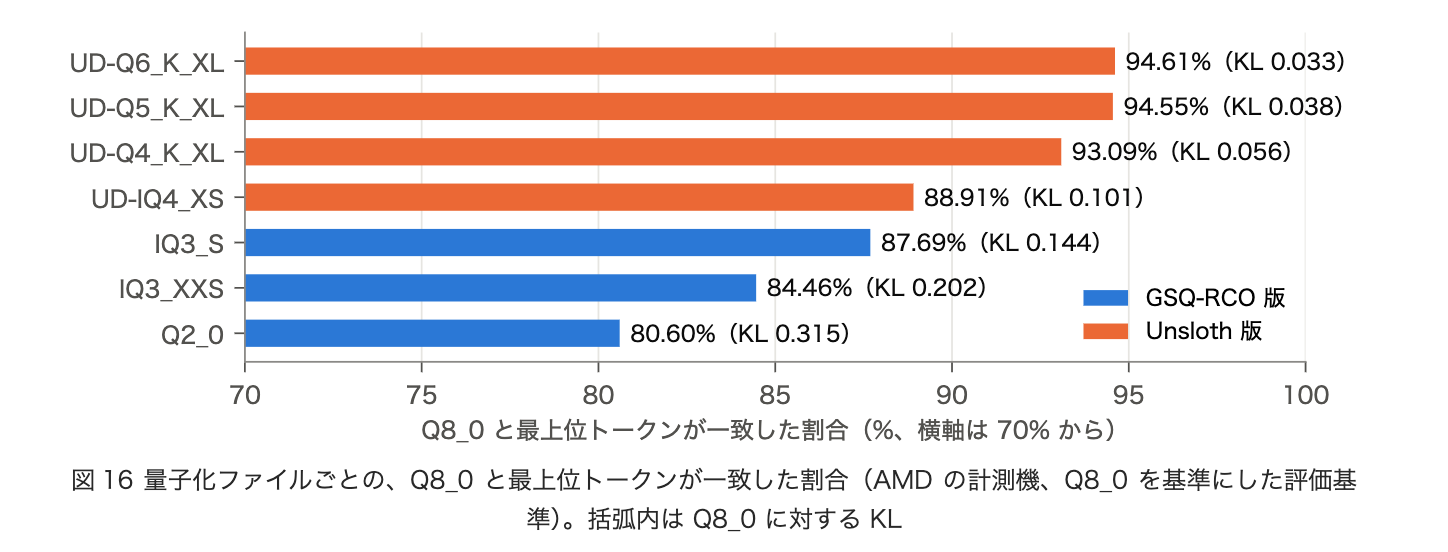
- 量子化ファイル同士の品質は Q8_0 を基準にした共通の評価基準で比べる
- 固定のテキスト集合(5 × 1,000 トークン)を teacher forcing で読む。中身はコード、ドキュメント、英語の文章、ドイツ語・フランス語・日本語・中国語、エージェントのやりとり
- 答えを揺らす要因(expert の適応、PCIe の取り分、tail skip など)はすべて止める
- 指標は、Q8_0 と最上位トークンが同じになる割合と、Q8_0 の上位 64 トークン上での KL
- Q8_0 を自分自身と比べると行がバイト単位で一致したので、この評価基準のノイズは 0
- 結果(AMD の機械 EPYC 7452、R9700 で測定)
- 一致率は Q2_0 の 80.60% から、IQ3_XXS 84.46%、IQ3_S 87.69%、Unsloth の UD-IQ4_XS 88.91% を経て、UD-Q6_K_XL の 94.61% まで上がる
- UD-Q4_K_XL(93.09%)より上では差が小さく、UD-Q5_K_XL と UD-Q6_K_XL はほぼ同じ
- ビット数を増やすと品質は上がるが、2 節で見たように 1 トークンあたりに読む expert の量も増え、より多くの RAM を必要とする
8.4 他の GPU
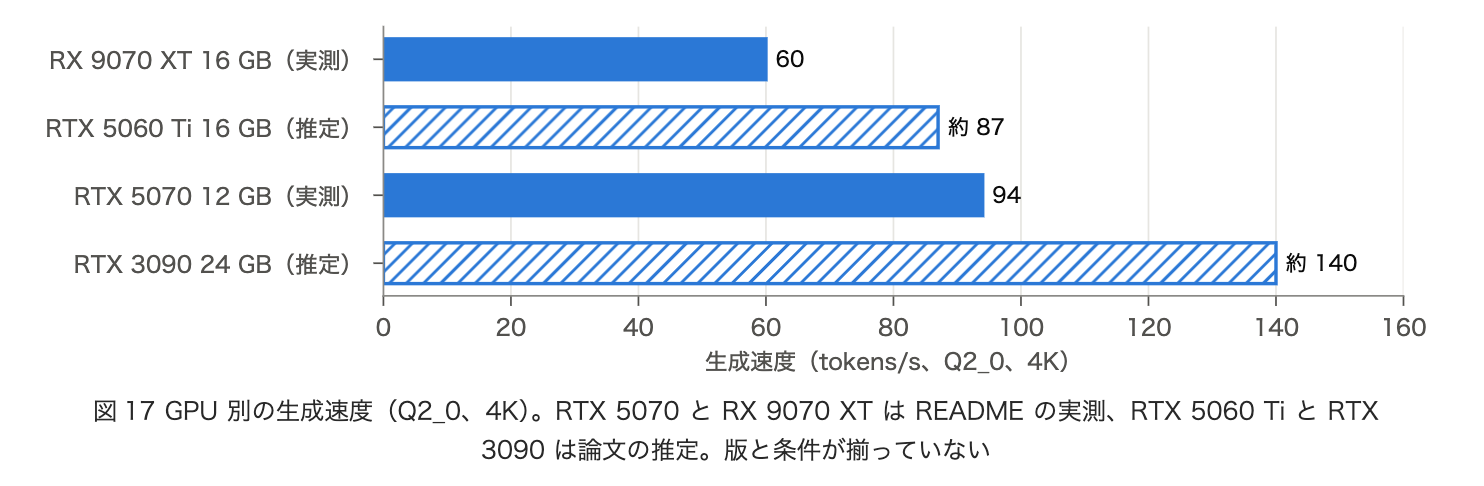
- 4 本の棒は同じ条件の比較ではない
- RTX 5070(94 tokens/s、0.1.36)と RX 9070 XT(60 tokens/s、0.1.26)は README の実測で、CPU と RAM も機械ごとに違う
- RTX 5060 Ti 16 GB(約 87)と RTX 3090 24 GB(約 140)は論文の推定で、測定ではない
- 推定の作り方
- RTX 5070 の時間の内訳をもとに、GPU の部分をメモリ帯域の比で、CPU の部分を追加の VRAM に入る expert の増分で伸縮させた
- 測定されるまで ±20% として扱うよう明記されている
- RTX 5060 Ti は帯域が小さい代わりに expert の置き場が広く、両者がほぼ打ち消し合う
- RTX 3090 は帯域も VRAM も大きく、CPU の仕事の大部分がなくなる
8.5 正確さ
- Strata の速度は出力を変えないことを前提にした速度
- 二段階の一致を区別する
- bit 単位で一致: 同じ入力に対して、出力のバイト列やロジットまで同じになること。新しいスイッチを既定オフで足したときに、既定の経路が前のリリースと変わらないことを確かめる基準
- トークン列が一致: 生成されたトークンの列が同じになること。投機やバッチの有無が答えを変えないことの基準
| 対象 | 比較 | 結果 |
|---|---|---|
| 投機的デコーディング | draft なしの greedy decoding | トークン列が一致(誤った draft と巻き戻しを強制する試験を含む) |
| エンジン全体 | llama.cpp の次トークン分布 | 平均 KL 0.022(llama.cpp 自身の CPU ビルドと GPU ビルドの差は 0.058) |
| batch slot | 単独実行 | greedy でトークン列が一致(8 本の同時会話、丸めを左右する要因を固定した場合) |
| KV ストリーミング | KV を VRAM に置く場合 | attention が読む値が同じなので出力が同じ |
| tail skip(0.1.42 既定) | 0.1.41 の挙動 | KL 0.003〜0.006(同じエンジンを 2 回動かした揺れは約 0.0007) |
| 融合 int8 プロンプトカーネル(0.1.36) | FP16 の参照 | 32K で KL 0.009(従来のカーネルは 0.012) |
| UD-Q4_K_XL(実験的) | 同じファイルの llama.cpp | 同じトークンを選ぶ割合は短い greedy 回答で 97.5〜99%、16K プロンプトの後で 90〜91% |
- 論文は所見の一つとして「正確さは達成でき、こだわる価値がある」とまとめている
- ただし、表の一致には条件がある
- 既定の設定では、i-quant の CPU カーネルの丸め、サーバでの expert の入れ替えと会話キャッシュ、PCIe の取り分によって、温度 0 でも同じプロンプトの答えが実行ごとに変わりうる
- 原文は答えをバイト単位で揃えて繰り返すためのスイッチを記している(そのうち --pcie-frac 0 はデコードが遅くなるので A/B 比較用)
- tail skip のように出力を変える既定には、KL とタスク評価の数値と、元の答えを bit 単位で戻す方法が添えられている
9. 限界と今後
- Strata の文書は測ったことと測っていないことを分けて書く方針を一貫して取っている
- 測定なしに主張しないことが文書の規則で、報告者にはテストしなかったことを書くよう求めている
- ここで挙げる限界の多くは現時点のもので、版が上がれば変わりうる
| 分類 | 限界 |
|---|---|
| 設計 | GPU と CPU がウィンドウの約半分ずつを要して互いを待つので、片側だけを速くしても改善は約 3 分の 1 が上限。投機的デコーディングの効果も 1.6〜1.8 倍にとどまる |
| RAM の容量 | 通常のモードでは全 expert を RAM に置くので、expert + 約 10 GB が要る。64 GB では IQ3_XXS と IQ3_S の 262K を測っていない。低 RAM モードは小さい GPU では大幅に遅い |
| OS とドライバ | Windows はページロックできる量に上限があり、WSL2 では pinned が約 1 GB に限られて KV ストリーミングが使えない |
| GPU と CPU | 既製のエンジンは RTX 20〜50 と AVX2 を持つ CPU が対象。旧世代の GPU と AVX2 のない CPU は実験的な経路 |
| モデル | 一つのモデルのためのエンジン。Coder はコード以外と英語以外の言語で弱く、Unsloth のファイルはサンプリングありのデコードと長い会話が未検証 |
| 機能の組み合わせ | 多くの opt-in が特定の構成でだけ動く。たとえば batch slot は既定では MTP draft を運ばず、繰り返しペナルティを適用しない |
| 未検証の領域 | メンテナが持つ機械以外のプラットフォームの組み合わせ、3 枚以上の GPU、長時間の連続運転、答えの品質のベンチマーク(とくにサンプリングあり、長い会話、画像) |
- 最も根本的な限界は設計そのものにある
- VRAM に収まらない expert を CPU が同時に計算するからこそ、12 GB のカードで 1,250 億パラメータのモデルが動く
- その代わり、デコード速度は GPU の密な重みの読み出しと CPU の expert 計算でほぼ決まる
- どちらの限界がどこで現れるかは、RAM の世代と量子化ファイルで変わる。DDR4 の機械では Q2_0 の CPU 側が約 2 倍の時間を要し、i-quant は損が小さい
- いずれの場合も、大きな GPU キャッシュが最良の補償になる
- 論文が挙げた今後の方向
- リクエスト間で会話の状態を保つ
- 層の中ではなく層をまたいで重ねる(次の層の expert を現在の隠れ状態から予測して、router より先にコピーを始める)
- CPU での i-quant の演算を安くする
- 速いプロンプト経路、温度サンプリング
- 無料でできるハードウェアの設定(RAM を定格の速度で動かす、モニタをマザーボードにつなぐ、Linux を使う)
- 後の版での実装状況
- 会話状態の保存(6 節)、プロンプト経路の高速化(5 節)、サンプリング時の draft の扱いは、形を変えて実装されている
- 層をまたぐ予測で後の版にあるのは主に、ファイルから読む低 RAM モードで予測した expert のページを先に要求する仕組み(計算する expert は変えない)と、予測の精度を測る計測専用の機能
- 予測した expert を VRAM のスロットへ先にコピーする opt-in(STRATA_FS_SLOTS)も試したが、測ったどの機械でも、キャッシュが小さくなる損が上回った
- 未検証の領域は、メンテナが持たないハードウェアに集中している
- メンテナが測定を求めているもの: 大きさの違う NVIDIA カード 2 枚の組、3〜4 枚の NVIDIA GPU、Pascal 世代のカード、RAM 32 GB 以下の Linux ホスト、1 時間以上の連続運転