Confident Learning
- 参考
(けっこう有名なので知っている人は多い?)
概要
といっても参考ブログがとてもわかりやすいのでほぼコピペ
Confident Learning
- データセットのラベル間違いを検出する手法
- Noisy Labeledなデータセットに対しての課題
- ラベルノイズがどのような特徴を持っているか?
- どのサンプルのラベルが間違っているのか?
- ノイズありの状況下でどう訓練したら良いのか?
- 上記の課題に対応するためのアプローチConfident Learning(CL)を提案
- Confident Learningを使うと
- どのクラスはどのラベルに間違えられやすいかを取得可能
- どのサンプルのラベルが間違っていそうか取得可能
- (確率と見なせるものを出力するならば)どんな判別器に対しても使用可能
- 多クラス分類対応
- といっても取引先はかなりN多いので厳しいかも
- すぐに使用可能 (pip install cleanlab)
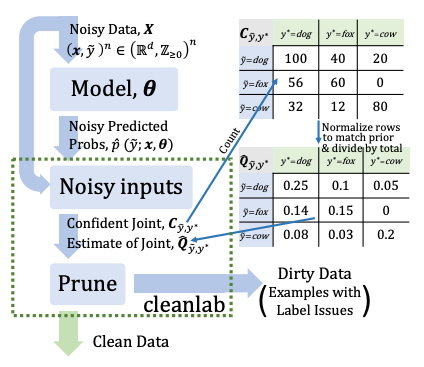
- 仕組みは?
- 真のクラスy∗と与えられたラベルỹの同時分布p(y∗,ỹ )をy∗なしで推定
- https://aotamasaki.hatenablog.com/entry/confident_learning
- 性能は?
- 理論的に妥当
- Class-conditional classification Noise Process (CNP) という現実的な仮定
- クラスインバランスやモデルの性能に対して頑健であるということを理論的に保証
- 実験的に高性能
- CIFAR-10を用いた実験で、他の手法よりも同等もしくは良い性能を発揮
- Sparsityの大きい(現実に近い)状況では他の手法の性能を凌駕
- コメント
- 間違えやすいクラスとかわかって良いかも?
- 多クラス分類のNが多いとうまくいかないかも
- アノテーション入力値とユーザ入力値を持っていたらそんなに?
- ユーザ入力値しかない時は良いかも?