RMT: Retentive Networks Meet Vision Transformers
概要
- LLM界隈で話題になっていたRetentive NetworkをViTに応用したRMTを提案
- 空間距離に対する明示的な減衰を導入
- RetNetでは1次元方向に対して明示的な減衰を事前知識として効果的に導入していた (Retention)
- 今回の論文では、それを2次元シナリオに拡張したRetentive SelfAttention (ReSA)を提案
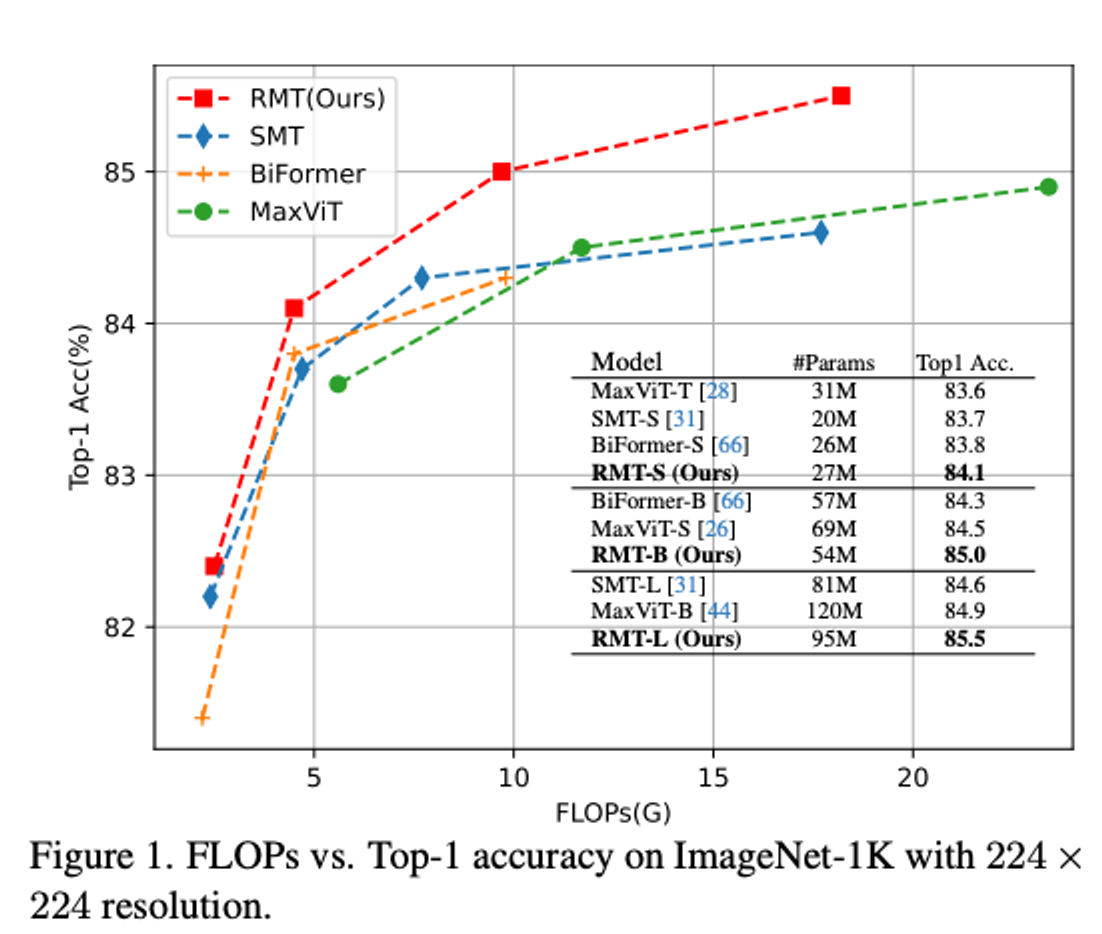
- 画像分類タスクに対してSoTAを大幅に上回る性能を達成
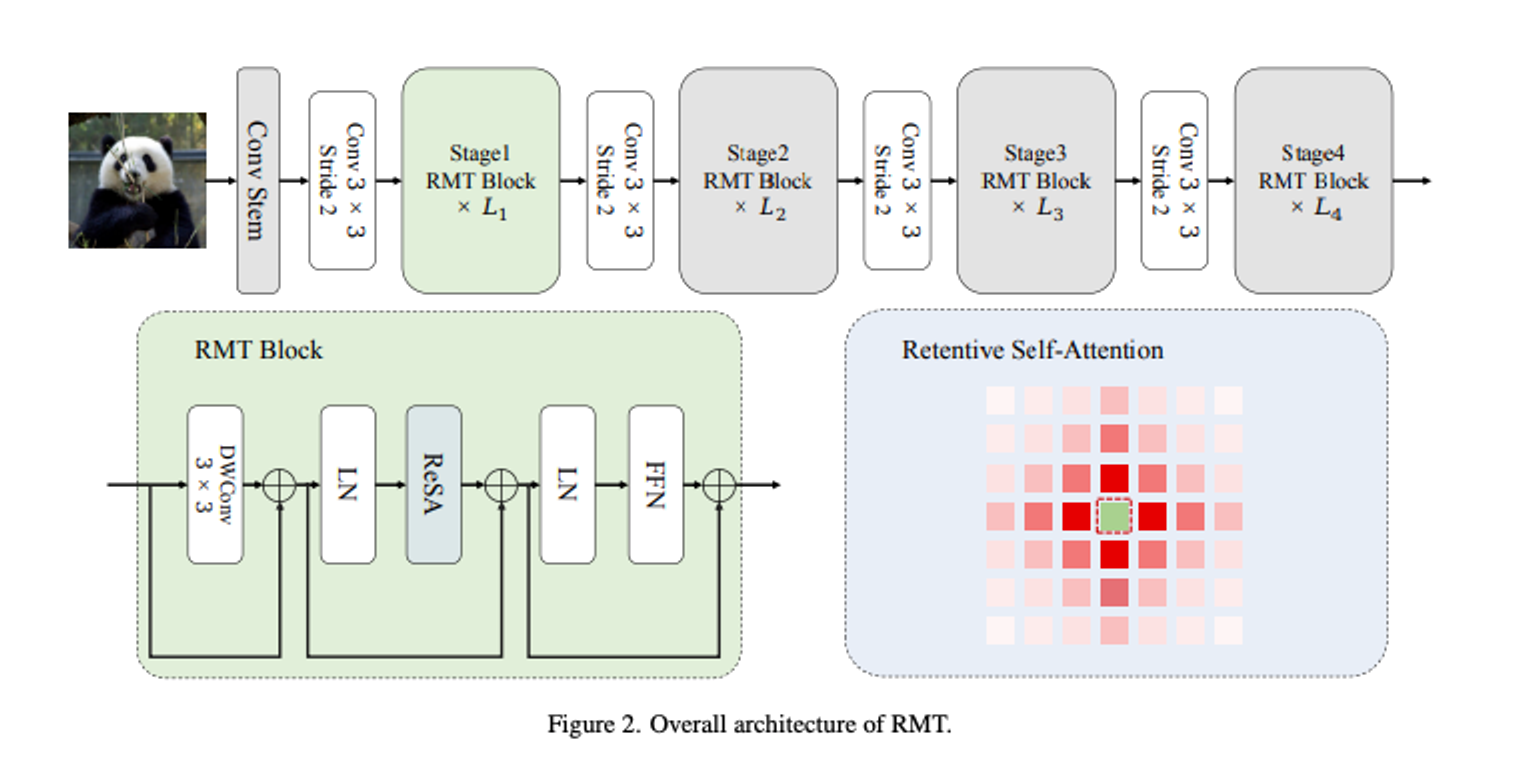
- 構造としては以下のような形
- 各tokenペアのマンハッタン距離に応じた減衰係数行列を使う
- 縦と横に処理を分割することで計算量削減
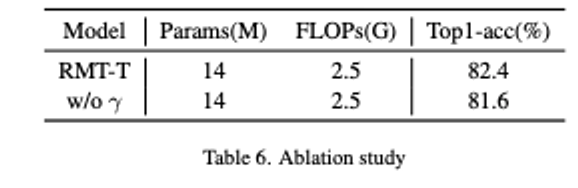
- 減衰なしだとACCが確かに下がることもAblation Studyで確認