Recommendation Modeling with Impression Data at Netflix
概要
- RecSys2023のWS「LERI 2023 - Workshop on Learning and Evaluating Recommendations with Impressions」のkeynote
- レコメンドにおいてimpressionを学習と特徴エンジニアリングにおいてどう扱うかがまとめられている。
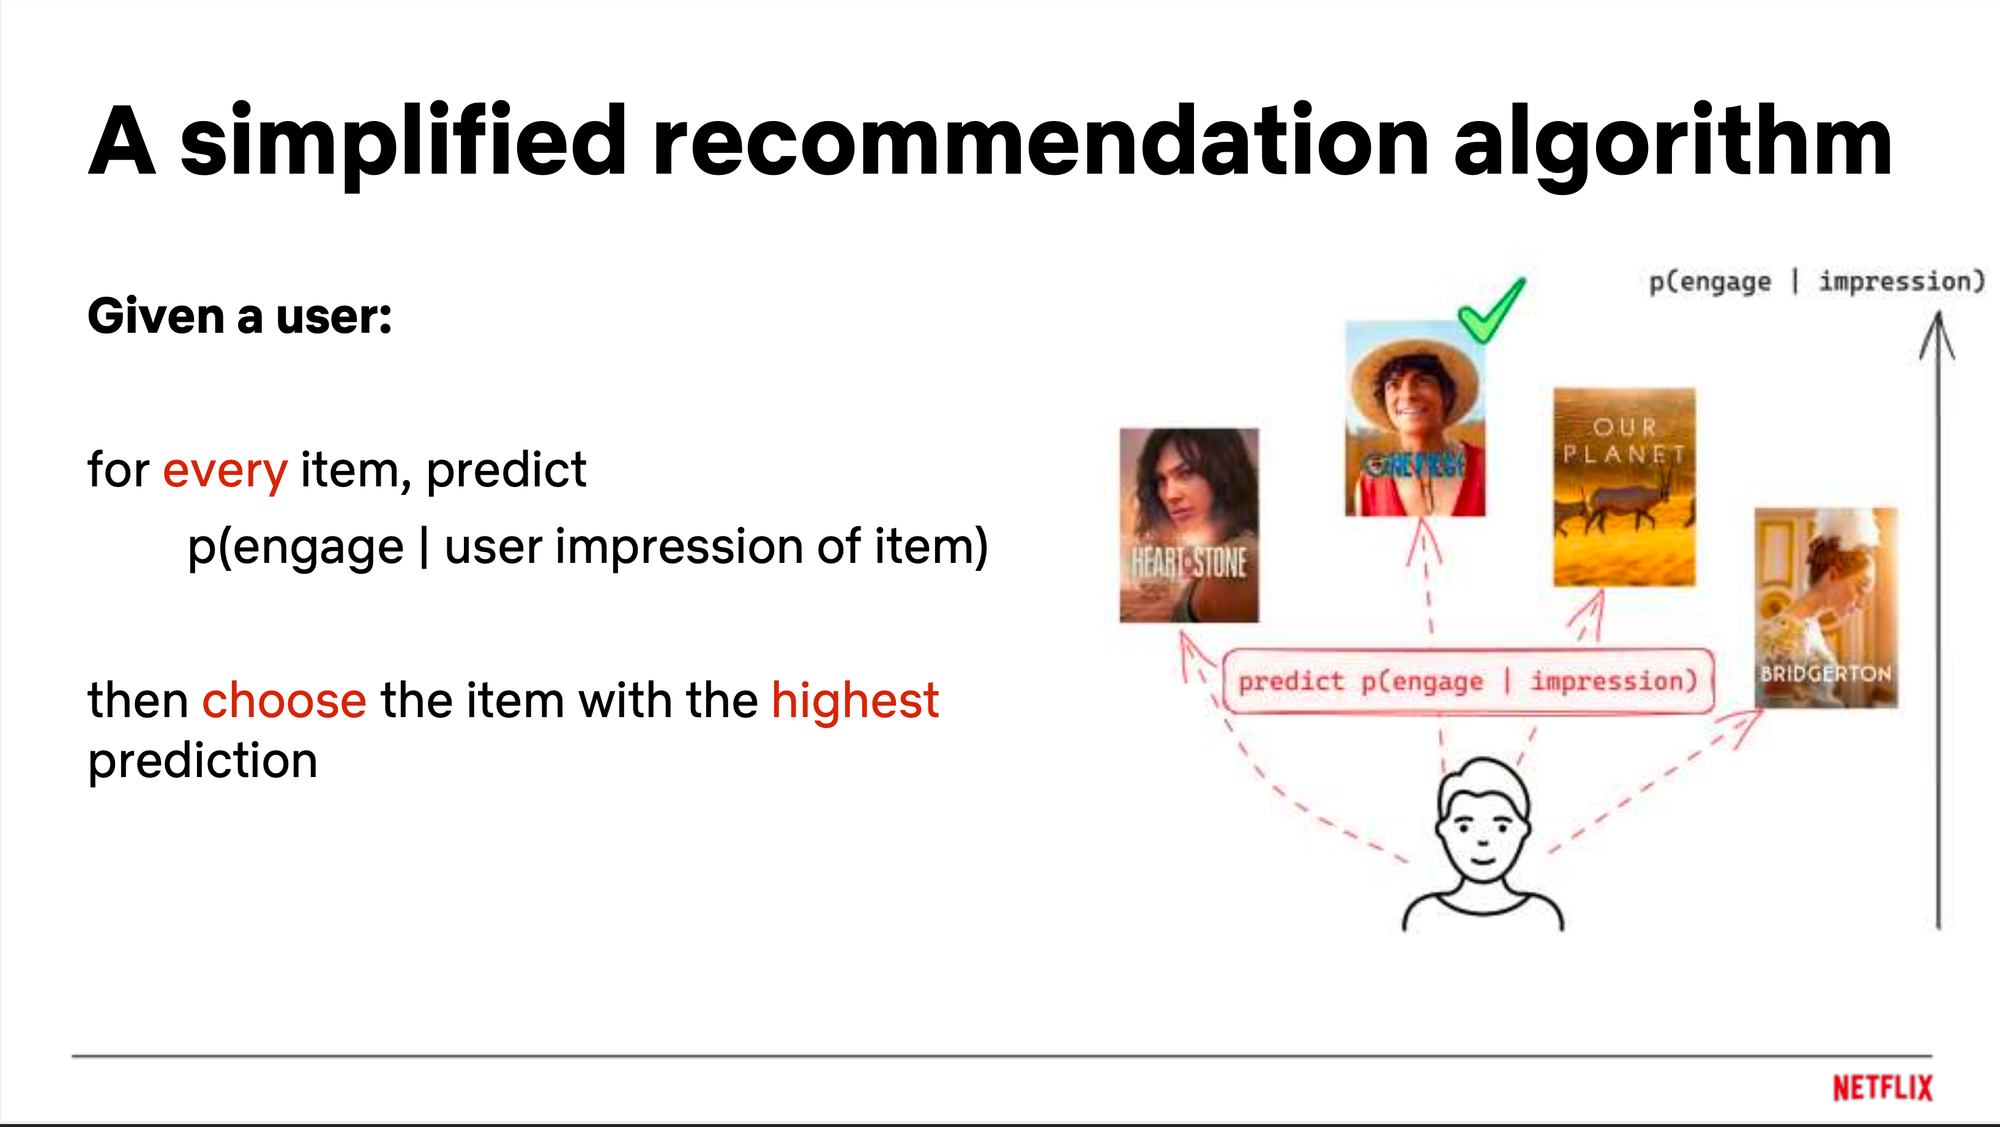
- 問題設定:p(engage|impression)をあらゆるitemに対して推論する
- 学習の課題
- impressionのついたものはそもそもrelevantが高いものが多いので、それだけで学習してしまうのはバイアスが発生してしまうよね。
- Sol.1:レコメンドにexploration要素を足してnot relevantなものにもimpressionしてもらう。ユーザー体験を既存しない範囲にて。
- Sol.2:impressionしていないものをランダムにサンプリングしてネガティブとして扱う。
- どういうふうにサンプリングするのか、impressionされたnegativeサンプルとの使い分けをどうするのか、などはchallenge
- 人気バイアス:人気なアイテムが真の値よりも過剰に良いと評価されるバイアス
- 十分にexploreできれば減らせる。
- impressionしていないものをネガティブとしてサンプリングする方法ではバイアスが広がってしまう恐れ。
- item数が大きいと計算大変
- 2-stageでいったん候補を減らすといいね。
- candidates generation → fine-granted ranking
- 特定のアイテムに複数回のimpressionが発生することがある。
- 特にランキング上位のアイテムはその傾向にあるので重複を消すなどの処理が必要。さもなければ過剰にペナルティが乗せられてしまう。
- ノイズとなるimpressionが発生することがある。
- engageがない場合に、興味がなかったからなのか実際にはユーザの目に入っていないからなのか。
- impressionはlong-termな性質も持つ
- 1回のimpresssionではengageしないが、複数回impressionするうちに気になってengageすることも。
- 特徴量エンジニアリング
- いろいろ考えられるね
- Frequency
- engagement rate
- impressionがないサンプルをどう扱うか?0?
- categorical
- 量も多い・扱いもで大変
- データの扱い
- 複数デバイス(TV, mobile, web)
- リアルタイム性
- データ量
- 直近のimpressionを重く見る
- increase minimum impression duration requirement(一瞬で画面を閉じたときとかはカウントしない、とかかな)
- ランダムサンプリング
- インプレッションに関する特徴量を加えると、インプレッションが少なかったアイテムがレコメンドされるようになるはず
- たくさんインプレッションされているアイテムは良いものの可能性が高いが、逆が成り立つわけではない。