36億パラメータの日本語言語モデルを公開しました[LINE]
概要
- データセット作成のフィルタリング処理に自社製のOSS‣を使用
- やalbumentationっぽく書ける
- ‣ってやつが、pyproject.tomlの中で使われている。初めて知った。以下のようにMakeFile的に書けるっぽい?で実行できる
- 650GBのコーパスを利用していて、3D ParallelismやActivation Checkpointingといったテクニックを駆使することによって、ミニバッチサイズを巨大化
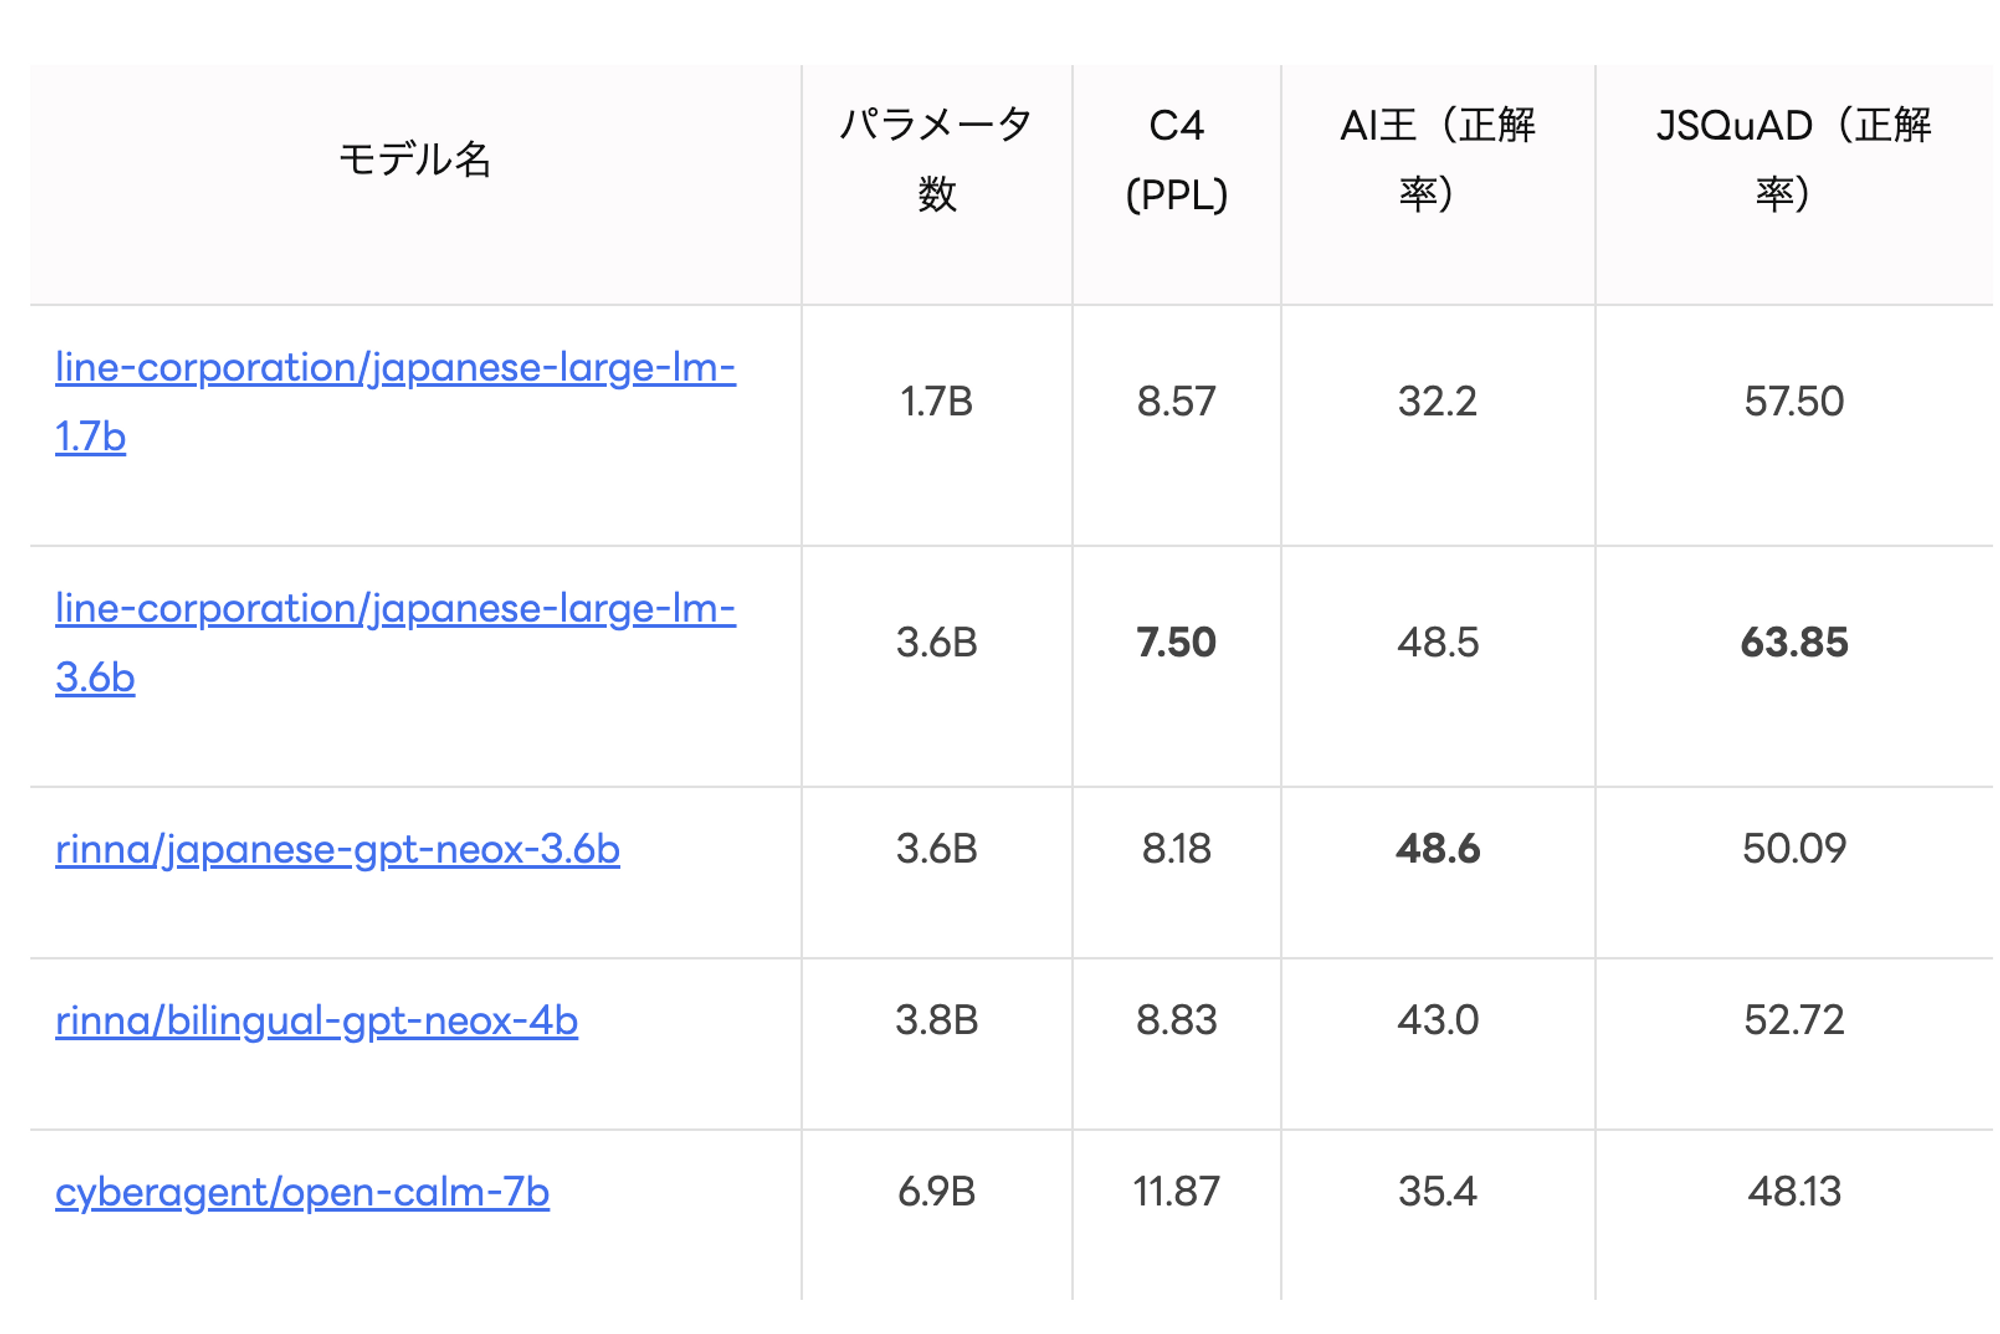
- 3.6bのモデルはrinna3.6bと同等かそれ以上の精度
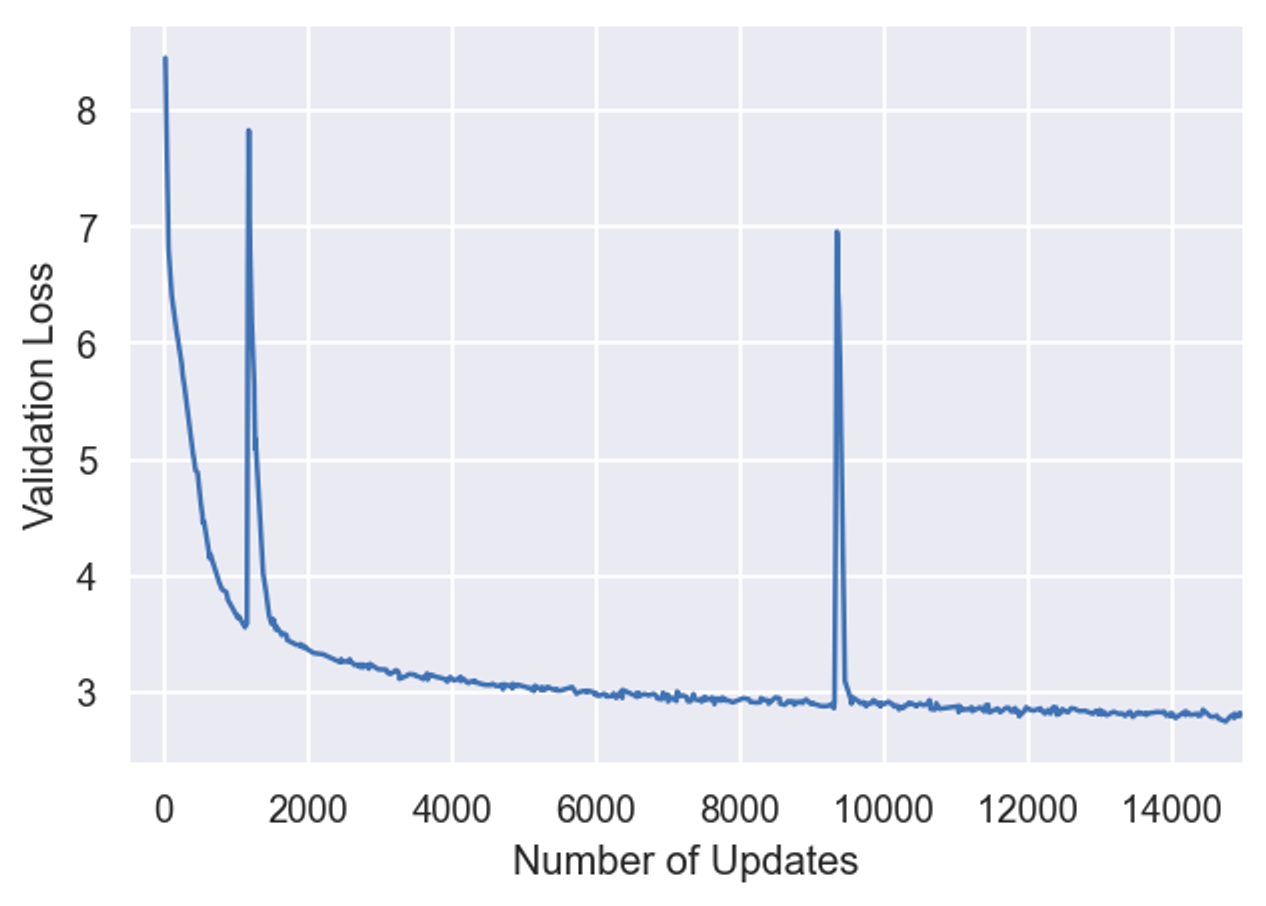
- パラメータの初期値を層の数に応じて変える、Adamのbeta2の値を小さくするなど、ロスを発散させないテクニックについても述べられている