TabR: Unlocking the Power of Retrieval-Augmented Tabular Deep Learning
概要
- Yandexが発表した新しいテーブルデータに対するNNの論文
- コードも公開:‣
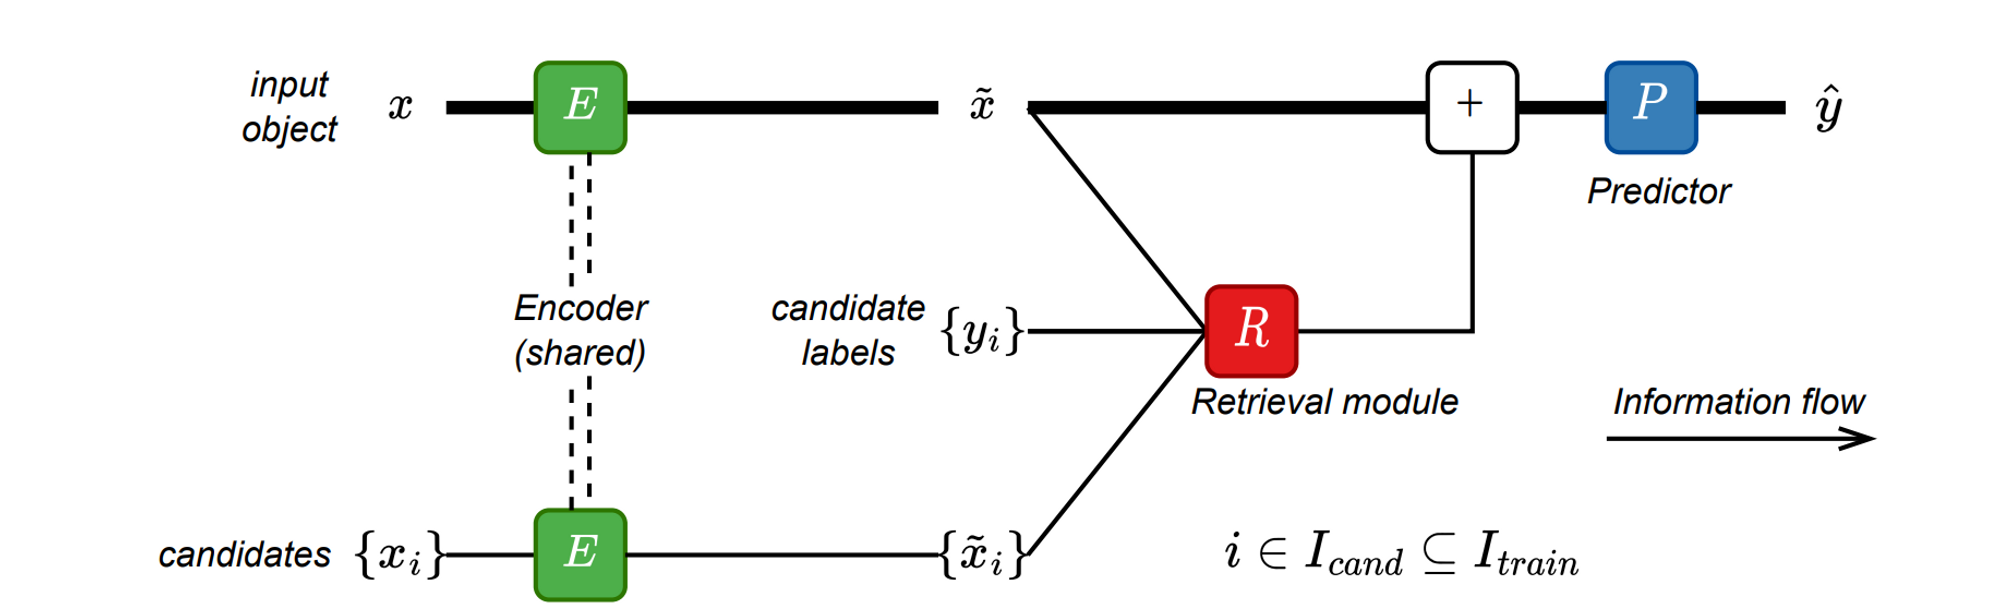
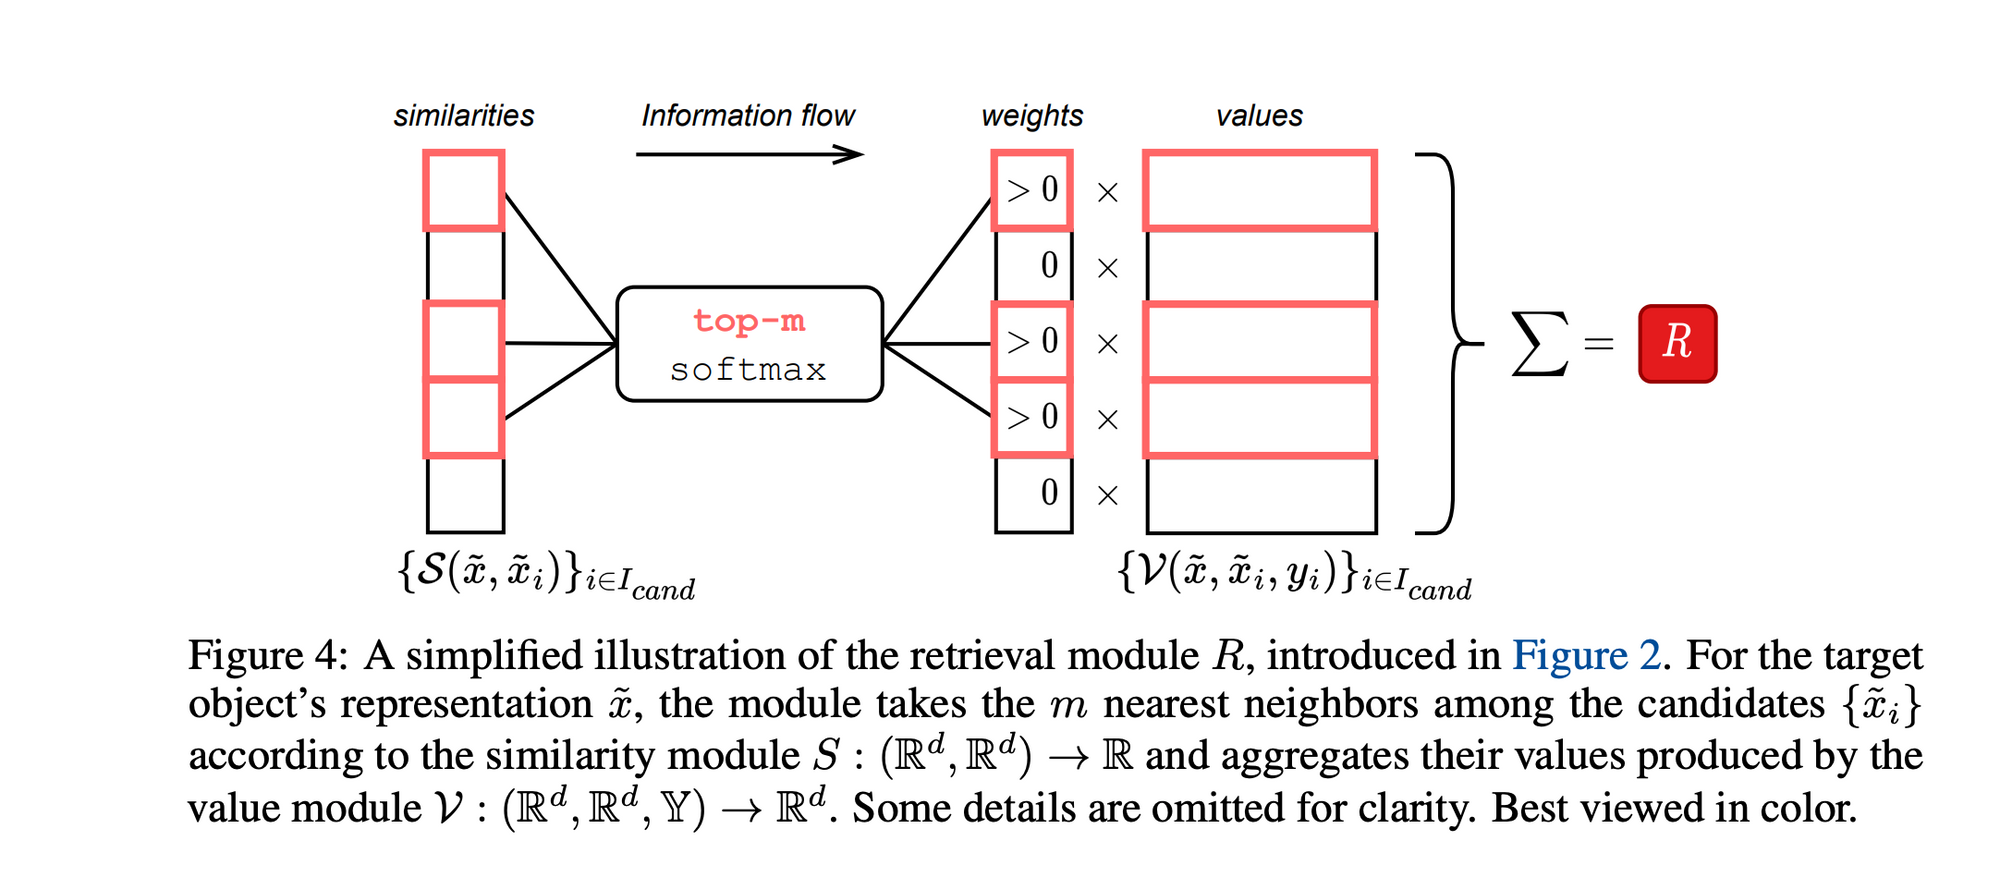
- Retrieval moduleを組み込んだNNを提案
- SimilarityやValueの計算を行うModuleの実験も色々試し、先行研究では行われなかったようなAttentionメカニズムを提案している
- kNNアルゴリズムの一般化として最近提案されたDNNRからインスピレーションを得て、Valueモジュールをより表現豊かにした
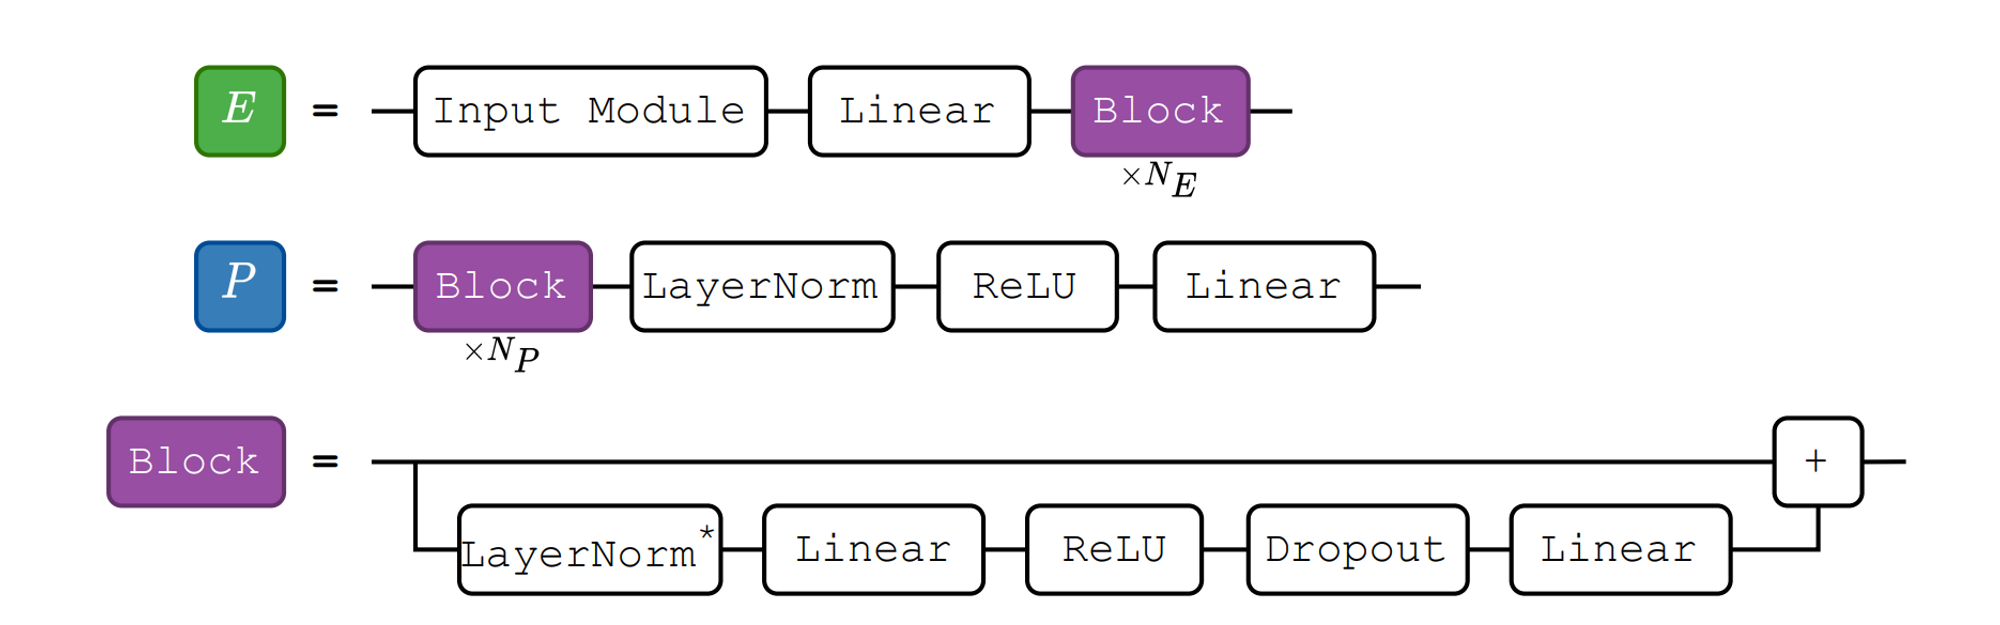
- シンプルな構造であることも先行研究に対する優位性
Abstract
表形式データ問題のためのディープラーニング(DL)モデルは、勾配ブースト決定木(GBDT)に基づくアルゴリズムが依然として有力な解決策である一方で、ますます注目を集めている。自然言語処理やコンピュータビジョンといった他の領域における最近のトレンドに倣い、最近、検索を考慮した表形式DLモデルがいくつか提案されている。検索ベースのモデルは、与えられたターゲットオブジェクトに対して、利用可能な(訓練)データから、最近傍のオブジェクトのような他の関連オブジェクトを検索し、より良い予測を行うためにそれらの特徴、あるいはラベルを利用する。しかし、既存の検索ベースの表形式DLソリューションは、適切にチューニングされた単純な検索なしのベースラインと比較して、利点があるとしてもわずかであることを示す。したがって、検索ベースのアプローチが表形式DLの方向性としてふさわしいかどうかは、依然として不明である。
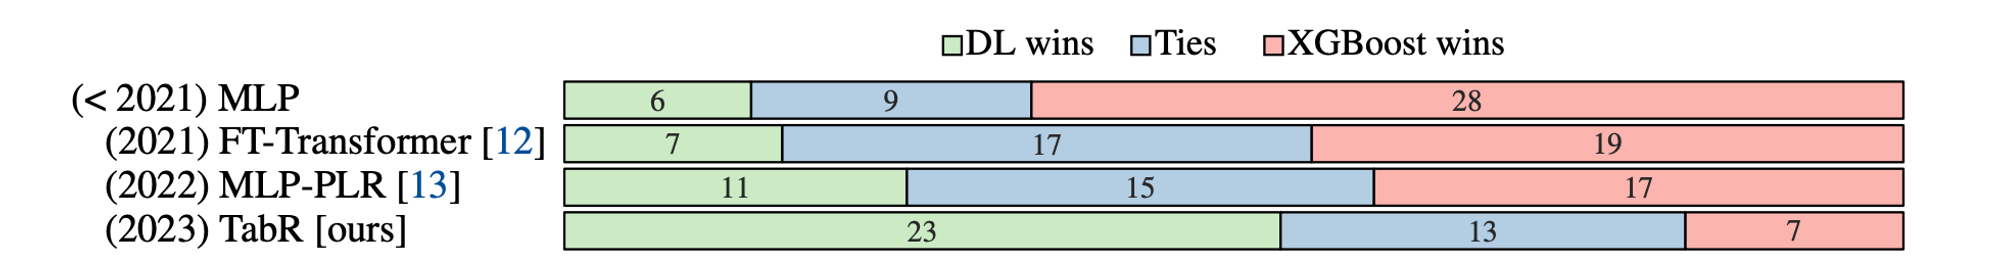
本研究では、この疑問に対して肯定的な回答を与える。我々はまず、単純なフィードフォワードアーキテクチャを、多くの(表形式の)検索ベースモデルと同様の注意のような検索コンポーネントで段階的に補強することから始める。次に、表形式のデータ問題に対する性能に大きな影響を与えることが判明したが、先行研究では検討されていなかった注意メカニズムの詳細をいくつか強調する。その結果、我々はTabR(単純な検索ベースの表形式DLモデル)を設計した。TabRは、一連の公開ベンチマークにおいて、表形式DLモデルの中で最高の平均性能を示し、いくつかのデータセットにおいて新たな最先端となり、最近提案された``GBDT-friendly''ベンチマークにおいてGBDTモデルをも凌駕する(図参照)。